
Tóm tắt nhanh
- A20 Pro chuyển từ kiểu xếp DRAM trên SoC sang WMCM, đặt hai phần cạnh nhau để mở đường tản nhiệt trực tiếp hơn.
- Tiến trình TSMC N2 dùng transistor GAA nanosheet; ba lớp nanosheet là lựa chọn cân bằng cho chip di động, không phải cuộc đua đếm lớp.
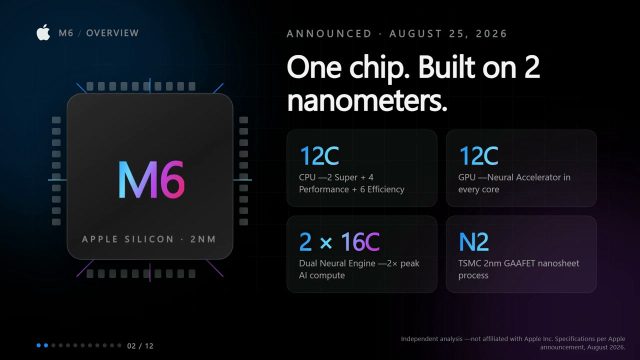
- CPU gồm 2 nhân S-core và 4 E-core; dung lượng cache tăng, còn bus nhớ 96-bit được phân tích là đạt 115,2 GB/s.
- Phần cứng mới gợi ý ưu tiên cho tác vụ AI/GPU và hiệu năng duy trì; thông số die chưa tự chứng minh mức tăng hiệu năng trong ứng dụng.
Điểm đáng bàn ở A20 Pro không nằm riêng ở nhãn “2 nm”. Một phân tích die shot do High Yield thực hiện cùng STEEL Lab cho thấy Apple thay đổi cách đặt bộ nhớ cạnh chip xử lý; đối chiếu với TechInsights giúp xác nhận những nét chính về cấu hình CPU và kiểu đóng gói. Cách bố trí này có thể quan trọng với nhiệt và băng thông hơn một con số tiến trình đứng riêng.
WMCM xử lý bài toán nhiệt bằng cách bỏ lớp DRAM khỏi mặt trên SoC
Trong kiểu InFO-PoP trước đây, DRAM nằm chồng lên SoC. Cách xếp tầng tiết kiệm diện tích bo mạch — lợi thế thiết thực với điện thoại mỏng — nhưng tạo thêm một lớp vật liệu trên đường truyền nhiệt từ SoC tới hệ thống tản nhiệt.
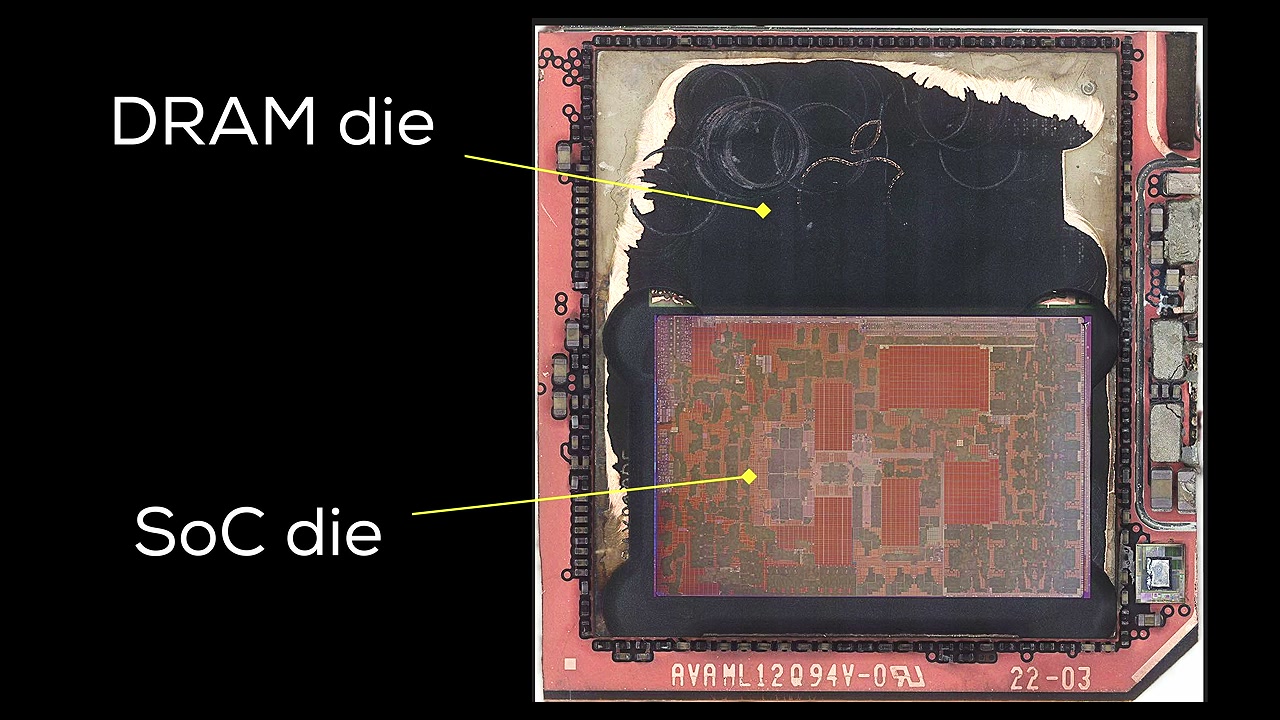
Với WMCM, DRAM và SoC nằm cạnh nhau trong cùng cấu trúc đóng gói wafer-level. Theo phân tích die shot, mặt lưng SoC vì vậy không còn bị DRAM phủ phía trên; nhiệt có đường thoát trực tiếp hơn về buồng hơi. Apple cũng nói iPhone 18 Pro có buồng hơi thế hệ mới và A20 Pro cùng hệ thống này hướng tới hiệu năng duy trì cao nhất trong lịch sử iPhone. Đây là tuyên bố của hãng, chưa phải kết quả đo độc lập.
Đổi lại, đặt hai die cạnh nhau cần diện tích mặt bằng lớn hơn so với xếp chồng. Apple dường như chấp nhận đánh đổi không gian để tăng dư địa nhiệt và mở rộng giao tiếp bộ nhớ. Đó là thay đổi về thiết kế hệ thống, không chỉ là thay một tiến trình sản xuất.
Ba nanosheet của TSMC N2 ưu tiên cân bằng hơn số lớp tối đa
TSMC N2 là tiến trình GAA đầu tiên của hãng. Thay vì để cổng điều khiển bao quanh một vây silicon như FinFET, transistor GAA dùng các kênh dạng tấm xếp chồng; cổng bao quanh từng kênh để kiểm soát dòng điện tốt hơn và hạn chế rò rỉ khi kích thước giảm.
Hình cắt lớp trong phân tích nhận diện ba nanosheet trong mỗi stack N2, còn Intel 18A dùng bốn RibbonFET. Một stack nhiều lớp hơn có thể tăng dòng dẫn, nhưng đồng thời làm tăng điện dung và chiều cao cấu trúc, khiến việc chế tạo phức tạp hơn. Với SoC điện thoại bị giới hạn bởi pin, nhiệt và thể tích, tối đa hóa dòng dẫn không tự động đem lại thiết kế tốt hơn. Ba lớp là lựa chọn có thể cân đối hiệu năng, điện năng và khả năng sản xuất; đây là diễn giải từ cấu trúc được quan sát, không phải kết luận rằng N2 hơn toàn diện 18A.
TechInsights lưu ý N2 chuyển TSMC từ FinFET sang nanosheet, đồng thời các lựa chọn thiết kế quy trình ảnh hưởng tới mật độ, rò điện và độ phức tạp sản xuất. Vì vậy, không thể xếp hạng hai tiến trình chỉ bằng số nanosheet hay việc một bên có cấp nguồn mặt sau. Kết quả cuối cùng phụ thuộc cả thư viện cell, thiết kế chip, đóng gói và tản nhiệt.
CPU 6 nhân tăng cache ở nhóm E-core, không chạy theo số nhân
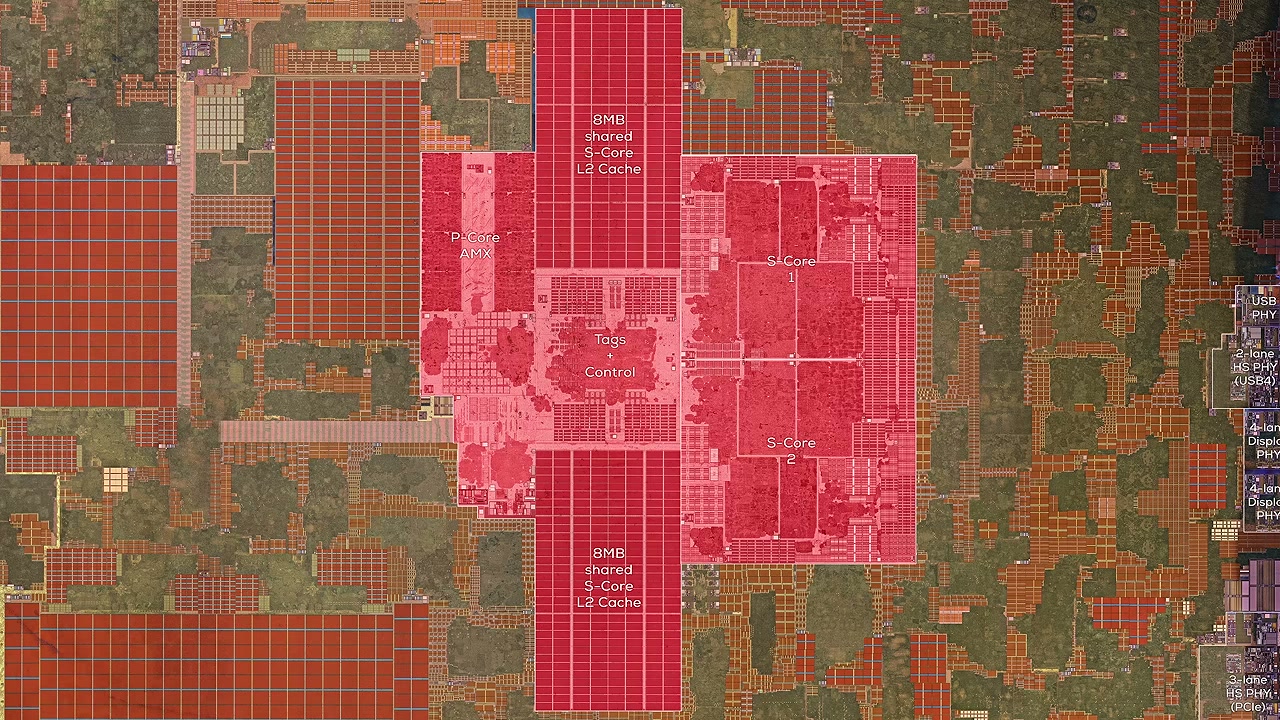
A20 Pro có hai nhân hiệu năng S-core và bốn nhân tiết kiệm E-core. TechInsights xác nhận sơ bộ cấu hình sáu nhân; dữ liệu die shot cho thấy hai S-core dùng tổng 16 MB L2 chia thành hai khối 8 MB, còn bốn E-core chia sẻ 8 MB L2. Phần E-core tăng từ mức 6 MB được ghi nhận ở A19 Pro, trong khi nhóm S-core vẫn giữ tổng 16 MB.
Cache lớn hơn giúp giảm số lần CPU phải chờ dữ liệu từ RAM trong những tác vụ phù hợp, nhưng không biến thành mức tăng tốc cố định cho mọi ứng dụng. Điểm đáng chú ý ở đây là Apple tăng tài nguyên quanh nhóm nhân tiết kiệm điện — nơi xử lý nhiều việc nền và tác vụ thường nhật — thay vì chỉ bổ sung nhân hiệu năng cao. Tác động thực tế còn phụ thuộc lịch điều phối, xung nhịp duy trì và ứng dụng.
Die shot cũng cho thấy cụm AMX gắn với nhóm S-core để tăng tốc một số phép toán ma trận. Đây là năng lực phần cứng có thể hỗ trợ xử lý máy học, song số khối xử lý không cho biết tốc độ của một mô hình cụ thể: phần mềm phải tận dụng được đơn vị này và dữ liệu phải vừa với bộ nhớ phù hợp.
Bus nhớ 96-bit mở rộng băng thông cho GPU và AI trên máy
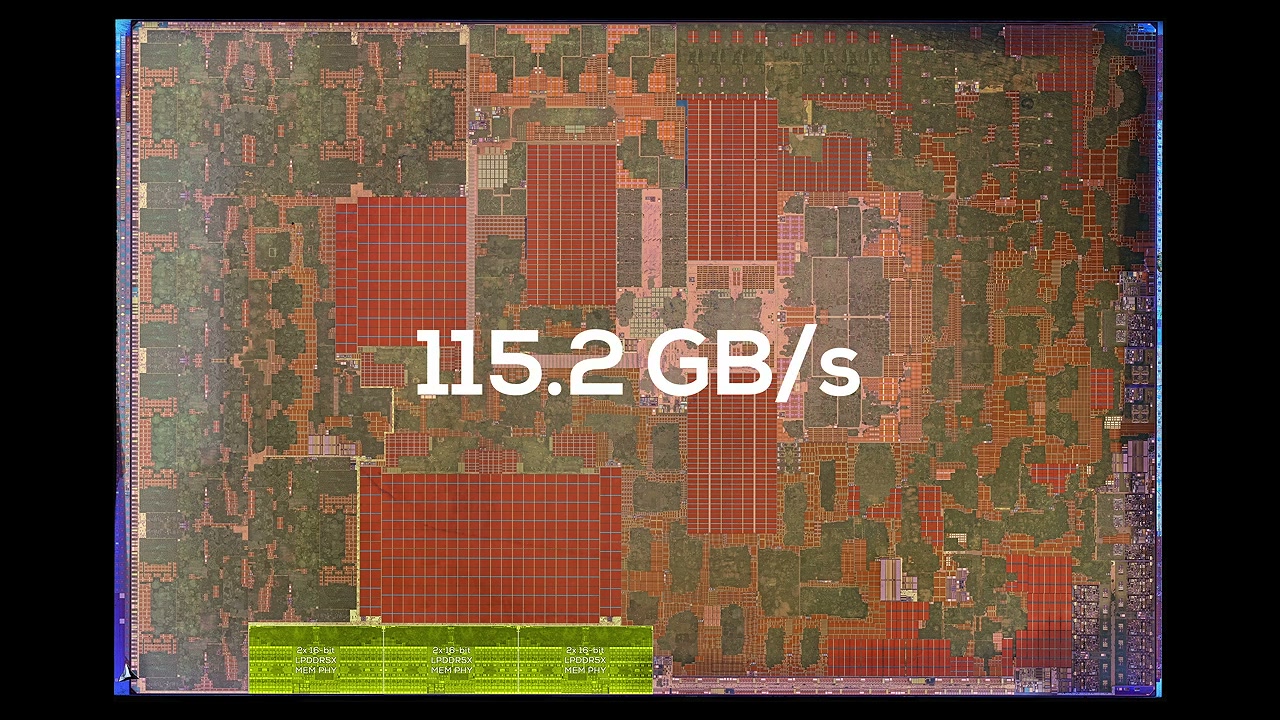
Giao tiếp bộ nhớ được chia thành ba cụm PHY, mỗi cụm gồm hai liên kết 16-bit, tạo bus tổng cộng 96-bit. Với LPDDR5X-9600, phép tính lý thuyết cho ra 115,2 GB/s; mức này cao hơn khoảng 50% so với A19 Pro. Đây là băng thông cực đại theo cấu hình, không phải tốc độ mọi ứng dụng luôn đạt được.
Bus rộng hơn có ích khi nhiều đơn vị cùng cần dữ liệu — đặc biệt GPU và NPU — nhưng cũng kéo theo chi phí về chân kết nối, bố trí die và năng lượng truyền dữ liệu. WMCM hỗ trợ cách gom các PHY về cùng cạnh hướng tới DRAM, làm cho việc đặt bộ nhớ song song với SoC hợp lý hơn về đường đi tín hiệu.
Die shot còn cho thấy GPU 7 nhân vật lý với 2 MB cache L2 dùng chung. Neural Engine được mô tả là thiết kế dual 16-core; vùng silicon dành cho NPU lớn hơn khoảng 60% so với A19 Pro theo phân tích video. Những thay đổi này phù hợp với hướng tăng năng lực AI cục bộ và đồ họa, nhưng chưa đủ để kết luận mô hình ngôn ngữ lớn nào chạy nhanh hơn hay dùng được ngoại tuyến. Cần benchmark và dữ liệu về bộ nhớ khả dụng, phần mềm hỗ trợ cùng mức tiêu thụ điện để trả lời.
Die gần bằng A19 Pro cho thấy N2 dành chỗ cho nhiều khối hơn
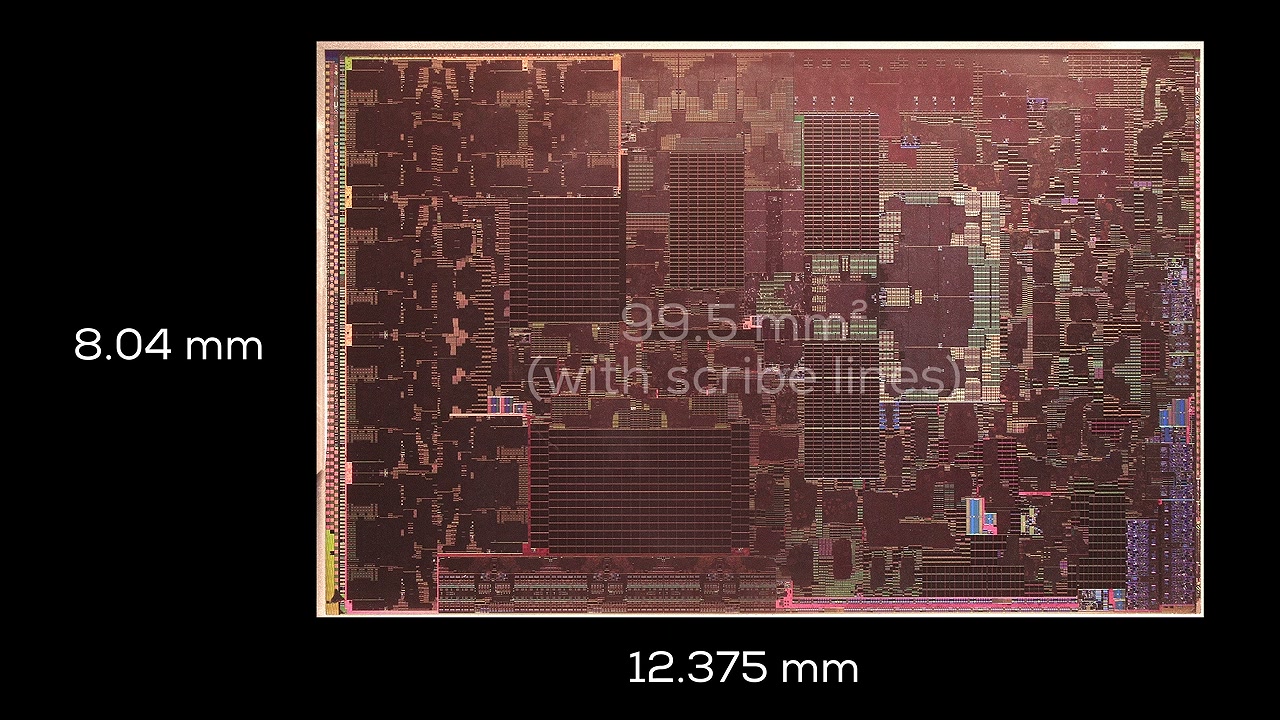
Die A20 Pro được đo khoảng 8,04 × 12,375 mm, tương đương 99,5 mm² nếu tính cả đường cắt; TechInsights ước tính phần die khoảng 98,2 mm². Hai cách tính không hoàn toàn giống nhau, nhưng đều đặt kích thước gần A19 Pro. Trong diện tích tương đương, phân tích nhận diện thêm một nhân GPU, cache hệ thống lớn hơn và vùng NPU mở rộng.
Điều này cho thấy lợi ích của N2 không nhất thiết là làm chip nhỏ đi. Mật độ logic cao hơn có thể giúp Apple đưa thêm chức năng vào cùng diện tích, còn WMCM xử lý một phần bài toán nhiệt và bố trí DRAM. Tuy nhiên, xung nhịp trên 4,9 GHz trong phân tích video là mức được ghi nhận từ cấu trúc/hoạt động chip, không thay thế phép đo hiệu năng duy trì trên điện thoại hoàn chỉnh.
Apple công bố A20 Pro kết hợp buồng hơi mới để đạt hiệu năng duy trì cao nhất từng có trên iPhone. Cấu trúc mới đưa ra lời giải hợp lý cho giới hạn nhiệt, nhưng cần thử nghiệm độc lập để xác định mức lợi ích qua phiên chơi game dài, dựng video hay tác vụ AI liên tục. Kiến trúc cho thấy hướng thiết kế; nó chưa phải benchmark.
Giá trị của A20 Pro nằm ở phối hợp CPU, bộ nhớ và tản nhiệt
A20 Pro là một bước tiến theo hướng tích lũy: transistor GAA giúp tăng mật độ logic, cache và cụm xử lý được mở rộng, bus nhớ rộng hơn, còn WMCM tạo đường nhiệt thuận lợi hơn. Từng yếu tố riêng lẻ không bảo đảm trải nghiệm tốt hơn; chúng chỉ phát huy khi phần mềm khai thác được và thân máy duy trì được mức công suất tương ứng.
Với người dùng, điều nên chờ không phải con số “2 nm” hay số nhân NPU đứng riêng, mà là các phép đo độc lập về hiệu năng sau thời gian dài, nhiệt độ bề mặt, mức tiêu thụ pin và tốc độ xử lý tác vụ AI cụ thể. Đó mới là cách phân biệt nâng cấp trong sơ đồ silicon với khác biệt cảm nhận được trên iPhone.
Nguồn tham khảo: TechInsights, High Yield / STEEL Lab, Apple Newsroom