
Tóm tắt nhanh
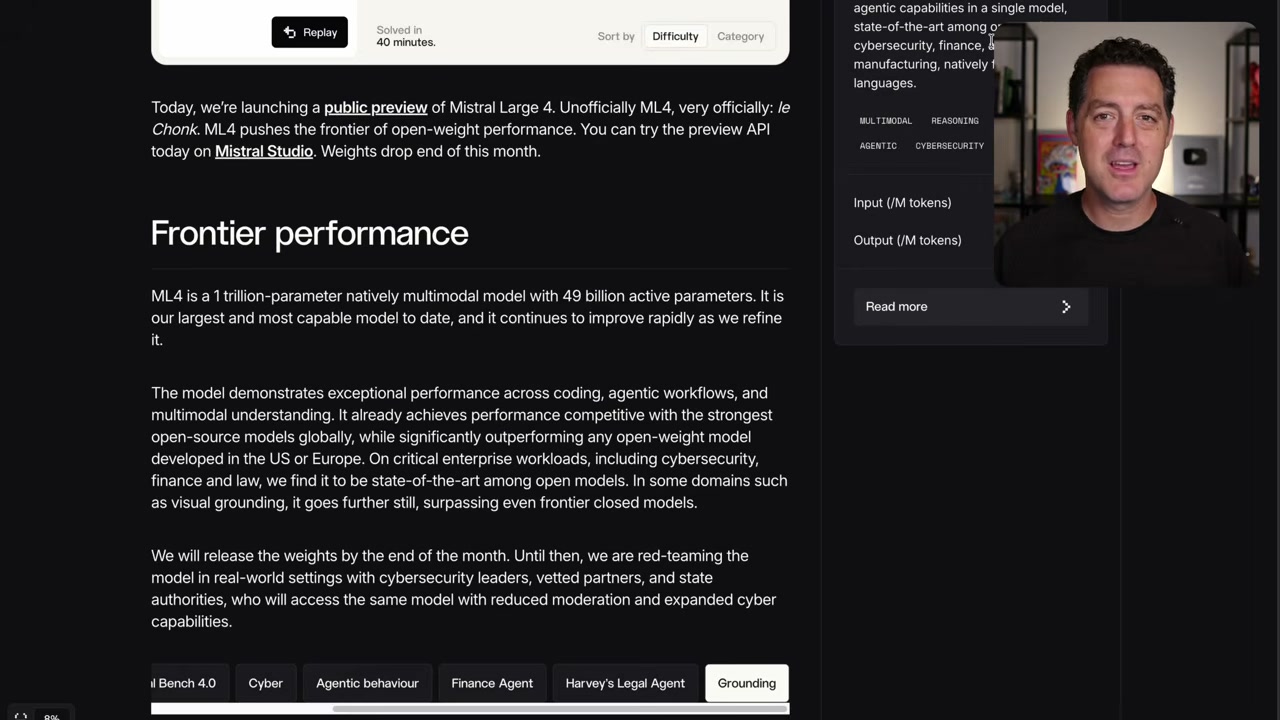
- Mistral Large 4, tên gọi thân mật Le Chonk, là mô hình đa phương thức có 1.000 tỷ tham số tổng cộng và 49 tỷ tham số hoạt động mỗi lượt.
- Bản preview đã dùng được qua API; Mistral dự kiến công bố trọng số vào cuối tháng 10/2026, sau giai đoạn kiểm thử an ninh.
- Điểm mạnh được hãng nhấn vào coding agent, xử lý quy trình doanh nghiệp, thị giác và an ninh mạng; các kết quả hiện công bố chủ yếu là benchmark của hãng.
- Với doanh nghiệp Việt Nam, triển vọng tự triển khai đáng chú ý hơn con số 1.000 tỷ: có thể giảm lệ thuộc vào một API đóng, nhưng chi phí hạ tầng và mức độ trưởng thành của model vẫn cần kiểm chứng.
Mistral Large 4 không phải mô hình 1.000 tỷ tham số mà doanh nghiệp cần chạy toàn bộ trong từng lần hỏi. Kiến trúc thưa của nó chỉ kích hoạt một phần trọng số tại mỗi lượt, còn giá trị thực tế sẽ phụ thuộc vào chất lượng model, chi phí phục vụ và khả năng triển khai khi Mistral phát hành trọng số.
49 tỷ tham số hoạt động giúp mô hình lớn không phải tính toán toàn bộ mỗi lần
Con số “1.000 tỷ” mô tả tổng quy mô tham số; 49 tỷ là phần được kích hoạt trong một lượt suy luận. Cách thiết kế này thường gắn với kiến trúc Mixture of Experts (MoE): hệ thống chọn những nhóm chuyên gia phù hợp với đầu vào thay vì chạy toàn bộ mạng như một khối dày đặc.
Điều đó giúp giải thích vì sao Mistral có thể theo đuổi quy mô rất lớn mà vẫn hướng tới vận hành thực tế. Nhưng 49 tỷ tham số hoạt động không đồng nghĩa model nhẹ như một mô hình 49 tỷ tham số thông thường. Tổng trọng số vẫn phải được lưu trữ hoặc phân phối trên hạ tầng, trong khi tốc độ và chi phí còn chịu ảnh hưởng của băng thông bộ nhớ, cách định tuyến chuyên gia, độ dài ngữ cảnh và số token sinh ra.
Mistral cho biết ML4 được huấn luyện từ đầu trên 3.800 GPU NVIDIA Grace Blackwell tại các trung tâm dữ liệu của hãng ở châu Âu. Bản preview API hiện được phục vụ trên cùng hạ tầng. Vì vậy, trước khi có trọng số và hướng dẫn triển khai đầy đủ, chưa thể lấy kiến trúc thưa làm bằng chứng rằng một công ty có thể tự chạy model rẻ trên một máy chủ đơn lẻ.
Benchmark cao là tín hiệu ban đầu, chưa phải bảo đảm hiệu quả trong công việc thật
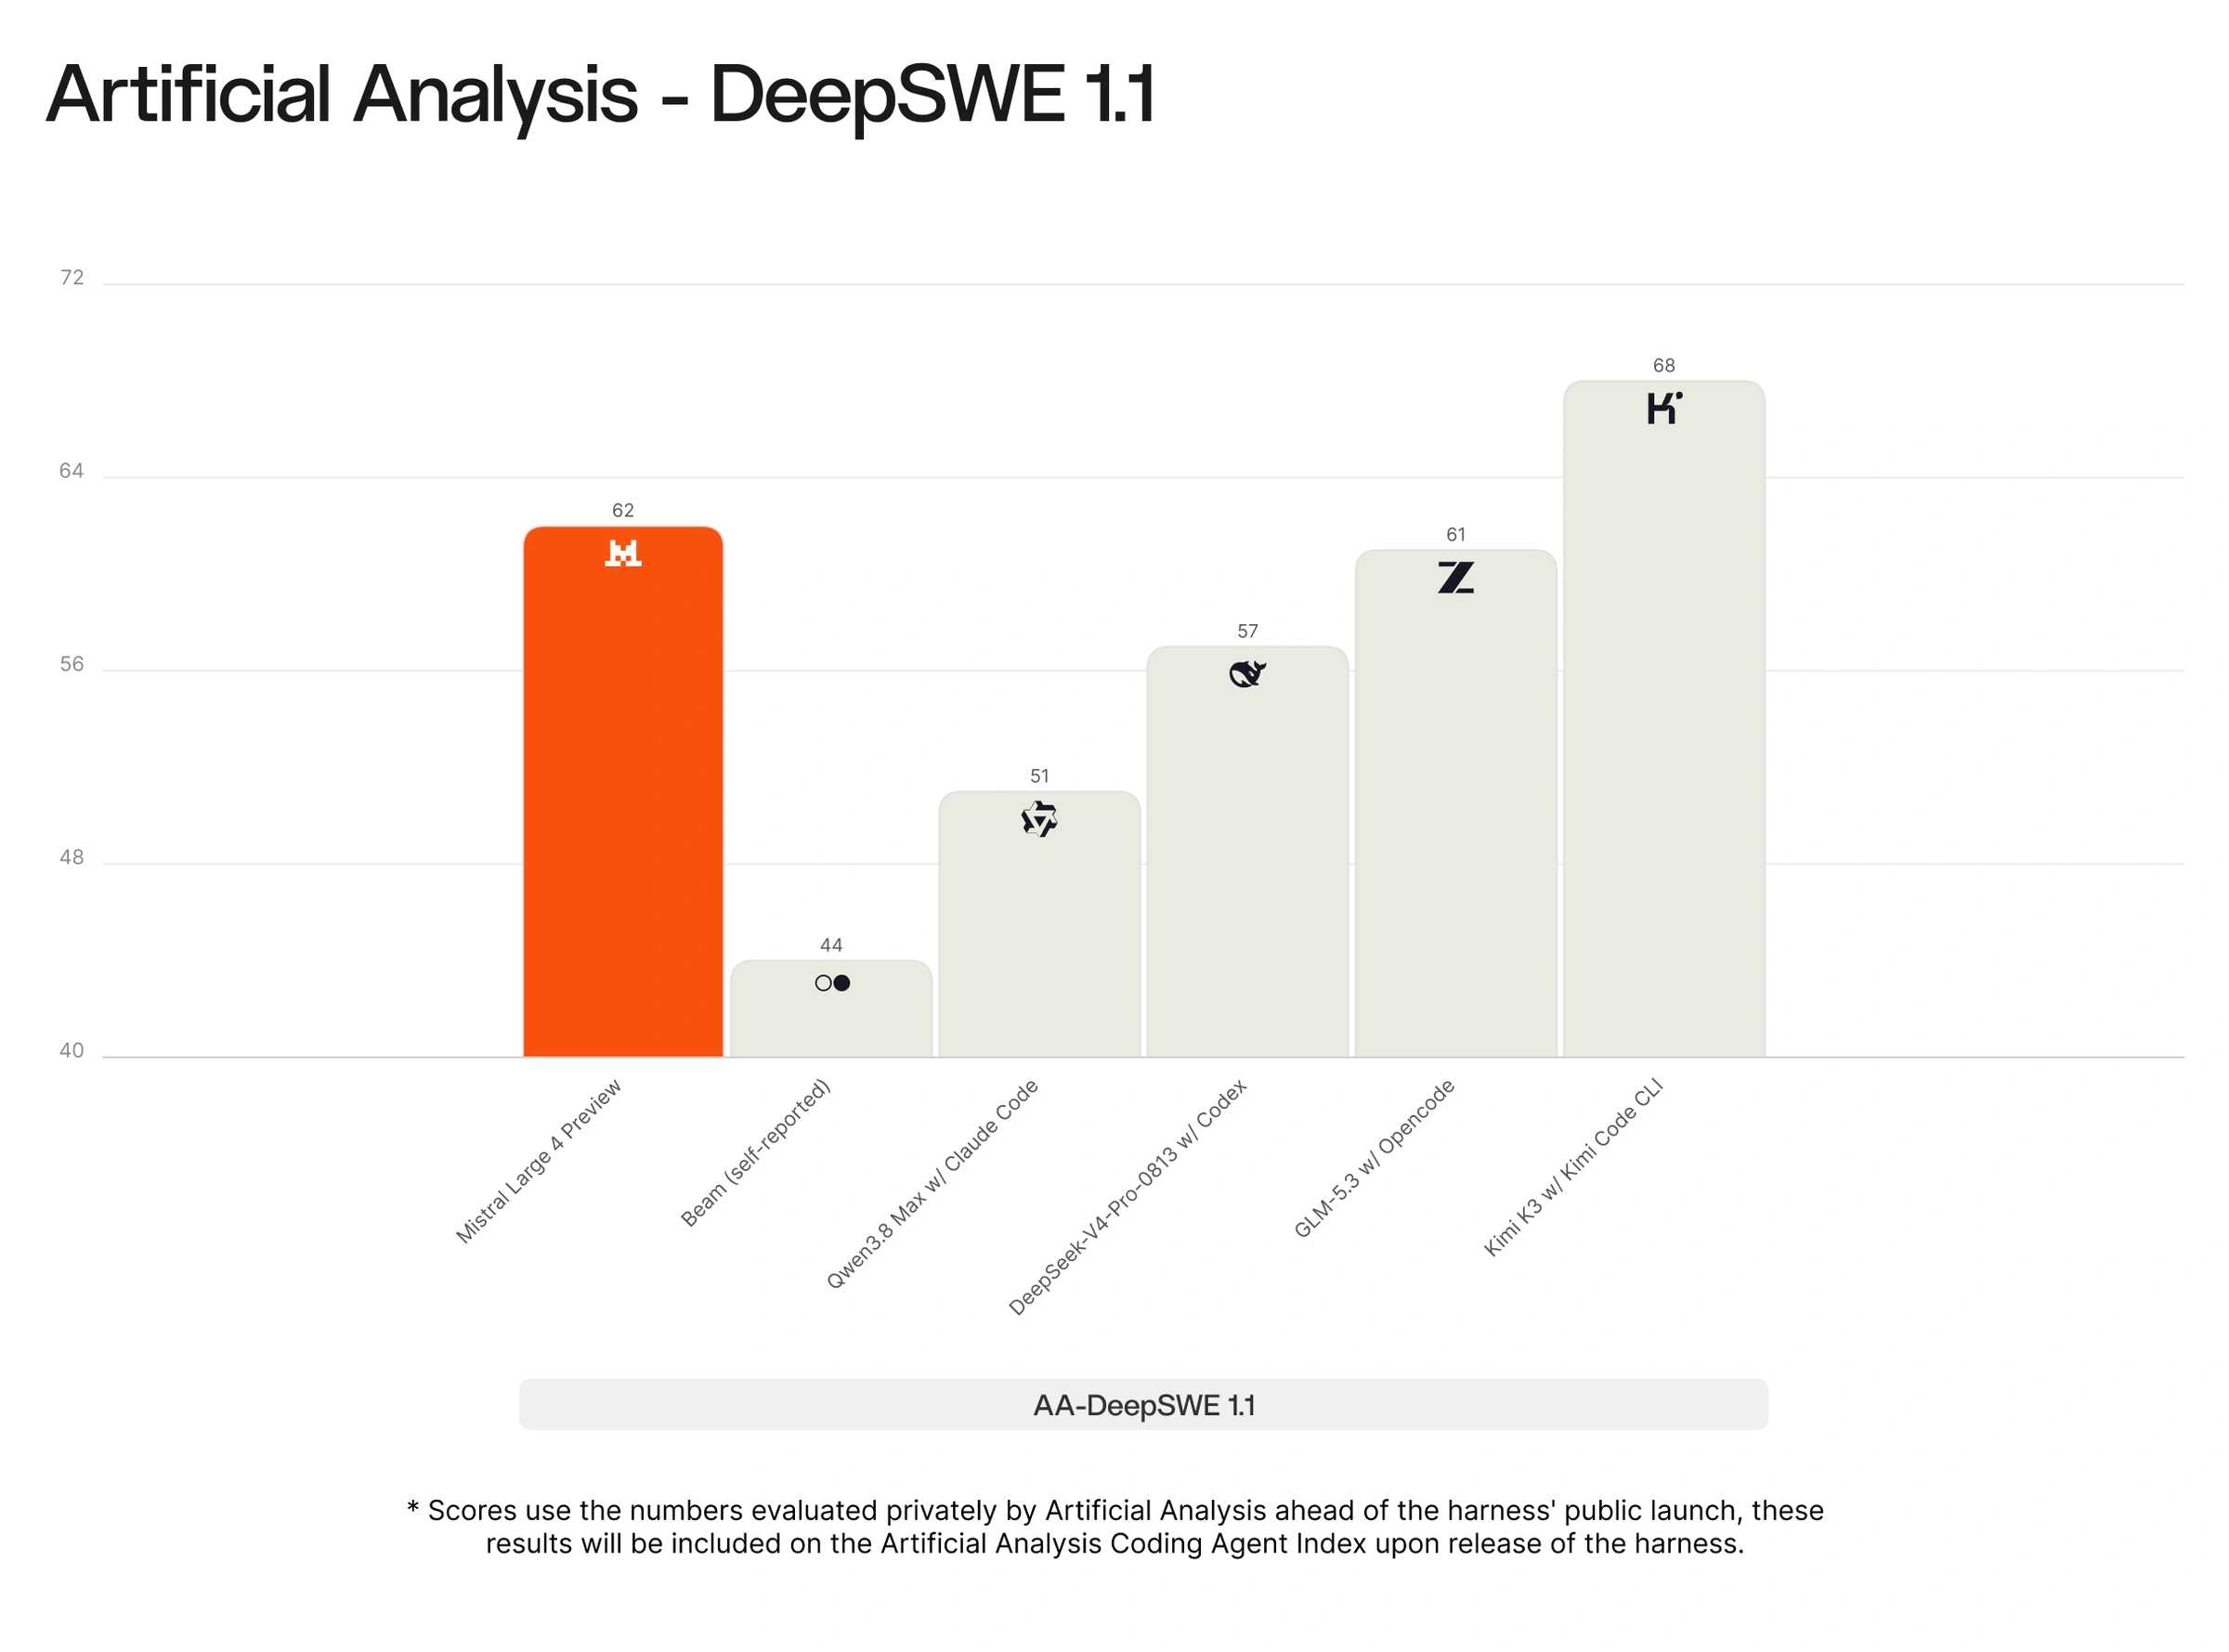
Các kết quả ML4 tập trung vào tác vụ có nhiều bước: sửa lỗi trong kho mã, thao tác terminal, điều khiển công cụ và đọc hiểu tài liệu hình ảnh. Đây là nhóm việc phù hợp với agent doanh nghiệp hơn một bài kiểm tra hỏi đáp đơn lẻ. Dù vậy, điểm benchmark chỉ có ý nghĩa khi biết cách chấm, cấu hình chạy và khả năng tái lập độc lập.
| Phép thử | Mistral Large 4 | Qwen 3.8 Max | DeepSeek V4 Pro 0813 | Kimi K3 |
|---|---|---|---|---|
| DeepSWE v1.1 (%) | 61,7 | 51 | 57 | 68 |
| SWE-Atlas-QnA (%) | 59,4 | — | — | — |
| Terminal-Bench 4 (%) | 28,3 | — | — | — |
| Coding Agent Index (điểm) | 49,8 | — | — | — |
Số liệu: Mistral AI; các mức đối chiếu được nêu trong công bố và tài liệu VentureBeat.
Bảng cho thấy ML4 đang nhắm vào năng lực làm việc liên tục với công cụ, chứ không chỉ tạo câu trả lời trôi chảy. DeepSWE là phép thử sửa lỗi phần mềm; Terminal-Bench chú trọng tác vụ dòng lệnh. Điểm số giữa các bộ không thể cộng gộp thành một thang xếp hạng chung, vì mỗi bài dùng tập nhiệm vụ và cách chấm khác nhau. Doanh nghiệp nên kiểm tra trên kho mã và quy trình riêng trước khi thay hệ thống đang dùng.
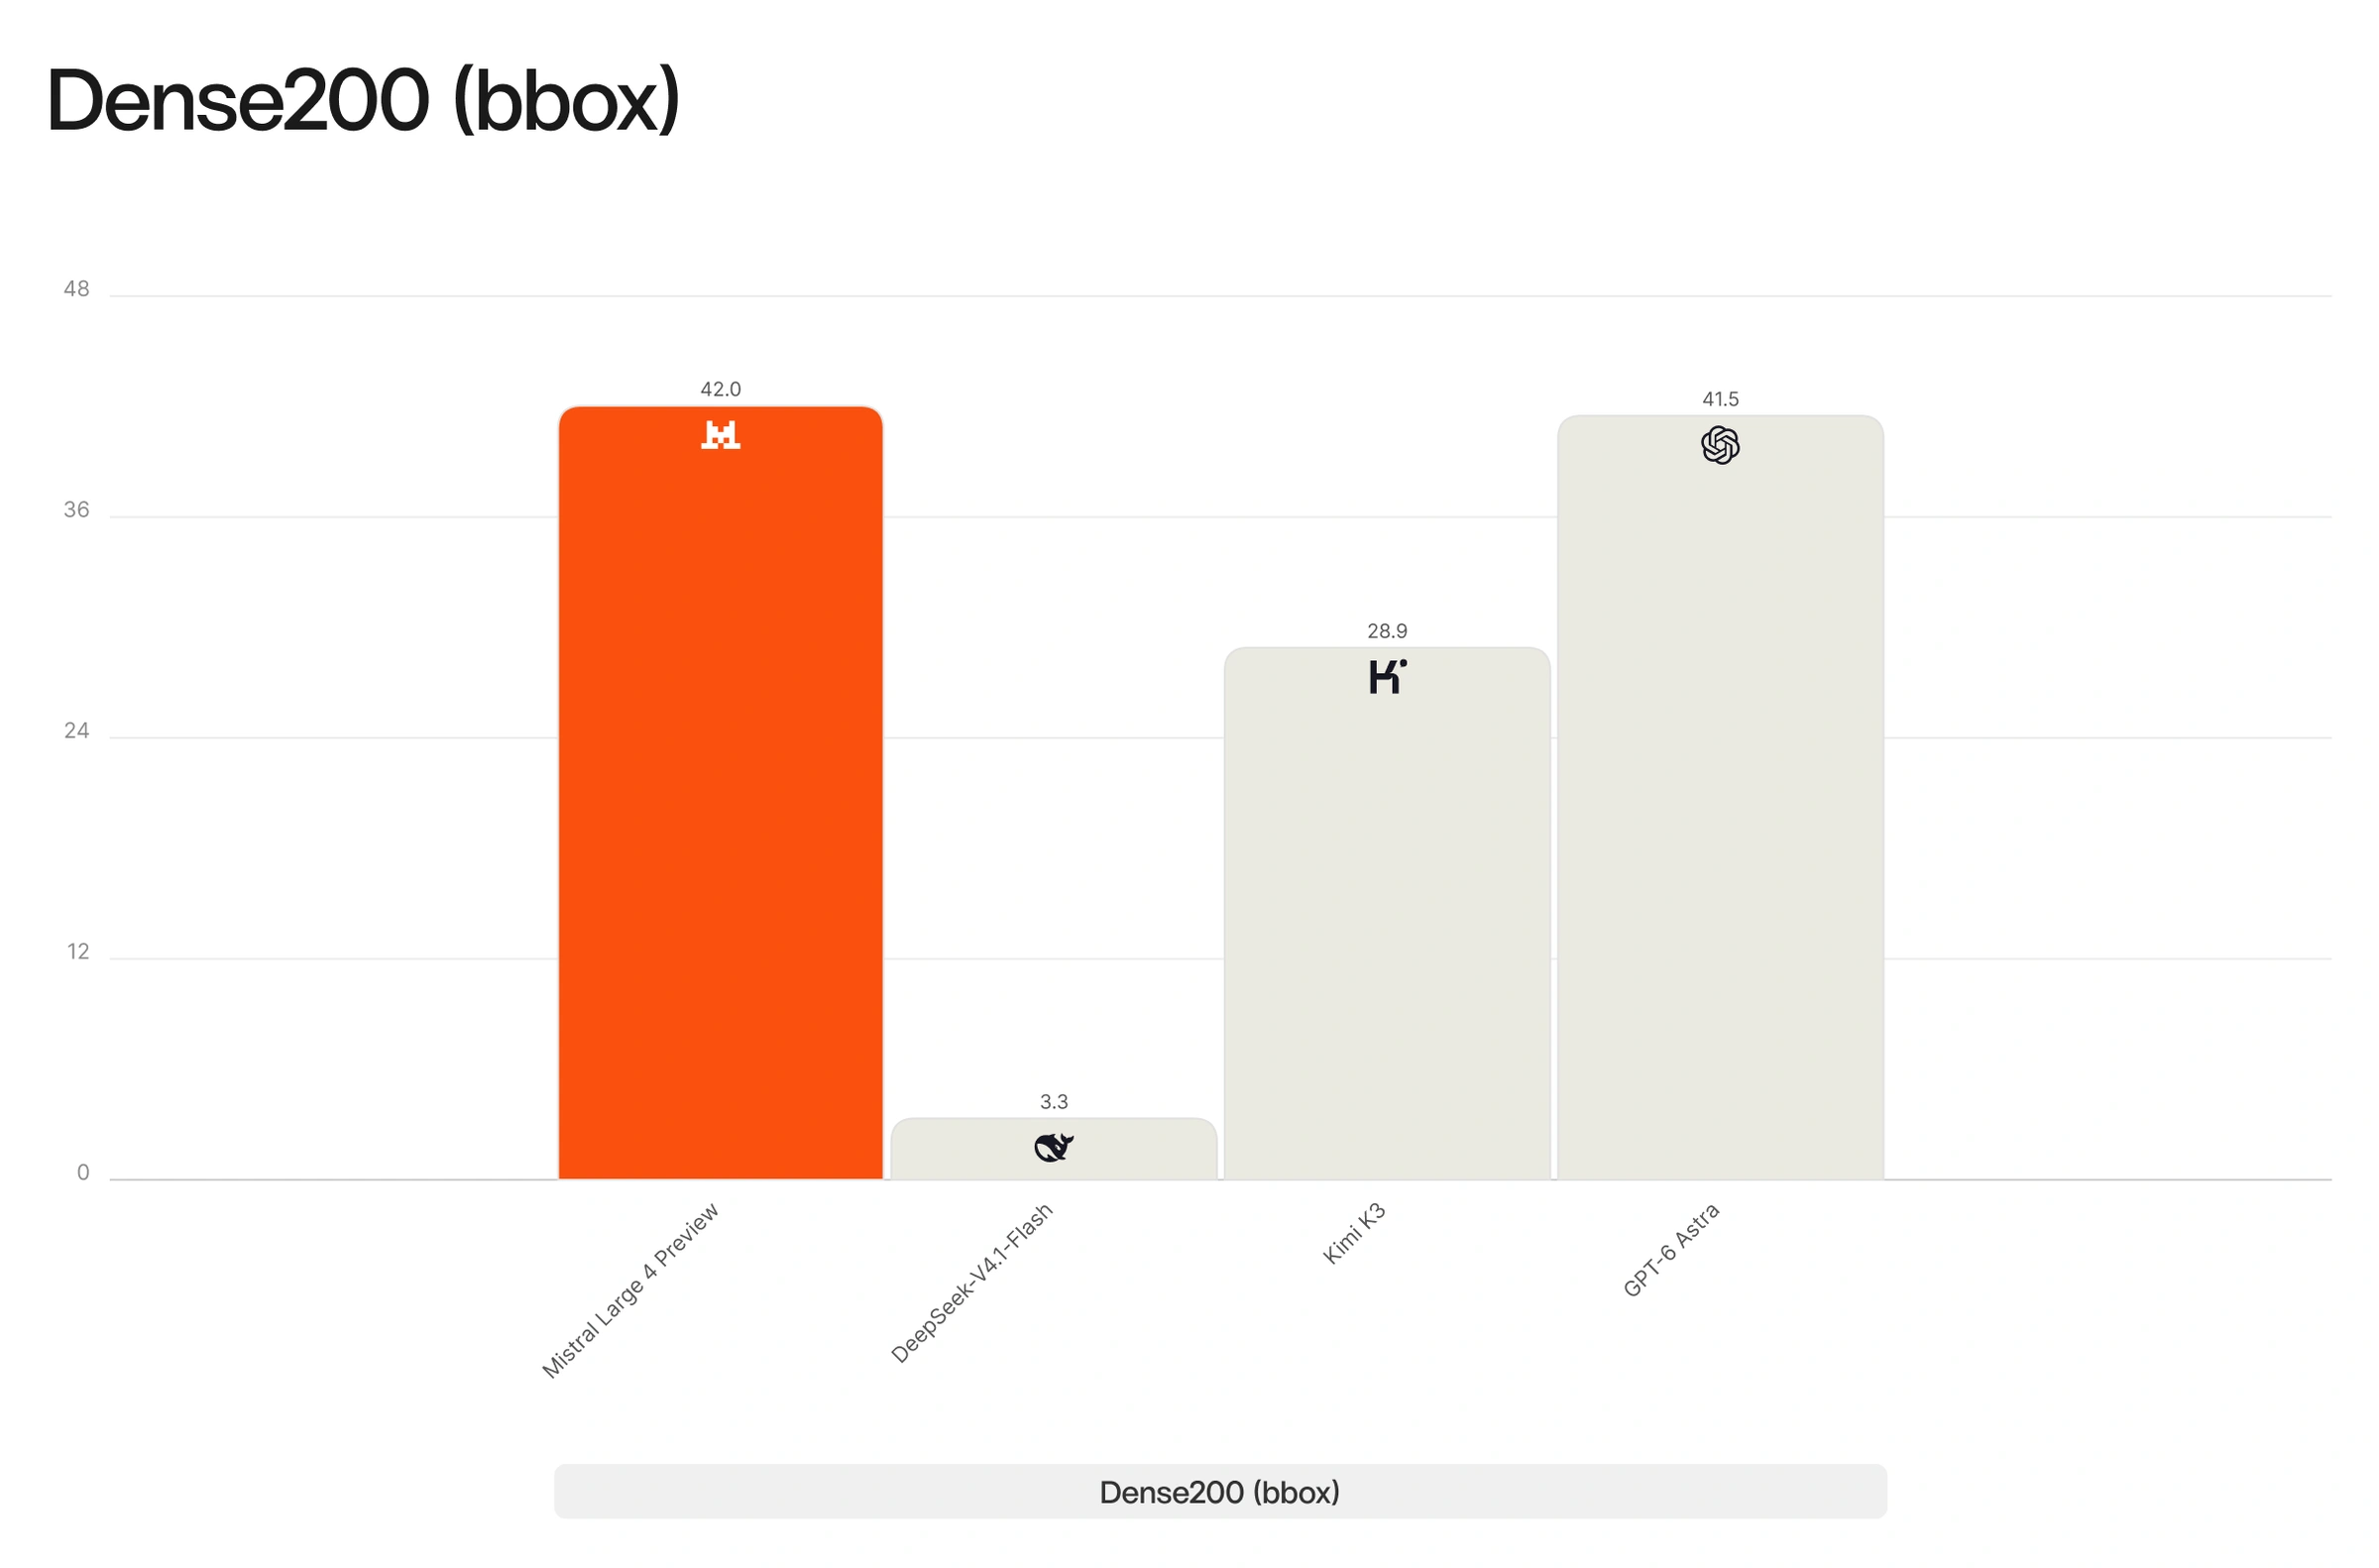
Ở Dense 200, Mistral báo cáo 42% so với 41% của GPT-6 Astra. Chênh lệch một điểm phần trăm là sít sao; nó cho thấy ML4 cạnh tranh được trong một phép thử định vị đối tượng, chưa chứng minh khả năng thị giác tổng quát tốt hơn mọi mô hình đóng. Các kết quả này do nhà phát triển công bố, nên cần chờ đánh giá độc lập có mô tả cấu hình và cách chạy để đối chiếu công bằng.
| Phép thử | Mistral Large 4 | GPT-6 Astra |
|---|---|---|
| Dense 200, visual grounding (%) | 42 | 41 |
Số liệu: Mistral AI.
Một điểm mạnh khác là agent quy trình. Mistral báo cáo 59,9% trên AutomationBench, gồm 657 quy trình qua Gmail, Google Sheets, Slack và Salesforce; ở AA-Briefcase, bài đánh giá công việc tri thức kéo dài, model đạt 1.393 Elo. Hai kết quả nhắm tới việc hoàn thành chuỗi công việc bằng công cụ, không chỉ phản hồi một câu hỏi. Tuy vậy, điểm số chưa cho biết model xử lý quyền truy cập, lỗi ứng dụng hay bước xác nhận của con người ra sao trong môi trường triển khai thực tế.
Trong đánh giá mù về chất lượng mã do Surge AI thực hiện, Mistral công bố ML4 Preview đạt 3,74/5 và xếp thứ hai trong năm model; Kimi K3 đạt 3,59, GLM-5.3 đạt 3,60, còn Claude Opus 5 dẫn đầu với 4,22. Kết quả này cho thêm góc nhìn của người chấm chuyên môn, nhưng vẫn là một thử nghiệm giới hạn, không thay thế phép đo trên sản phẩm của doanh nghiệp.
| Phép thử | Mistral Large 4 Preview | Kimi K3 | GLM-5.3 | Claude Opus 5 |
|---|---|---|---|---|
| Chấm chất lượng mã mù (thang 5) | 3,74 | 3,59 | 3,60 | 4,22 |
Số liệu: Mistral AI, đánh giá mù do Surge AI thực hiện.
Ở các tác vụ pháp lý và tài chính, Mistral cho biết đánh giá của Vals.ai cho kết quả ML4 cao hơn GPT-6 Astra; trên HarveyAI Legal Agent, hãng nói model dẫn đầu nhóm mã nguồn mở. Không có điểm số chi tiết kèm theo các claim này trong phần công bố được xem xét, nên chưa thể lượng hóa khoảng cách. Với công ty Việt Nam, các kết quả vẫn chưa trả lời câu hỏi thực dụng hơn: model có đọc đúng hợp đồng tiếng Việt, bám quy định nội bộ và tránh tạo trích dẫn sai hay không.
An ninh mạng là lợi thế có giá trị, nhưng cũng là bài toán kiểm soát rủi ro
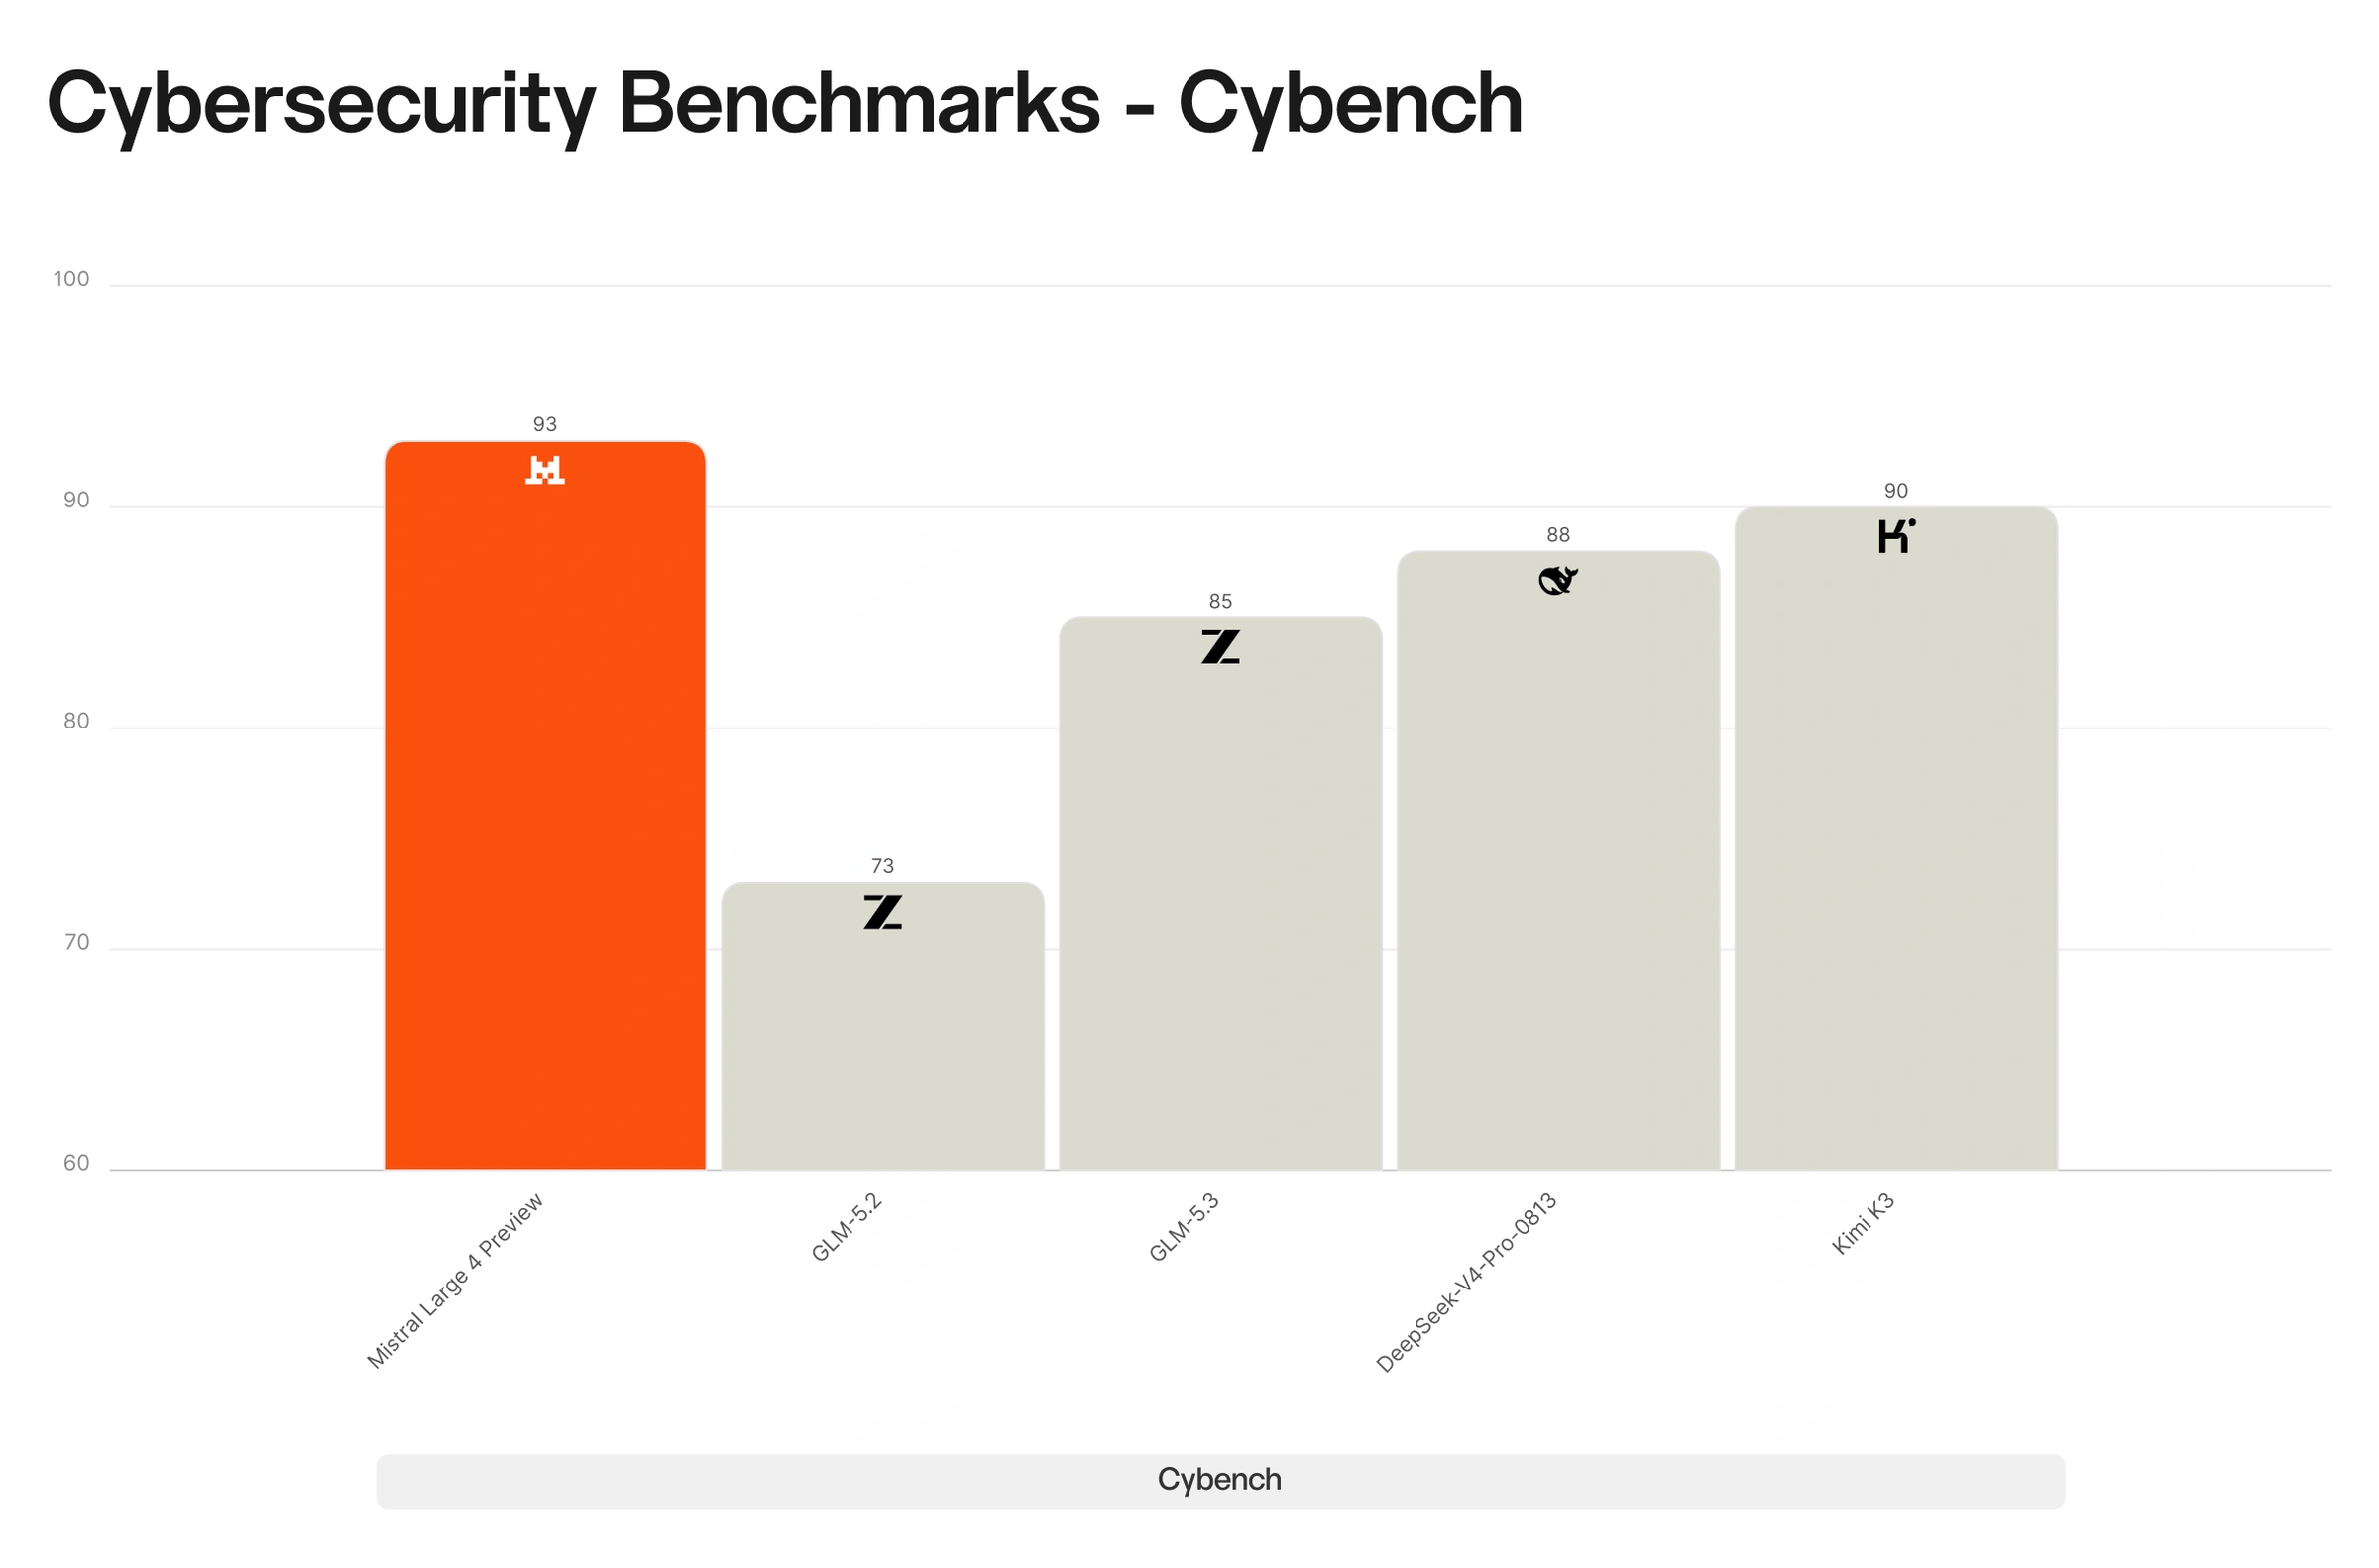
Khả năng tái hiện lỗ hổng rồi đề xuất bản vá có ích cho nhóm phòng thủ: muốn khắc phục lỗi, kỹ sư thường phải tái tạo được vấn đề trước. Hai con số Mistral công bố tập trung vào đúng công đoạn này:
| Phép thử an ninh | Mistral Large 4 Preview |
|---|---|
| Tái hiện và vá lỗ hổng phần mềm mã nguồn mở thực tế trên Artificial Analysis Cyber Index (%) | 82 |
| Thử thách Cybench hoàn thành, trên 40 bài (%) | 93 |
Số liệu: Mistral AI.
Đây là trường hợp quyền tự triển khai có ý nghĩa cụ thể. Nếu model chạy trong môi trường riêng, tổ chức có thể đặt chính sách truy cập, lưu log và giới hạn dữ liệu theo quy trình nội bộ thay vì gửi mã nguồn nhạy cảm qua dịch vụ bên ngoài. Nhưng trọng số mở không tự tạo ra an toàn: một model có năng lực khai thác lỗi cũng có thể bị dùng sai, nên cần kiểm soát người dùng, sandbox, giám sát đầu ra và quy trình phê duyệt trước khi đưa vào môi trường thật.
Mistral cho biết hãng đang red-team cùng các đối tác an ninh mạng và cơ quan nhà nước trước khi công bố trọng số. Hãng cũng nêu kết quả chống prompt injection gián tiếp đạt 93,3% trên Lakera B3. Các con số này là dữ liệu do nhà phát triển công bố, không thay thế đánh giá bảo mật độc lập trong cấu hình mà doanh nghiệp dự định sử dụng.
Năng lực cao trong tác vụ an ninh phải đi cùng hàng rào giảm lạm dụng. Mistral công bố ML4 chống được 93,3% tấn công trong benchmark Lakera B3 và đạt 1,691/2 trên KORA. Hãng cũng cho biết tỷ lệ từ chối các yêu cầu an ninh mạng độc hại cao hơn những model mã nguồn mở được so sánh. Đây là tín hiệu thiết kế an toàn, nhưng cần đánh giá riêng trong cách tích hợp mà tổ chức sẽ dùng.
| Benchmark an toàn | Mistral Large 4 |
|---|---|
| Lakera B3, tấn công bị chặn (%) | 93,3 |
| KORA (điểm trên tối đa 2) | 1,691/2 |
Số liệu: Mistral AI.
Điểm đáng lưu ý là khả năng kiểm soát không đến từ việc chỉ tải trọng số về máy chủ. Doanh nghiệp vẫn phải xác định ai được gọi model, giới hạn quyền truy cập công cụ, lưu vết thao tác và yêu cầu người phụ trách xác nhận trước khi model sửa mã hoặc thực hiện hành động có tác động. Với các tác vụ an ninh, nên tách môi trường thử nghiệm khỏi hệ thống thật; một model hữu ích cho pentest cũng làm tăng hậu quả nếu quyền truy cập bị cấp quá rộng.
Chủ quyền AI chỉ thành lợi thế khi doanh nghiệp thật sự kiểm soát được model
Khía cạnh đáng quan tâm không nằm ở việc model được huấn luyện tại châu Âu như một nhãn tiếp thị, mà ở quyền lựa chọn nơi chạy và chính sách áp dụng sau khi có trọng số. Một API đóng có thể thay đổi hạn mức, giá hoặc quyền truy cập; model tự triển khai cho doanh nghiệp thêm quyền kiểm soát, nhưng đổi lại phải tự lo GPU, cập nhật, bảo mật và vận hành.
Điểm này có liên quan cả với tổ chức Việt Nam. Dùng API preview giúp thử nghiệm nhanh mà không phải đầu tư cụm máy chủ, nhưng dữ liệu vẫn đi qua dịch vụ của nhà cung cấp và cần được xem xét theo chính sách bảo mật của từng công ty. Tự host có thể phù hợp với đơn vị cần giữ mã nguồn hoặc tài liệu nội bộ trong hạ tầng riêng, song lợi ích chỉ rõ khi tổng chi phí vận hành và chất lượng đầu ra cạnh tranh được với dịch vụ đám mây.
Mistral cho biết trọng số sẽ được phát hành vào cuối tháng 10/2026, sau giai đoạn red-team; ngày cụ thể 27/10 được nêu trong thông tin báo chí về kế hoạch phát hành. Đây là kế hoạch tương lai tại thời điểm công bố, chưa phải bản tải xuống sẵn có. Trước khi quyết định, doanh nghiệp nên đợi giấy phép, yêu cầu phần cứng, kích thước thực tế, cách lượng tử hóa và benchmark độc lập.
Le Chonk cần chứng minh chi phí vận hành, không chỉ quy mô
Mistral Large 4 đáng theo dõi vì kết hợp mô hình lớn, kiến trúc thưa và kế hoạch mở trọng số, đặc biệt ở hai lĩnh vực doanh nghiệp quan tâm là coding agent và an ninh mạng. Nhưng hiện tại, điểm số mới là một phần câu chuyện. Chất lượng khi xử lý dữ liệu riêng, độ ổn định của agent và chi phí hạ tầng mới quyết định nó có thay được dịch vụ đóng hay không.
Với nhóm phát triển ở Việt Nam, lựa chọn hợp lý lúc này là thử API trên tác vụ không nhạy cảm và theo dõi bản phát hành trọng số, thay vì dựa vào tên gọi 1.000 tỷ tham số để ước lượng hiệu năng hoặc chi phí. Nếu Mistral công bố đủ chi tiết để triển khai hiệu quả, Le Chonk có thể trở thành một lựa chọn thực dụng; đến khi đó, lợi thế chủ quyền vẫn là lời hứa cần được xác nhận bằng vận hành thực tế.
Nguồn tham khảo: Mistral AI, Ars Technica, VentureBeat, Matt Wolfe.