Tóm tắt nhanh
- Maia 300 là bộ tăng tốc AI cho hạ tầng Azure, không phải chip bán lẻ cho máy tính cá nhân.
- Microsoft dự kiến bắt đầu triển khai Maia 300 cho workload sản xuất trong năm 2027.
- Hãng tuyên bố hiệu suất đạt 40% token mỗi megawatt cao hơn các hệ thống GPU hàng đầu, nhưng chưa công bố GPU đối chứng và bộ workload để tái lập phép so sánh.
- Rack 96 accelerator được Microsoft nói có thông lượng token tối đa gấp 7 lần rack Maia 200; đây vẫn là số liệu do hãng đưa ra.
Maia 300 nhắm vào chi phí phục vụ AI, không phải cuộc đua chip bán lẻ
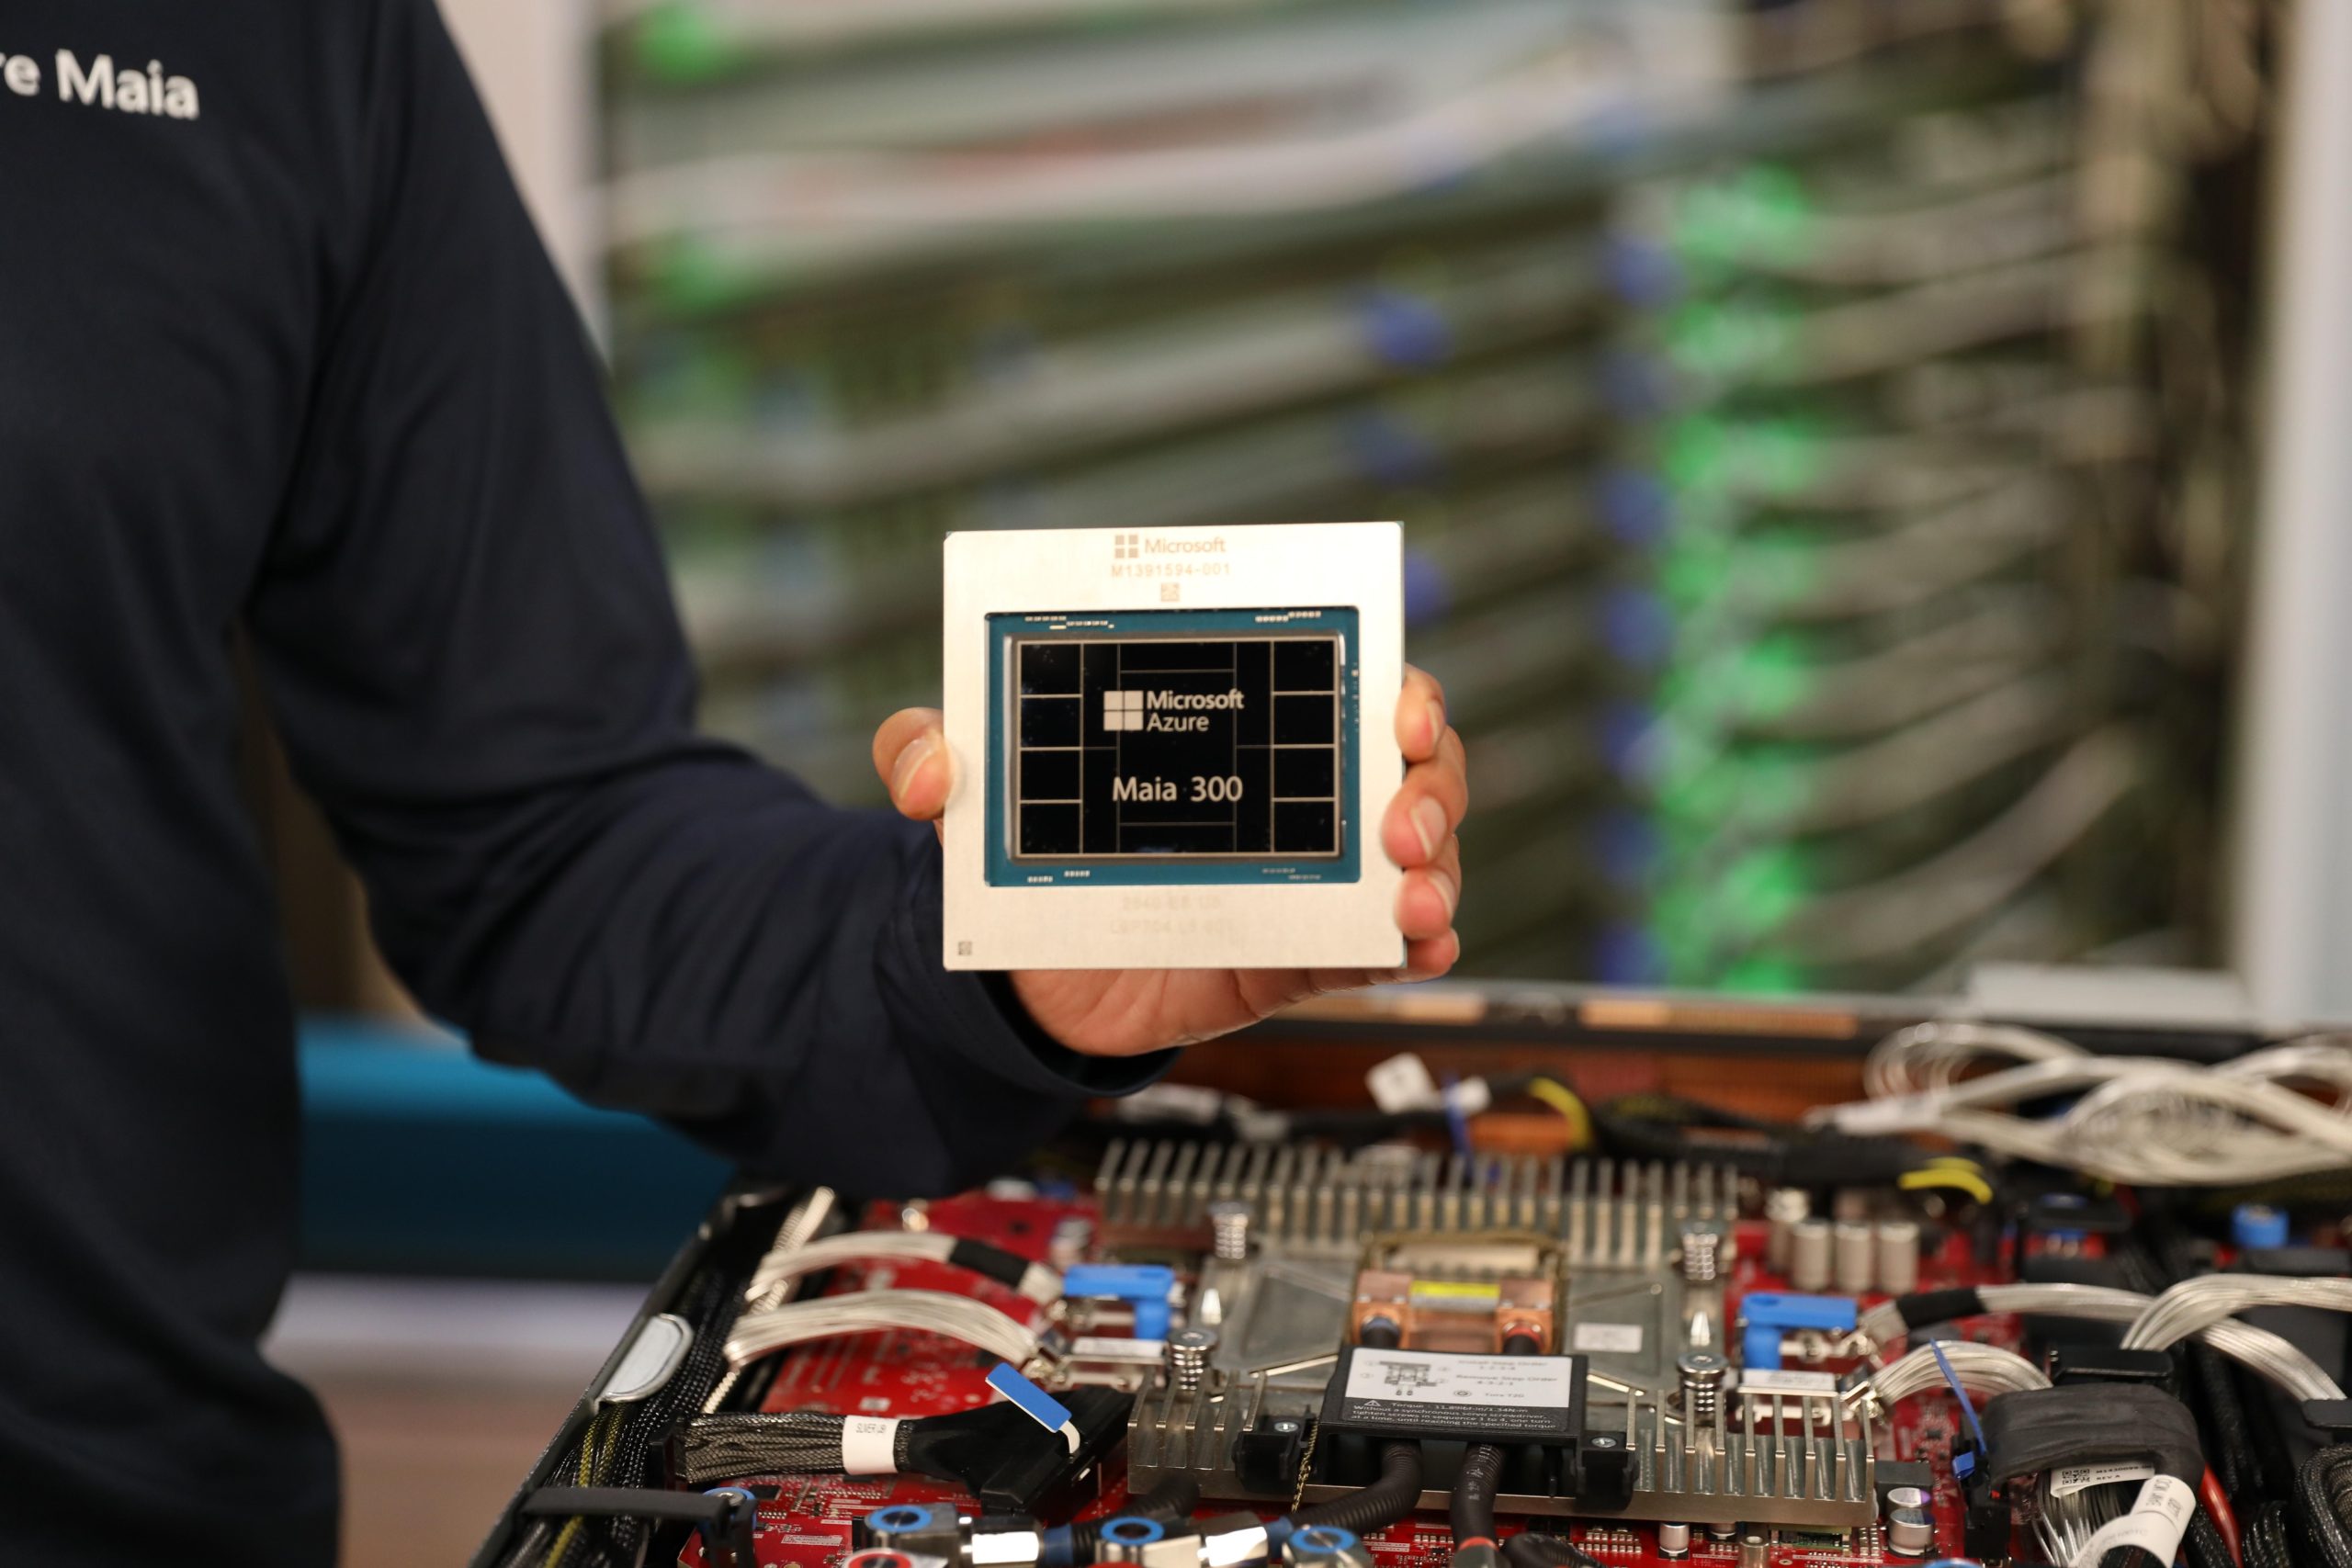
Maia 300 cho thấy Microsoft muốn tự kiểm soát thêm một tầng của dịch vụ AI: phần cứng chạy mô hình trong Azure. Chip được thiết kế chủ yếu cho suy luận — giai đoạn mô hình tạo câu trả lời — với các tác vụ dài ngữ cảnh, hội thoại cần độ trễ thấp và những quy trình AI nhiều bước.
Điều đó khác với việc thay thế GPU trên mọi máy chủ hay đưa một bộ xử lý mới ra thị trường PC. Maia 300 là một hệ thống trung tâm dữ liệu; người dùng Copilot tại Việt Nam không mua chip này và cũng không có lựa chọn bật/tắt nó trên máy cá nhân. Nếu Microsoft phân bổ thêm workload sang Maia, thay đổi người dùng có thể cảm nhận nằm ở năng lực, độ ổn định hoặc chi phí vận hành dịch vụ, chứ không phải cấu hình máy họ đang dùng.
Con số 40% token mỗi megawatt chưa đủ để kết luận Maia nhanh hơn
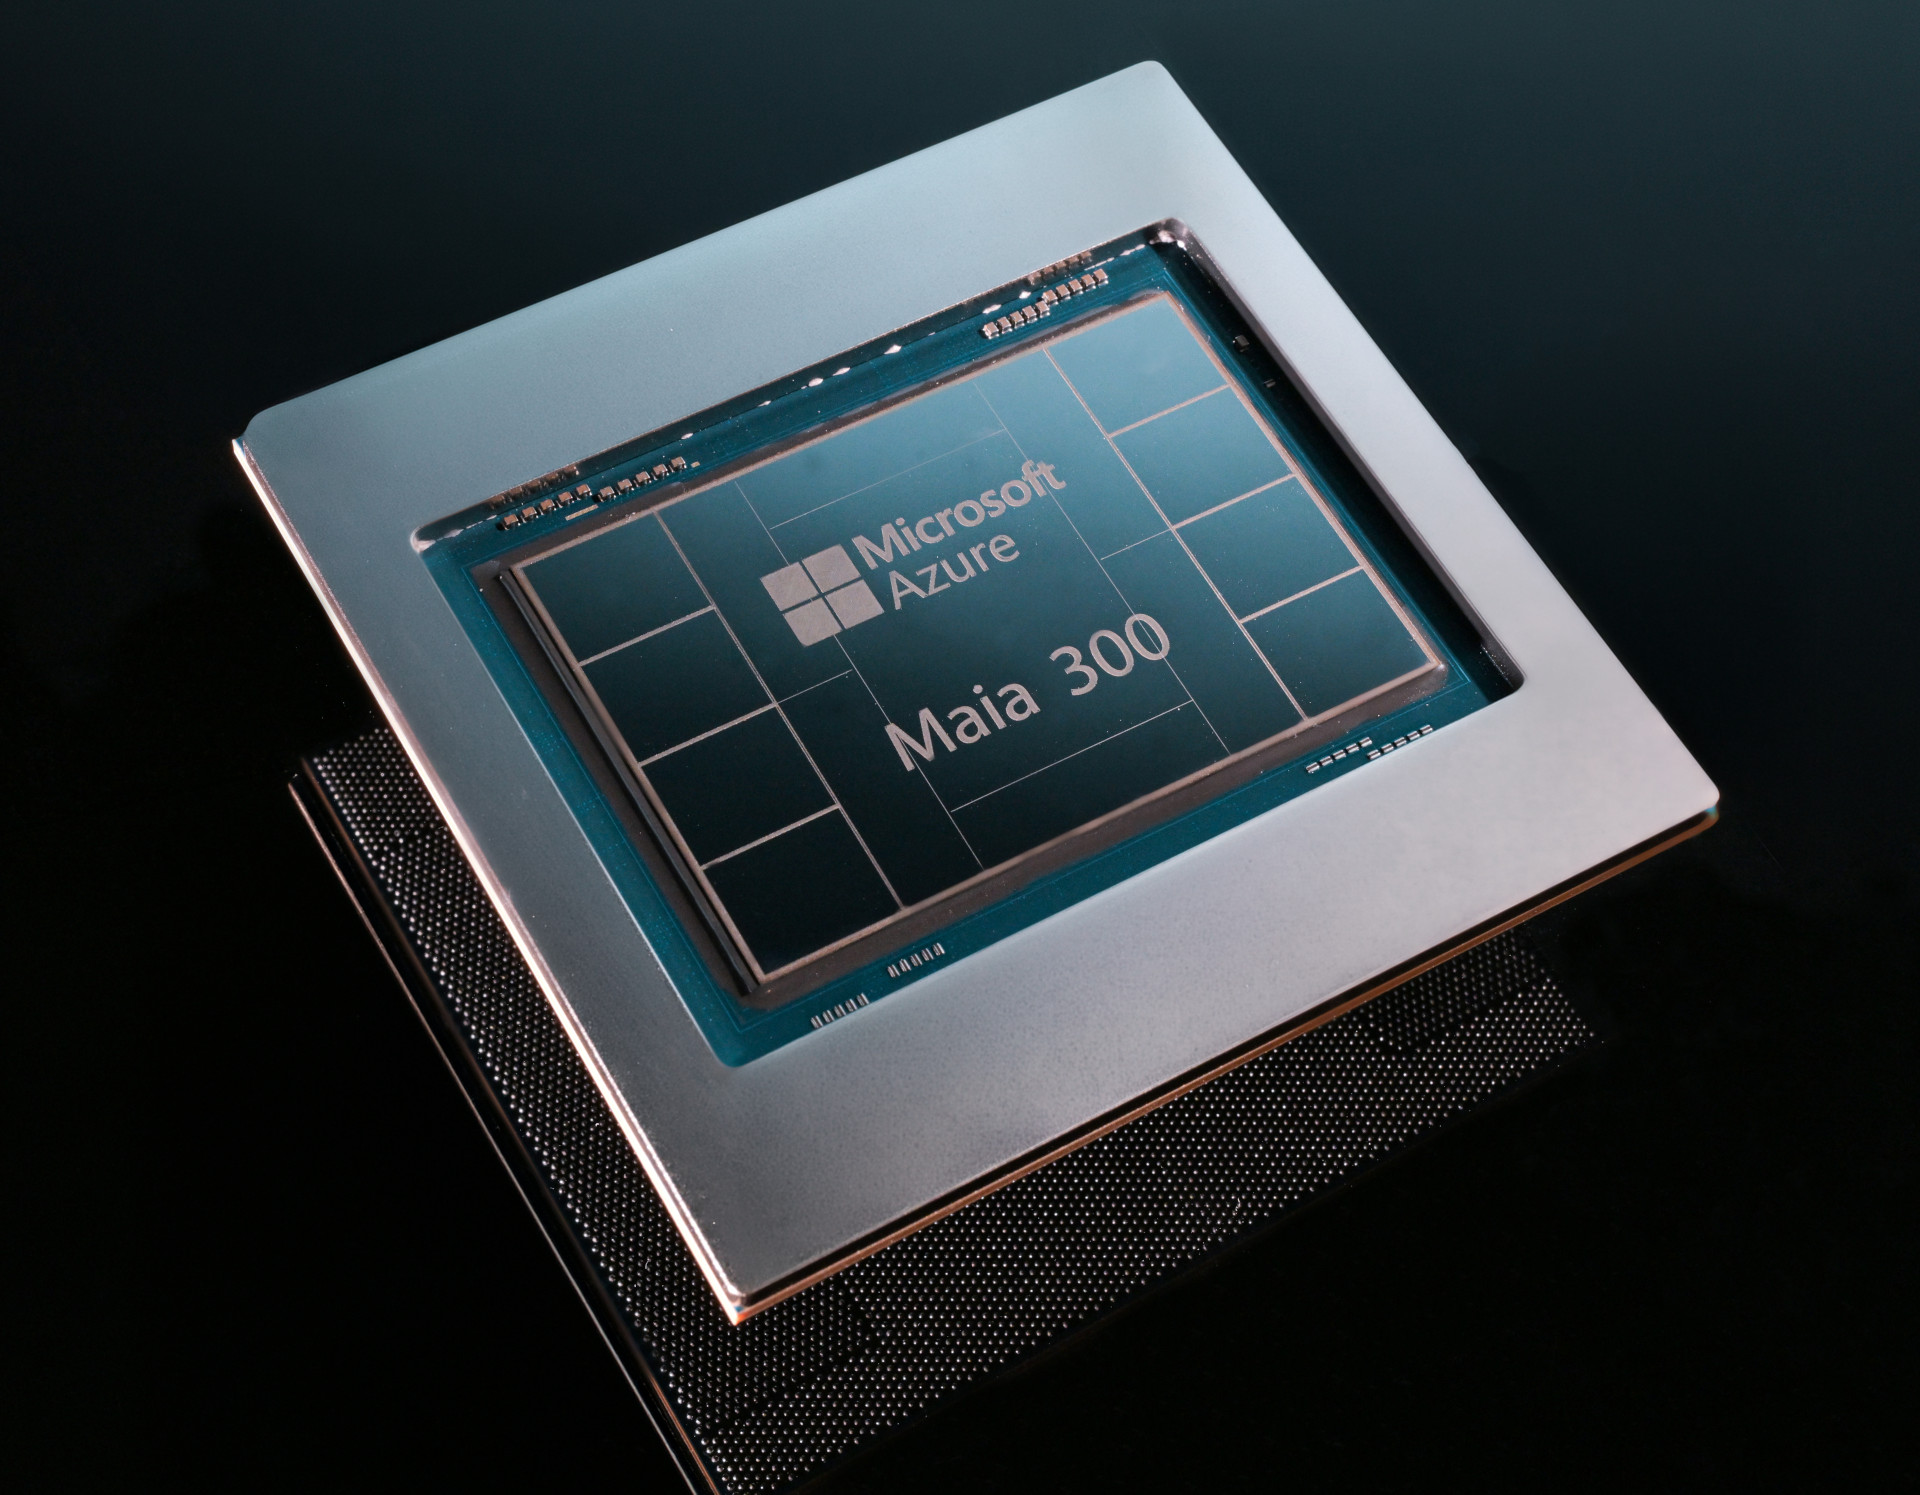
Microsoft nói Maia 300 tạo ra nhiều hơn 40% token trên mỗi megawatt so với “các hệ thống GPU hàng đầu”. Đây là một thước đo hiệu suất trên điện năng ở quy mô hạ tầng, không phải khẳng định mỗi câu trả lời sẽ nhanh hơn 40%. Tốc độ phản hồi còn phụ thuộc model, độ dài đầu vào và đầu ra, mức tải đồng thời, phần mềm phục vụ và cách phân bổ năng lực tính toán.
Điểm còn thiếu là định nghĩa cụ thể của nhóm GPU đối chứng, cấu hình máy chủ, phiên bản mô hình và phương pháp đo. Không có các thông tin đó, con số của Microsoft mô tả mục tiêu hiệu quả mà hãng đạt được trong hệ thống của mình, nhưng chưa cho phép bên ngoài so sánh ngang hàng hay kiểm tra độc lập. Vì thế, không nên đọc “40% token/MW” như một lời xác nhận rằng Maia 300 vượt một GPU cụ thể trong mọi tác vụ.
Microsoft cũng cho biết một rack đủ 96 accelerator có thể đạt thông lượng token tối đa gấp 7 lần rack Maia 200. Đây là so sánh giữa hai thế hệ Maia trong cấu hình cấp rack; nó không nói một chip Maia 300 nhanh gấp bảy lần Maia 200, càng không đồng nghĩa mỗi người dùng nhận câu trả lời nhanh gấp bảy lần. Thông lượng tổng thể phản ánh lượng công việc hệ thống xử lý được, thường có ý nghĩa nhất khi phục vụ nhiều yêu cầu song song.
Thiết kế ưu tiên bộ nhớ và đường đi dữ liệu cho suy luận quy mô lớn
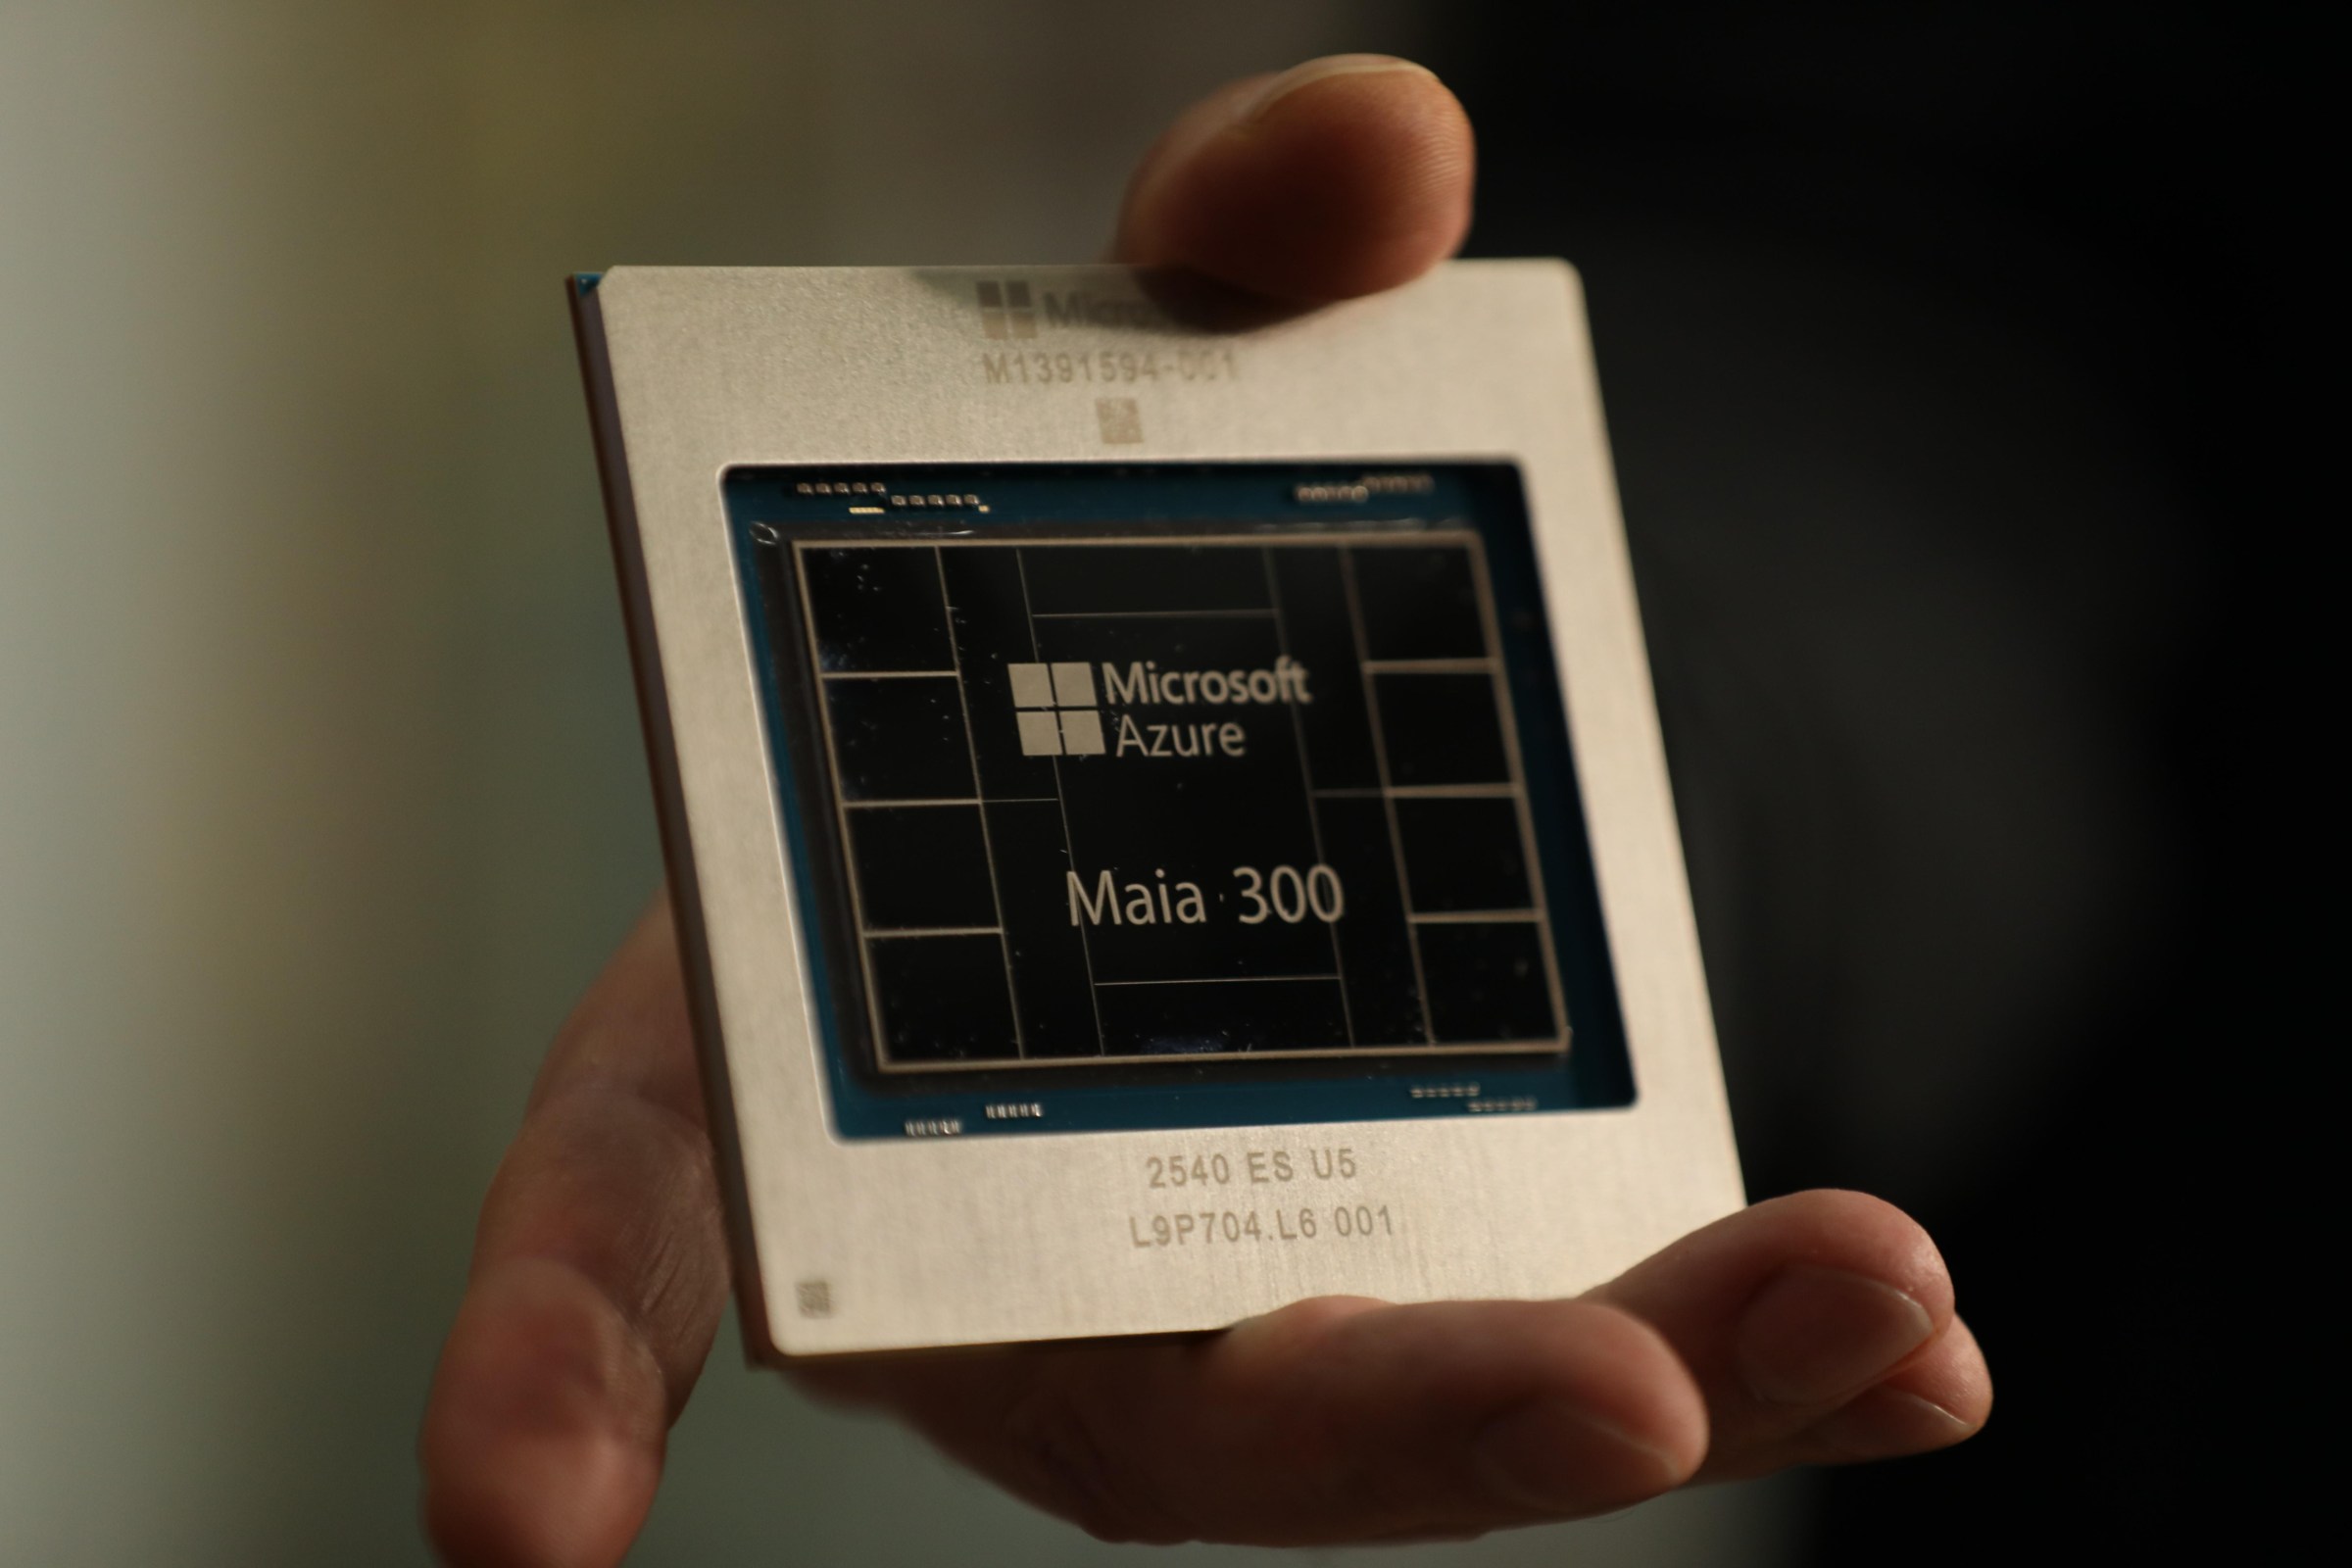
Với suy luận AI, năng lực tính toán thô không phải lúc nào cũng là nút thắt duy nhất. Mô hình lớn cần chuyển trọng số và dữ liệu liên tục giữa bộ nhớ, bộ xử lý và các accelerator; nếu việc di chuyển dữ liệu làm hệ thống chờ, thêm phép tính không tự động tăng hiệu suất tương ứng.
Microsoft mô tả Maia 300 theo hướng cân bằng compute, băng thông bộ nhớ, kết nối và điện năng. Hệ thống dùng tám stack HBM4, băng thông bộ nhớ đỉnh được công bố là 18 TB/s và TDP mỗi accelerator là 950 W. Các thông số này là thiết kế do hãng công bố, không phải kết quả đo độc lập. Kiến trúc chiplet tách compute, bộ điều khiển bộ nhớ và I/O; phần compute dùng tiến trình TSMC N2P. Mục tiêu là dành diện tích silicon và công nghệ phù hợp cho từng khối chức năng thay vì buộc toàn bộ chip dùng cùng một cách thiết kế.
Ở cấp rack, cấu hình 96 accelerator có công suất trong giới hạn 167 kW, tổng dung lượng HBM 27,6 TB và băng thông HBM cộng gộp 1,7 PB/s theo thông số Microsoft công bố. Quy mô này cho thấy Maia 300 được thiết kế để tăng năng lực phục vụ trong trung tâm dữ liệu, nhưng cũng nhấn mạnh đây là bài toán hạ tầng: điện, làm mát, mạng và phần mềm phải vận hành cùng nhau. Chỉ nhìn vào thông số chip sẽ không cho biết chi phí trên mỗi câu trả lời sau khi tính cả rack và hệ thống Azure.
Azure Maia có thể giảm lệ thuộc nguồn cung, nhưng chưa xóa được vai trò GPU
Tự phát triển accelerator giúp Microsoft có thêm quyền chủ động khi tối ưu phần cứng cho dịch vụ và mô hình của mình. Hãng có thể thiết kế chip quanh các workload thường gặp trong Azure, thay vì chỉ điều chỉnh phần mềm để phù hợp với phần cứng mua từ bên ngoài. Đây là lợi thế chiến lược nếu phần cứng, mô hình và nền tảng phục vụ được đồng thiết kế hiệu quả.
Nhưng “tự chủ” không đồng nghĩa toàn bộ nhu cầu tính toán sẽ chuyển sang Maia. Các dịch vụ đám mây phải chạy nhiều loại mô hình và workload; khả năng hỗ trợ phần mềm, tính linh hoạt và nguồn cung accelerator khác vẫn có ý nghĩa. Microsoft chưa công bố tỷ lệ workload dự kiến chuyển sang Maia 300, cũng chưa đưa ra lộ trình ngừng dùng GPU của Nvidia hay AMD. Vì vậy, cách hiểu hợp lý hiện nay là Maia mở rộng lựa chọn phần cứng của Azure, không phải bằng chứng GPU bên thứ ba sắp biến mất.
Copilot chỉ hưởng lợi khi chip đi vào dịch vụ và phép đo được công khai
Microsoft dự kiến Maia 300 bắt đầu triển khai sản xuất năm 2027. Hãng cho biết Maia 200 đang phục vụ một số workload sản xuất, trong đó có Microsoft Copilot; GitHub Copilot và Microsoft Foundry được dự kiến tiếp nối Maia 200 vào cuối năm 2026. Đây là bối cảnh cho thấy Microsoft đã đưa chip tự thiết kế vào vận hành, nhưng không chứng minh Maia 300 đã cải thiện trải nghiệm người dùng hiện tại.
Người dùng sẽ cần chờ những tín hiệu cụ thể hơn: Maia 300 thực sự phục vụ dịch vụ nào, ở khu vực Azure nào, và Microsoft có công bố độ trễ, năng lực xử lý hoặc chi phí trên workload tương đương hay không. Nếu thiếu các phép đo đó, tuyên bố hiệu suất vẫn hữu ích để hiểu hướng thiết kế, nhưng chưa đủ để dự đoán Copilot sẽ nhanh hơn bao nhiêu hoặc giá dịch vụ sẽ giảm.
Với doanh nghiệp dùng Azure, câu hỏi thực tế cũng không phải chỉ là chip nào nằm trong rack. Điều đáng theo dõi là liệu Microsoft có cung cấp lựa chọn triển khai rõ ràng, hiệu năng ổn định với mô hình đang dùng và mức giá tốt hơn cho workload suy luận hay không. Maia 300 có thể giúp hãng tối ưu dịch vụ từ bên trong; giá trị cuối cùng chỉ hiện ra khi các cải thiện đó chuyển thành kết quả đo được ở cấp dịch vụ.
Nguồn tham khảo: Microsoft; Azure Architecture Blog; The Verge; TechRadar