Tóm tắt nhanh
- Meta phát hành trọng số Muse Spark Open, mô hình đa phương thức có 816 tỷ tham số tổng, trong đó 42 tỷ tham số được kích hoạt cho mỗi token.
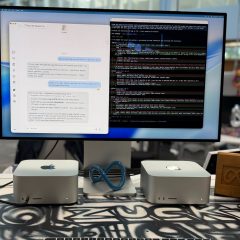
- Meta và Apple tối ưu mô hình để chạy qua MLX trên cụm hai Mac Studio dùng chip M5 Ultra; mỗi máy có thể cấu hình tối đa 512 GB bộ nhớ hợp nhất.
- Ước tính lượng tử hóa 4-bit vẫn cần khoảng 493 GB chỉ cho trọng số, chưa tính bộ nhớ làm việc, nên một máy 512 GB gần như không còn khoảng trống.
- Thông lượng được nêu là khoảng 20 token/giây trên hai máy và 36 token/giây trên bốn máy; đây là kết quả trong cấu hình thử nghiệm cụ thể, không phải tốc độ bảo đảm cho mọi tác vụ.
Muse Spark Open của Meta có 816 tỷ tham số nhưng không cần một siêu máy chủ duy nhất để chạy thử tại chỗ: Meta tối ưu mô hình cho cụm hai Mac Studio M5 Ultra thông qua framework MLX của Apple. Điểm đáng bàn không nằm ở con số tham số lớn, mà ở việc bộ nhớ hợp nhất của hai máy được gom lại để chứa trọng số vốn đã sát giới hạn của một máy 512 GB.
MoE giảm lượng tính toán mỗi token, không làm biến mất nhu cầu chứa trọng số
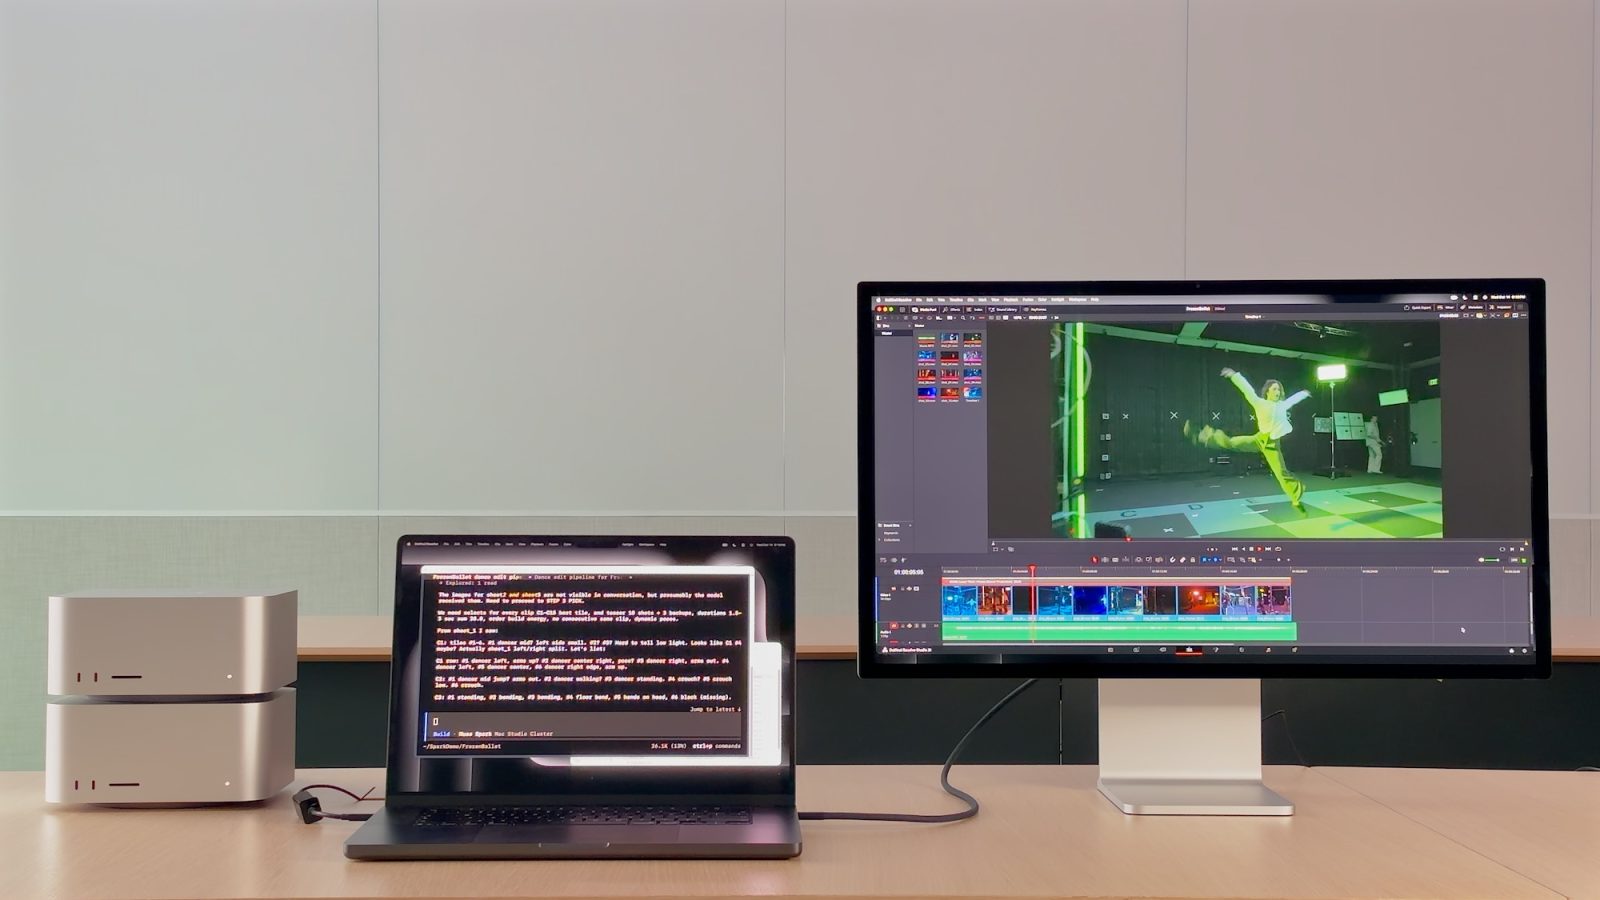
Muse Spark Open dùng kiến trúc Mixture of Experts (MoE): mô hình có 816 tỷ tham số tổng, nhưng chỉ kích hoạt 42 tỷ tham số tại một thời điểm. Cách chia này giúp giảm phần tính toán cần thực hiện cho từng token so với việc dùng toàn bộ tham số cùng lúc; tuy vậy, hệ thống vẫn phải bố trí được các trọng số của những chuyên gia mà mô hình có thể gọi đến.
Đó là lý do “42 tỷ tham số đang hoạt động” không đồng nghĩa mô hình chỉ cần bộ nhớ cho 42 tỷ. Theo ước tính được Wccftech dẫn lại, riêng trọng số ở mức lượng tử hóa 4-bit cần khoảng 493 GB. Mức đó đã gần chạm trần 512 GB của một Mac Studio trước khi dành bộ nhớ cho ngữ cảnh, hệ điều hành và các tiến trình phục vụ suy luận.
Cửa sổ ngữ cảnh 1 triệu token làm bài toán bộ nhớ càng đáng lưu ý. Đây là giới hạn ngữ cảnh được công bố cho mô hình, không phải cam kết rằng một cấu hình cụ thể có thể xử lý đủ một triệu token cùng lúc ở tốc độ cao; bộ nhớ dành cho phần ngữ cảnh và trạng thái tác vụ còn tùy cách triển khai.
Hai máy giải bài toán dung lượng, còn tốc độ phụ thuộc cách ghép cụm
Meta cho biết Muse Spark Open được tối ưu để chạy trên Mac Studio M5 Ultra bằng phiên bản mới nhất của MLX. Theo thông số được công bố, mỗi máy có thể dùng tối đa 512 GB bộ nhớ hợp nhất và chip có băng thông bộ nhớ 1,2 TB/s. Ghép hai máy tạo ra tổng dung lượng danh nghĩa 1 TB, đủ chỗ hơn cho trọng số cùng phần bộ nhớ vận hành mà một máy đơn lẻ khó đáp ứng.
Tuy nhiên, hai máy không tự biến thành một máy có bộ nhớ liền mạch chỉ bằng cách nối cáp. Phần mềm phải phân phối trọng số và công việc giữa các thiết bị, còn dữ liệu phải di chuyển qua kết nối cụm. Băng thông bộ nhớ cao của từng chip có ích khi đọc dữ liệu trong máy, nhưng không thể xem đó là băng thông Thunderbolt giữa hai máy; hiệu năng thực tế còn tùy cách MLX phân chia mô hình và trao đổi dữ liệu.
Wccftech dẫn mức thông lượng khoảng 20 token/giây khi hai Mac Studio M5 Ultra nối qua Thunderbolt chạy MLX, và khoảng 36 token/giây với bốn máy. Các con số này cần được đọc kèm cấu hình: chúng không cho biết đầy đủ độ dài đầu vào, thiết lập lượng tử hóa hay cách đo từng lượt sinh. Vì vậy, chưa thể suy ra từ đó tốc độ của một phiên làm việc dài, có nhiều công cụ hoặc xử lý video.
Mô hình mở đưa AI về máy cá nhân, nhưng chi phí vẫn ở cấp workstation
Việc phát hành trọng số mở trên Hugging Face giúp nhà phát triển có thể tải mô hình và thử các cách triển khai riêng, thay vì chỉ truy cập qua một dịch vụ đám mây. Meta mô tả Muse Spark Open hướng tới lập trình và các tác vụ agent nhiều bước; bài công bố cũng nêu khả năng xử lý đa phương thức. Những khả năng này mới là mục tiêu do hãng giới thiệu, không nên đánh đồng với đánh giá độc lập về độ ổn định hay chất lượng đầu ra.
Rào cản lớn là phần cứng. CellphoneS niêm yết Mac Studio M5 Ultra bản cấu hình tiêu chuẩn từ 159.990.000 đồng tại Việt Nam, còn cấu hình 512 GB cần kiểm tra giá và tình trạng đặt hàng riêng. Mức giá này cho thấy chạy một mô hình rất lớn tại chỗ vẫn là lựa chọn cho phòng lab, nhóm phát triển hoặc đơn vị cần kiểm soát dữ liệu; nó chưa phải con đường tiết kiệm cho người dùng cá nhân chỉ muốn dùng chatbot.
Quan hệ hợp tác giữa Meta và Apple cũng đáng chú ý ở góc phần mềm: Meta có mô hình và hệ công cụ AI, còn Apple có MLX cùng kiến trúc bộ nhớ hợp nhất trên Apple Silicon. Cách ghép này cho thấy một hướng triển khai khác với việc phụ thuộc hoàn toàn vào GPU máy chủ, nhưng chưa đủ dữ kiện để kết luận nó thay thế được hạ tầng NVIDIA ở quy mô lớn. Giá của cụm máy, khả năng mở rộng và tốc độ trên các tác vụ thực tế vẫn là những câu hỏi cần thêm phép đo độc lập.
Mac Studio tại Việt Nam chưa phải lựa chọn hợp lý chỉ vì Muse Spark Open
Với người dùng tại Việt Nam, cấu hình Mac Studio tiêu chuẩn đang được niêm yết từ 159.990.000 đồng ở CellphoneS, nhưng mức giá đó không tự bảo đảm máy có đủ bộ nhớ cho mô hình. Muse Spark Open cần cụm nhiều máy theo cách Meta mô tả; nếu mục tiêu chỉ là thử AI tạo sinh, dịch vụ đám mây hoặc mô hình nhỏ hơn có thể thực tế hơn nhiều về chi phí và thiết lập.
Nhóm có lý do rõ hơn để quan tâm là nhà phát triển muốn thử suy luận cục bộ, nghiên cứu MLX hoặc kiểm soát dữ liệu không rời khỏi thiết bị. Trước khi đầu tư, cần chờ hướng dẫn triển khai chính thức, xác nhận cấu hình bộ nhớ thực sự hỗ trợ, rồi xem các phép đo độc lập về độ trễ, mức tiêu thụ điện và chất lượng trên cùng bộ tác vụ.
Điểm còn thiếu là phép đo độc lập trên cùng một bộ tác vụ
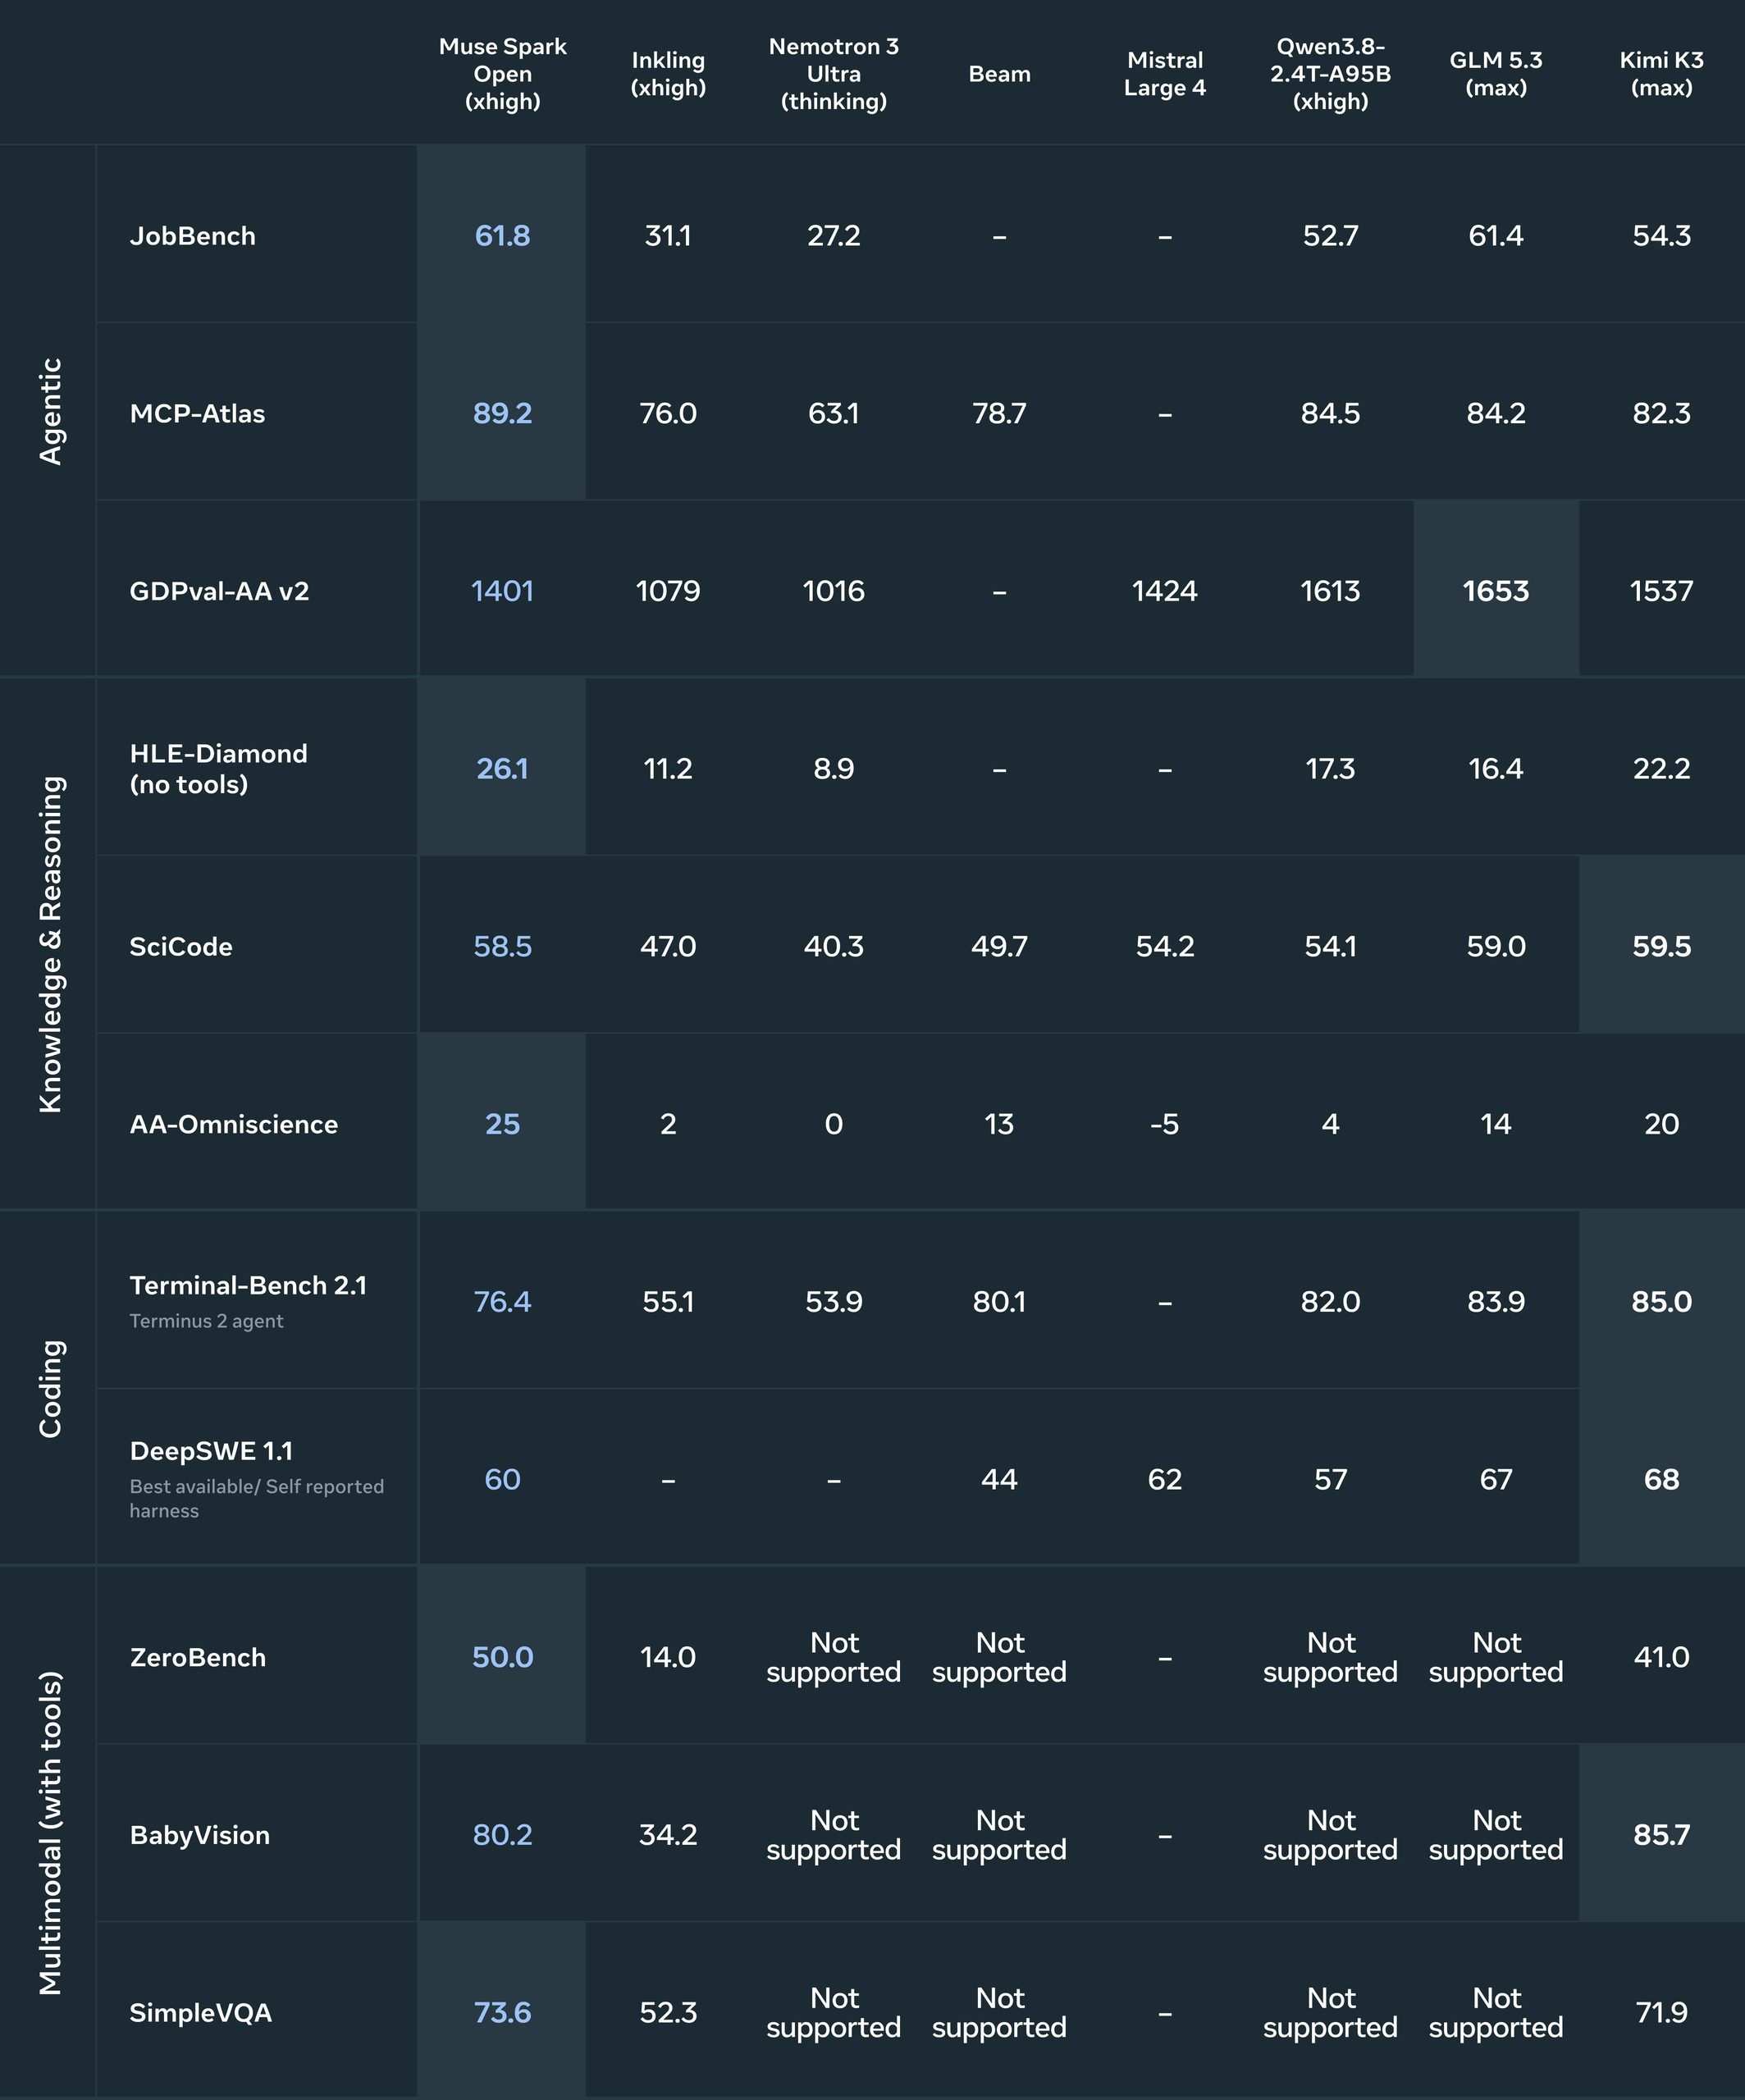
Hiện các thông tin đáng chú ý tập trung vào thông số mô hình, cách tối ưu cho Mac và mức thông lượng được dẫn lại từ cấu hình cụ thể. Chưa có đủ dữ liệu trong các nguồn đã kiểm tra để so sánh chi phí mỗi token, độ trễ đầu-cuối hay chất lượng Muse Spark Open với những mô hình khác trong cùng điều kiện. Vì thế, giá trị dễ thấy nhất lúc này là khả năng đưa một mô hình quy mô lớn lên cụm máy để bàn; lợi thế thực dụng so với thuê GPU đám mây vẫn cần được chứng minh bằng phép đo và tổng chi phí vận hành.
Nguồn tham khảo: 9to5Mac, Wccftech, The Verge, CellphoneS.