Tóm tắt nhanh
- NVIDIA thiết kế Vera với 88 nhân Olympus trên một compute die nguyên khối, thay vì ghép nhiều chiplet như phần lớn CPU máy chủ hiện nay.
- Lý do là tác tử AI chạy xen kẽ giữa CPU và GPU. Một đoạn tuần tự chậm trên CPU sẽ khiến GPU đắt tiền phải chờ.
- NVIDIA công bố Vera nhanh hơn Grace 1,5 lần và nhanh hơn CPU x86 đầu bảng tới 2 lần trên tác vụ tuần tự. Đây là số do hãng đo trong điều kiện của mình.
- Vera nhắm tới trung tâm dữ liệu. Chưa có thông tin về kênh bán lẻ hay giá tại Việt Nam.
Vì sao NVIDIA Vera quay lại thiết kế CPU nguyên khối cho AI tác tử?
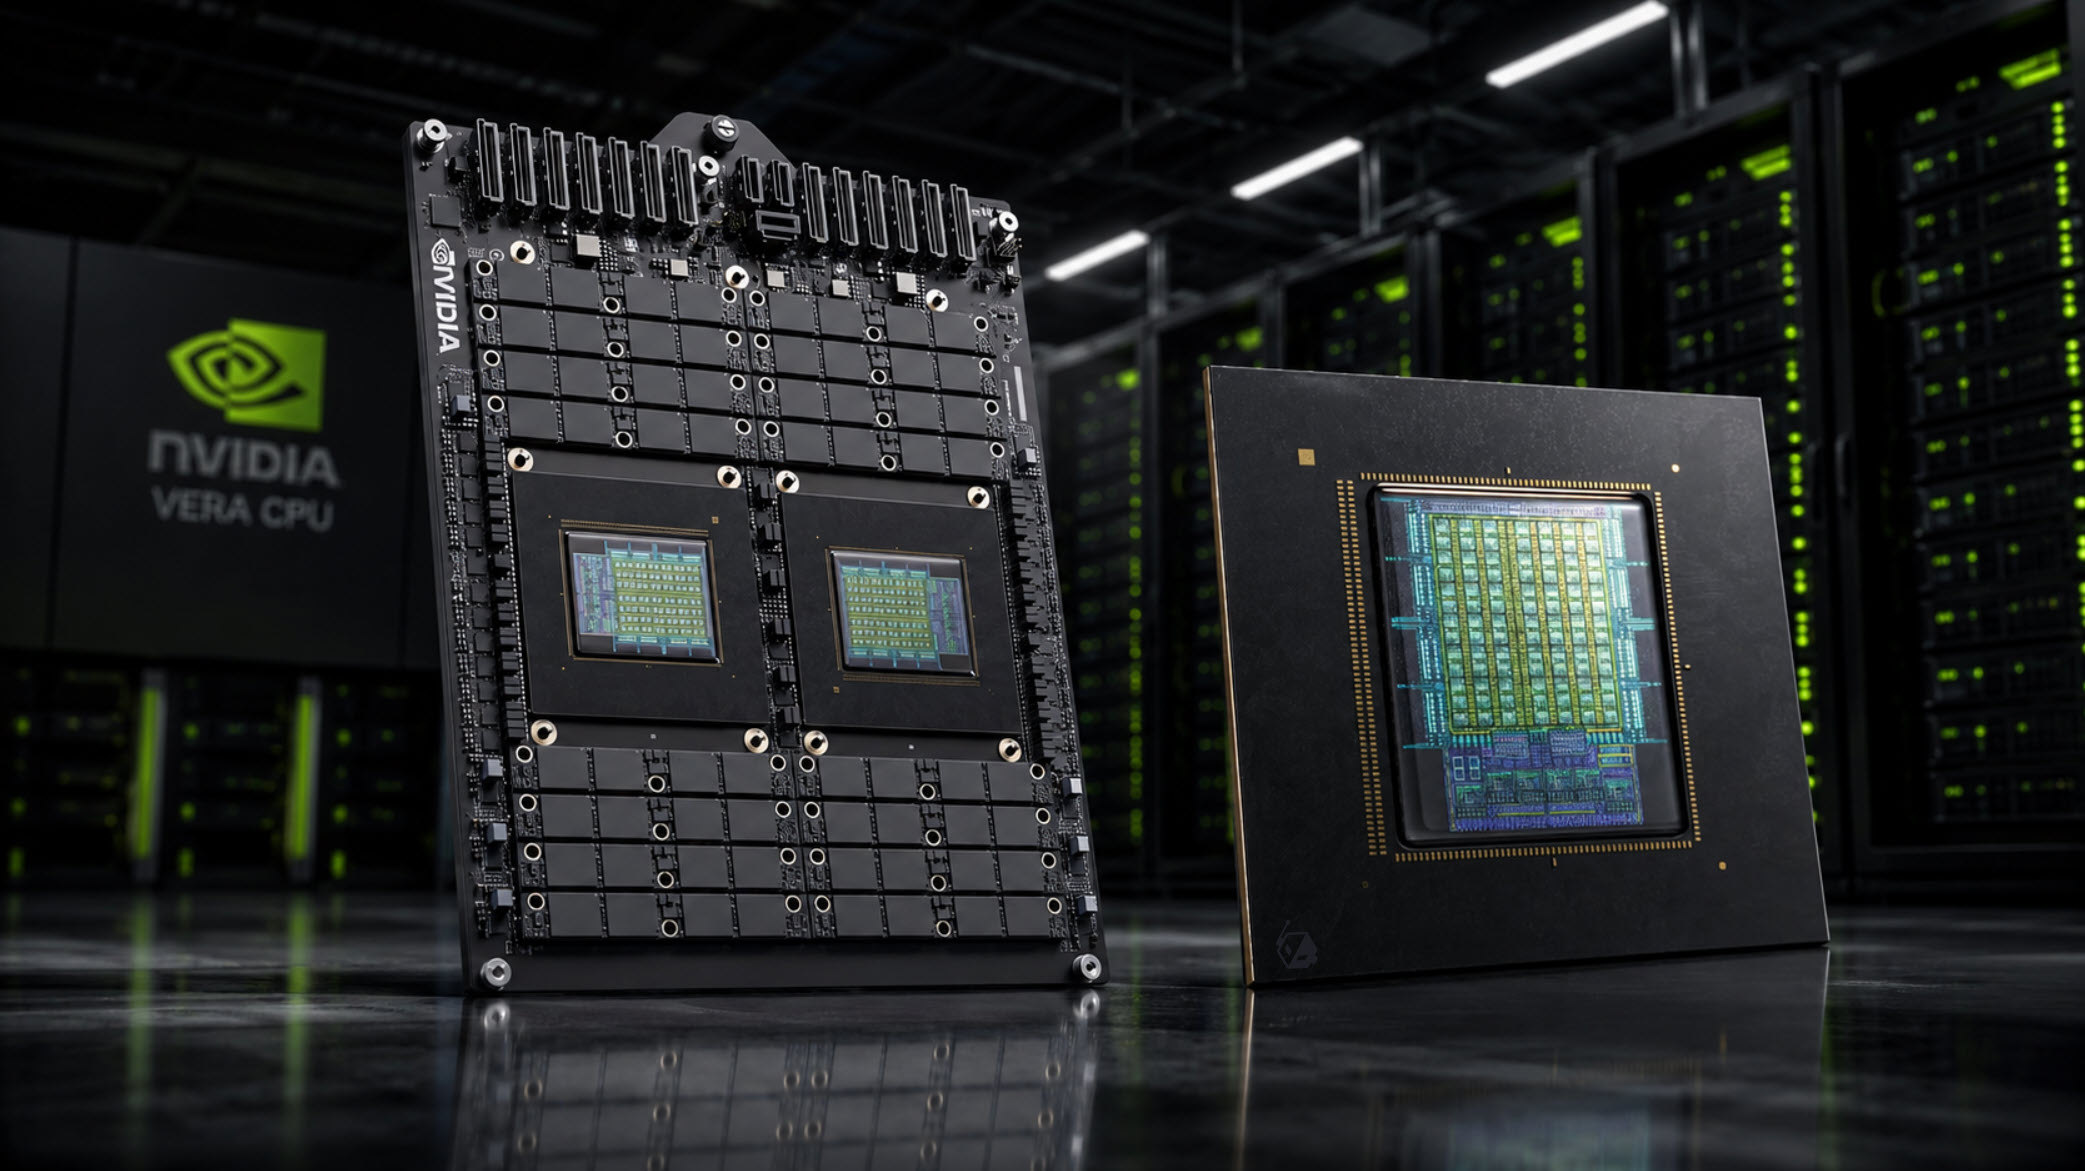
NVIDIA đi ngược hướng mà phần lớn ngành CPU máy chủ đã theo gần một thập kỷ. Khi các hyperscaler muốn nhồi thật nhiều nhân vào một máy chủ, AMD và Intel chuyển sang chiplet để tăng mật độ và giữ chi phí. Cái giá là tốc độ từng nhân và IPC bị hy sinh, vì chiplet không để lại nhiều chỗ trên die cho việc tối ưu từng nhân. Đội ngũ Vera cho rằng đánh đổi đó nay không còn phù hợp với tải AI tác tử.
Lý do nằm ở nhịp làm việc của một tác tử. Tác tử đọc kết quả, chọn công cụ, chạy một đoạn mã trong sandbox rồi mới gửi bước kế tiếp về GPU. Phần việc tuần tự này không thể song song hóa hết, nên nó hưởng lợi trực tiếp từ hiệu năng đơn luồng và độ trễ ổn định. CPU hoàn thành chậm thì GPU, vốn là tài sản đắt nhất trong cụm AI, sẽ nằm không. Logic này hợp lý về mặt vận hành. Mức độ ảnh hưởng với từng khối lượng công việc thì còn tùy cách triển khai.
Die nguyên khối đổi mật độ nhân lấy đường đi dữ liệu ngắn hơn
Trên Vera, 88 nhân Olympus, bộ nhớ đệm dùng chung và fabric kết nối nằm chung trên một compute die. Scalable Coherency Fabric thế hệ hai đạt băng thông bisection tối đa 3,4 TB/s và nối tới bộ nhớ đệm L3 hợp nhất 164 MB. Khi hai nhân ở hai đầu chip cần chia sẻ ngữ cảnh, dữ liệu không phải đi qua ranh giới giữa các die. NVIDIA nói phép giao tiếp này nhanh hơn 3 lần so với chip x86 hàng đầu. Con số đến từ chính hãng và chưa có phép đo độc lập nào đối chiếu.
Thiết kế nguyên khối cũng có giá phải trả. Một die lớn tốn diện tích, khó mở rộng theo kiểu ghép khối như chiplet làm được, và chịu giới hạn chế tạo riêng. Chiplet vẫn linh hoạt hơn khi cần ghép nhiều khối và tối ưu chi phí. NVIDIA không xem đây là tín điều. Đội Vera nói hãng sẽ chọn kiến trúc theo cơ hội thị trường cụ thể. Vì vậy Vera là lời giải cho một bài toán hẹp, không phải bằng chứng rằng chiplet đã lỗi thời.
88 nhân, bộ nhớ băng thông cao và SMT nhắm vào tải đồng thời
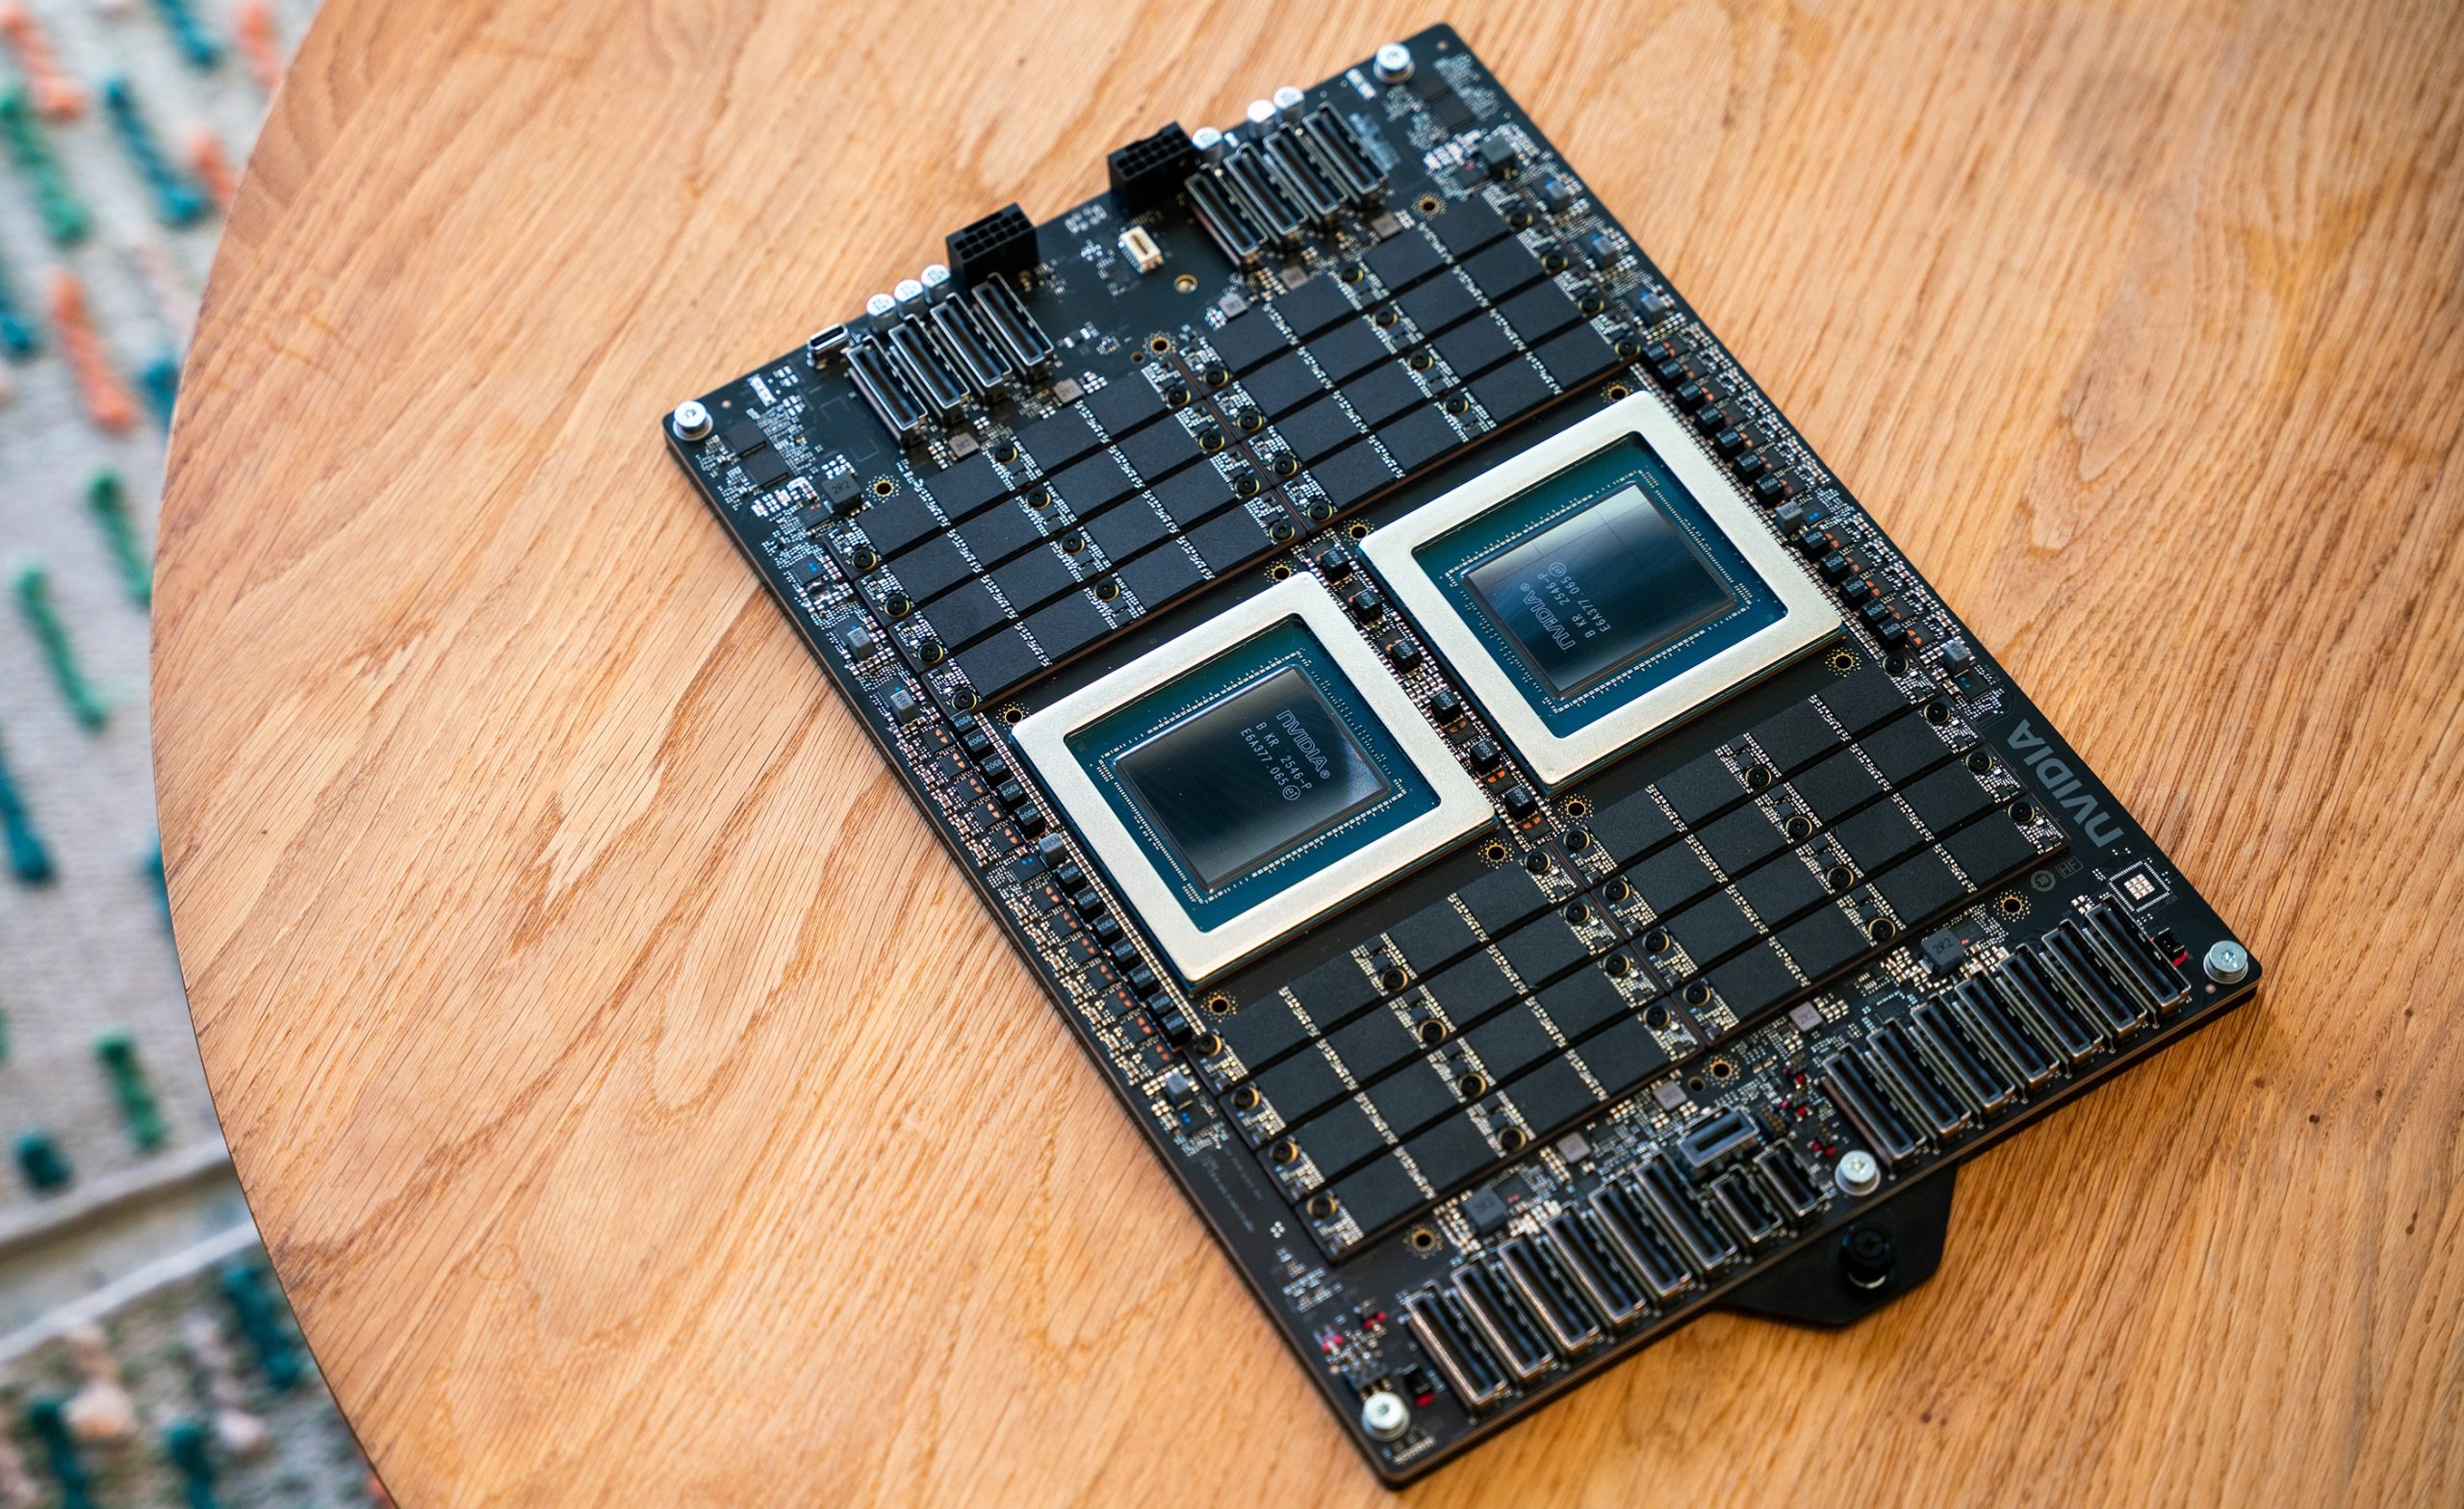
Vera có 88 nhân Olympus với 176 luồng phần cứng. Bộ nhớ SOCAMM2 LPDDR5X đạt tổng băng thông tối đa 1,2 TB/s, tương đương tối đa 14 GB/s mỗi nhân. Theo tài liệu kỹ thuật của NVIDIA, Olympus có bộ giải mã 10 lệnh mỗi chu kỳ và bộ dự đoán nhánh neural. Các thông số này nhắm vào việc giữ nhân luôn có dữ liệu khi nhiều tác vụ chạy cùng lúc. Riêng thông số thì chưa cho biết ứng dụng thật chạy nhanh đến đâu.
| Thông số | Vera theo NVIDIA |
|---|---|
| Số nhân Olympus | 88 |
| Luồng phần cứng (SMT) | 176 |
| Bộ nhớ đệm L3 hợp nhất | 164 MB |
| Băng thông bisection của SCF | tối đa 3,4 TB/s |
| Băng thông LPDDR5X (SOCAMM2) | tối đa 1,2 TB/s |
| Băng thông bộ nhớ mỗi nhân | tối đa 14 GB/s |
Số liệu: NVIDIA Developer Blog.
Spatial Multithreading (SMT) của Vera không hoạt động như SMT thông thường. NVIDIA cấp phát riêng luồng worker và luồng I/O, để luồng xử lý chính không bị cướp chu kỳ chỉ vì tác vụ nền. Đội Vera nói Phoronix đo được mức tăng khoảng 20% với SMT trên Vera. Đây là số được nhắc lại trong cuộc phỏng vấn, chưa đối chiếu được với bản đo gốc, nên đọc như một tín hiệu tích cực hơn là kết luận.
Mốc 2 lần so với x86 cần đọc kỹ điều kiện
NVIDIA đưa ra ba mốc: nhanh hơn Grace 1,5 lần; nhanh hơn CPU x86 đầu bảng tới 2 lần trên tác vụ agentic tuần tự như chạy Python và biên dịch mã; và mức trung bình nhân 1,6 lần. Điều cần để ý là mốc 2 lần so với x86, không phải so với Grace. Hãng không nêu đầy đủ tên CPU đối thủ, cấu hình thử và cách đặt điều kiện công bằng về bộ nhớ, số nhân hay điện năng. Người đọc chưa thể tự kiểm tra con số này.
Với người theo dõi hạ tầng AI, đây là mốc đáng để ý nhưng chưa đủ để kết luận. Python hay biên dịch mã chỉ là một phần của tải agent, và giá hệ thống, mật độ rack hay mức tiêu thụ điện không có trong bản công bố. Cho đến khi bên độc lập đo lại, mốc 2 lần nên được hiểu là kỳ vọng của NVIDIA.
Vera là CPU cho trung tâm dữ liệu, chưa phải lựa chọn cho máy cá nhân
Điểm dễ hiểu nhầm nhất là Vera không phải CPU để người dùng lắp vào PC. Sản phẩm nhắm tới AI factory và máy chủ. NVIDIA cũng nói Vera không còn chỉ là một phần của stack Vera-Rubin, mà có thể triển khai thành rack CPU thuần để xử lý tool call và học tăng cường. Với người dùng Việt Nam, đây chủ yếu là tín hiệu về hướng đi của hạ tầng AI. Chưa có thông tin về kênh bán lẻ hay giá tại Việt Nam.
Câu hỏi thực sự với doanh nghiệp là khối lượng tác vụ điều phối, sandbox và xử lý dữ liệu có đủ nặng để một CPU chuyên dụng đáng đầu tư hay không. Trong cuộc phỏng vấn với Wccftech, một con số được nhắc tới là có nhà cung cấp sandbox chạy tới 400.000 sandbox cho một khách hàng. NVIDIA cũng nói hãng không có quan điểm về tỷ lệ CPU/GPU, nhưng tin tỷ lệ đó đang dịch về phía CPU. Hai dữ kiện này cùng hướng, nhưng chưa đủ để đoán quy mô thị trường. NVIDIA còn lập luận AMD và Intel phải phục vụ cả máy khách lẫn trung tâm dữ liệu bằng một kiến trúc, trong khi Vera chỉ nhắm tới một thị trường. Câu hỏi kế tiếp là AMD và Intel sẽ đáp lại bằng chiplet nhiều nhân hơn, hay tự chuyển hướng.
Vera cho thấy NVIDIA đặt cược rằng tải AI tác tử sẽ đưa CPU trở lại trung tâm. Lập luận về nút thắt tuần tự có cơ sở. Phần thưởng thực tế lại phụ thuộc vào benchmark độc lập, giá và điện năng, và những thứ này chưa được công bố đầy đủ. Người theo dõi nên chờ các phép đo đó trước khi coi Vera là chuẩn mới.
Nguồn tham khảo: NVIDIA Developer Blog; Wccftech