Tóm tắt nhanh
- Kimi K3.1 Pro đạt 55 điểm Artificial Analysis Intelligence Index, đứng thứ tư trong đánh giá lúc ra mắt, thấp hơn Claude Opus 5.5 đạt 58 điểm.
- Mô hình đã có trên các dịch vụ Kimi và API; Moonshot AI hẹn phát hành đầy đủ trọng số chậm nhất ngày 4/11/2026.
- Khả năng làm việc nhiều bước bằng công cụ tăng rõ, còn mức tăng ở các bài kiểm tra kiến thức và suy luận khiêm tốn hơn.
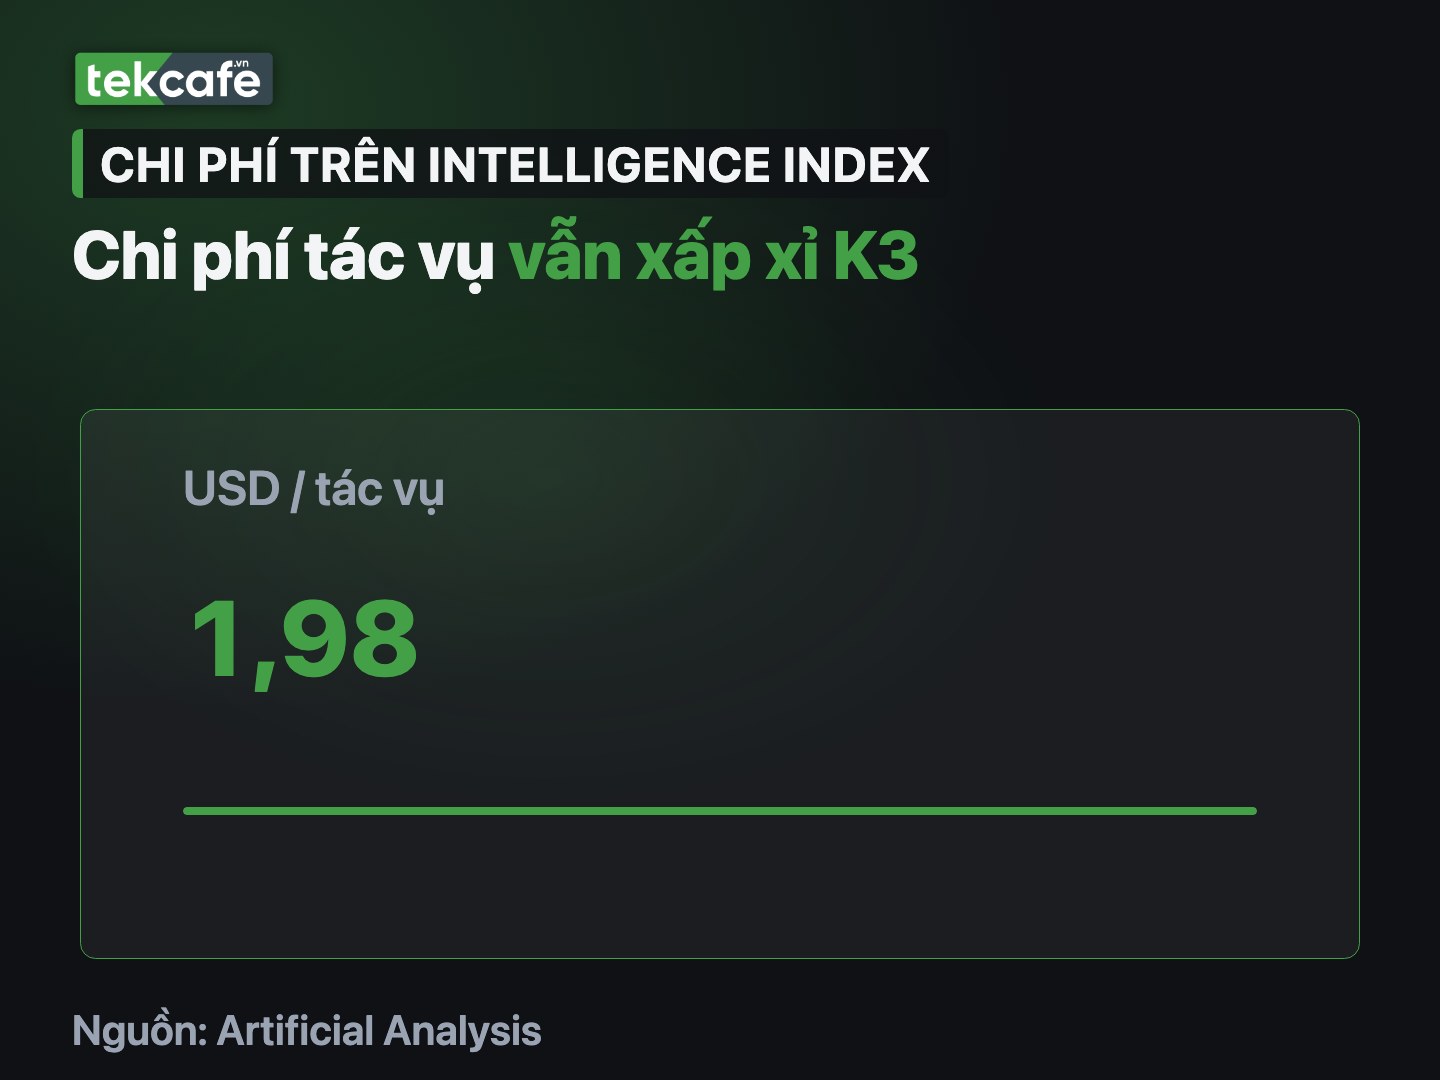
- Giá API giảm 33% so với Kimi K3, nhưng chi phí mỗi tác vụ trong phép đo của Artificial Analysis vẫn xấp xỉ thế hệ trước.
Moonshot AI công bố Kimi K3.1 Pro ngày 23/10, đưa mô hình lên mức 55 điểm trên Intelligence Index và tiến gần nhóm mô hình độc quyền dẫn đầu. Điểm đáng quan tâm với người xây ứng dụng là khả năng hoàn thành công việc bằng công cụ, trong khi danh hiệu dẫn đầu nhóm mở trọng số vẫn phải chờ hãng thực hiện lịch phát hành.
Có hai chuyện cần tách bạch: dịch vụ đã dùng được không có nghĩa trọng số đã tải được, còn giá mỗi token rẻ hơn không bảo đảm một quy trình tự động sẽ tốn ít tiền hơn. K3.1 Pro là lựa chọn đáng đưa vào thử nghiệm cho tác vụ lập trình và xử lý tài liệu, nhưng chưa có cơ sở để thay toàn bộ hệ thống đang chạy chỉ vì thứ hạng mới.
Khoảng cách thu hẹp trên bảng điểm, chưa phải chiến thắng toàn diện
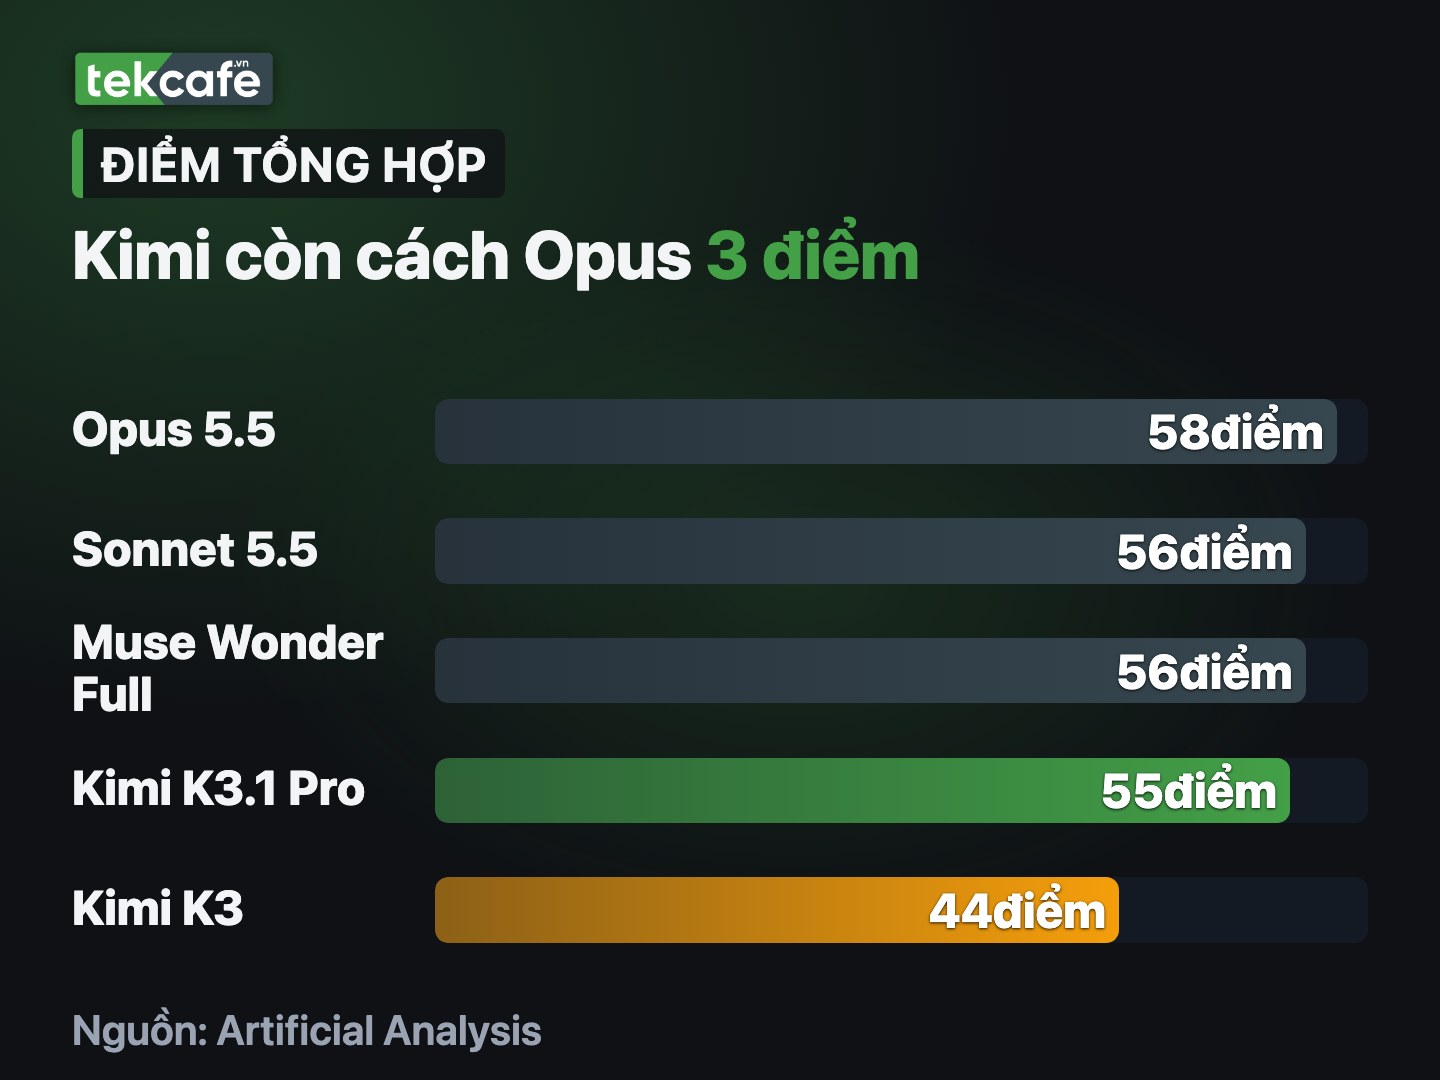
K3.1 Pro rút ngắn khoảng cách với nhóm đầu chủ yếu bằng tiến bộ ở các tác vụ có công cụ, thay vì tăng đều ở mọi năng lực. Đơn vị đánh giá Artificial Analysis (AA) ghi nhận mô hình tăng 11 điểm so với Kimi K3, từ 44 lên 55 điểm, trong khi Claude Opus 5.5 đạt 58 điểm ở cấu hình max có cơ chế fallback.
| Phép đo, cao hơn tốt hơn | Kimi K3.1 Pro | Claude Opus 5.5 | Claude Sonnet 5.5 | Muse Wonder Full |
|---|---|---|---|---|
| Intelligence Index, điểm | 55 | 58 | 56 | 56 |
| GDPval-AA, Elo | 1.846 | 1.866 | — | 1.857 |
| Terminal-Bench 4.0, % | 67 | — | 64 | — |
Số liệu: Artificial Analysis, đánh giá công bố ngày 23/10/2026. Opus và Sonnet dùng cấu hình max có fallback, Muse dùng max; dấu — là số không được nêu trong phần kết quả tương ứng.
Trên GDPval-AA, K3.1 Pro đứng thứ ba với 1.846 Elo, sau Opus và Muse; trong khi ở Terminal-Bench 4.0, mô hình đạt mức cao nhất trong đợt đo của AA. Một mô hình có thể đứng đầu phép thử thao tác terminal mà vẫn xếp sau ở chất lượng sản phẩm công việc, nên dùng một cột điểm để kết luận thắng mọi đối thủ là quá rộng.
| Phép đo | Kimi K3 | Kimi K3.1 Pro |
|---|---|---|
| Intelligence Index, điểm, cao hơn tốt hơn | 44 | 55 |
| GDPval-AA, Elo, cao hơn tốt hơn | 1.534 | 1.846 |
| Terminal-Bench 4.0, %, cao hơn tốt hơn | 13 | 67 |
| AutomationBench-AA, %, cao hơn tốt hơn | 58 | 73 |
| Humanity’s Last Exam, %, cao hơn tốt hơn | 47 | 52 |
| CritPt, %, cao hơn tốt hơn | 23 | 25 |
| SciCode, %, cao hơn tốt hơn | 59 | 61 |
Số liệu: AA. Các tỷ lệ giữ mức làm tròn trong bài công bố.
Chênh lệch giữa hai thế hệ lớn ở Terminal-Bench và AutomationBench-AA, nhưng nhỏ hơn nhiều ở CritPt hay SciCode. Điều này phù hợp với một bản nâng cấp phục vụ công việc nhiều bước: mô hình có ích hơn khi phải điều khiển công cụ và theo đuổi yêu cầu đến cùng, chứ không mặc nhiên suy luận tốt vượt trội ở mọi câu hỏi.
Khái niệm mở trọng số cũng cần dùng đúng thời điểm. Với 55 điểm được AA ghi nhận, K3.1 Pro sẽ dẫn đầu nhóm này nếu thứ hạng giữ nguyên khi trọng số được phát hành, kéo khoảng cách với mô hình độc quyền dẫn đầu từ 12 xuống 3 điểm trên Intelligence Index. Đó là so sánh theo bảng điểm lúc công bố, không phải cam kết thứ hạng còn nguyên vào ngày tải xuống; mở trọng số cũng không tự động đồng nghĩa toàn bộ mã nguồn, dữ liệu huấn luyện và quyền sử dụng đều được mở.
Khả năng dùng công cụ đáng chú ý hơn quy mô tham số
Giá trị thực dụng của K3.1 Pro nằm ở việc chuyển từ câu trả lời sang công việc có đầu ra kiểm tra được, chẳng hạn sửa một kho mã hoặc tạo mô hình CAD. Quy mô lớn giúp mô tả kiến trúc, nhưng không thay cho phép thử trên đúng công việc mà người dùng cần giao.
| Đặc tính | Kimi K3.1 Pro |
|---|---|
| Tổng tham số | 2,8 nghìn tỷ |
| Tham số kích hoạt mỗi token | 104 tỷ |
| Cửa sổ ngữ cảnh | 1 triệu token |
| Định dạng mô hình tiếp nhận | Văn bản và hình ảnh |
| Trạng thái phân phối lúc ra mắt | Dịch vụ Kimi và API; chưa phát hành trọng số |
Số liệu: AA và Moonshot AI.
Ở kiến trúc phân tuyến chuyên gia, lượng tham số tham gia xử lý mỗi token thấp hơn tổng tham số, nhưng toàn bộ trọng số vẫn phải được lưu trữ và phục vụ theo cách phù hợp. Vì vậy, 104 tỷ tham số kích hoạt không có nghĩa đây là mô hình gọn có thể mặc nhiên chạy trên máy cá nhân. Cửa sổ ngữ cảnh dài tạo chỗ cho nhiều tài liệu hoặc mã nguồn hơn, còn việc truy xuất đúng chi tiết và làm theo yêu cầu vẫn cần đánh giá riêng.
Trong phép đo Terminal-Bench 4.0 do Moonshot công bố, K3.1 Pro đạt 65,7%, so với GPT-6 Astra đạt 58,2% và Claude Opus 5.5 đạt 66,4%. Kết quả Kimi dùng Claude-Code harness, tức bộ phần mềm điều phối tương tác giữa mô hình với công cụ, ở reasoning effort max, temperature 1,0 và top-p 0,95. Các điểm đối thủ được hãng lấy từ báo cáo hoặc bảng xếp hạng, nên đây không phải toàn bộ mô hình đều được thử lại trong một cấu hình giống hệt nhau.
Con số 65,7% không nên trộn với mức 67% do AA công bố thành một kết quả duy nhất. Hai bên báo cáo các đợt đánh giá riêng; khác biệt ở bộ điều phối, cấu hình và quy trình thử có thể làm thay đổi tỷ lệ hoàn thành, ngay cả khi tên bài kiểm tra giống nhau.
| Phép thử Moonshot công bố | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Terminal-Bench 4.0, %, cao hơn tốt hơn | 65,7 | 66,4 | 58,2 |
| BenchCAD có công cụ, Voxel IoU, cao hơn tốt hơn | 92,7 | 96,2 | 95,9 |
Số liệu: Moonshot AI. BenchCAD dùng tập con 1.000 mẫu với mô hình mở ở mức suy luận tối đa và Claude Code cho cấu hình có công cụ; điểm đối thủ được dẫn từ báo cáo của từng hãng.
BenchCAD đánh giá tái dựng hình dạng từ ảnh nhìn nhiều góc thông qua mã CAD, nên điểm số này không tương đương khả năng tạo mọi loại tài sản 3D. Dù vậy, việc một mô hình có thể viết rồi chạy mã để chỉnh hình học là hướng sử dụng cụ thể hơn lời hứa tạo nội dung chung chung; giao diện 3D Make cũng cho phép xem, sửa và xuất mô hình ngay trong dịch vụ Kimi.
Ở nhóm công việc tài chính, Moonshot báo cáo OfficeQA Pro v2 đạt 64,4 điểm, với tài liệu PDF được cung cấp dưới dạng ảnh để kiểm tra truy xuất và đối chiếu nhiều tài liệu. Điểm số ấy có ý nghĩa về khả năng xử lý tài liệu, chứ không xác nhận mọi phép tính hoặc khuyến nghị đầu tư do mô hình tạo ra đều đúng.
Lọc dữ liệu giảm năng lực khai thác, không xoá được rủi ro
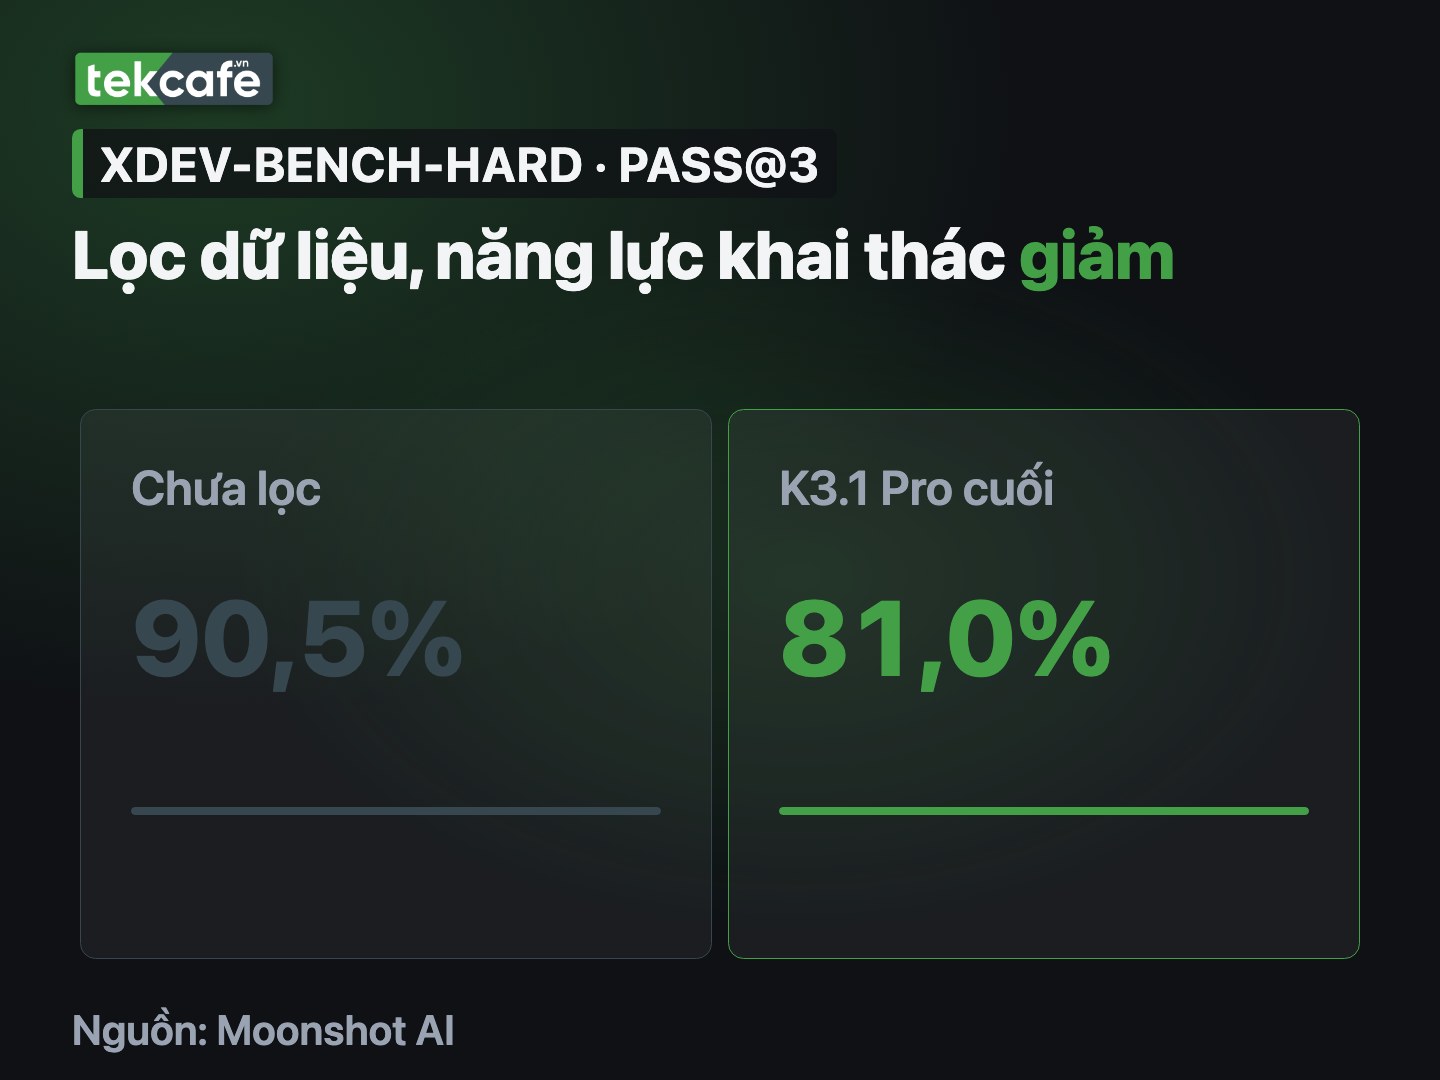
Quyết định lọc dữ liệu an ninh mạng cho thấy kiểm soát rủi ro của mô hình mở phải bắt đầu trước khi trọng số rời tay nhà phát triển. Nhưng chính kết quả thử của Moonshot cũng đặt giới hạn cho cách hiểu này: giảm dữ liệu chuyên biệt không xoá được năng lực liên quan vốn phát sinh từ kỹ năng lập trình tổng quát.
Moonshot cho biết đã loại nội dung liên quan an ninh mạng ở giai đoạn mid-training và lọc môi trường tương ứng trong huấn luyện tăng cường, đồng thời giữ những tác vụ lập trình phổ thông. Trên xdev-bench-hard nội bộ, phiên bản chưa áp dụng biện pháp giảm rủi ro giải được 90,5% bài ở pass@3, còn bản K3.1 Pro cuối đạt 81,0%.
Điều kiện phép đo rất quan trọng: tập thử gồm tác vụ lỗ hổng dựa trên mã nguồn, báo cáo pass@3 trên các lượt chạy được lấy mẫu và không đặt giới hạn cứng về thời gian hoặc token đầu ra. Pass@3 cho phép thành công trong tối đa ba lần thử, nên không thể đọc 81,0% thành tỷ lệ thành công ngay lần đầu, càng không thể áp sang mọi hệ thống ngoài thực tế.
Khoảng giảm giữa hai phiên bản là bằng chứng biện pháp lọc có tác dụng trong phép thử đó, nhưng chưa đủ chứng minh mô hình an toàn khi phát hành rộng rãi. Năng lực đọc mã, tìm lỗi và gỡ lỗi có thể phục vụ cả phòng thủ lẫn lạm dụng; với đội triển khai, kiểm soát quyền công cụ và phạm vi truy cập vẫn cần thiết thay vì chỉ dựa vào tuyên bố mô hình đã được lọc.
Độ chính xác cũng chưa phải chuyện đã giải quyết xong. AA ghi nhận chỉ số AA-Omniscience tăng từ 20 lên 30 điểm. Chỉ số này thuộc một bộ đánh giá cụ thể, không phải xác nhận mô hình đã hết bịa thông tin; việc kiểm tra nguồn và xác nhận đầu ra vẫn cần được giữ lại khi giao công việc quan trọng.
Đội phát triển Việt Nam nên tính tiền theo tác vụ hoàn tất
Với nhóm phát triển phần mềm ở Việt Nam, lý do đáng thử K3.1 Pro là cơ hội tăng tỷ lệ hoàn thành ở chi phí chấp nhận được, không phải một mức giá token nhìn riêng lẻ. Nếu mô hình dùng thêm nhiều bước suy luận hoặc phải chạy lại, khoản tiết kiệm trên bảng giá có thể không còn nguyên trong hóa đơn.
| Hạng mục API | Kimi K3.1 Pro, USD/triệu token |
|---|---|
| Đầu vào chưa có trong bộ nhớ đệm | 2,00 |
| Đầu ra | 10,00 |
| Đầu vào khớp bộ nhớ đệm | 0,20 |
Số liệu: AA, giá API trực tiếp lúc ra mắt. Đây không phải giá thuê bao Kimi hay mức giá bán lẻ riêng tại Việt Nam.
AA ghi nhận cả ba đơn giá thấp hơn Kimi K3 33%, nhưng chi phí khoảng 1,98 USD mỗi tác vụ trên Intelligence Index vẫn xấp xỉ thế hệ cũ. Lượng token đầu ra trung bình cũng tăng từ khoảng 48.000 lên 55.000 mỗi tác vụ theo số liệu làm tròn của đơn vị này; tác vụ, tỷ trọng đầu vào và cách dùng bộ nhớ đệm đều ảnh hưởng số tiền cuối cùng.
Vì thế, phép thử phù hợp trước khi chuyển mô hình là lấy một nhóm công việc thực tế đã có tiêu chí đạt, giữ nguyên quyền công cụ và cách chấm rồi so tỷ lệ hoàn tất cùng tổng chi phí. Với mã nguồn, cần tính cả lượt sửa lỗi sau kiểm thử; với bảng tính và tài liệu, cần kiểm chứng số liệu cũng như nguồn trích, thay vì chỉ chấm câu trả lời có vẻ thuyết phục.
Người muốn thử có thể dùng các dịch vụ Kimi hoặc API đã triển khai; người muốn tự vận hành phải chờ trọng số và xem điều kiện giấy phép cùng yêu cầu hạ tầng khi phát hành. Moonshot hẹn chậm nhất ngày 4/11/2026, nên quyết định đưa dữ liệu nhạy cảm lên dịch vụ đám mây hôm nay và kế hoạch tự triển khai sau đó vẫn là hai lựa chọn khác nhau.
Nguồn tham khảo: Moonshot AI: công bố Kimi K3.1 Pro và điều kiện benchmark; Artificial Analysis: điểm số, chi phí và trạng thái trọng số.