Tóm tắt nhanh
- XDA ghi nhận Qwythos-9B-v2 bản Q4_K_M chạy khoảng 20–22 token/giây trên RTX 3070 8GB trong LM Studio; đây không phải tốc độ bảo đảm cho mọi GPU.
- Hãy bắt đầu bằng ngữ cảnh vừa phải, theo dõi ước tính bộ nhớ rồi điều chỉnh GPU Offload, thay vì chọn ngay cửa sổ một triệu token.
- Empero AI công bố bản v2 sửa lỗi lặp bằng FTPO, nhưng điểm lập trình vẫn thấp hơn Qwen3.5-9B trong phép thử nội bộ của hãng.
- Giải thích kiến thức là việc đáng thử trước; thông tin mới cần công cụ tìm kiếm, còn câu trả lời quan trọng vẫn phải được kiểm chứng.
Qwythos-9B-v2 đưa một mô hình suy luận vào tầm với của máy có GPU 8GB: XDA ghi nhận bản lượng hóa Q4_K_M dung lượng dưới 7GB chạy được trên RTX 3070. Điều đáng quan tâm không phải lời hứa thu nhỏ Claude vào máy cá nhân, mà là khả năng chuyển bớt các câu hỏi giải thích thường ngày sang phần cứng đang có, trong khi vẫn giữ dịch vụ đám mây cho việc khó.
Muốn làm được điều đó, cần phân biệt ba thứ thường bị gộp làm một: dung lượng tệp mô hình, bộ nhớ khi chạy và chất lượng câu trả lời. Tải vừa một tệp chưa có nghĩa là còn đủ VRAM cho hội thoại dài; câu trả lời trôi chảy cũng chưa chứng minh mô hình hiểu đúng toàn bộ yêu cầu.
Tải đúng bản Q4_K_M rồi nạp với ngữ cảnh vừa sức
Bản lượng hóa phù hợp quan trọng hơn tên mô hình trong kết quả tìm kiếm. Qwythos có bản gốc và bản v2, còn kho trọng số dùng định dạng safetensors không phải cùng gói tải GGUF dành cho các trình chạy cục bộ. Với cấu hình GPU nhỏ, nên bám đúng biến thể đã có ghi nhận vận hành thay vì tải ngẫu nhiên một tệp có chữ Qwythos.
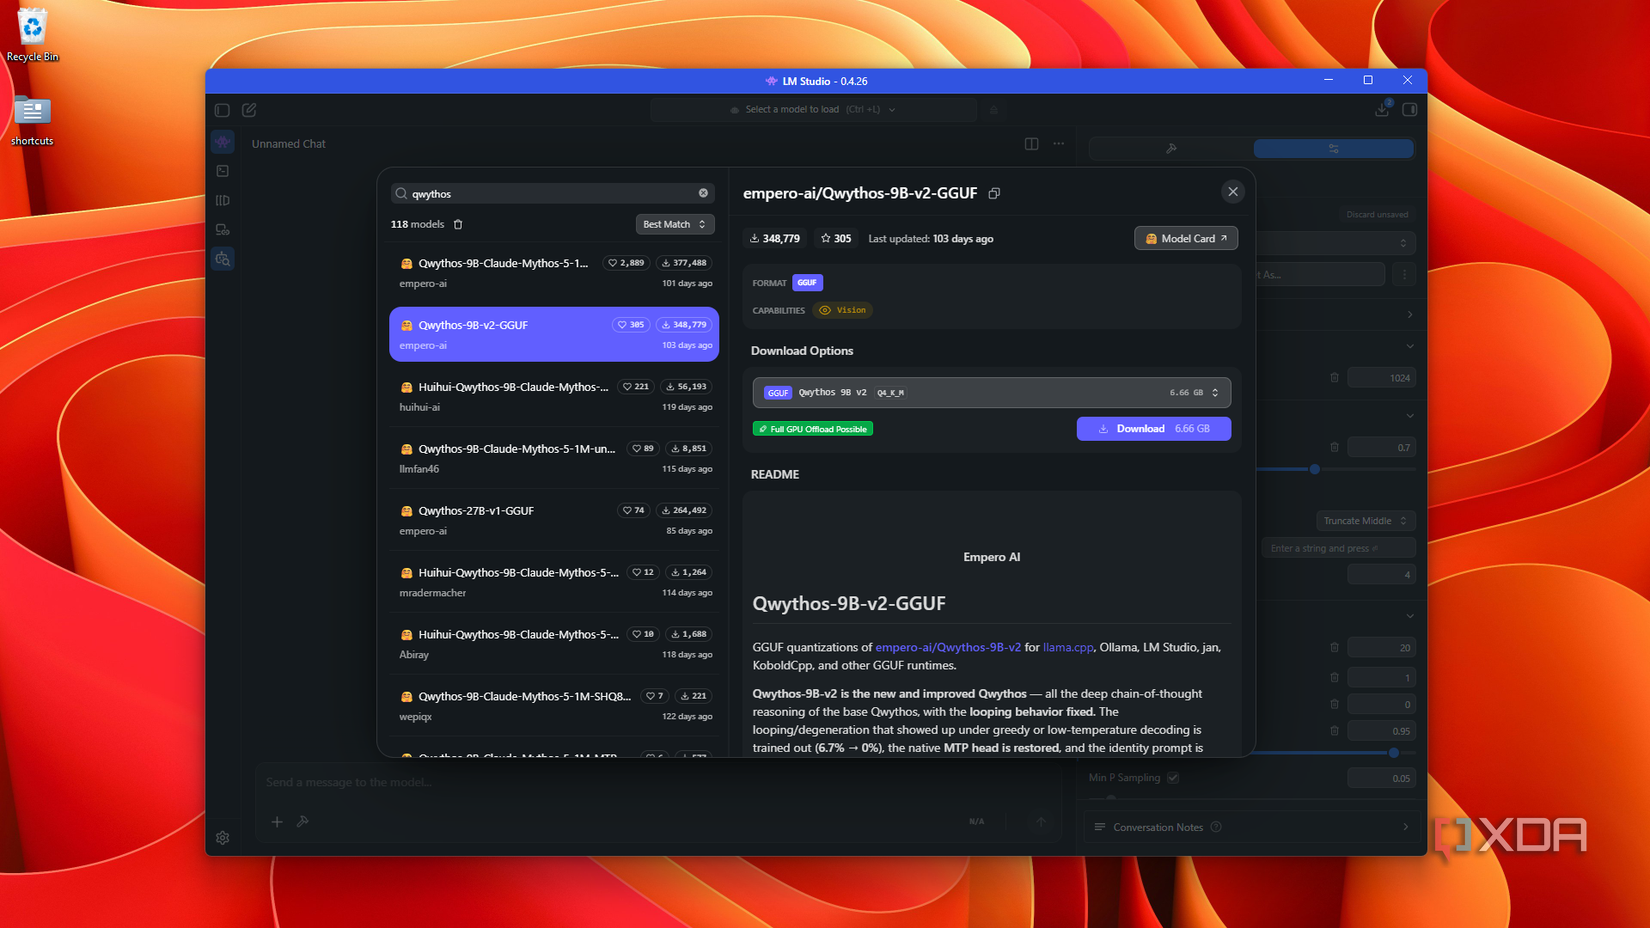
- Mở chức năng tìm và tải mô hình trong LM Studio, tìm Qwythos-9B-v2 rồi kiểm tra tên nhà phát hành Empero AI và định dạng GGUF. Đừng nhầm với bản Qwythos-9B đời đầu.
- Chọn mức lượng hóa Q4_K_M. XDA dùng biến thể này với tệp dưới 7GB trên RTX 3070 8GB; lượng hóa giúp giảm bộ nhớ chứa trọng số, nhưng không xóa phần bộ nhớ cần cho lúc suy luận.
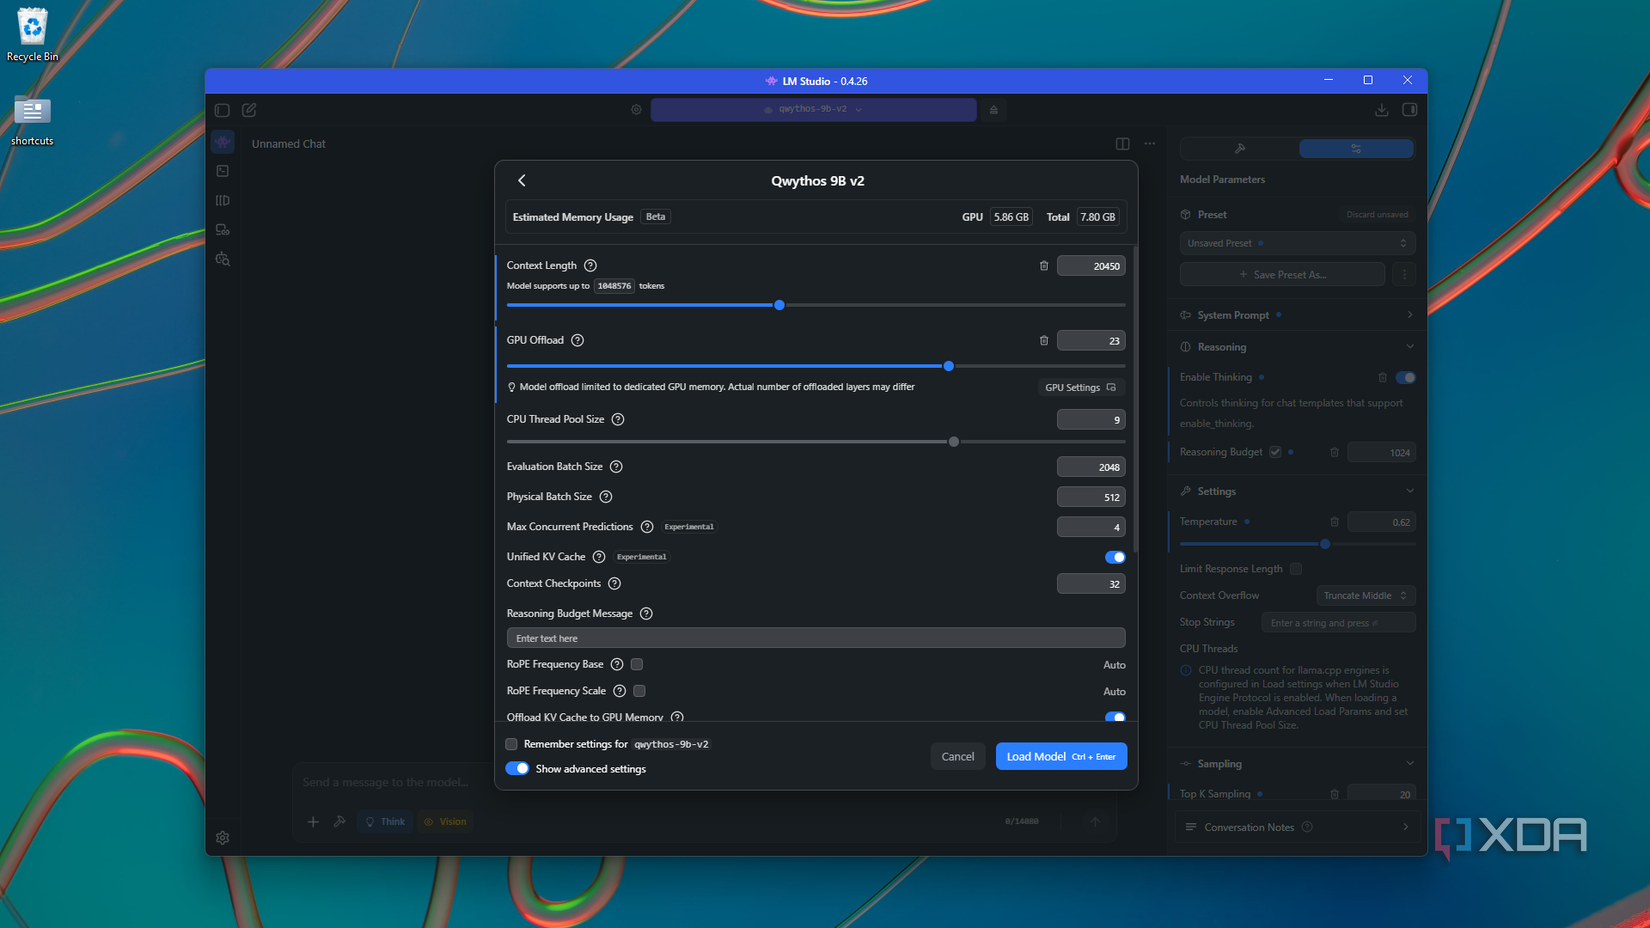
- Ở cửa sổ nạp mô hình, đặt Context Length vừa với tài liệu và cuộc trò chuyện thực sự cần dùng. Khoảng 14 nghìn token là một mốc đã chạy được trong thử nghiệm XDA, không phải yêu cầu tối thiểu hay thiết lập tối ưu cho mọi máy.
- Xem Estimated Memory Usage và điều chỉnh GPU Offload trước khi chọn Load Model. Nếu ước tính bộ nhớ không còn dư địa, giảm ngữ cảnh hoặc số lớp chuyển lên GPU rồi thử lại, thay vì cố nạp toàn bộ theo thông số tối đa.
- Sau khi nạp, gửi một câu hỏi ngắn rồi thử tiếp đoạn tài liệu đại diện cho công việc của mình. Chỉ tăng ngữ cảnh khi cấu hình hiện tại chạy ổn và thực sự thiếu chỗ.
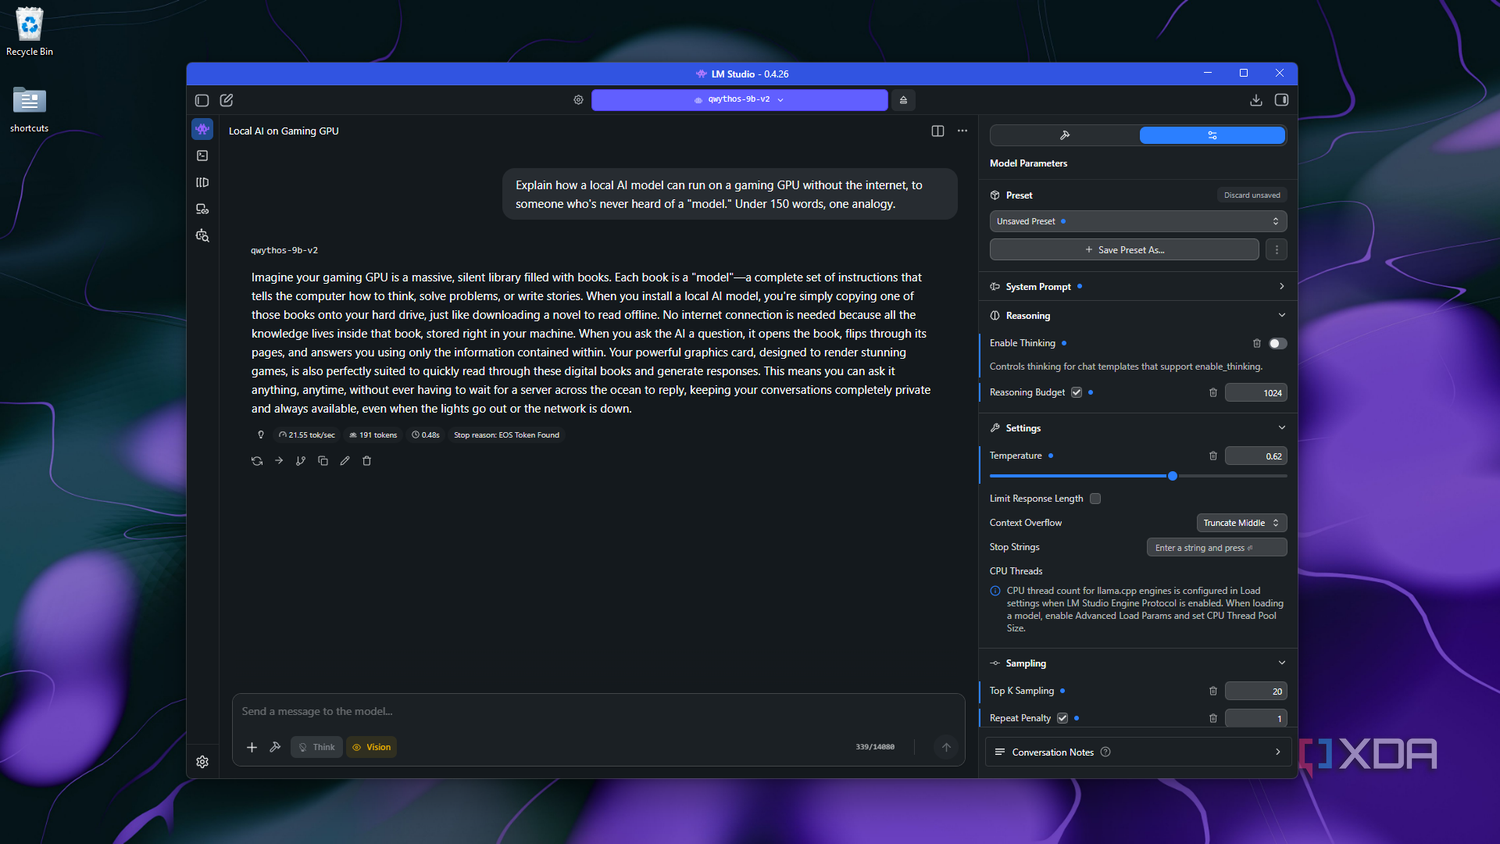
XDA ghi nhận khoảng ngữ cảnh 10–30 nghìn token tùy số lớp offload, cùng tốc độ khoảng 20–22 token/giây trên RTX 3070 trong LM Studio. Các con số này gắn với cấu hình thử nghiệm đó; chúng không đủ để suy ra GPU 8GB khác sẽ có cùng tốc độ, nhất là khi phần việc chuyển sang CPU thay đổi.
Cũng cần tách tốc độ sinh token khỏi thời gian chờ đáp án cuối. Một mô hình có thể bắt đầu xuất nội dung nhanh nhưng vẫn dành thời gian cho khối suy luận; bật Thinking vì vậy không đồng nghĩa câu trả lời hoàn chỉnh sẽ xuất hiện ngay.
Kiến trúc lai tiết kiệm bộ nhớ, không biến 8GB thành máy chủ
Cửa sổ ngữ cảnh ghi trên model card là giới hạn cấu hình, không phải cam kết chạy được trên lượng VRAM bất kỳ. Empero công bố Qwythos-9B-v2 dùng kiến trúc Qwen3.5 với tỷ lệ ba lớp Gated-DeltaNet linear attention trên một lớp full attention, cùng ngữ cảnh 1.048.576 token khi áp dụng YaRN hệ số 4.
Ở các lớp full attention, bộ nhớ đệm khóa và giá trị, thường gọi là KV-cache, tăng theo chiều dài hội thoại. Các lớp tuyến tính giữ trạng thái có kích thước cố định, nhờ đó giảm phần bộ nhớ phải tăng theo từng token mới. Đây là lý do một mô hình nhỏ có thể dành thêm chỗ cho hội thoại, chứ không phải bằng chứng rằng chi phí ngữ cảnh đã biến mất.
Trọng số vẫn phải nằm trong bộ nhớ, lớp full attention vẫn có bộ đệm, còn chương trình chạy cũng cần tài nguyên. Khi tăng Context Length, người dùng đang chia lại phần bộ nhớ còn dư giữa nội dung hội thoại và các thành phần vận hành, không đơn thuần mở khóa một tính năng miễn phí.
Với GPU 8GB, cấu hình hợp lý là ngữ cảnh đủ cho nhiệm vụ hiện tại và số lớp offload không làm bộ nhớ chạm trần. Một tài liệu ngắn không được lợi chỉ vì cửa sổ được đặt cực lớn; ngược lại, cấu hình vừa sức giúp tránh phải đánh đổi phần xử lý trên GPU lấy chỗ trống không dùng đến. Mốc một triệu token nên được hiểu là thông số triển khai cần phần cứng tương ứng, không phải đích phải đạt trên máy chơi game.
Học từ dữ liệu Claude không đồng nghĩa có Claude trong máy
Nền tảng của Qwythos vẫn là Qwen3.5-9B, không phải trọng số Claude được chuyển sang định dạng nhỏ hơn. Theo model card, Empero hậu huấn luyện mô hình trên hơn 500 triệu token có dữ liệu hội thoại mang tên Claude Mythos và Claude Fable, còn chuỗi suy luận được tạo bằng công cụ nội bộ rethink. Đây là mô tả dữ liệu do nhà phát triển công bố, không phải xác nhận năng lực tương đương các mô hình của Anthropic.
Cách phân biệt này ảnh hưởng trực tiếp đến kỳ vọng sử dụng. Học từ câu trả lời hay cách trình bày của một mô hình khác có thể định hình hành vi, nhưng không chuyển nguyên bộ kiến thức, độ tin cậy hay những tính năng của dịch vụ gốc sang mô hình mới. Việc mang tên Claude trong kho tải cũng không giải quyết câu hỏi về nguồn gốc và quyền sử dụng dữ liệu huấn luyện.
Bản v2 đáng chú ý ở cách sửa lỗi lặp hơn là lời hứa tăng trí thông minh. Empero mô tả FTPO, viết đầy đủ là Final-Token Preference Optimization, xác định token khởi đầu vòng lặp rồi huấn luyện để ưu tiên phương án tiếp diễn mạch lạc tại vị trí đó. Cách làm nhắm vào điểm phát sinh lỗi, thay vì trông chờ hoàn toàn vào hình phạt lặp khi sinh văn bản.
Theo phép thử nội bộ của Empero, tỷ lệ lặp khi giải mã greedy giảm từ 6,7% ở Qwythos đời đầu xuống 0% ở v2; khi lấy mẫu với temperature 0,6, bản v2 vẫn còn ghi nhận lỗi lặp. Vì vậy, nói v2 không bao giờ lặp là quá lời: kết quả phụ thuộc thiết lập, và chính model card vẫn ghi nhận lặp ở phép thử có lấy mẫu.
Các điểm phần trăm bên dưới thuộc cùng bảng đối chiếu nội bộ trên model card v2. Empero dùng suy luận sinh văn bản và greedy/pass@1 nếu không ghi khác; cỡ mẫu MMLU, ARC và GSM8K là 500, GPQA-diamond là 198, HumanEval là 164. Không nên ghép chúng với những điểm số trên trang khác nếu chưa đối chiếu phương pháp.
| Phép thử, đơn vị | Qwen3.5-9B | Qwythos-9B | Qwythos-9B-v2 |
|---|---|---|---|
| MMLU có suy luận, % (cao hơn tốt hơn) | 80,6 | 83,8 | 83,8 |
| ARC-Challenge, % (cao hơn tốt hơn) | 95,6 | 95,0 | 96,4 |
| GPQA-diamond, % (cao hơn tốt hơn) | 32,8 | 52,0 | 49,0 |
| GSM8K, % (cao hơn tốt hơn) | 80,6 | 92,2 | 93,6 |
| HumanEval pass@1, % (cao hơn tốt hơn) | 81,7 | 79,9 | 77,4 |
| Tỷ lệ lặp greedy, % (thấp hơn tốt hơn) | 2,7 | 6,7 | 0,0 |
Số liệu: Empero AI, model card Qwythos-9B-v2; kết quả từ hệ thống đánh giá nội bộ của nhà phát triển.
Điểm toán và kiến thức không tăng cùng chiều với điểm lập trình: v2 đứng đầu GSM8K trong bảng nhưng thấp hơn Qwen gốc ở HumanEval. Đó là lý do nên chọn mô hình theo loại công việc, không xem bản fine-tune mới hơn mặc nhiên là nâng cấp cho mọi nhu cầu.
Bật Thinking khi cần giải thích, rồi kiểm tra cả ràng buộc của đề
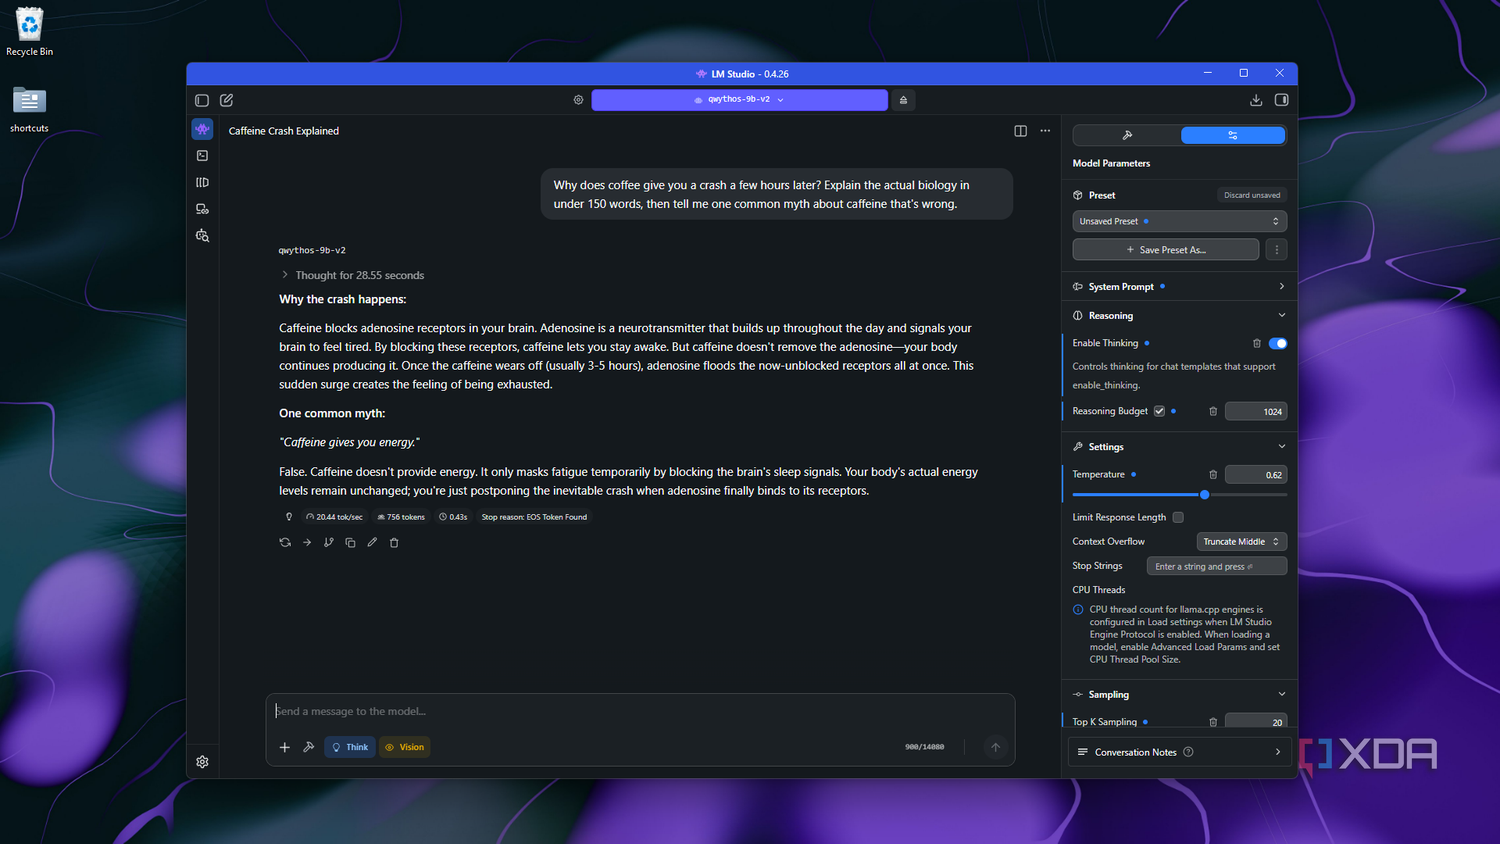
Suy luận dài chỉ hữu ích khi nó giúp trả lời đúng câu hỏi. Trong LM Studio, có thể bật Enable Thinking cho nhiệm vụ cần giải thích cơ chế hoặc phân tích nhiều bước, rồi so với cùng câu hỏi khi tắt; tiêu chí nên là độ chính xác và mức bám yêu cầu, không phải độ dài khối suy nghĩ.
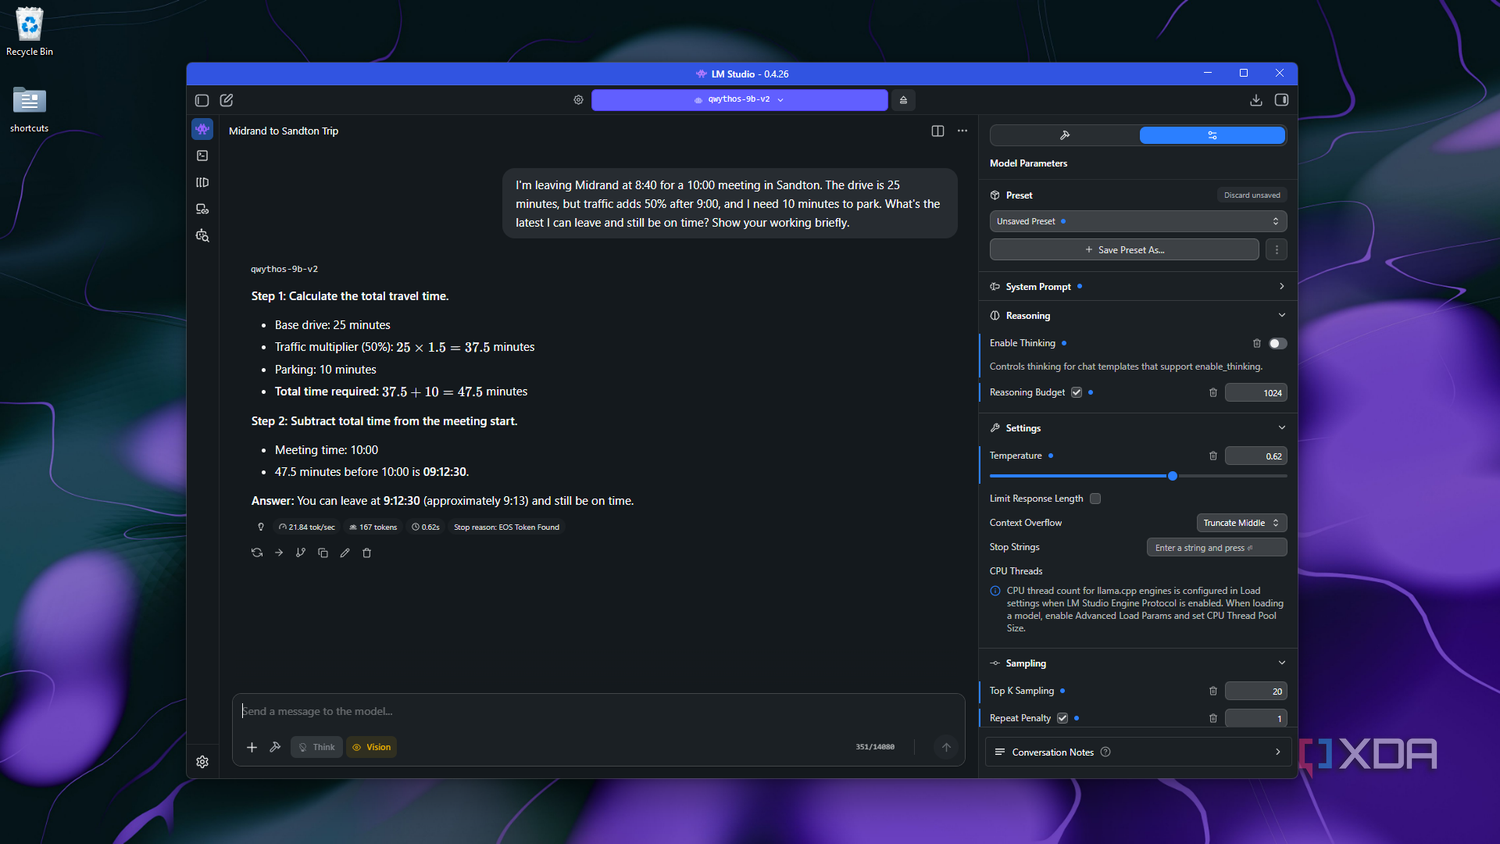
XDA ghi nhận câu hỏi giải thích hiện tượng mệt sau khi uống cà phê mất khoảng 28 giây suy luận khi bật Thinking. Với câu đố tính giờ di chuyển khi tắt chế độ này, đáp án xuất hiện nhanh nhưng bỏ qua một chi tiết mở đầu của đề. Những tình huống đó cho thấy cần đọc lại giả định và ràng buộc, kể cả khi phép tính phía sau trông hợp lý.
Phép ví von cũng đáng rà soát như con số. Câu trả lời có thể đổi vai trò của cùng một đối tượng giữa các đoạn, hoặc vượt giới hạn độ dài dù văn phong vẫn dễ đọc. Khi dùng để học kiến thức mới, nên yêu cầu mô hình chỉ rõ điều kiện áp dụng và đối chiếu kết luận quan trọng với tài liệu gốc, thay vì coi đoạn giải thích liền mạch là bằng chứng đúng.
Nếu cần điểm bắt đầu cho tham số lấy mẫu, Empero khuyến nghị temperature 0,6, top_p 0,95, top_k 20 và repetition_penalty 1,05. Model card cho biết hình phạt lặp ở v2 không còn là thành phần bắt buộc để tránh vòng lặp như trước; giữ cấu hình khuyến nghị ban đầu giúp việc so sánh các lần thử dễ hiểu hơn.
Với người dùng Việt Nam, nên thử trực tiếp các yêu cầu tiếng Việt thường làm trước khi chuyển việc sang mô hình này. Các ví dụ tiếng Anh và bảng benchmark trên không đo riêng chất lượng diễn đạt tiếng Việt, khả năng giữ thuật ngữ chuyên ngành hay mức bám định dạng mà công việc của bạn cần. Một câu trả lời đúng nội dung nhưng phải sửa quá nhiều vẫn có thể không tiết kiệm thời gian.
Thông tin mới cần công cụ, còn thị giác chưa phải thế mạnh
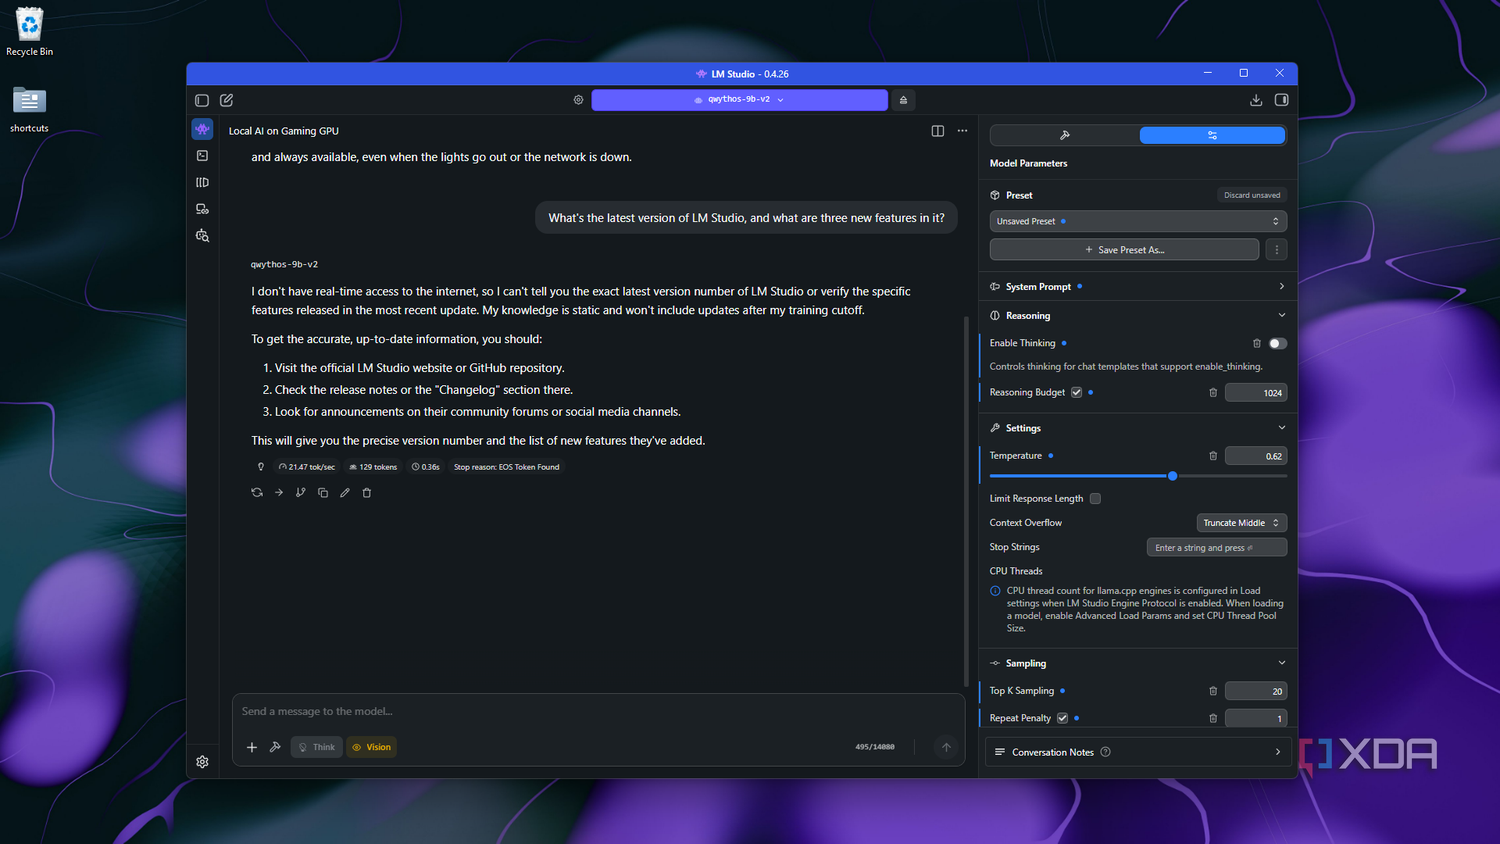
Chạy cục bộ không tự đem lại kiến thức cập nhật. Khi được hỏi phiên bản LM Studio mới nhất, câu trả lời trong thử nghiệm nhận mình không có truy cập internet; đây là hành vi phù hợp với giới hạn của một mô hình ngoại tuyến, nhưng không bảo đảm nó luôn biết dừng ở mọi câu hỏi khác.
Nếu đã có tích hợp tìm kiếm qua MCP, hãy kiểm tra rằng công cụ thực sự được gọi và nguồn trả về đúng câu hỏi. Chỉ viết vào prompt rằng mô hình được dùng internet không tạo ra kết nối đó. Empero công bố mô hình trả lời đúng cả bảy câu hỏi trong bộ thử nội bộ khi được cấp Python executor và tìm kiếm web qua DuckDuckGo; kết quả nhỏ, có công cụ hỗ trợ này không phải tỷ lệ chính xác chung khi trò chuyện ngoại tuyến.
Đổi lại, khi gửi truy vấn sang dịch vụ tìm kiếm, phần dữ liệu trong truy vấn đã rời máy. Nếu mục tiêu là giữ kín tài liệu, cần xem nội dung nào được gửi ra ngoài trước khi bật công cụ; quyền riêng tư phụ thuộc cả đường đi của dữ liệu, không chỉ vị trí lưu trọng số.
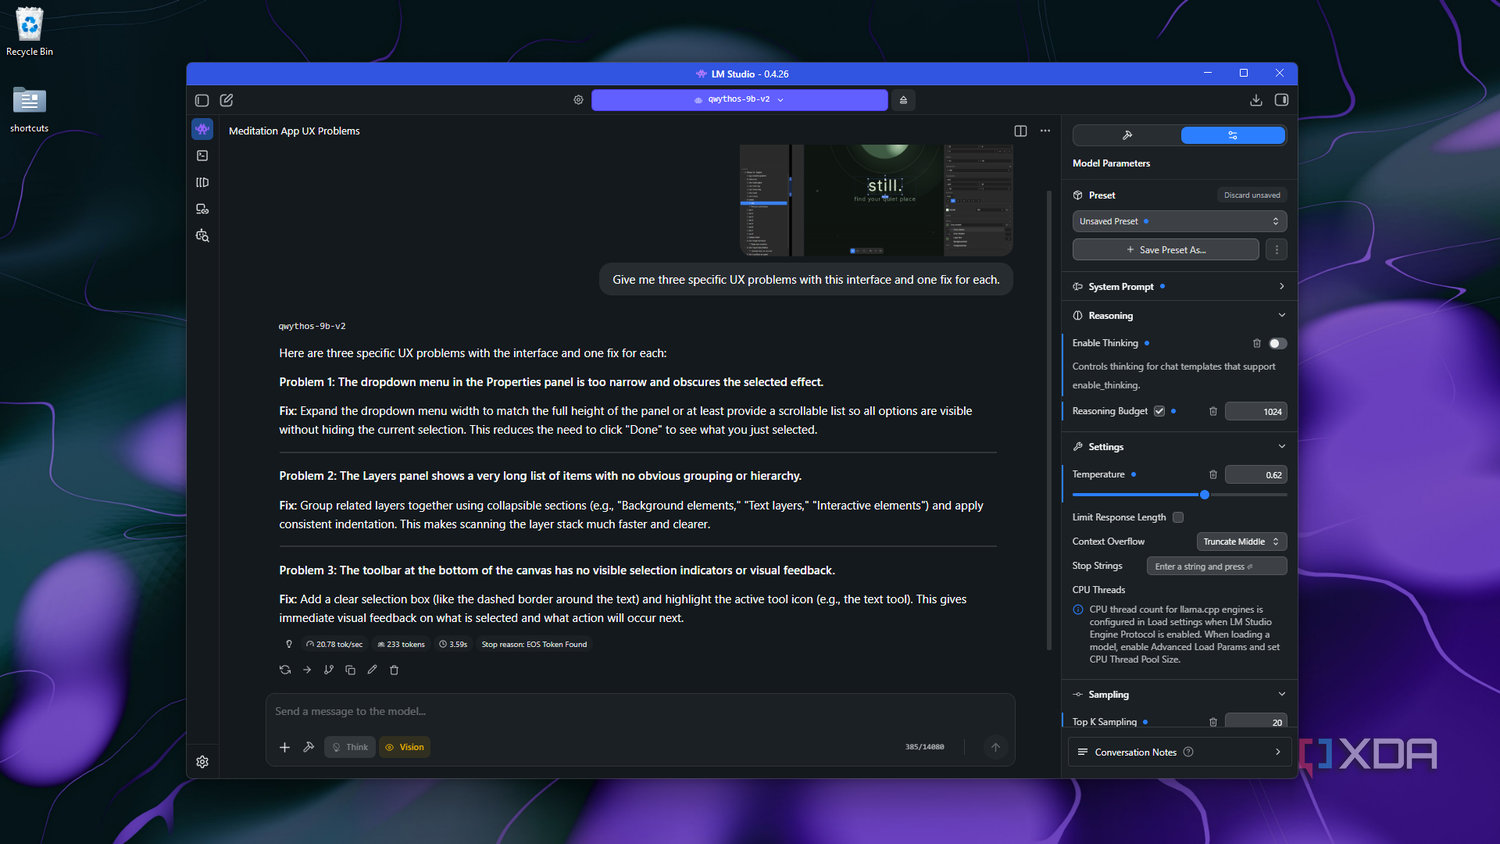
Khả năng nhận ảnh cũng không nên được suy ra từ chữ multimodal trên trang tải. Empero cho biết phần thị giác kế thừa từ mô hình nền, bị đóng băng trong huấn luyện và không được đánh giá ở lần fine-tune gốc. Với các yêu cầu nhận xét giao diện, câu trả lời chung chung hoặc suy đoán không đủ thay cho việc kiểm tra từng chi tiết trên ảnh.
Lựa chọn thực dụng là thử Qwythos trên máy đang có cho các việc giải thích thường ngày, giữ Claude cho nhiệm vụ mà mô hình nhỏ chưa đáp ứng. Chưa có cơ sở để mua thêm GPU chỉ vì kỳ vọng tiết kiệm phí thuê bao, cũng chưa nên hủy dịch vụ trước khi đo chất lượng và công sửa đầu ra trên chính việc mình làm. Giá trị của AI cục bộ nằm ở phần việc nó gánh được đều đặn, không nằm ở tên mô hình lớn xuất hiện trong lời giới thiệu.
Nguồn tham khảo: Empero AI — Qwythos-9B-v2; Empero AI — Qwythos-9B bản gốc; XDA Developers.