Tóm tắt nhanh
- XDA tính chi phí sinh một triệu token ở mức 0,149 USD trên PC dùng RTX 4070 Ti Super và Ryzen 5 7600X, theo giá điện giả định 0,182 USD/kWh.
- Đây là chi phí điện của một cấu hình và mô hình cụ thể, không phải tổng chi phí sở hữu hay phép so sánh chất lượng với dịch vụ đám mây.
- Người đã có PC nên tính phần điện tăng thêm; người mua máy riêng cần tính cả thời gian bật chờ và khấu hao.
Một PC sinh câu trả lời AI không nhất thiết tiêu thụ điện bằng lúc chạy game nặng, nên lấy công suất định danh của card để ước tính hóa đơn có thể dẫn tới kết quả sai. Tuy vậy, lấy tiền điện của máy sẵn có đặt cạnh toàn bộ giá thuê bao rồi kết luận AI cục bộ rẻ hơn sẽ bỏ sót phần đắt nhất: mua máy, giữ máy hoạt động và nhận được câu trả lời đủ tốt để dùng.
Tiền điện thấp là lợi thế của máy sẵn có, chưa phải lý do mua GPU
Chạy mô hình trên PC có lợi thế rõ nhất khi phần cứng đã được mua cho công việc khác. Máy vốn phục vụ lập trình, dựng hình hoặc chơi game có thể kiêm xử lý tài liệu riêng tư; khi đó, câu hỏi hợp lý là bật thêm tác vụ AI làm hóa đơn tăng bao nhiêu, thay vì bắt toàn bộ giá chiếc máy gánh vào mỗi câu trả lời.
Ngược lại, nếu mua riêng một bộ máy chỉ để bỏ thuê bao, tiền điện nhỏ không đủ chứng minh khoản đầu tư sẽ hoàn vốn. Phải cộng giá phần cứng, thời gian thiết lập, khả năng nâng cấp và phần điện tiêu thụ lúc không có yêu cầu nào. Hai người dùng cùng một mô hình nhưng xuất phát từ hai tình huống này sẽ có kết quả kinh tế rất khác nhau.
Quyền kiểm soát dữ liệu cũng đáng được tính riêng. Xử lý tài liệu ngay trên máy có thể giúp tránh gửi nội dung lên dịch vụ bên ngoài, miễn là phần mềm và cách triển khai thực sự giữ dữ liệu cục bộ. Lợi ích ấy không cần được biện minh bằng lời hứa thay thế hoàn toàn mọi dịch vụ AI.
Phải tách đọc yêu cầu và sinh câu trả lời khi đo điện
Hai giai đoạn của một lượt hỏi đáp có tốc độ và chi phí khác nhau, nên lấy một con số công suất GPU rồi nhân với thời gian mở ứng dụng rất dễ gây hiểu nhầm. Đọc prompt là xử lý phần đầu vào; sinh token là tạo dần câu trả lời, thường khiến người dùng phải chờ lâu hơn trên cùng khối lượng văn bản.
XDA dùng Qwen3.6-35B-A3B ở bản lượng tử hóa UD-IQ4_XS, với kích thước được XDA nêu là 16,5 GB, trên card có 16 GB GDDR6X. Một phần expert thuộc tám lớp được chuyển sang Ryzen 5 7600X qua tùy chọn --n-cpu-moe của llama.cpp. Vì CPU cũng tham gia xử lý token, chỉ đo card đồ họa sẽ thiếu một phần điện năng thực sự phục vụ tác vụ.
Phép thử dùng llama-bench trong llama.cpp build b11927: đọc prompt dài 2.048 token qua mười lượt, rồi sinh 512 token qua năm lượt, đều bắt đầu từ ngữ cảnh trống. CPU được theo dõi bằng HWiNFO, còn GPU dùng nvidia-smi với chu kỳ lấy mẫu nửa giây. Kết quả vì thế gắn với đúng cách chia tải, mô hình và độ dài ngữ cảnh này; không thể áp nguyên cho mọi PC chạy AI.
| Phép thử và đơn vị | Qwen3.6-35B-A3B trên RTX 4070 Ti Super + Ryzen 5 7600X |
|---|---|
| Đọc prompt, token/giây (cao hơn tốt hơn) | 2.855 |
| Sinh câu trả lời, token/giây (cao hơn tốt hơn) | 85,5 |
| Công suất đỉnh CPU + GPU khi đọc, W (thấp hơn tốt hơn) | 237,5 |
| Công suất đỉnh CPU + GPU khi sinh token, W (thấp hơn tốt hơn) | 251,9 |
| Điện cho một triệu token đầu vào, USD (thấp hơn tốt hơn) | 0,0042 |
| Điện cho một triệu token đầu ra, USD (thấp hơn tốt hơn) | 0,149 |
| Điện cho một triệu token đầu vào nếu cộng 100 W, USD (thấp hơn tốt hơn) | 0,0060 |
| Điện cho một triệu token đầu ra nếu cộng 100 W, USD (thấp hơn tốt hơn) | 0,208 |
Số liệu: XDA Developers; chi phí tính theo mức điện giả định 0,182 USD/kWh.
Khác biệt lớn giữa tốc độ đọc và tốc độ sinh cho thấy thời gian GPU thực sự làm việc quan trọng hơn số token đứng riêng lẻ. Một tài liệu dài được xử lý nhanh không nhất thiết tốn điện hơn một câu trả lời dài mà mô hình phải tạo tuần tự.
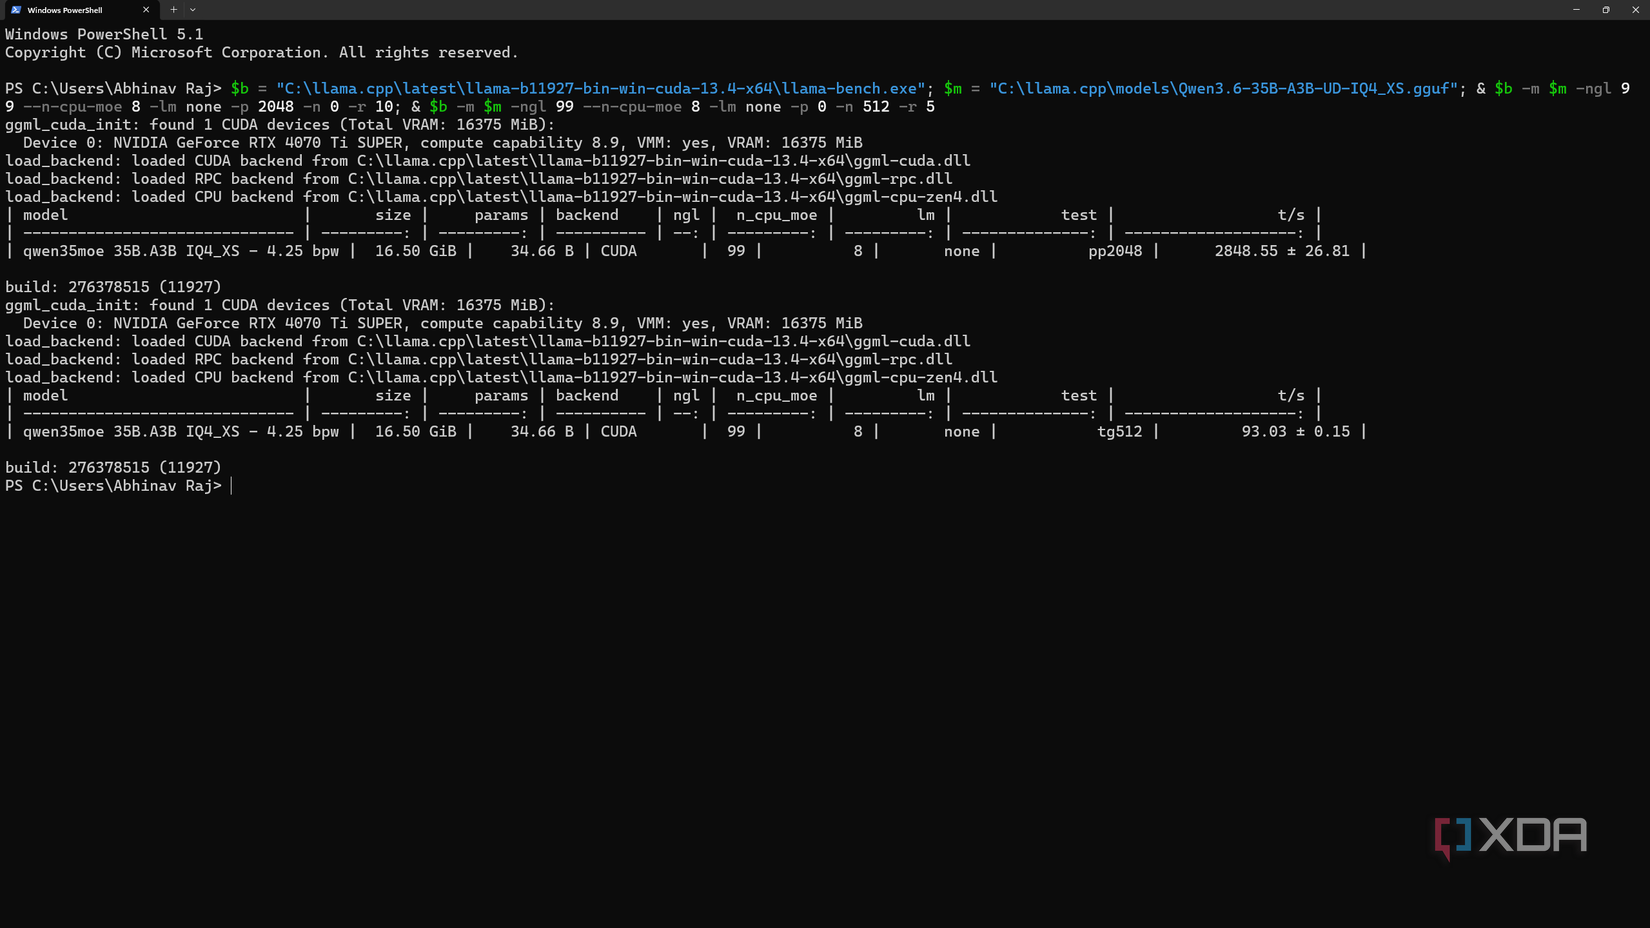
Ảnh chụp llama-bench do XDA đăng hiển thị khoảng 2.848,55 token/giây ở phép đọc và 93,03 token/giây ở phép sinh, khác với bảng tổng hợp 2.855 và 85,5 token/giây. Chênh lệch giữa ảnh và bảng không có lời giải thích đi kèm, nên không nên xem ảnh là bằng chứng trùng khít cho bảng hay diễn giải kết quả thành một mức tốc độ bảo đảm trên mọi lần chạy.
Cộng thêm công suất là giả định thận trọng, không thay được ổ đo điện
Phép tính dùng công suất đỉnh suốt thời gian xử lý có xu hướng nâng chi phí ước tính so với một tải dao động, nhưng vẫn chưa phải số điện toàn hệ thống đo tại ổ cắm. XDA cộng số đo CPU và GPU, không trừ công suất chờ của hai linh kiện; RAM, quạt và tổn hao bộ nguồn chưa nằm trong phép ghi này.
Kịch bản cộng thêm 100 W được dùng để bù khoảng thiếu này. Khoản cộng ấy hữu ích để thử độ nhạy của kết luận, song không phải số đo xác nhận rằng mọi bộ máy đều tiêu thụ thêm đúng như vậy. Ổ cứng, màn hình nếu tính chung, hiệu suất nguồn và các tác vụ chạy nền có thể làm mức thực tế khác đi.
Theo phép quy đổi của XDA ở mức điện giả định trên, 20 USD tương đương khoảng 110 kWh. Nếu giữ mức 251,9 W liên tục chỉ để sinh token, thời gian cần thiết là khoảng 436 giờ, tương đương 14,5 giờ mỗi ngày trong tháng 30 ngày. Kịch bản cộng 100 W còn khoảng 312 giờ, tức hơn mười giờ sinh liên tục mỗi ngày.
Những con số đó giúp hình dung quy mô, chứ không có nghĩa cứ mở ứng dụng AI mười giờ là GPU sinh token đủ mười giờ. Thời gian đọc câu trả lời, chỉnh yêu cầu và làm công việc khác đều tạo khoảng chờ. Ngược lại, một hệ thống tự động chạy tác vụ nối tiếp có thể bận lâu hơn nhiều so với người chỉ thỉnh thoảng trò chuyện.
Bật máy chờ cả ngày có thể đáng lo hơn một lượt hỏi dài
Với nhu cầu cá nhân không liên tục, thời gian không làm gì có thể chiếm phần lớn lịch hoạt động của máy chủ AI. Vì thế, tối ưu vài watt lúc đang trả lời chưa chắc tiết kiệm bằng việc không để cả thùng máy công suất chờ cao hoạt động suốt ngày.
LLM Configurator minh họa mức chờ 80 W trong 24 giờ mỗi ngày, tính 30 ngày ở đơn giá 0,17 USD/kWh, tương ứng 9,79 USD mỗi tháng trước khi cộng tác vụ AI. Đây là ví dụ tính toán, không phải số đo công suất chờ của bộ RTX 4070 Ti Super nói trên; trộn hai cấu hình lại sẽ tạo ra một hóa đơn không có thật.
Người dùng cần phân biệt máy vốn đã bật với máy được bật chỉ để chờ lệnh. Nếu PC luôn chạy cho công việc, một phần điện nền đã tồn tại trước khi cài mô hình; còn nếu bật máy riêng để phục vụ điện thoại từ xa, toàn bộ thời gian chờ trở thành chi phí của dịch vụ tự vận hành. Tắt mô hình khỏi bộ nhớ cũng chưa đồng nghĩa tắt cả PC.
Ở chiều ngược lại, giữ mô hình trong RAM hoặc VRAM giúp tránh nạp lại khi có yêu cầu mới, nên tiết kiệm điện và độ trễ phản hồi có thể xung đột. Cách chọn hợp lý phụ thuộc tần suất sử dụng: cần phản hồi ngay cả ngày khác với chỉ xử lý tài liệu trong một buổi làm việc.
Ở Việt Nam, hãy tính theo phần điện tăng thêm trên hóa đơn của mình
Mức điện tại Mỹ trong phép thử không nên được quy đổi thẳng thành kết luận về chi phí của một hộ gia đình Việt Nam. Với biểu giá theo bậc, lượng điện máy tính dùng thêm có thể rơi vào phần giá khác với mức bình quân đang thấy trên hóa đơn; tiền thuế và các thiết bị chạy cùng lúc cũng cần được phân biệt.
Cách tính có thể áp dụng mà không cần đoán một mức giá hiện hành là: chi phí bằng công suất trung bình theo kW, nhân số giờ hoạt động, rồi nhân đơn giá áp dụng cho phần điện tăng thêm. Nếu chạy cả ngày, nên tính riêng thời gian tải và thời gian chờ, tránh vừa cộng điện chờ cho cả ngày vừa cộng lại toàn bộ điện tải trong cùng khoảng thời gian.
Ổ đo điện tại đầu vào bộ máy sẽ gần với tiền phải trả hơn cộng thông số định danh của CPU và GPU. Với cùng tác vụ, nên ghi tổng điện năng, thời gian hoàn thành và chất lượng đầu ra; một thiết lập ít watt nhưng chạy lâu hơn không tự động tiết kiệm hơn.
Người dùng PC trong phòng có điều hòa còn phải để ý nhiệt phát ra. Điện tiêu thụ cuối cùng chuyển thành nhiệt trong phòng, nhưng không có một hệ số cố định để cộng tiền điều hòa cho mọi căn nhà. Có thể đo chênh lệch thực tế theo cách sử dụng, thay vì mặc định bỏ qua hoặc tự nhân đôi hóa đơn.
Token rẻ không đồng nghĩa câu trả lời có giá trị tương đương
Chi phí điện trên mỗi token chỉ phản ánh một phần rất hẹp của bài toán. Giá API còn bao gồm hạ tầng vận hành và dịch vụ, trong khi thuê bao thường đi kèm giao diện cùng các chức năng ngoài việc sinh văn bản; bởi vậy ba khoản này không thể thay thế nhau trong phép so sánh trực tiếp.
Một mô hình chạy tại nhà tạo văn bản rẻ nhưng cần sửa lại nhiều lần có thể làm mất lợi thế ở công việc quan trọng. Ngược lại, những tác vụ vừa sức, cần giữ nội dung riêng tư và được lặp lại thường xuyên có thể hợp với máy sẵn có, dù người dùng vẫn duy trì dịch vụ đám mây cho nhu cầu khác.
Công suất định danh của card cũng không cho biết hóa đơn AI. XDA ghi nhận riêng GPU đạt đỉnh 144 W khi sinh token và 177 W khi đọc prompt, so với mức định danh 285 W của RTX 4070 Ti Super. Với suy luận từng yêu cầu, quá trình đọc trọng số và băng thông bộ nhớ có thể giới hạn tốc độ trước khi tài nguyên tính toán đạt tải tối đa; điều này không phải quy luật cho mọi kiểu suy luận hay xử lý nhiều yêu cầu đồng thời.
Nếu đã có PC phù hợp, tiền điện là lý do khá yếu để gạt bỏ việc thử AI cục bộ. Nhưng trước khi mua máy nhằm tiết kiệm thuê bao, nên kiểm tra mô hình có hoàn thành công việc cần làm hay không, đo điện cả lúc chờ và xác định phần chi phí phần cứng thực sự dành cho AI. Bỏ qua các khoản ấy sẽ khiến một phép đo điện đúng dẫn tới quyết định mua sắm sai.
Nguồn tham khảo: XDA Developers; LLM Configurator.