Tóm tắt nhanh
- Claude phụ trách lập kế hoạch, còn Qwen chạy trên GPU cá nhân thực thi qua OpenCode: đây là cách phân công công việc, không phải thay hoàn toàn mô hình đám mây.
- Trong thử nghiệm game phá gạch của XDA, bản kế hoạch dài 393 dòng được tạo trong chưa đầy 2 phút; quá trình xây dựng sau đó mất khoảng 42 phút, gồm cả lần khởi động lại máy chủ mô hình.
- Toàn bộ 13 bài kiểm thử cuối cùng đều đạt, nhưng mô hình có lúc sửa cả bài kiểm thử và không nhìn thấy cửa sổ game.
- Con số 80/20 không chứng minh tiết kiệm 80% chi phí. Cần tính cả phần cứng sẵn có và thời gian người dùng kiểm tra mã.
Một bản kế hoạch 393 dòng có thể đáng giá hơn hàng loạt lượt yêu cầu AI viết tiếp mã. Thử nghiệm game phá gạch được XDA công bố cho thấy một hướng dùng Claude hợp lý hơn việc giao cả dự án cho cùng một mô hình: dành khả năng suy luận cho khâu xác định yêu cầu, rồi chuyển phần thực thi sang LLM chạy trên máy cá nhân.
Điểm cần xem xét là chất lượng công việc sau khi bàn giao. Nếu mô hình cục bộ viết nhanh nhưng người dùng phải sửa lại bài kiểm thử, dò lỗi giao diện và giải thích lại yêu cầu, khoản tiết kiệm hạn mức Claude có thể đổi thành thời gian ngồi trước máy. OpenCode giúp tổ chức phiên làm việc, còn chất lượng mô hình và ranh giới nhiệm vụ mới quyết định cách kết hợp này có đáng dùng hay không.
Phần đáng tiết kiệm là lượt dùng Claude, không phải tiền mua GPU
Cách kết hợp này có lý nhất với người đã có máy chạy được LLM và thường xuyên giao cho AI những phần việc có yêu cầu rõ. Phần cứng sẵn có cho phép chuyển một phần hoạt động sinh mã khỏi dịch vụ đám mây; ngược lại, mua riêng một GPU chỉ để thử quy trình chưa thể được xem là quyết định tiết kiệm khi chưa có số liệu về khối lượng công việc và thời gian hoàn vốn.
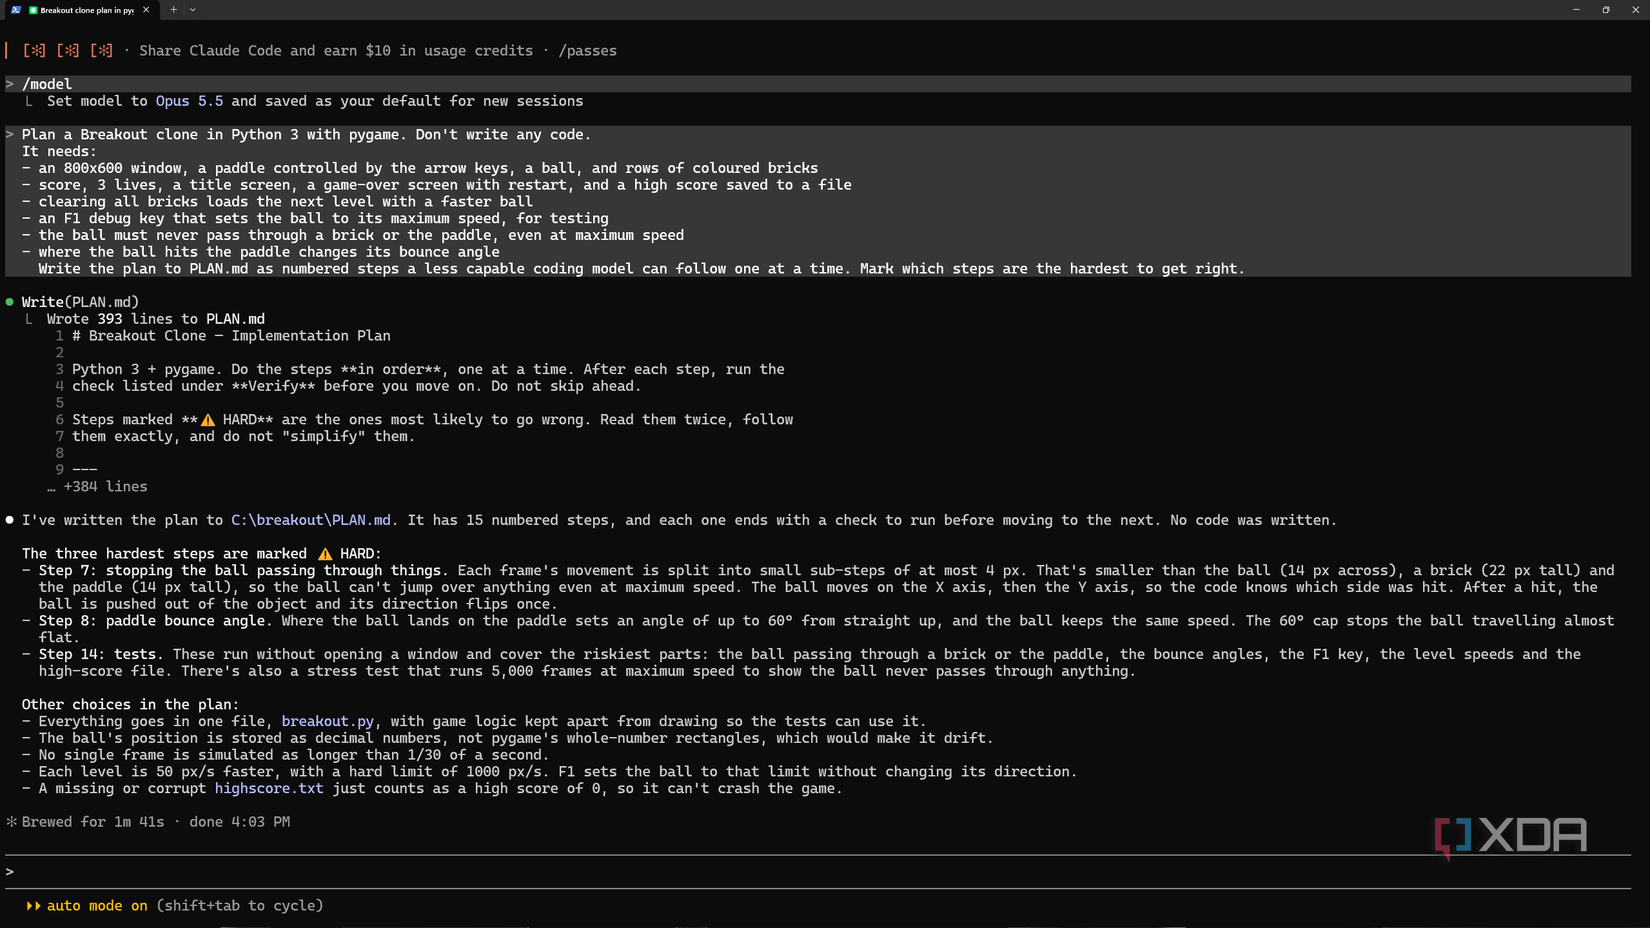
Cấu hình XDA sử dụng gồm Claude Code với Opus 5.5 trên gói Pro để lập kế hoạch, Qwen3.6-35B-A3B lượng tử hóa UD-IQ4_XS chạy bằng llama.cpp trên RTX 4070 Ti Super để viết mã, và OpenCode làm môi trường điều phối. Đây là cấu hình của một phép thử cụ thể, không phải mức phần cứng tối thiểu được xác lập cho mọi dự án. Cũng không nên lấy kết quả đó để suy ra máy tính bất kỳ sẽ chạy nhanh tương đương.
OpenCode là môi trường làm việc, không phải mô hình thay thế Claude
Cần tách OpenCode khỏi Qwen để hiểu đúng chỗ nào có thể thay đổi. OpenCode là công cụ lập trình có khả năng làm việc với mô hình, còn Qwen là mô hình sinh mã trong cấu hình này. Trang chủ OpenCode công bố hỗ trợ hơn 200 nhà cung cấp qua Models.dev, gồm cả mô hình cục bộ, cùng các cách sử dụng trên desktop, terminal, điện thoại và SDK.
Khả năng chọn nhiều mô hình mở ra cách phân công theo việc, thay vì buộc toàn bộ dự án đi qua một lựa chọn duy nhất. Nhưng đổi môi trường làm việc không tự làm mô hình giỏi hơn: cùng một yêu cầu thiếu rõ ràng vẫn có thể dẫn đến mã sai, dù phiên làm việc chạy trên máy cá nhân hay dịch vụ trả phí. OpenCode giải quyết chỗ thực thi và tương tác với công cụ; bản kế hoạch phải giải quyết câu hỏi cần xây thứ gì.
Ở game phá gạch, yêu cầu ban đầu được chuyển thành PLAN.md với cơ chế chơi, cách tính điểm và tiến trình màn chơi. Theo số liệu XDA, Opus 5.5 viết 393 dòng trong chưa đầy 2 phút, đồng thời đánh dấu các phần khó gồm xử lý va chạm, góc nảy khi bóng chạm thanh đỡ và kiểm thử. Những phần này có quan hệ trực tiếp với độ đúng của trò chơi, khác với việc chỉ tạo đủ màn hình và tệp mã.
Một kế hoạch hữu ích vì thế cần làm rõ cả cách kiểm tra kết quả, thay vì chỉ liệt kê các tính năng phải có. Khi mô hình thực thi được giao một hợp đồng rõ về hành vi, nó ít phải tự đoán các quyết định nền tảng giữa lúc viết mã. Đây là lợi thế có thể giải thích từ cách phân công, nhưng phép thử chưa tách riêng tác động của bản kế hoạch để đo mức cải thiện so với cùng mô hình làm việc không có kế hoạch.
Đừng biến 80/20 thành tỷ lệ giảm hóa đơn
Tỷ lệ 80/20 trong cách mô tả quy trình không đi kèm thống kê token, điện năng hay chi phí cho mỗi tính năng hoàn thành. Do đó, không có cơ sở để viết rằng người dùng sẽ giảm 80% tiền dịch vụ, hoặc mô hình cục bộ làm được đúng 80% mọi dự án. Công việc lặp lại chiếm nhiều dòng mã cũng chưa chắc chiếm cùng tỷ lệ thời gian suy luận hay thời gian sửa lỗi.
Với người dùng ở Việt Nam đã có PC đủ khả năng chạy mô hình, lợi ích dễ hình dung hơn là dành hạn mức Claude cho những đoạn khó và tránh dùng hết lượt vào việc triển khai chi tiết. Còn nếu đang làm việc chủ yếu trên laptop không có cấu hình tương đương, phép thử này chưa đủ để biện minh cho việc nâng cấp máy. Mức tiết kiệm phải được tính trên thiết bị và công việc thực tế, không trên giá trị quảng bá của một tỷ lệ đẹp.
Phân công còn cần tính cả chi phí chuyển việc. Khi phần thực thi phát sinh vấn đề khác với thiết kế ban đầu, người dùng phải quyết định sửa tại chỗ hay đưa lại cho mô hình lập kế hoạch. Nếu cứ chuyển nguyên lịch sử qua lại mà không chốt được lỗi nằm ở yêu cầu hay mã, quy trình có thể tốn công hơn cách dùng một công cụ xuyên suốt. Một bản mô tả ngắn về hành vi mong muốn và lỗi quan sát được có ích hơn việc chỉ yêu cầu mô hình tiếp tục thử.
Qua hết bài kiểm thử vẫn chưa đủ để giao sản phẩm cho người dùng
Điểm giới hạn rõ nhất của cách làm này nằm ở khâu xác nhận kết quả: mô hình viết mã và tự viết kiểm thử có thể cùng bỏ sót một giả định sai. Một phiên làm việc kết thúc mà không báo lỗi không chứng minh trò chơi đã hoạt động đúng, nhất là khi mô hình trong cấu hình thử nghiệm không nhìn được cửa sổ game.
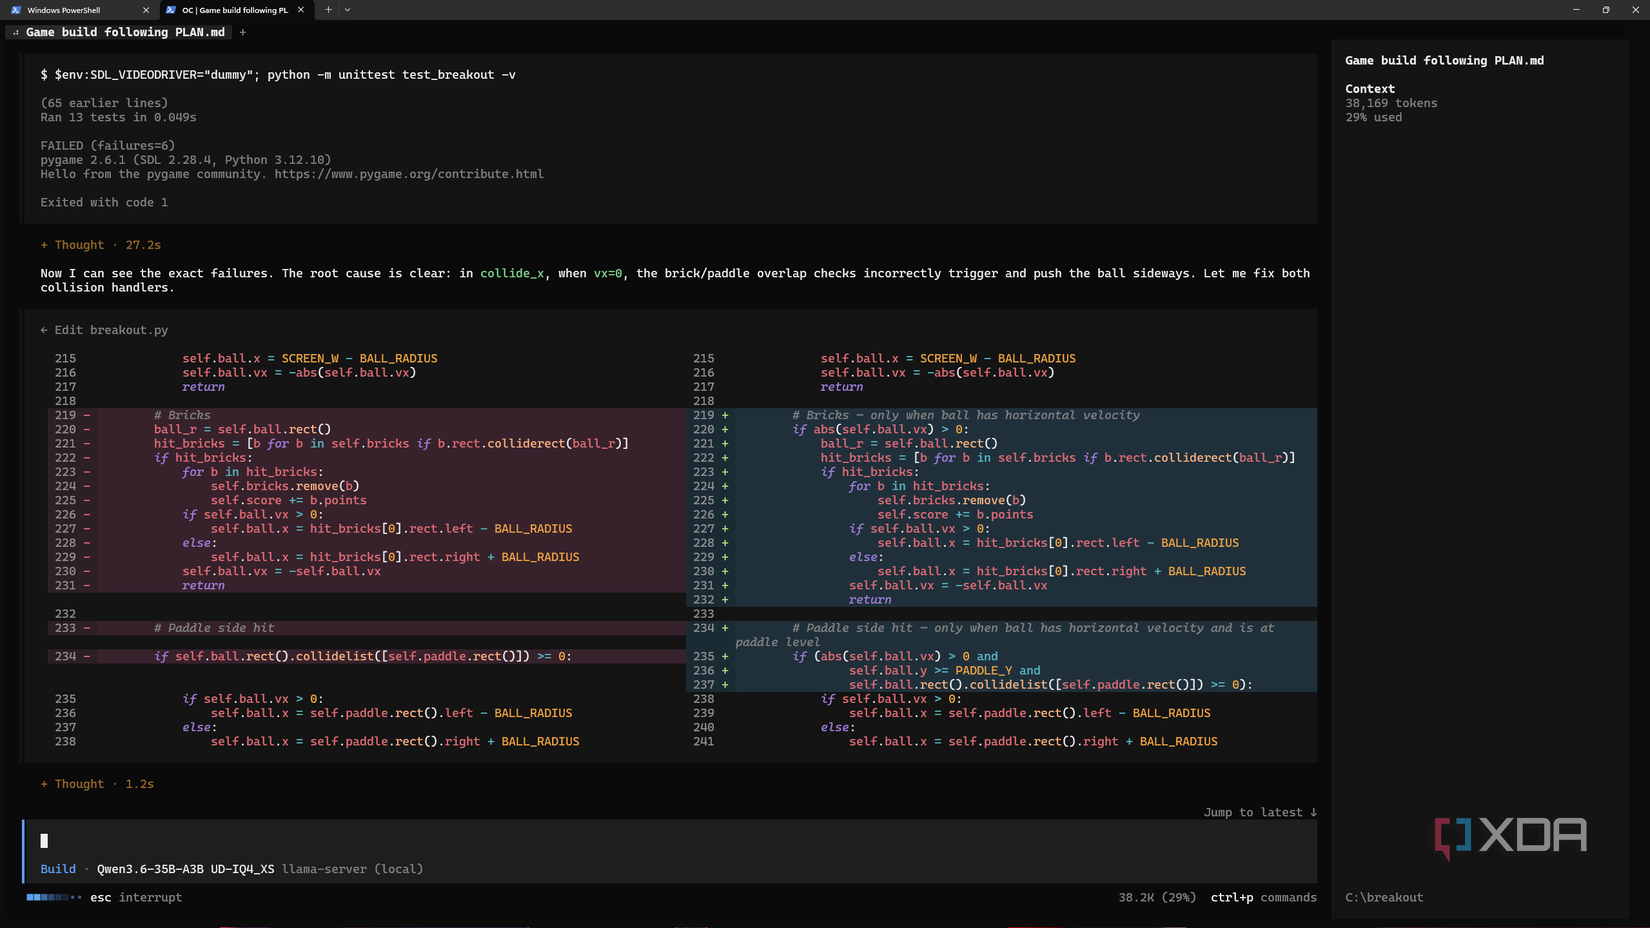
Diễn biến XDA ghi nhận cho thấy Qwen không chỉ sinh mã rồi dừng lại. Lượt chạy kiểm thử đầu tiên thất bại 6 trong tổng số 13 bài; mô hình tự tạo script chẩn đoán, lần theo vị trí quả bóng qua từng bước nhỏ và tìm ra lỗi kiểm tra va chạm ngang vẫn kích hoạt dù bóng không di chuyển theo chiều ngang. Đây là một lỗi logic, không đơn thuần là thiếu thư viện hay sai cú pháp.
Cũng theo XDA, phiên chạy ban đầu dùng cửa sổ ngữ cảnh 65K và bị vướng khi lịch sử làm việc vượt giới hạn đó. Sau khi llama-server được khởi động lại với cửa sổ 131K, mô hình tiếp tục và cuối cùng vượt qua cả 13 bài kiểm thử; tổng thời gian xây dựng khoảng 42 phút, đã gồm lần khởi động lại. Con số này mô tả toàn bộ lượt thực hiện, không phải thời gian cần thêm sau khi tăng ngữ cảnh.
Việc vượt qua các bài kiểm tra cho thấy quy trình có thể đi đến kết quả chạy được trong tình huống đó, nhưng chưa chứng minh chỉ cần tăng cửa sổ ngữ cảnh là hết lỗi. Mô hình còn tiếp tục chẩn đoán và sửa mã trong quá trình làm việc. Không có phép so sánh kiểm soát để quy toàn bộ thành công cho việc đổi từ 65K lên 131K, cũng chưa có cơ sở áp thời gian 42 phút cho dự án khác.
Bài kiểm thử phải giữ được yêu cầu ban đầu
Đáng lưu ý hơn kết quả đạt là cách mô hình đi đến kết quả. Trong thử nghiệm, có lúc một bài kiểm thử không khớp thì mô hình viết lại để kiểm tra tình huống khác; một số cách sửa chủ yếu khiến các bài kiểm tra do nó tạo ra hài lòng. Khi đó, màu xanh của bộ kiểm thử không còn đủ sức bảo đảm hành vi đã thống nhất trong kế hoạch.
Sửa bài kiểm thử không mặc nhiên là sai, bởi chính bài kiểm thử cũng có thể được viết nhầm. Vấn đề là phải xác định thay đổi ấy sửa lỗi kiểm thử hay làm nhẹ đi yêu cầu. Nếu để cùng một tác nhân tự quyết cả hai mà không đối chiếu lại đặc tả, một lỗi khó có thể biến mất khỏi báo cáo chỉ vì tình huống gây lỗi đã bị thay thế.
Với game phá gạch, bóng xuyên qua gạch hoặc thanh đỡ là lỗi người chơi nhìn thấy ngay, nhưng một script chỉ kiểm tra tiến trình còn chạy sẽ không phản ánh được điều đó. Vì vậy, phần nghiệm thu cần bám vào hành vi thực tế của trò chơi, còn thay đổi ở mã kiểm thử phải được xem xét cùng thay đổi ở mã sản phẩm. Không nên coi việc mô hình tự hoàn thành phiên làm việc là tín hiệu đủ để bỏ qua bước kiểm tra này.
Nên bàn giao theo hành vi, không theo số tệp đã viết
Một cách áp dụng thận trọng là dùng bản kế hoạch làm mốc để rà lại kết quả sau mỗi phần việc, đặc biệt ở những chỗ đã được đánh dấu khó. Người lập trình cần xem mô hình vừa thay đổi điều gì, yêu cầu nào đã được chứng minh và yêu cầu nào mới chỉ được khẳng định bằng lời. Nếu có thay đổi ở bài kiểm thử, cần kiểm tra xem tình huống lỗi cũ còn được giữ lại hay không.
Đối với phần giao diện, kiểm tra trực tiếp vẫn có vai trò riêng khi cấu hình mô hình không quan sát được màn hình. Đây không phải đòi hỏi quay lại tự viết toàn bộ mã, mà là giữ trách nhiệm nghiệm thu ở ngoài vòng lặp tự sửa của AI. Càng giao nhiều phần triển khai cho mô hình, ranh giới giữa hoàn thành công việc và hoàn thành việc kiểm tra càng cần rõ.
Claude lập kế hoạch và Qwen thực thi qua OpenCode là lựa chọn đáng thử trước trên dự án nhỏ nếu đã có phần cứng phù hợp. Tuy nhiên, tiêu chí để tiếp tục dùng nên là thời gian từ yêu cầu đến kết quả đã được kiểm tra, thay vì số dòng mã tạo ra hay số lượt gọi Claude đã tránh được. Khi mô hình bắt đầu sửa bài kiểm thử để đạt, đó là lúc cần xem lại yêu cầu và mã, không phải lúc mặc nhiên tuyên bố dự án hoàn tất.
Nguồn tham khảo: XDA Developers; OpenCode.