Tóm tắt nhanh
- Architect Labs giới thiệu Frostbite, kiến trúc CPU đa dụng cùng tập lệnh mới được hệ thống AI thiết kế và xác minh.
- Trong mô phỏng tiền silicon 7nm, cụm bốn tile đạt hiệu năng mỗi watt trung bình cao gấp 4,59 lần nhân CPU dual-issue in-order đối chứng.
- Trên 15 workload giữ kín, mức chênh giảm còn 3,83 lần; chip chưa được sản xuất và đối thủ thử nghiệm không được nêu tên.
Startup Architect Labs cho biết các hệ thống AI của hãng đã thiết kế Frostbite, một kiến trúc CPU đa dụng mới, từ tập lệnh đến RTL và bố trí vật lý; mô phỏng tiền silicon cho thấy cụm bốn tile có hiệu năng mỗi watt cao gấp 4,59 lần nhân CPU đối chứng trên 25 workload.
Con số đáng chú ý, nhưng phạm vi của phép so sánh rất hẹp: Frostbite được mô phỏng trên tiến trình 7nm ở xung 500 MHz, còn nhân đối chứng là thiết kế dual-issue in-order giấu tên, không phải CPU out-of-order hiệu năng cao của AMD, Intel hay Apple. Chưa có chip vật lý để kiểm chứng kết quả.
Interaction nets đưa sự song song vào cấu trúc chương trình
Frostbite dựa trên interaction nets, mô hình tính toán được giới thiệu từ năm 1990. Thay vì để bộ xử lý tự tìm quan hệ phụ thuộc giữa các lệnh khi chương trình chạy, mô hình biểu diễn chương trình như một mạng các nút; mỗi bước chỉ tác động lên phần mạng cục bộ, còn các phép tính độc lập có thể chạy đồng thời.
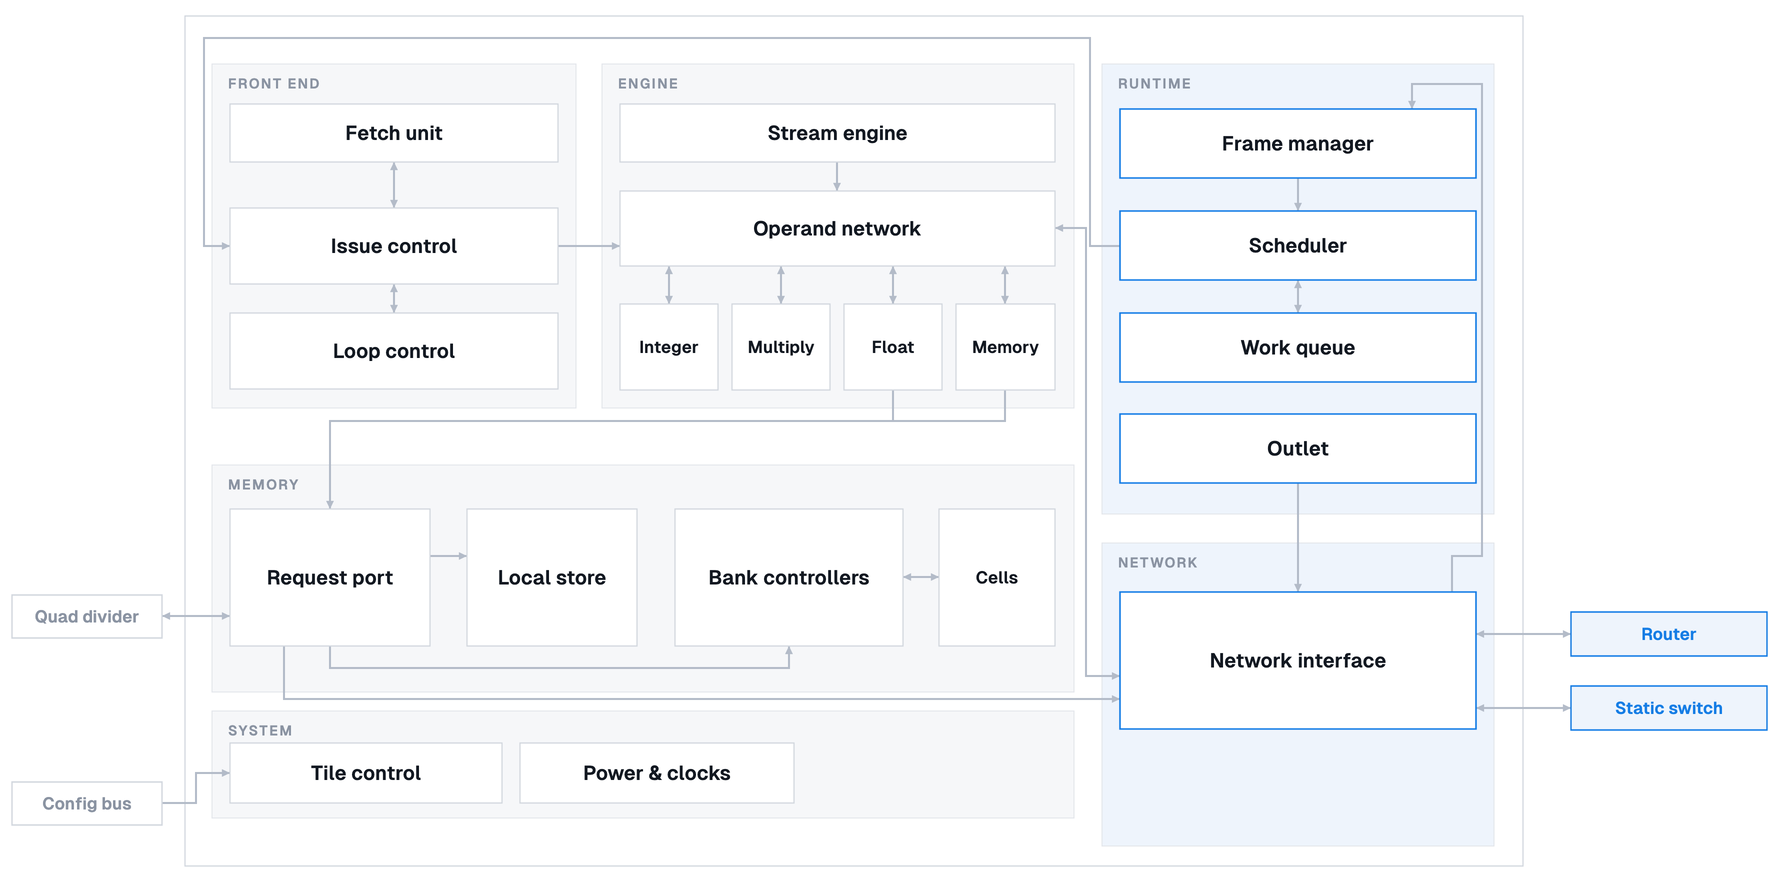
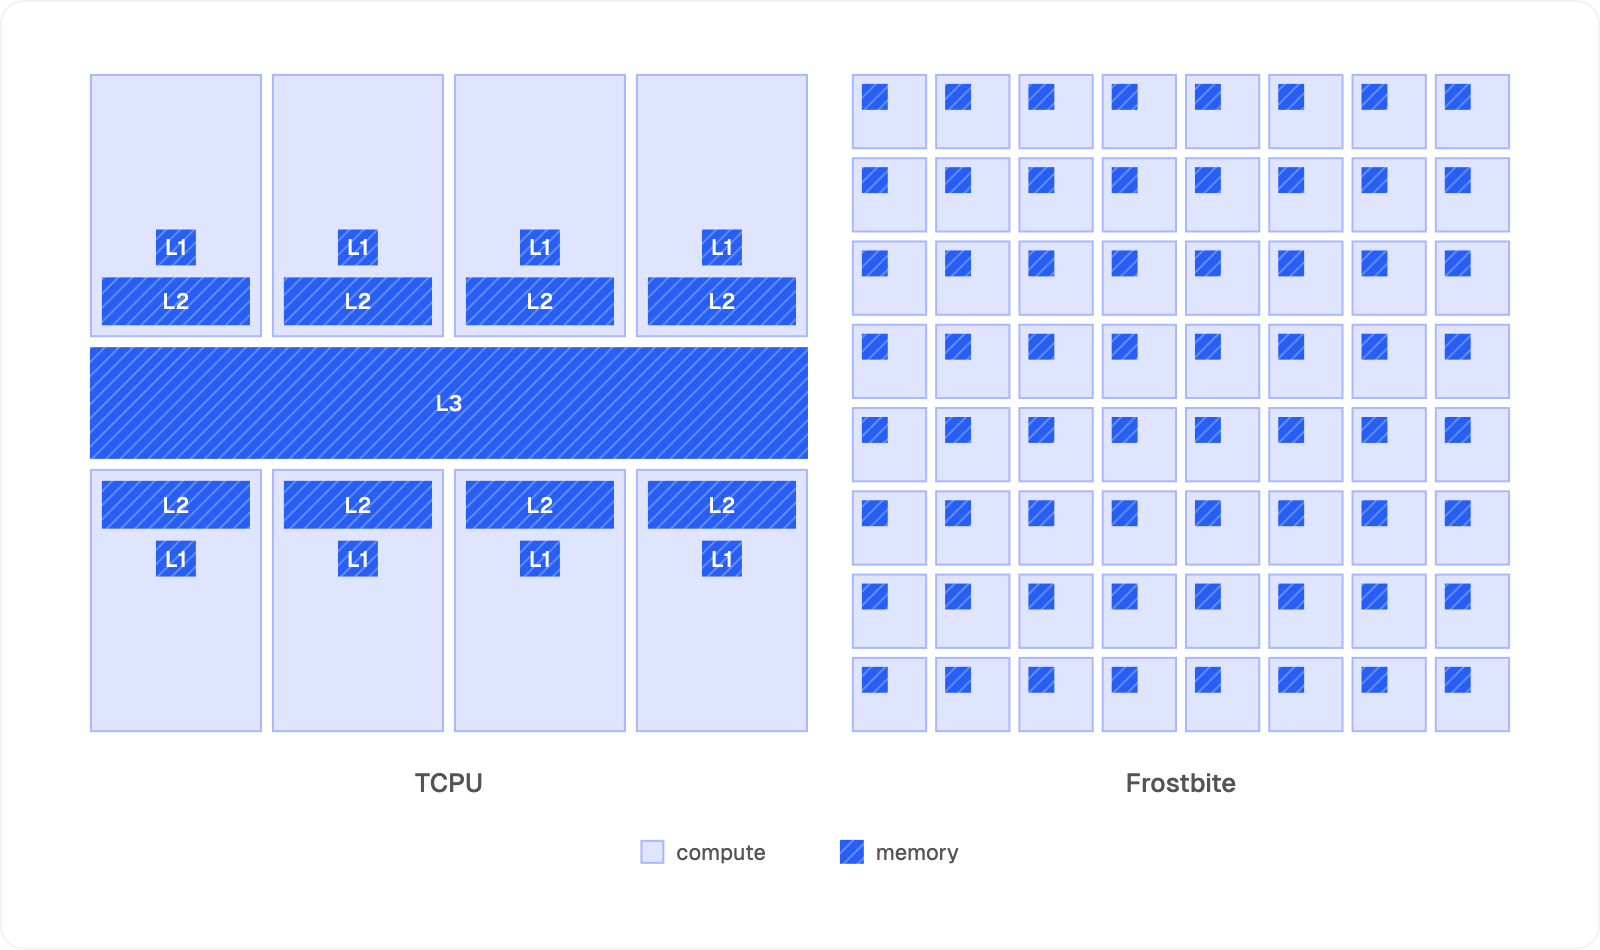
Architect Labs lập luận rằng cách biểu diễn này giảm nhu cầu về cơ chế thực thi ngoài thứ tự (out-of-order), vốn giúp CPU thông thường khai thác song song từ chuỗi lệnh, và hạn chế trạng thái dùng chung cần được giữ nhất quán. Mỗi giá trị trong interaction nets có một nơi sở hữu, nhờ đó dữ liệu có thể nằm trong bộ nhớ nhỏ gần tile xử lý thay vì liên tục đi qua hệ thống cache lớn.
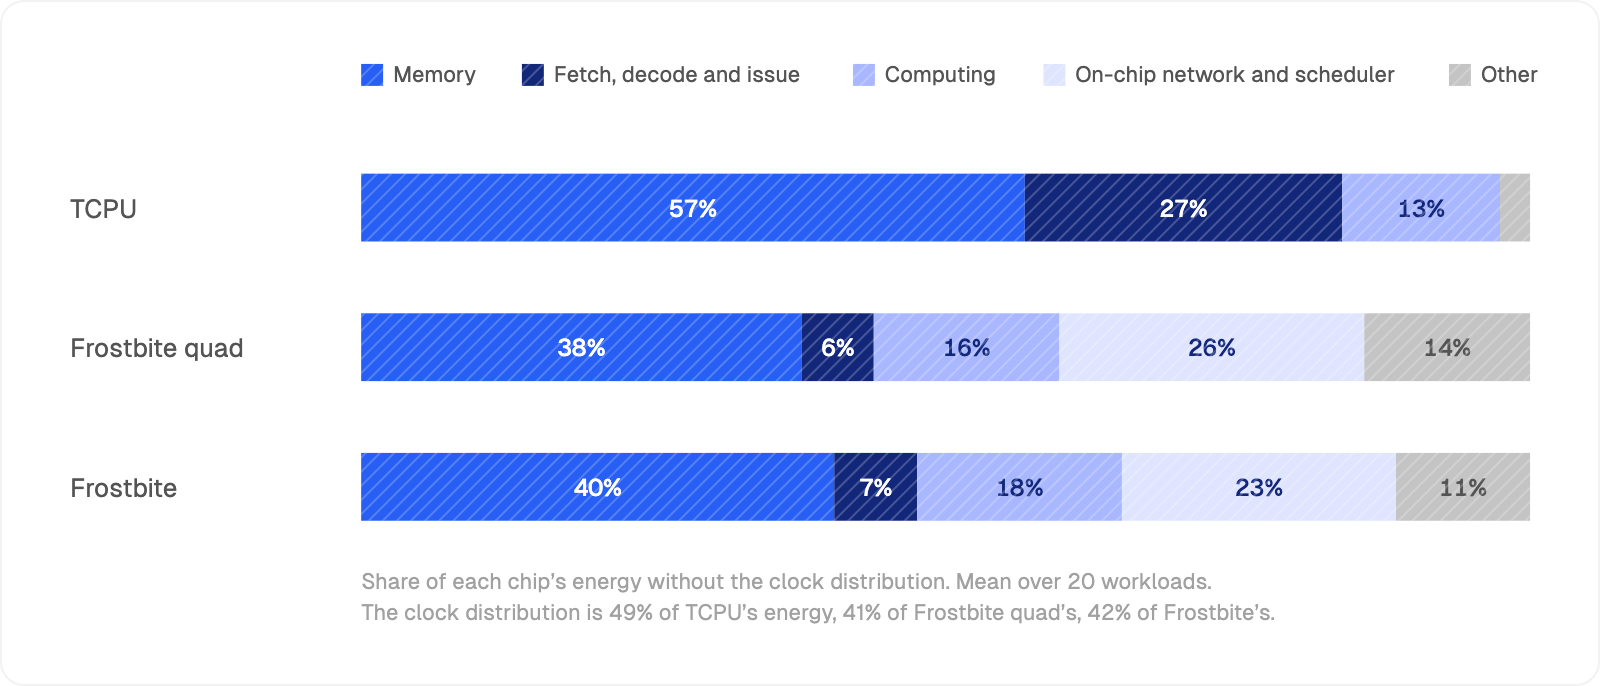
Đổi lại, Frostbite phải điều phối công việc và chuyển thông điệp giữa các tile. Trong phân tích năng lượng trung bình trên 20 workload, Architect Labs ghi nhận bộ nhớ chiếm 38% năng lượng của cụm Frostbite, so với 57% ở nhân đối chứng; phần lấy, giải mã và phát lệnh lần lượt chiếm 6% và 27%. Frostbite dành 26% cho mạng trên chip và bộ lập lịch. Đây là phân bổ của mô phỏng, chưa phải số đo trên silicon.
AI được giới hạn bằng mô hình hình thức, không chỉ bằng lời nhắc
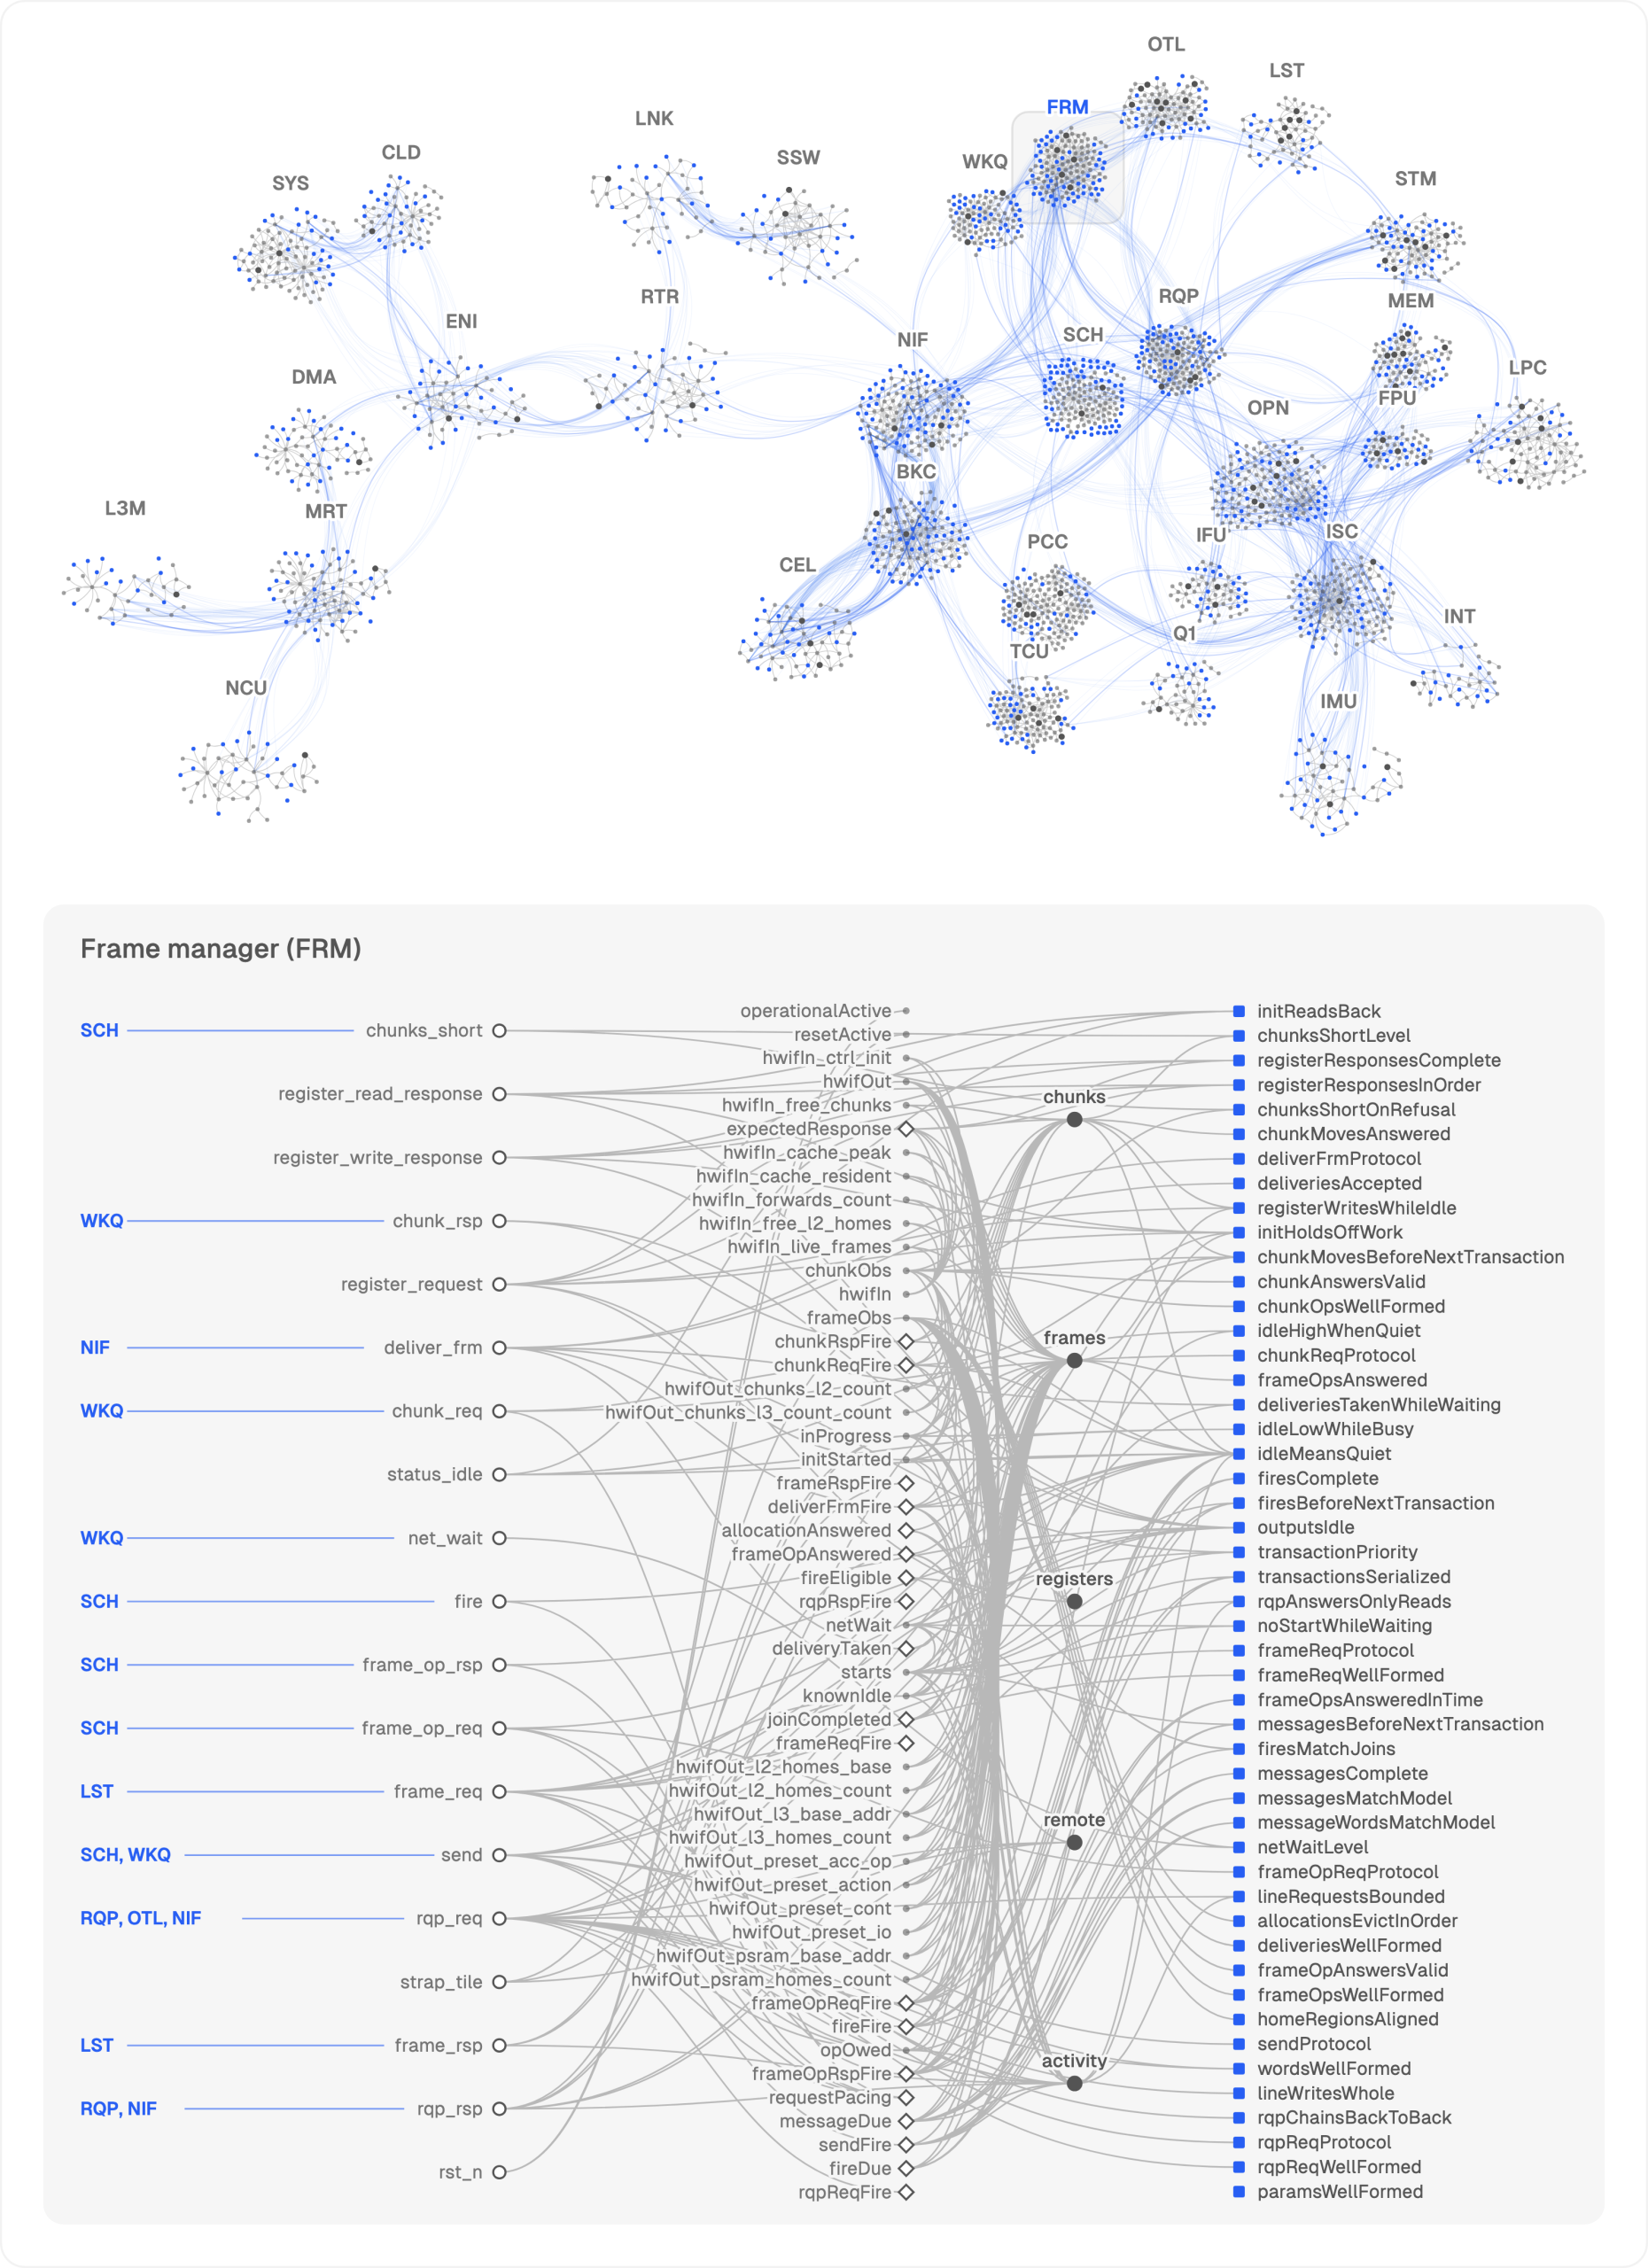
Thiết kế phần cứng do AI tạo ra cần một cách kiểm tra chính xác hơn việc đọc lại mô tả bằng ngôn ngữ tự nhiên. Architect Labs xây dựng ASL, ngôn ngữ đặc tả có thể kiểm tra bằng máy, rồi dùng nó viết mô hình hệ thống Arcmodel và làm cơ sở đối chiếu giữa đặc tả, RTL, mô phỏng và kiểm chứng hình thức.
ASL được chuyển sang Lean để chứng minh định lý; đến cuối quá trình, phần đặc tả Frostbite được hạ thành hơn 800.000 dòng Lean. Công ty cho biết Arcmodel chạy nhanh hơn mô phỏng RTL khoảng 200 lần, còn mô phỏng toàn chip nhanh hơn 660 lần. Mô hình được hiệu chỉnh để sai số ước tính công suất và hiệu năng nằm trong khoảng 1–5% so với RTL.
Cơ chế này không chứng minh mọi lựa chọn kiến trúc đều tốt, nhưng giúp phát hiện sai lệch giữa các thành phần trước khi chúng thành lỗi phần cứng. Đây là phần quan trọng trong tuyên bố “AI thiết kế CPU”: AI đảm nhiệm quá trình tìm kiếm và triển khai, còn hợp đồng hình thức cùng mô hình kiểm tra tạo ra ràng buộc để kết quả không chỉ dựa vào việc tác nhân tự khẳng định đã làm đúng.
4,59 lần là kết quả mô phỏng với đối thủ có giới hạn rõ ràng
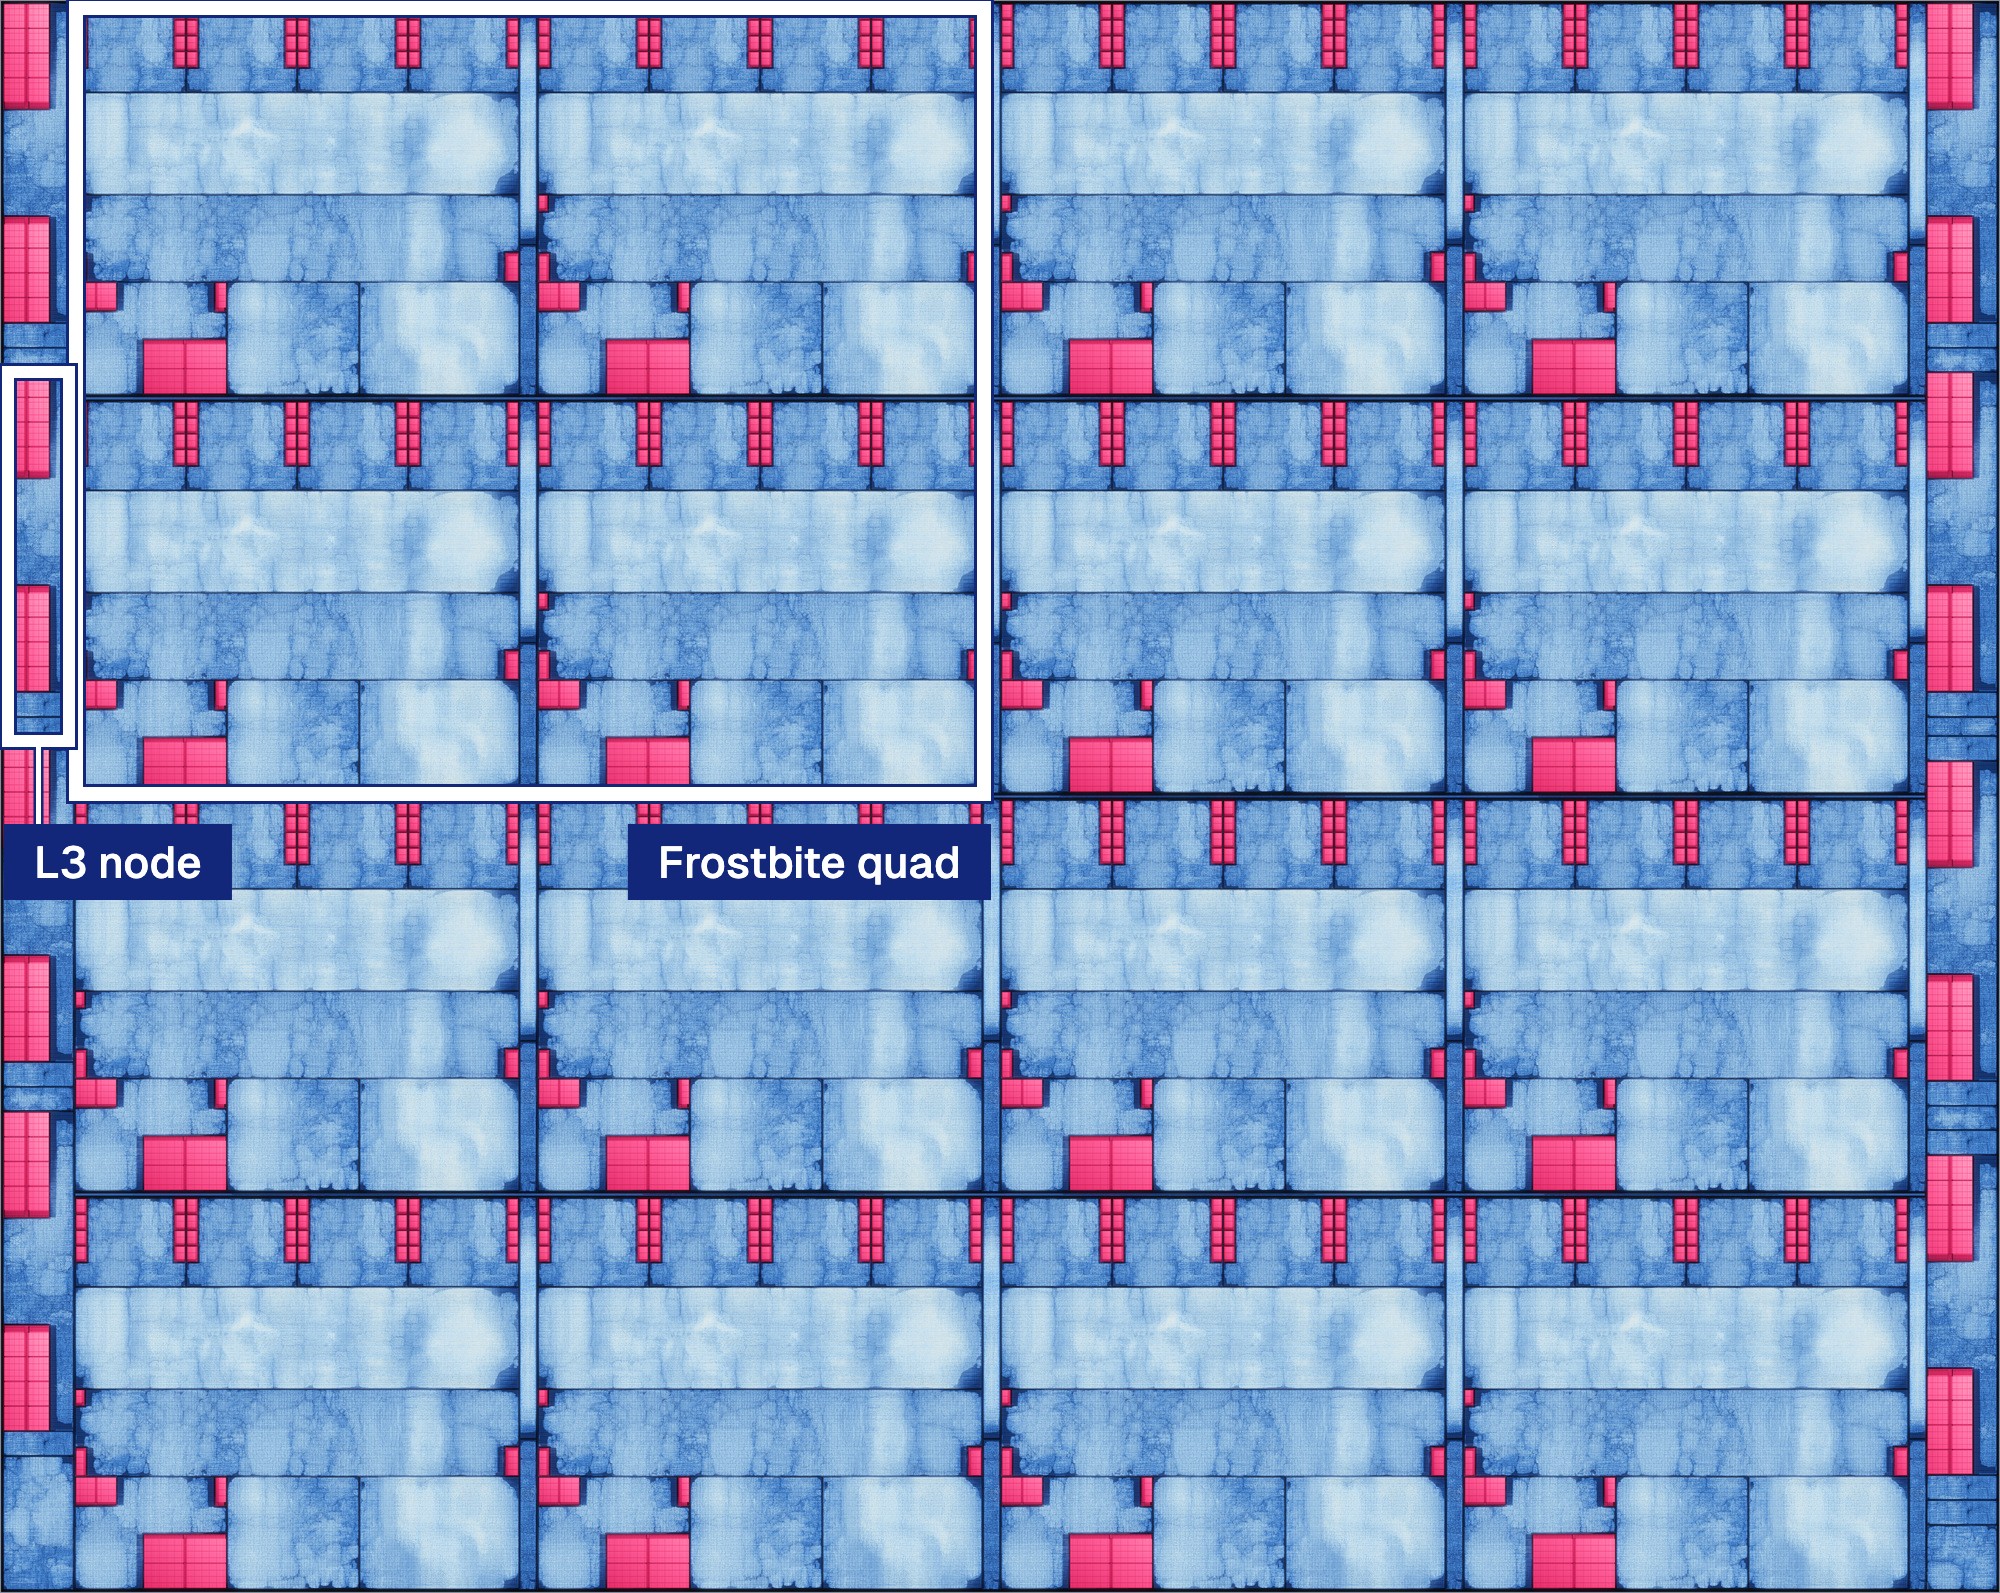
Trong đánh giá do Architect Labs thực hiện trên tiến trình 7nm, một cụm Frostbite gồm bốn tile và bốn node L3 có diện tích 0,792 mm²; nhân TCPU đối chứng chiếm 0,895 mm². Bố trí Frostbite đạt 500 MHz ở layout cuối, thấp hơn mức 800 MHz ở giai đoạn tổng hợp ban đầu.
| Nhóm workload | Số workload | Hiệu năng mỗi watt của Frostbite so với TCPU |
|---|---|---|
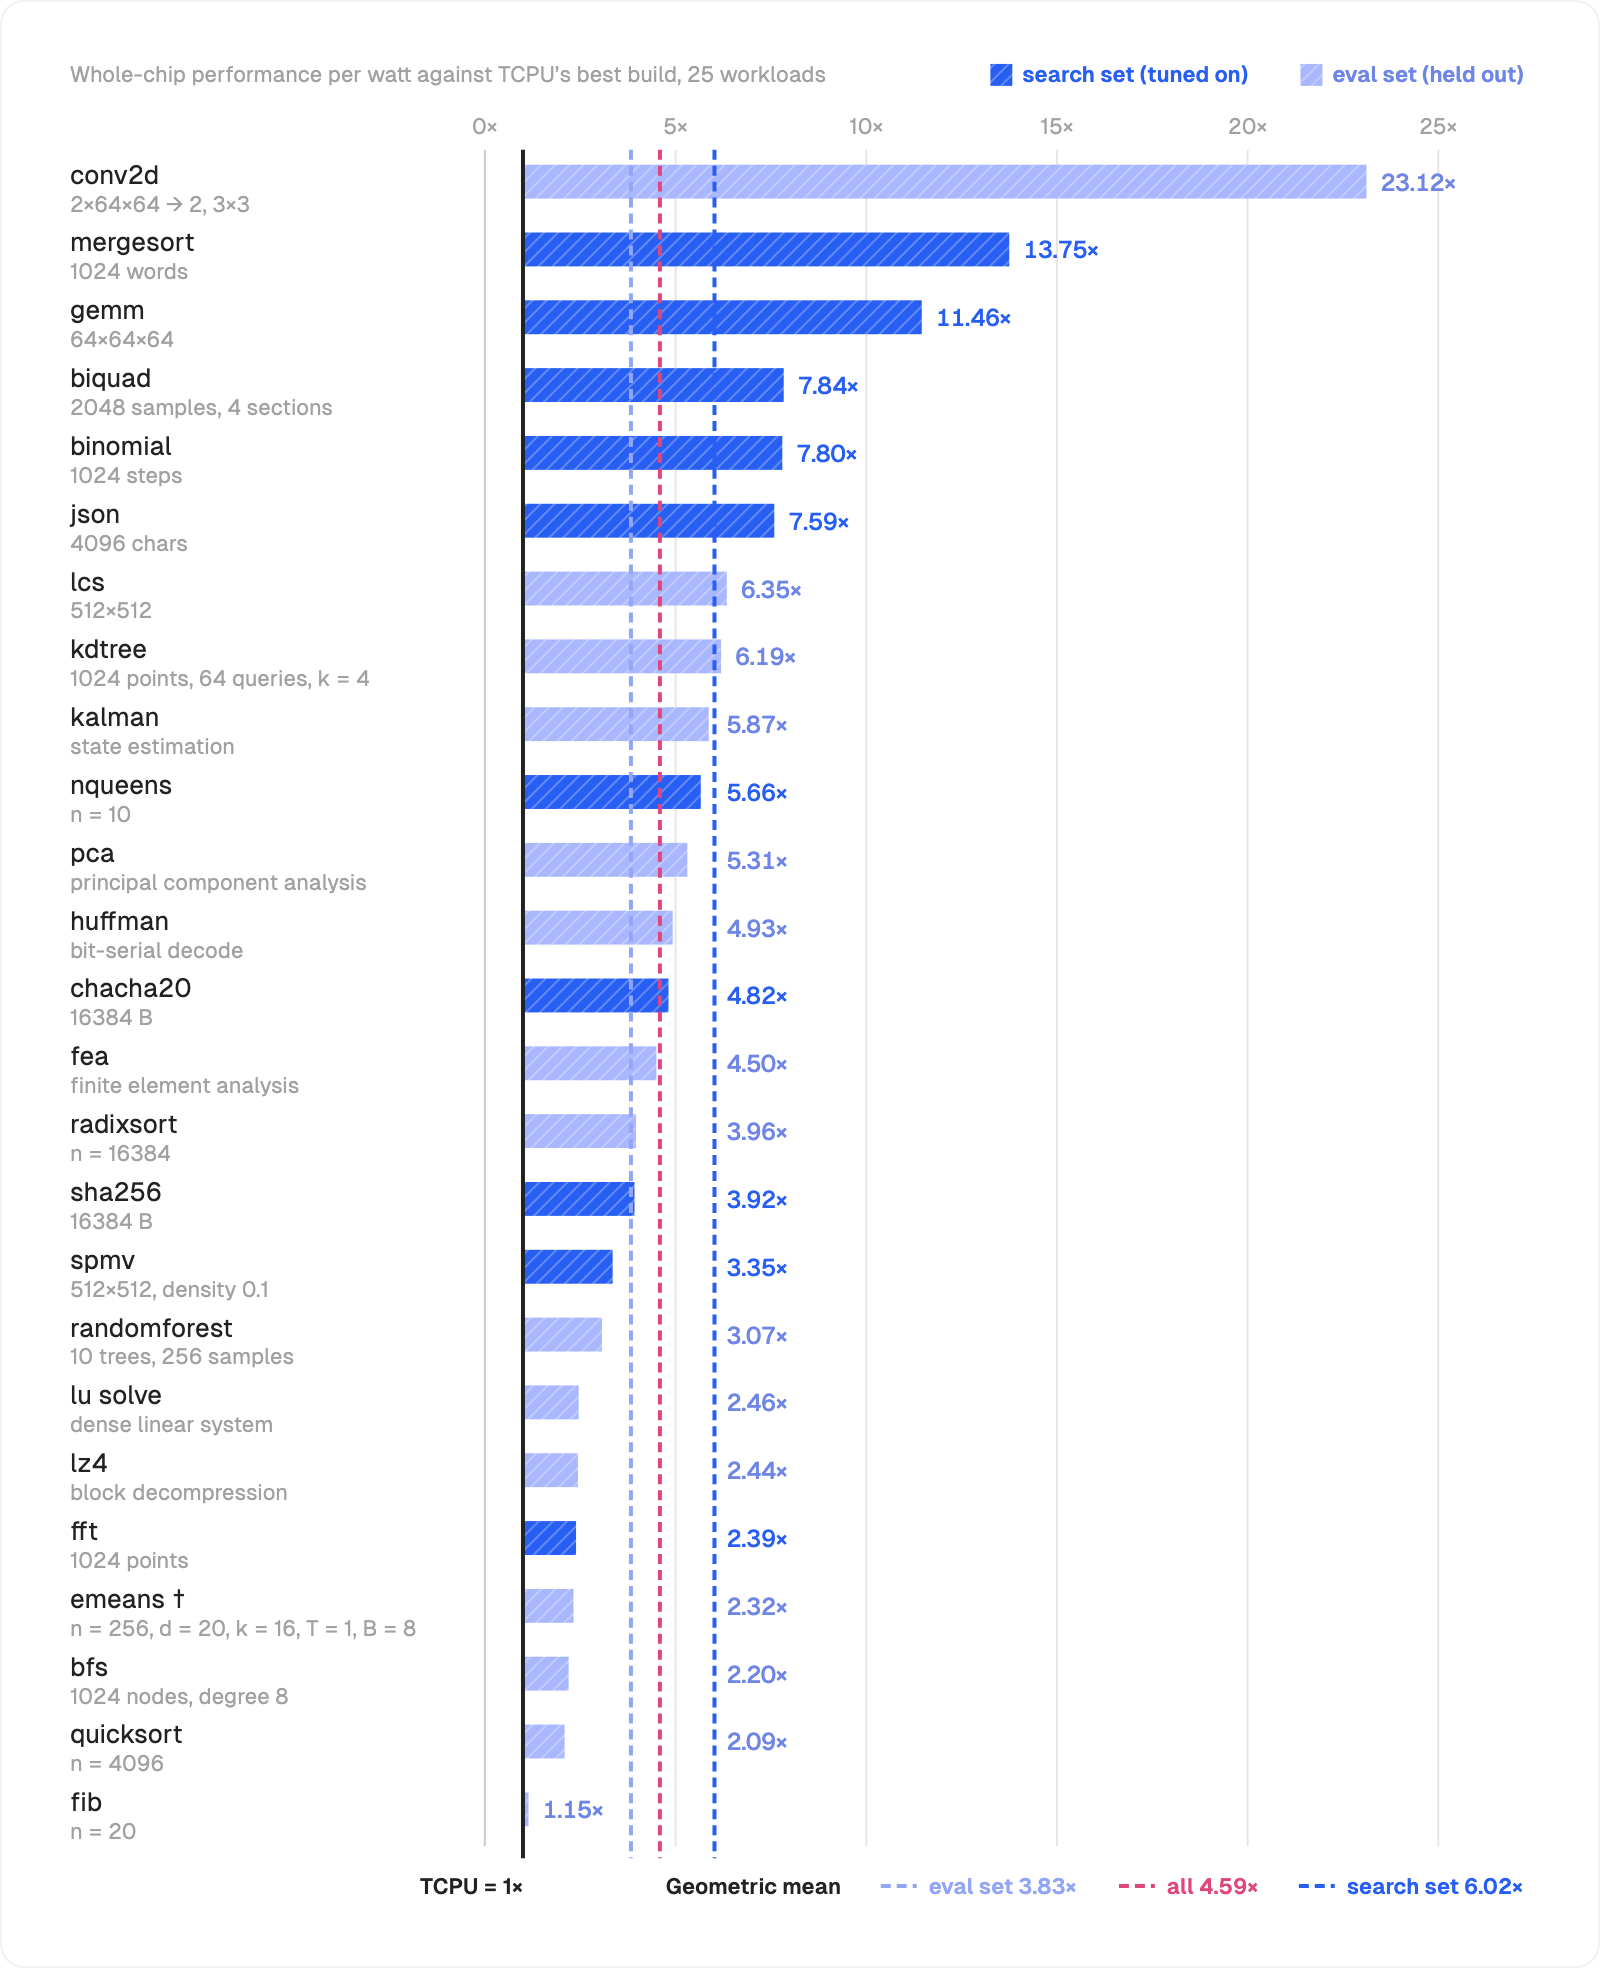
| Toàn bộ bộ thử nghiệm | 25 | 4,59 lần |
| Nhóm dùng để tinh chỉnh | 10 | 6,02 lần |
| Nhóm giữ kín đến đánh giá cuối | 15 | 3,83 lần |
Số liệu: Architect Labs
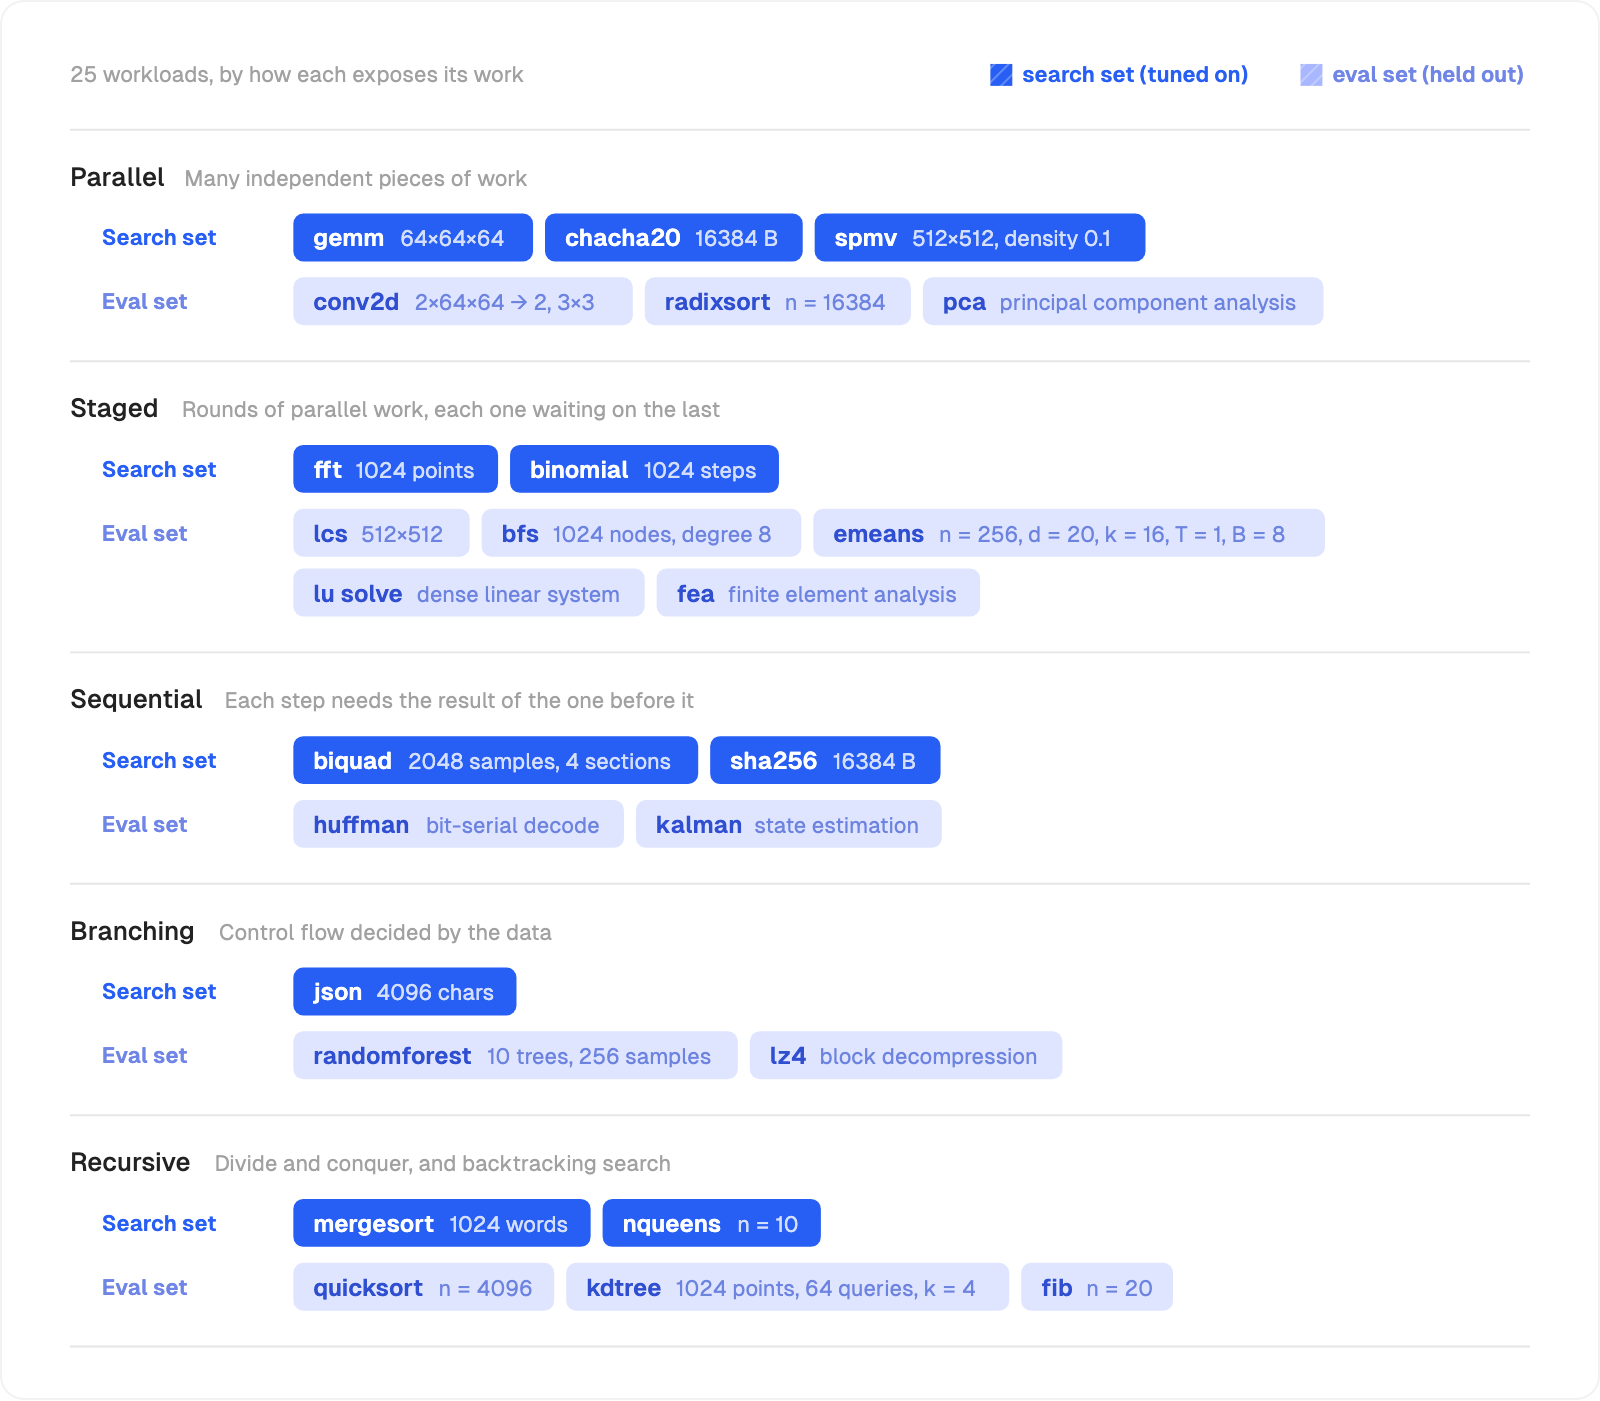
15 workload giữ kín giúp kiểm tra khả năng tổng quát hóa tốt hơn nhóm dùng để tối ưu, nhưng mức 3,83 lần vẫn là kết quả mô phỏng của chính công ty. Đối chứng TCPU không được tiết lộ danh tính vì lý do pháp lý và thuộc loại in-order dual-issue. Vì thế, không thể lấy tỷ lệ này để kết luận Frostbite hiệu quả hơn CPU Ryzen, Core hay Apple Silicon.
Mức tăng cũng tùy bài toán: công ty ghi nhận kết quả tốt nhất ở conv2d, còn Fibonacci đệ quy là workload yếu nhất trong nhóm giữ kín. Cấu trúc phơi bày nhiều phép tính độc lập có lợi cho thiết kế; với chuỗi phụ thuộc dài, khoảng cách thu hẹp đáng kể. Hiệu năng mỗi watt do đó không phải một thuộc tính có thể áp nguyên xi cho mọi ứng dụng.
Giá trị tiếp theo nằm ở phép thử trên chip thật và workload chuẩn
Frostbite hiện là kiến trúc tiền silicon, chưa có sản phẩm bán tại Việt Nam hay thị trường khác. Architect Labs dự định đưa phần mềm thử nghiệm lên FPGA, xây dựng hệ điều hành sơ bộ, mở rộng đánh giá với SPEC và PARSEC, đồng thời cho biết có kế hoạch phát hành RTL cùng tập lệnh.
Cho đến khi có kết quả trên FPGA hoặc silicon và được đối chiếu với các CPU rộng hơn, out-of-order, tuyên bố về hiệu năng vẫn cần được xem là kết quả ban đầu. Điểm đáng theo dõi không phải một phép nhân đơn lẻ, mà là liệu mô hình interaction nets và quy trình thiết kế có thể giữ lợi thế khi chạy phần mềm thực tế, với hệ thống bộ nhớ và đối thủ đại diện hơn cho máy tính hiện nay hay không.
Nguồn tham khảo: Architect Labs; Tom’s Hardware; Notebookcheck