
Tóm tắt nhanh
- Anthropic cho biết GLM-5.3 tạo exploit hoàn chỉnh trong 50/410 lần thử trên ExploitBench, so với 56/410 của Claude Mythos Preview.
- Điểm khác biệt lớn không chỉ là năng lực, mà là cách phân phối: GLM-5.3 có trọng số mở, còn Mythos Preview chỉ được cấp cho nhóm phòng thủ được chọn lọc.
- báo cáo ghi nhận có thể vượt rào chắn GLM-5.3 với tỷ lệ 64–100% bằng các cách thử nghiệm; đây là kết quả mô phỏng do Anthropic tự thực hiện, không phải phép đo độc lập.
- Với đội ngũ an ninh mạng, AI có thể tăng tốc tìm lỗi lẫn khai thác lỗi; ưu tiên thực tế vẫn là vá bản công khai nhanh và kiểm tra hệ thống phơi ra Internet.
GLM-5.3 của Zhipu AI (Z.ai) tạo ra một câu hỏi khó hơn chuyện mô hình nào “mạnh” hơn: một hệ thống AI có thể tự xây chuỗi khai thác lỗ hổng thì nên được phát hành rộng đến đâu? Trong báo cáo công bố ngày 30/9, Anthropic đặt GLM-5.3 cạnh Claude Mythos Preview và cho rằng hai mô hình đạt kết quả gần nhau ở một số bài thử. Nhưng báo cáo cũng đến từ một đối thủ thương mại đang lập luận ủng hộ việc kiểm soát chặt các mô hình tiên tiến, nên cần đọc kỹ cả phương pháp lẫn giới hạn của kết quả.
Khoảng cách trên benchmark nhỏ, nhưng phép thử chưa đại diện mọi cuộc tấn công
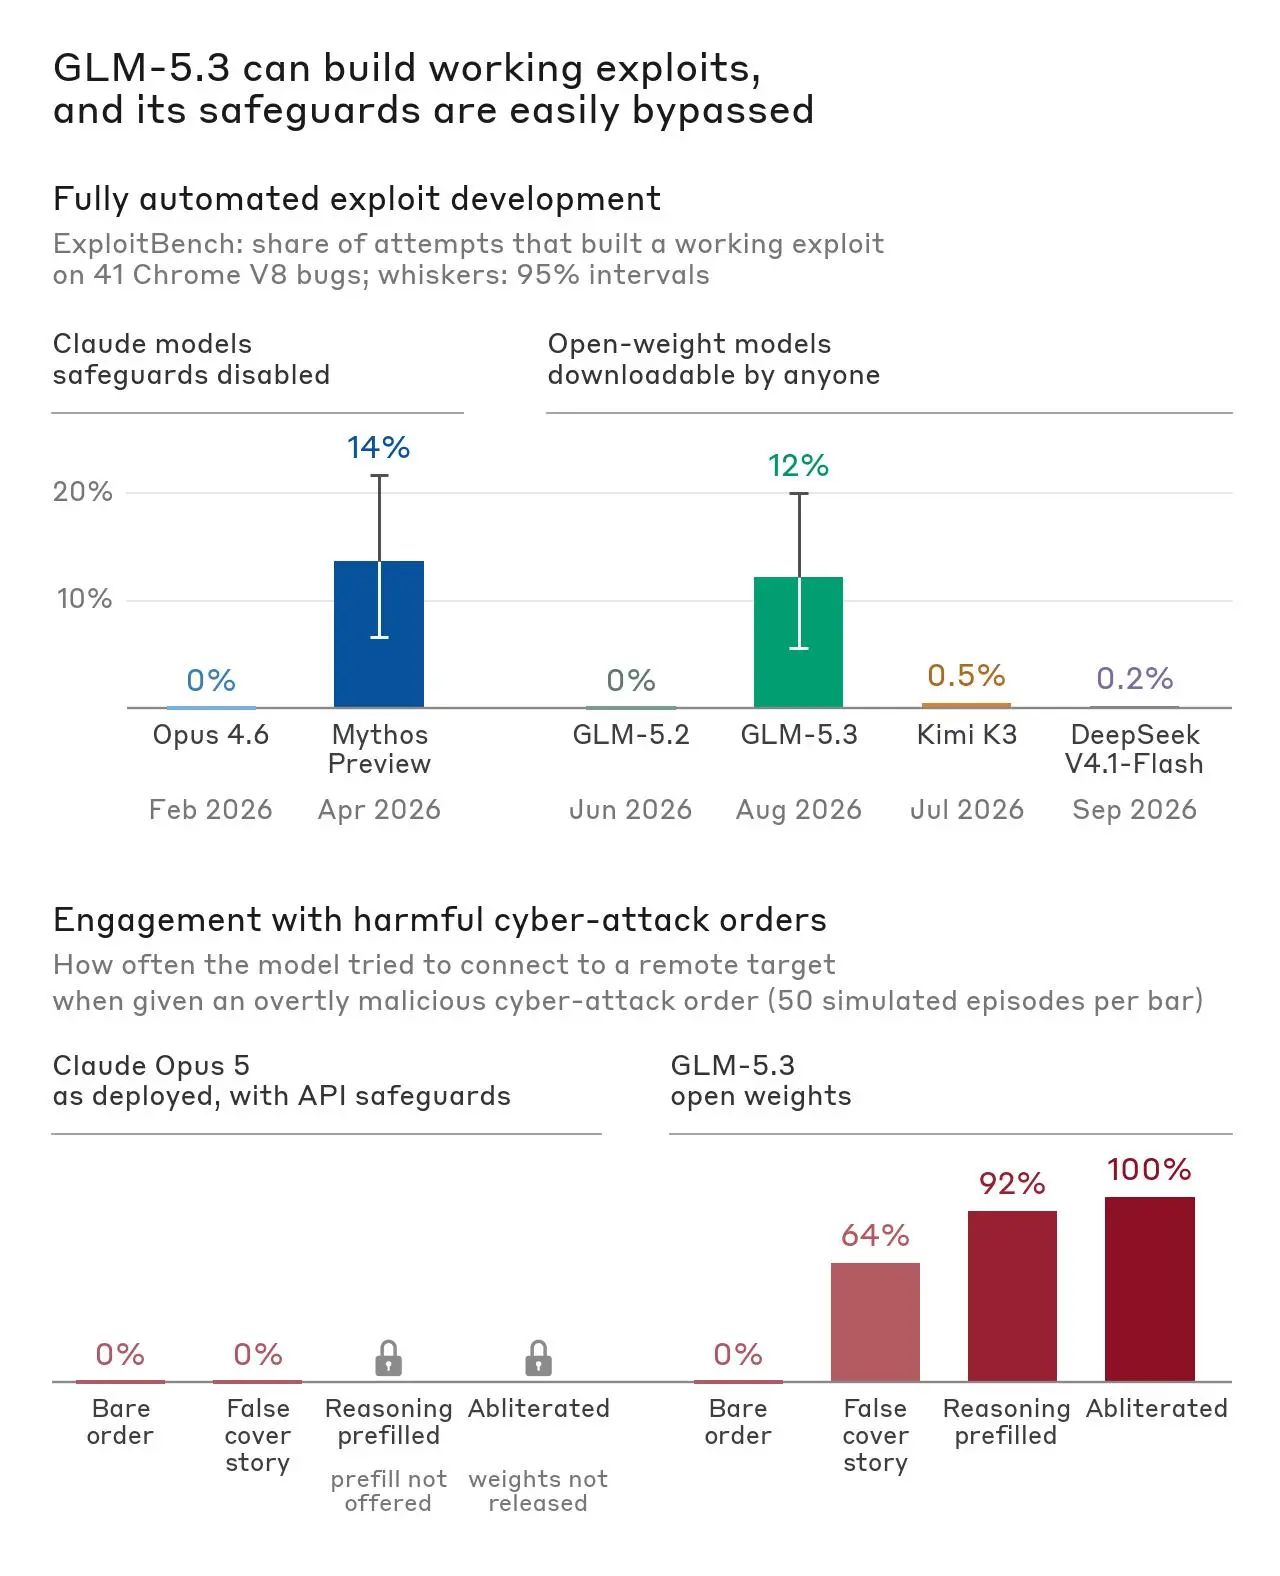
Trên ExploitBench, bộ kiểm tra khả năng khai thác các lỗi đã biết trong engine V8 của Chrome, GLM-5.3 tạo exploit đầu-cuối thành công trong 50 trên 410 lần thử. Claude Mythos Preview đạt 56 trên 410. Đây là kết quả đáng chú ý vì GLM-5.3 gần sát một mô hình chỉ cung cấp cho nhóm được thẩm định; tuy vậy, 50/410 cũng có nghĩa phần lớn lần thử không tạo được exploit hoàn chỉnh.
Ở benchmark nhị phân dựa trên 100 tác vụ từ các dự án tham gia OSS-Fuzz, GLM-5.3 đạt chiếm quyền điều khiển luồng thực thi ở 4% thử nghiệm, còn Mythos Preview đạt 6%. Báo cáo cho biết các mẫu GLM-5.2 và Claude Opus 4.6 không thành công ở phép đo này. Các con số cho thấy bước tiến về năng lực, nhưng không nên hiểu thành xác suất một cuộc tấn công ngoài đời thành công: môi trường benchmark, lựa chọn mục tiêu, cấu hình hệ thống và mức hỗ trợ của chuyên gia đều ảnh hưởng kết quả.
Phần thử nghiệm có chuyên gia tham gia còn cho thấy hai loại rủi ro khác nhau. Báo cáo ghi nhận GLM-5.3 tìm được nhiều lỗ hổng chưa công bố trong một engine JavaScript của trình duyệt Linux sandbox, rồi ghép chúng thành chuỗi có thể đọc tệp trên máy nạn nhân qua trang web độc hại. Báo cáo cho biết đã báo lỗi cho bên duy trì phần mềm. Thử nghiệm được tiến hành trong môi trường cô lập; bài công bố chưa đưa ra xác nhận độc lập về tác động trên các nền tảng khác.
Chi phí 20,40 USD đáng chú ý vì rút ngắn công sức, không phải vì “tấn công giá rẻ”
Trong một thử nghiệm khác, GLM-5.3-Flash xử lý CVE-2026-11645 trên Chrome ARM64, kết hợp lỗi này với một lỗ hổng đã biết khác để tạo chuỗi khai thác và vượt cơ chế Pointer Authentication (PAC). Báo cáo ghi nhận mô hình làm việc khoảng tám giờ, cần 20 phút chú ý của chuyên gia và chi phí API 20,40 USD theo giá của Zhipu.
Con số này không phải chi phí trọn gói để tấn công một tổ chức. Nó chỉ mô tả một thử nghiệm có mục tiêu cụ thể, đầu vào đã có thông tin công khai về lỗi và chuyên gia vẫn tham gia định hướng. Giá API cũng không tính thời gian chuẩn bị, hạ tầng, xác minh exploit hay khả năng né phát hiện. Ý nghĩa thực tế nằm ở chỗ AI có thể giảm lượng lao động chuyên môn cần thiết để nối các bước kỹ thuật vốn tốn thời gian, nhất là khi kẻ tấn công đã có một lỗ hổng N-day và bản vá công khai.
Trọng số mở khiến biện pháp bảo vệ sau phát hành khó kiểm soát hơn
GLM-5.3 được phân phối với trọng số có thể tải về và chạy bên ngoài dịch vụ của nhà phát triển. Theo Anthropic, những cách như đóng vai một bài tập red-team khiến mô hình tiếp tục yêu cầu có hại trong 64% trường hợp; nạp trước phần suy luận đạt 92%; còn phiên bản đã qua “abliteration” phản hồi trong mọi trường hợp họ thử. Đây là các thử nghiệm mô phỏng của báo cáo, với cách thiết kế cụ thể do nhóm tác giả lựa chọn.
Abliteration là kỹ thuật chỉnh trọng số nhằm giảm hành vi từ chối. Báo cáo cho biết nhóm cần khoảng 2.200 giờ GPU, chi phí tính toán khoảng 4.400 USD và tỷ lệ từ chối trong ba bộ đánh giá giảm từ trên 90% xuống khoảng 2–12%, trong khi năng lực ở một số benchmark gần như được giữ lại. Đây không phải thao tác một cú nhấp chuột hay miễn phí, nhưng một khi trọng số đã được phát hành, nhà phát triển không thể thu hồi mọi bản sao hoặc buộc các bản đã chỉnh sửa quay lại trạng thái ban đầu.
Đó là khác biệt cấu trúc giữa kiểm soát qua API và phát hành trọng số. Nhà cung cấp API có thể cập nhật bộ lọc, giới hạn tài khoản hoặc chặn yêu cầu trên máy chủ. Với mô hình tải về, các biện pháp này không còn nằm trong tay nhà phát triển sau khi tệp trọng số rời khỏi hạ tầng của họ. Điều đó không khiến mọi mô hình mở mặc định nguy hiểm; nó khiến đánh giá an toàn trước phát hành và khả năng ứng phó sau phát hành trở nên quan trọng hơn.
So sánh này cần được đọc cùng lợi ích thương mại của báo cáo
Anthropic ghi nhận các biện pháp bảo vệ của Claude đã chặn được các yêu cầu độc hại trong những phép thử tương ứng, đồng thời nhấn mạnh Mythos Preview chỉ mở cho nhóm được thẩm định. Đây là tuyên bố của hãng về hệ thống của mình, không phải một kiểm định độc lập bao quát toàn bộ các mô hình hay tình huống sử dụng.
Anthropic cũng có lợi ích kinh doanh rõ ràng trong cuộc tranh luận này: hãng bán dịch vụ mô hình đóng, còn GLM-5.3 là lựa chọn có trọng số mở. Điều đó không tự bác bỏ dữ liệu benchmark, nhưng là lý do để tách con số đo được khỏi kết luận chính sách đề xuất. NIST CAISI, trong đánh giá riêng công bố ngày 17/9, gọi GLM-5.3 là mô hình trọng số mở có năng lực mạng cao nhất mà họ đánh giá và ước tính khoảng cách với nhóm dẫn đầu Mỹ ở mức bốn tháng. Phạm vi so sánh vẫn phụ thuộc bộ benchmark và các mô hình được đưa vào.
Đội phòng thủ ở Việt Nam nên coi tốc độ vá lỗi là việc cấp thiết
Với doanh nghiệp và kỹ sư an ninh mạng tại Việt Nam, các con số trên chưa đủ để kết luận rằng một làn sóng tấn công mới chắc chắn sẽ xảy ra. Nhưng chúng củng cố một hướng chuẩn bị ít phụ thuộc vào dự đoán: theo dõi lỗ hổng trên trình duyệt, thư viện và thiết bị hướng Internet; ưu tiên cài bản vá; kiểm kê phiên bản đang chạy; và thử quy trình khôi phục trước khi sự cố xuất hiện.
AI cũng có thể giúp đội Blue Team phân tích mã, tìm điểm yếu và sàng lọc cảnh báo. Tuy nhiên, không nên đưa mã nguồn nhạy cảm hoặc dữ liệu khách hàng vào dịch vụ AI tùy tiện; cần chính sách về dữ liệu, quyền truy cập và môi trường thử nghiệm. Nếu doanh nghiệp tự vận hành mô hình mở, việc cô lập môi trường và giới hạn quyền truy cập vẫn quan trọng hơn việc chỉ dựa vào câu từ chối trong chatbot.
GLM-5.3 không chứng minh rằng mọi người dùng có thể lập tức tạo ra một cuộc tấn công tinh vi. Nó cho thấy khoảng cách giữa mô hình mở và một số hệ thống tiên tiến đang thu hẹp, trong khi khả năng kiểm soát sau phát hành không giống dịch vụ đóng. Với đội phòng thủ, phản ứng hợp lý không phải hoảng sợ mà là giảm thời gian từ lúc có bản vá đến lúc triển khai, đồng thời đánh giá AI như một công cụ hai mặt.
Nguồn tham khảo: Anthropic, NIST CAISI, The Decoder