Tóm tắt nhanh
- Trong cập nhật Android Bench ngày 26/10/2026, Gemini 4 Argon đạt tỷ lệ vượt bài kiểm tra 21,3%, còn Claude Sonnet 5.5 đạt 40%.
- GPT-6.1 Sol đạt 29,3% với chi phí được bảng ghi nhận là 99,5 USD, thấp hơn các đối thủ trong danh sách hiển thị.
- Argon vẫn dẫn đầu một số benchmark khác trong bảng Google công bố; kết quả Android không đại diện cho mọi loại lập trình.
- Khi chọn công cụ cho dự án Android, cần kiểm tra cả bản sửa có đạt yêu cầu hay không, thay vì chỉ xem tác vụ đã chạy xong.
Google cập nhật Android Bench ngày 26/10 với kết quả không thuận lợi cho Gemini 4 Argon: mô hình của hãng đứng sau các đối thủ Claude và GPT trên chính phép thử dành cho lập trình Android. Điểm đáng xem hơn thứ hạng là khoảng cách giữa tỷ lệ hoàn thành tác vụ và tỷ lệ thực sự vượt bài kiểm tra, cùng chi phí để tạo ra kết quả đó.
Đây là hai câu hỏi khác nhau khi đưa AI vào dự án: công cụ có đi đến cuối quy trình hay không, và phần việc hoàn thành có đáp ứng tiêu chí đánh giá hay không. Một mô hình trả về kết quả đều đặn vẫn có thể khiến lập trình viên mất nhiều công kiểm tra, sửa lại hoặc bỏ bản sửa.
Hoàn thành tác vụ chưa có nghĩa là vượt bài kiểm tra
Argon không thua vì bỏ dở phần lớn tác vụ: tỷ lệ hoàn thành của nó khá gần các đối thủ, trong khi tỷ lệ vượt bài kiểm tra lại thấp hơn đáng kể. Theo số liệu Android Bench được 9to5Google công bố, Argon đạt 81,8% tỷ lệ hoàn thành nhưng chỉ đạt 21,3% tỷ lệ vượt bài kiểm tra; Sonnet 5.5 có tỷ lệ hoàn thành thấp hơn, 80,9%, nhưng tỷ lệ vượt bài kiểm tra đạt 40%.
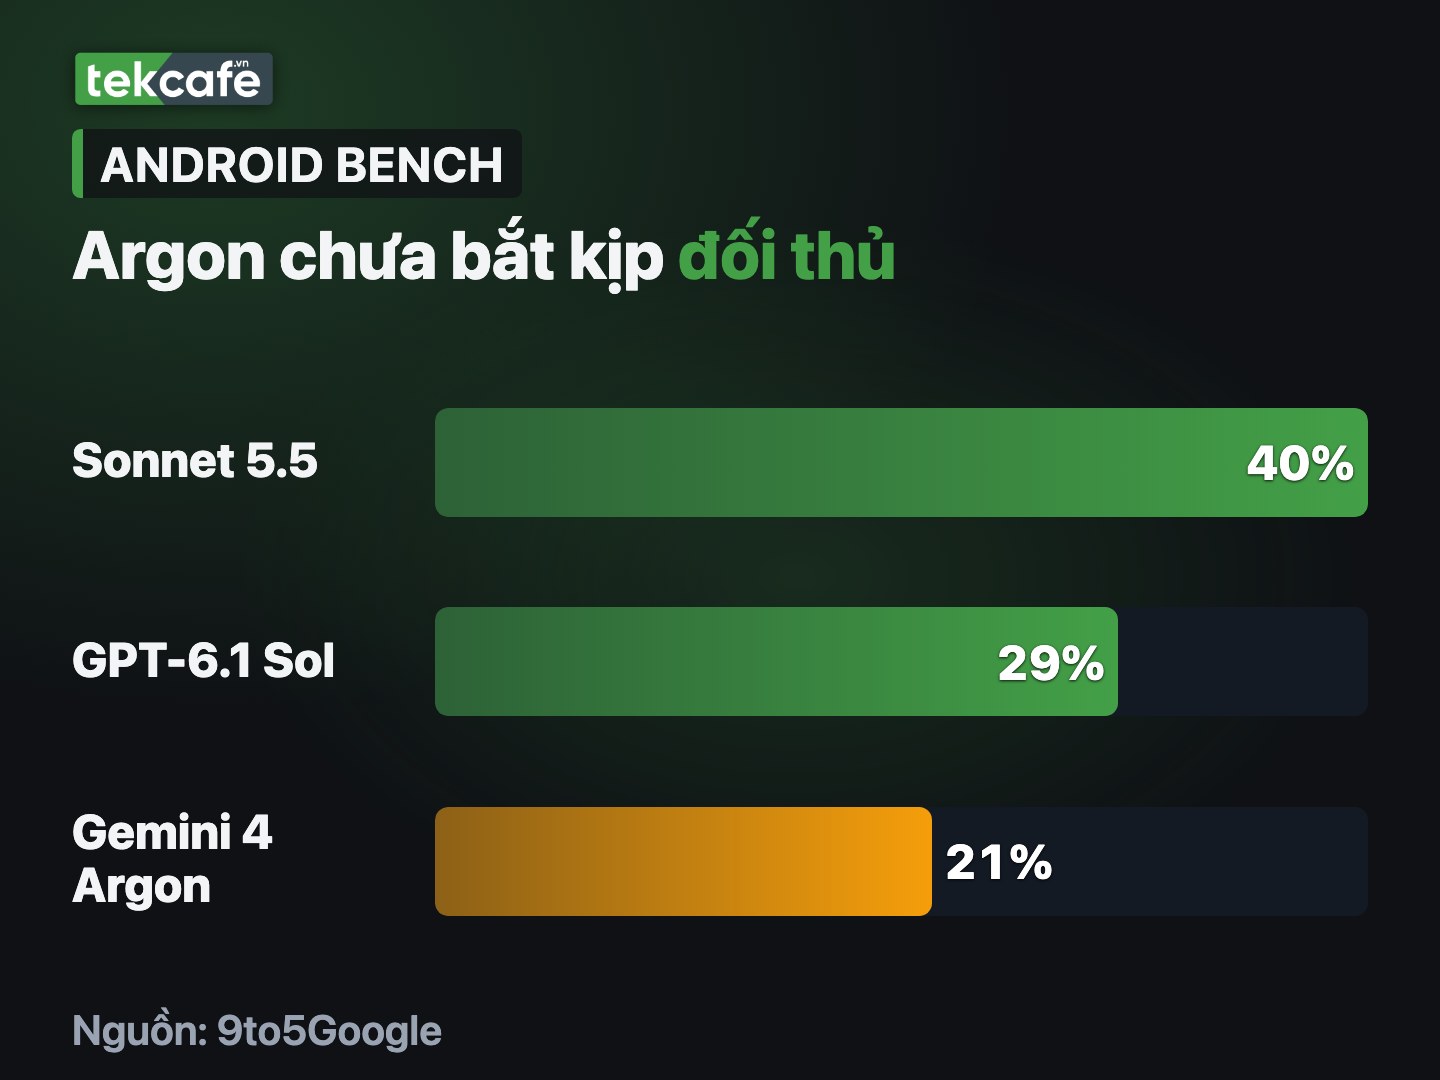
| Chỉ số Android Bench | Gemini 4 Argon | Claude Sonnet 5.5 | GPT-6.1 Sol |
|---|---|---|---|
| Tỷ lệ vượt bài kiểm tra, % (cao hơn tốt hơn) | 21,3 | 40,0 | 29,3 |
| Tỷ lệ hoàn thành, % (cao hơn tốt hơn) | 81,8 | 80,9 | 82,8 |
| Chi phí trung bình trong bảng, USD (thấp hơn tốt hơn) | 267,6* | 1.574,9 | 99,5 |
| Độ trễ trung bình trong bảng, giờ (thấp hơn tốt hơn) | 52,8 | 70,7 | 26,6 |
Số liệu: bảng Android Bench đăng trên 9to5Google. *Ảnh bảng ghi chi phí của Argon là 267,6 USD, còn phần chữ của 9to5Google ghi 267,7 USD. Đây là chi phí trong phép thử, không phải giá thuê bao hay giá cho một yêu cầu API bất kỳ.
Khoảng cách này khiến tỷ lệ hoàn thành không đủ để làm tiêu chí chọn AI viết ứng dụng. Nó chỉ cho biết một mặt của quá trình thực hiện; lập trình viên vẫn cần xem kết quả cuối cùng có đạt tiêu chuẩn mà phép thử đặt ra hay không. Android Bench được Google xây dựng cho các yêu cầu đặc thù và thực hành phát triển Android, nên có ý nghĩa trực tiếp hơn một điểm tổng hợp chung khi công việc cần giải quyết cũng là Android.
Cũng cần cẩn thận với cách gọi thứ hạng. Phần chữ của 9to5Google gọi Argon là thứ năm, nhưng ảnh bảng đi kèm hiển thị Argon ở dòng thứ sáu, sau Sonnet 5.5, Opus 5.5, GPT-6.1 Sol, GPT-6 Astra và Fable 5.1. Các khoảng tin cậy trong ảnh còn chồng lấn nhau, vì vậy thứ tự điểm trung tâm không tự nó chứng minh mọi cặp mô hình đều khác biệt có ý nghĩa thống kê.
Chi phí thấp hơn có giá trị khi tỷ lệ đạt yêu cầu vẫn cao hơn
GPT-6.1 Sol là trường hợp đáng thử trước nếu ngân sách là giới hạn chính: trong nhóm so sánh ở trên, nó vừa có tỷ lệ vượt bài kiểm tra cao hơn Argon, vừa có chi phí thấp hơn. Đây là lợi thế rõ hơn việc chỉ đứng cao hơn một dòng trên bảng xếp hạng, dù chưa đủ để khẳng định mọi dự án Android đều sẽ có cùng kết quả.
Phần còn lại của ảnh Android Bench do 9to5Google đăng cho thấy vị trí của các lựa chọn nằm giữa những mô hình này:
| Chỉ số Android Bench | Claude Opus 5.5 | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|
| Tỷ lệ vượt bài kiểm tra, % (cao hơn tốt hơn) | 37,3 | 28,0 | 22,7 |
| Tỷ lệ hoàn thành, % (cao hơn tốt hơn) | 85,6 | 82,2 | 82,4 |
| Chi phí trung bình, USD (thấp hơn tốt hơn) | 1.150,3 | 375,7 | 492,6 |
| Độ trễ trung bình, giờ (thấp hơn tốt hơn) | 56,6 | 7,9 | 22,2 |
Số liệu: bảng Android Bench đăng trên 9to5Google. Ô in đậm chỉ giá trị tốt nhất trong từng bảng nhỏ, không phải toàn bộ danh sách.
Không nên biến cột chi phí này thành dự toán thanh toán cho ứng dụng của mình. Kết quả còn gắn với công cụ thực thi và mức suy luận: ảnh bảng ghi Claude chạy qua Claude Code, GPT qua Codex, còn Argon qua Antigravity SDK; mức suy luận cũng không đồng nhất giữa các dòng. Bảng phản ánh những cấu hình đã được đánh giá, không tách riêng được ảnh hưởng của mô hình khỏi mọi thành phần đi kèm.
Với nhóm phát triển tại Việt Nam, cách dùng số liệu hữu ích hơn là chọn vài ứng viên để chạy lại trên công việc thật. Nếu một công cụ rẻ hơn nhưng cần nhiều lượt sửa, thời gian rà soát có thể làm mất lợi thế ban đầu. Ngược lại, trả mức chi phí cao nhất chỉ để lấy vị trí đầu bảng cũng chưa chắc hợp lý khi phần việc của dự án khác nội dung phép thử.
Argon không yếu ở mọi dạng lập trình
Kết quả Android không đủ để gọi Argon là mô hình lập trình kém nhất, bởi khả năng của nó thay đổi đáng kể theo phép thử. Trong bảng đánh giá Google công bố được ToolScout đăng lại, Argon đứng đầu DeepSWE v1.1 và Vibe Code Bench, nhưng đứng cuối nhóm ở FrontierSWE v2 và Terminal-Bench 4.0.
| Phép thử, % (cao hơn tốt hơn) | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| DeepSWE v1.1 | 77,9 | 74,1 | 67,4 | 74,2 |
| FrontierSWE v2 | 55,0 | 65,5 | 56,3 | 62,3 |
| Vibe Code Bench | 91,9 | 89,6 | 90,3 | 90,3 |
| Terminal-Bench 4.0 | 57,4 | 58,2 | 57,9 | 66,4 |
| PostTrainBench | 45,3 | 44,3 | 40,2 | 49,3 |
Số liệu: bảng đánh giá Gemini 4 Argon của Google, đăng trên ToolScout. Đây là các phép thử riêng, không cùng thang đánh giá với Android Bench.
Điều kiện đo cũng cần đi cùng con số. Với DeepSWE v1.1, Google tự chạy Argon bằng mini-swe agent, còn số đối thủ lấy từ bảng xếp hạng công khai hoặc tài liệu của Anthropic. Với PostTrainBench, Google chạy tất cả mô hình bằng OpenCode, giới hạn thời gian mười giờ trên một GPU NVIDIA H100. Không thể coi mọi hàng là một cuộc thử nghiệm được tổ chức giống hệt nhau.
Vì thế, điểm DeepSWE cao không phủ nhận kết quả Android Bench thấp, và kết quả Android cũng không xóa đi lợi thế ở DeepSWE. Hai nhận định chỉ mâu thuẫn nếu coi “lập trình” là một năng lực duy nhất, trong khi sửa dự án phần mềm dài hơi và xử lý công việc trong terminal có yêu cầu khác nhau.
Điểm tổng hợp cao không thay được phép thử đúng công việc
Những lợi thế ngoài lập trình giúp giải thích vì sao một mô hình có thể ra mắt với nhiều điểm dẫn đầu mà vẫn không phải lựa chọn đầu tiên cho Android. Phần còn lại trong bảng Google công bố trải rộng từ công việc tri thức đến xử lý ngữ cảnh dài; đó không phải những điểm có thể cộng thẳng vào khả năng sửa ứng dụng.
| Phép thử công việc, % (cao hơn tốt hơn) | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| Vals Index | 68,9 | 63,1 | 65,8 | 67,0 |
| AutomationBench | 51,3 | 41,4 | 31,4 | 42,5 |
| Vals Finance Agent v2 | 65,4 | 53,5 | 58,9 | 58,6 |
| Harvey’s Legal Agent Benchmark | 19,6 | 5,4 | 6,7 | 3,8 |
| GraphWalks, đến 128 nghìn token | 99,7 | 98,7 | 91,4 | 90,6 |
| GraphWalks, 256 nghìn đến 1 triệu token | 84,2 | 71,8 | 65,0 | 66,8 |
Số liệu: bảng đánh giá của Google đăng trên ToolScout. Các chỉ số phần trăm thuộc từng phép thử độc lập.
| Phép thử khoa học, hình ảnh và công cụ, % (cao hơn tốt hơn) | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| Terminal-Bench Science 0.1 | 57,6 | 68,1 | 52,6 | 63,3 |
| LABBench 2 | 88,8 | 85,4 | 68,6 | 73,1 |
| RiemannBench | 76,0 | 72,0 | 65,6 | 69,6 |
| Agent’s Last Exam | 39,5 | 34,2 | — | 38,2 |
| OSWorld 2.0, tập con ngoại tuyến | 69,2 | 72,6 | — | — |
| Chartography | 71,6 | 71,0 | 46,2 | 66,3 |
| LVBench | 91,7 | 87,5 | 79,7 | 83,7 |
| CWE-bench v1 | 68,0 | 68,0 | 58,0 | 67,0 |
Số liệu: bảng đánh giá của Google đăng trên ToolScout. Dấu gạch ngang là không có điểm được công bố trong bảng.
Argon có lợi thế rõ ở ngữ cảnh dài trong các kết quả này, nhưng điều đó chưa cho biết nó sẽ sửa đúng một lỗi Android cụ thể. Ngay cả vị trí dẫn đầu cũng cần đọc cùng mức điểm tuyệt đối: tỷ lệ 19,6% ở bài pháp lý vẫn để lại phần lớn tác vụ không đạt, dù cao hơn các mô hình còn lại.
Các điều kiện khác nhau còn giới hạn việc so trực tiếp: Google tăng thời gian chờ xác minh cho Argon ở Terminal-Bench Science lên sáu lần mặc định; điểm OSWorld của Argon lấy kết quả tốt nhất trong ba lượt, trên tập con ngoại tuyến và có chấm điểm một phần. Ở LVBench, Argon nhận một khung hình mỗi giây, còn các đối thủ nhận số khung hình cố định theo giới hạn API. Lợi thế của cả hệ thống cung cấp dữ liệu có thể góp phần vào điểm số, chứ không chỉ khả năng suy luận của mô hình.
Với dự án Android, hãy chọn theo bản sửa đạt yêu cầu
Lựa chọn hợp lý lúc này là dùng Android Bench để lập danh sách thử nghiệm, không dùng nó thay quyết định kỹ thuật cho cả dự án. GPT-6.1 Sol đáng được đưa vào vòng thử về hiệu quả chi phí, còn Sonnet 5.5 là mốc đối chiếu khi ưu tiên tỷ lệ vượt bài kiểm tra. Argon cần chứng minh thêm trên chính loại công việc Android mà nhóm định giao, thay vì được chọn mặc định chỉ vì cùng do Google phát triển.
Nhóm phát triển có thể lấy những lỗi đã biết trong dự án, yêu cầu các công cụ tạo bản sửa trong cùng giới hạn, rồi đánh giá bằng bộ kiểm thử và quy trình rà soát mã đang dùng. Chi phí cần tính đến cả lượt chạy lại lẫn thời gian kiểm tra của con người. Với cách đó, một điểm số trên bảng mới được chuyển thành quyết định có ích cho sản phẩm, thay vì thành lời khẳng định rằng một mô hình luôn giỏi hơn mô hình khác.
Nguồn tham khảo: 9to5Google — Android Bench ngày 26/10; ToolScout — bảng đánh giá và điều kiện benchmark Gemini 4 Argon.