Tóm tắt nhanh
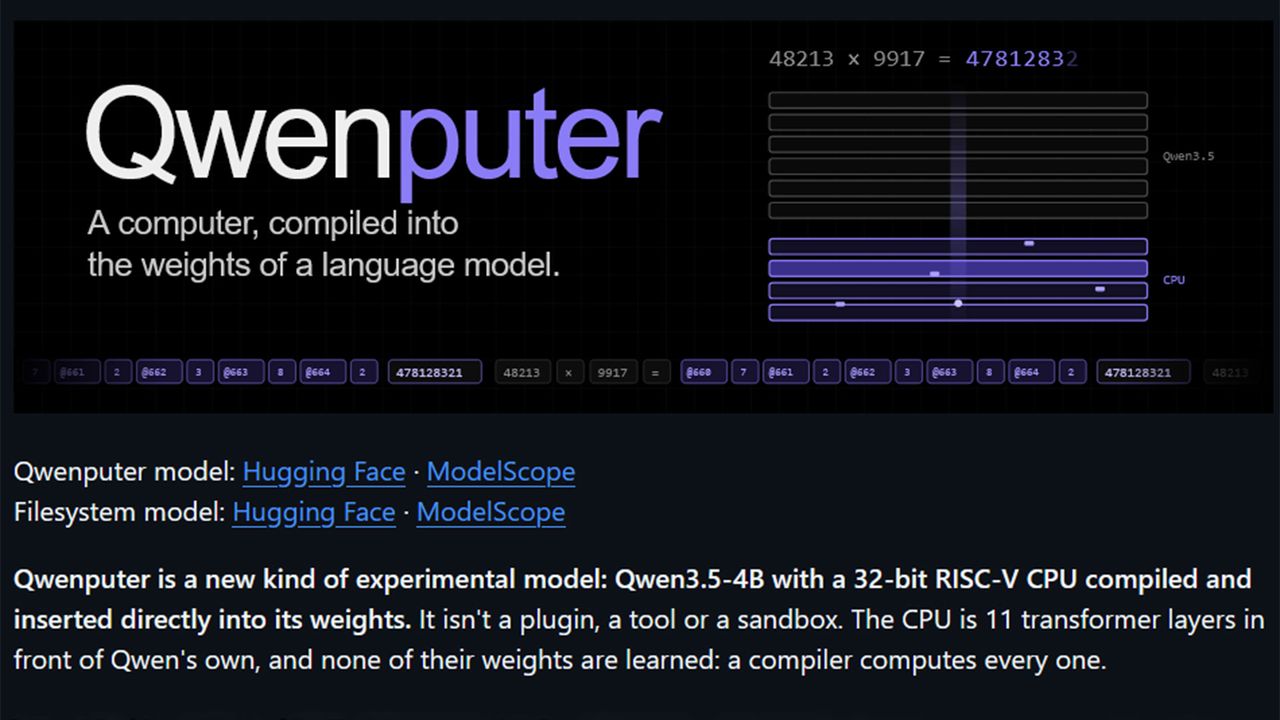
- Qwenputer bổ sung CPU RISC-V 32-bit vào Qwen3.5-4B bằng trọng số được tính bởi trình biên dịch, không qua huấn luyện phần CPU.
- Trạng thái Gated DeltaNet làm bộ nhớ để CPU thực thi mã C và MicroPython trong quá trình suy luận; đã có trình diễn DOOM chạy rất chậm.
- Trong thử nghiệm do tác giả công bố, bản RISC-V đạt 97,5% ở DeepMind mul_big, còn Qwen gốc không dùng công cụ đạt 55%.
- Checkpoint BF16 khoảng 18,8 GB, cấu hình thử nghiệm được khuyến nghị là GPU 24 GB VRAM; đây vẫn là dự án thực nghiệm.
Kỹ sư Divyansh Agrawal đã đưa một CPU RISC-V 32-bit vào các lớp trọng số bổ sung của Qwen3.5-4B, tạo thành mô hình thực nghiệm Qwenputer có thể thực thi chương trình thay vì chỉ dự đoán câu trả lời. Trình diễn DOOM khiến dự án dễ được chú ý, nhưng phần đáng quan tâm hơn là cách một mô hình ngôn ngữ có thể sử dụng bộ tính toán được lập trình sẵn ngay bên trong quá trình suy luận.
CPU ở đây không phải con chip vật lý mới, cũng không phải một cửa sổ Python được giấu sau chatbot. Nó là một mạch tính toán được biểu diễn bằng các lớp mạng nơ-ron, còn GPU bên ngoài vẫn phải thực hiện toàn bộ phép tính để chạy mô hình.
Trọng số giữ mạch tính toán, còn trạng thái DeltaNet giữ dữ liệu
Điểm cần phân biệt là nơi lưu chương trình đang chạy và nơi định nghĩa CPU. Theo tài liệu Qwenputer, trình biên dịch tính ra trọng số cho 11 lớp transformer đặt trước các lớp Qwen gốc; phần CPU này không được học bằng quá trình huấn luyện thông thường. Các trọng số Qwen gốc vẫn được giữ nguyên.
Còn RAM của máy tính nằm trong trạng thái hồi quy Gated DeltaNet, không phải mỗi lần ghi một con số là mô hình tự sửa lại bộ trọng số đã lưu trên đĩa. DeltaNet duy trì một ma trận trạng thái khi xử lý chuỗi token; Qwenputer tận dụng quy tắc cập nhật của nó để biến từng hàng thành ô nhớ có thể đọc và ghi chính xác.
Với cách bố trí được tác giả mô tả, khóa dạng one-hot chọn đúng một hàng cần ghi, còn truy vấn one-hot đọc lại hàng đó. Khi cổng giữ trạng thái mở và mức ghi được đặt phù hợp, dữ liệu mới thay thế hàng được chọn mà không làm thay đổi những hàng còn lại. Mã chương trình và dữ liệu được giữ trong vùng nhớ này, bên cạnh các vùng dành cho thanh ghi và bộ đếm chương trình.
Nhờ có địa chỉ nhớ và trạng thái máy rõ ràng, phép nhân có thể được thực hiện theo các bước xác định, thay vì trông chờ mô hình đoán đúng toàn bộ chuỗi chữ số. Đó là khác biệt giữa việc mô hình đã học nhiều ví dụ về phép toán với việc nó có một bộ máy thực thi phép toán.
Cú pháp giống gọi công cụ, nhưng phép tính diễn ra bên trong mô hình
Ranh giới thú vị nhất của Qwenputer nằm ở đường đi của yêu cầu tính toán. Qwen vẫn có thể sinh khối yêu cầu theo cú pháp gọi công cụ mà nó đã học, nhưng không có dịch vụ Python bên ngoài nhận yêu cầu ấy để tính hộ. Các lớp CPU đọc yêu cầu, chạy chương trình rồi đưa kết quả trở lại luồng token cho Qwen tiếp tục trả lời.
Tài liệu dự án cho biết CPU triển khai RV32IM, phần mở rộng Zba và bộ đồng xử lý số nguyên lớn. Nó chạy được mã C và MicroPython; trình diễn DOOM cho thấy có thể đưa một chương trình phức tạp hơn phép tính đơn lẻ lên máy tính nhúng này, dù tốc độ rất chậm. Chạy được trò chơi chứng minh khả năng thực thi chương trình, chưa chứng minh lợi ích về hiệu năng.
Không gọi trình thông dịch bên ngoài cũng không có nghĩa là bỏ được phần mềm điều khiển suy luận. Bản RISC-V sử dụng trình điều khiển RvChat để nạp firmware vào trạng thái DeltaNet sau prompt và quản lý các token vết thực thi, tách chúng khỏi các lớp ngôn ngữ trong lúc CPU làm việc. GPU và chương trình chạy mô hình vẫn cần thiết; thứ được đưa vào trong là cơ chế thực hiện phép tính.
Theo kết quả kiểm thử do tác giả công bố, CPU vượt qua riscv-tests, khớp QEMU trên các chương trình được thử và chạy tự do 18 triệu lệnh mà không phát hiện lỗi. Đây là bằng chứng cho độ đúng của bộ máy ở các phép thử đó, không đồng nghĩa mọi câu trả lời mà chatbot tạo ra đều chính xác.
Độ chính xác số học tăng, nhưng Python ngoài vẫn là đối chứng cần thiết
Kết quả đáng đọc nhất là so sánh với cả mô hình gốc lẫn mô hình gốc có Python, bởi chỉ vượt Qwen không dùng công cụ chưa đủ để chứng minh nên thay cách triển khai hiện tại. Bảng RISC-V trong tài liệu dự án dùng giải mã greedy, mỗi bộ gồm 40 bài toán giống nhau giữa các cấu hình; Qwen gốc không có công cụ và được yêu cầu tính chính xác từng bước, còn cột Python sử dụng trình thông dịch thực trên máy chủ.
| Phép thử, độ chính xác % (cao hơn tốt hơn) | Qwen3.5-4B không công cụ | Qwenputer RISC-V | Qwen3.5-4B + Python máy chủ |
|---|---|---|---|
| Số học số nguyên tổng hợp | 75,0 | 97,5 | 97,5 |
| DeepMind mul_big | 55,0 | 97,5 | 100,0 |
| DeepMind div_big | 72,5 | 97,5 | 95,0 |
| DeepMind mul_div_multiple_longer | 90,0 | 100,0 | 97,5 |
| DeepMind add_or_sub_big | 87,5 | 97,5 | 97,5 |
Số liệu: Divyansh Agrawal, tài liệu Qwenputer trên GitHub; kết quả do tác giả công bố, bản RISC-V, 40 bài mỗi bộ.
CPU nhúng giúp cải thiện rõ so với Qwen tự tính, nhưng không thắng Python ở mọi hàng. Với mẫu nhỏ như vậy, vài câu trả lời có thể làm thay đổi thứ tự; bảng này hữu ích hơn khi chứng minh cơ chế hoạt động, chưa đủ để xếp hạng độ tin cậy trên mọi loại bài toán.
Quan trọng hơn, bộ tính đúng vẫn có thể nhận yêu cầu sai. Nếu mô hình chọn nhầm phép toán hoặc lấy sai dữ kiện từ câu hỏi, CPU chỉ thực thi chính xác một việc không đúng với ý người dùng. Vì vậy, không nên kéo kết quả số học thành kết luận rằng Qwenputer đã giải quyết lỗi suy luận hay hiện tượng bịa thông tin của mô hình ngôn ngữ.
Với người chạy AI cục bộ, cần đo thời gian trả lời thay vì chỉ nhìn tốc độ token
Chi phí của việc đưa máy tính vào mô hình thể hiện ở cả bộ nhớ lẫn đường thực thi. AiCybr ghi nhận checkpoint RISC-V khoảng 18,8 GB ở BF16 và khuyến nghị thử nghiệm của tác giả là GPU 24 GB VRAM. Kích thước checkpoint không phải số đo bộ nhớ GPU cực đại: bộ đệm và trạng thái suy luận còn cần thêm chỗ.
Theo tài liệu Qwenputer, bộ thực thi Triton đạt khoảng 3.200 token vết thực thi mỗi giây trên NVIDIA L4. Đơn vị này không phải token văn bản trả lời người dùng, cũng không phải số khung hình DOOM. Một lệnh CPU có thể cần nhiều token vết thực thi, còn một phép tính hoàn chỉnh lại cần nhiều lệnh, nên không thể lấy con số đó so trực tiếp với tốc độ sinh văn bản của chatbot thông thường.
Với người phát triển trợ lý AI cục bộ tại Việt Nam, thước đo nên là thời gian từ lúc gửi câu hỏi đến khi nhận đáp án đúng trên cùng cấu hình máy. Cần so Qwenputer với Qwen có công cụ tính ngoài bằng chính công việc dự định dùng, thay vì đầu tư GPU chỉ vì thấy nhãn mô hình gốc 4B hoặc một bản trình diễn chạy được trò chơi.
Giá trị hiện tại của dự án nghiêng về nghiên cứu: có thể kiểm tra một bộ máy tính toán xác định kết hợp với phần ngôn ngữ đã học như thế nào. Đối với ứng dụng chỉ cần tính toán chính xác, dùng công cụ ngoài vẫn là lựa chọn khởi đầu hợp lý hơn; kết quả công bố chưa cho thấy lợi thế tốc độ đủ để đổi lấy checkpoint lớn và đường thực thi đặc thù.
Mã nguồn Qwenputer được công bố theo giấy phép MIT, còn trọng số mô hình sửa đổi theo Apache-2.0. Dự án cũng có nhánh thử nghiệm hệ thống tệp lưu trong trạng thái DeltaNet; đó là biến thể riêng, không nên gộp tính năng và kết quả của nó vào bản CPU RISC-V đang được so sánh.
Nguồn tham khảo: Qwenputer: mã nguồn, kiến trúc và bảng thử nghiệm RISC-V; Tom’s Hardware: Qwenputer và trình diễn DOOM; AiCybr: cấu hình và giới hạn triển khai Qwenputer.