Tóm tắt nhanh
- Thinking Machines Lab phát hành Inkling 2 Mini ngày 20/11/2026, mở trọng số theo giấy phép Apache 2.0, nhận văn bản và hình ảnh rồi trả lời bằng văn bản.
- Model card ghi checkpoint khoảng 20GB, hỗ trợ Mac Apple Silicon có từ 32GB bộ nhớ; đây không phải dung lượng RAM đủ cho mọi độ dài ngữ cảnh.
- Kiến trúc lặp dùng lại trọng số của các lớp giữa, tăng tính toán cho mỗi token mà không phải lưu thêm một bộ lớp tương ứng.
- Artificial Analysis đo được hiệu quả chi phí tốt so với Qwen3.8 27B trong Intelligence Index, nhưng kết quả dịch vụ không thể dùng làm cam kết tốc độ chạy trên Mac.
Thinking Machines Lab vừa đưa một mô hình AI 26,4 tỷ tham số xuống nhóm máy Mac có 32GB bộ nhớ, với điểm đáng chú ý nằm ở cách tái sử dụng các lớp xử lý thay vì chỉ giảm kích thước mô hình. Inkling 2 Mini có thể phục vụ trợ lý lập trình và ứng dụng dùng công cụ ngay trên máy cá nhân, còn ngưỡng bộ nhớ được hỗ trợ mới chỉ trả lời câu hỏi có thể chạy hay không, chưa trả lời chạy nhanh đến đâu.
Sự khác biệt này quan trọng với người dùng muốn giữ mã nguồn hoặc tài liệu trên máy. Một mô hình tải được và chạy ngoại tuyến mở thêm lựa chọn ngoài API, nhưng việc thay dịch vụ đám mây còn phụ thuộc vào chất lượng câu trả lời, thời gian chờ và quyền mà ứng dụng được cấp.
Lặp lớp để tăng tính toán, không nhân đôi trọng số
Inkling 2 Mini tiết kiệm dung lượng bằng cách dùng lại cùng một nhóm trọng số cho nhiều lượt xử lý. Theo model card của Thinking Machines, kiến trúc gồm 24 lớp transformer dạng decoder với các lớp Mixture-of-Experts, trong đó 12 lớp giữa chạy ba lượt bằng trọng số dùng chung. Kết quả là mỗi token đi qua 48 lần áp dụng lớp, dù mô hình chỉ lưu trọng số của 24 lớp.
Có thể hiểu trọng số là những giá trị đã học được và phải giữ trong bộ nhớ, còn một lượt đi qua lớp là công việc máy phải thực hiện khi sinh câu trả lời. Dùng lại trọng số giúp tăng phần công việc mà không cần tăng tương ứng phần dữ liệu lưu trữ. Tuy nhiên, các lượt xử lý thêm vẫn tốn tài nguyên tính toán; chúng không biến thành năng lực suy luận miễn phí.
Trong mỗi lớp, token được chuyển tới 8 trong số 128 chuyên gia theo thông số hãng công bố. Cơ chế lựa chọn này giải thích vì sao tổng số tham số và số tham số tham gia xử lý một token khác nhau. Model card ghi 26,4 tỷ tham số tổng, 3,4 tỷ tham số kích hoạt và 5,4 tỷ tham số kích hoạt hiệu dụng mỗi token sau khi tính các lượt lặp. Vì thế, không nên đặt Inkling 2 Mini cạnh một mô hình 3B thông thường rồi suy ra chúng có cùng chi phí xử lý.
Checkpoint được phân phối ở độ chính xác hỗn hợp NVFP4 và MXFP8, nặng khoảng 20GB theo hãng. Mức này giúp trọng số vừa với bộ nhớ của máy cá nhân được hỗ trợ, nhưng không đồng nghĩa toàn bộ phiên làm việc chỉ cần từng ấy RAM. Hệ điều hành, phần mềm chạy mô hình và dữ liệu phục vụ cuộc hội thoại vẫn cần dung lượng riêng.
Điểm ngang Qwen không có nghĩa mọi tác vụ đều ngang nhau
Hiệu quả của Inkling 2 Mini đáng chú ý ở lượng tài nguyên cần để đạt một mức điểm, thay vì ở vị trí dẫn đầu tuyệt đối. Artificial Analysis ghi nhận mô hình đạt 20 điểm Intelligence Index, ngang Qwen3.8 27B ở mức xhigh và Nanbeige4.3-33B. Đây là điểm tổng hợp của bộ đánh giá, không phải bằng chứng rằng mọi câu hỏi hay mọi dự án lập trình đều cho kết quả tương đương.
| Chỉ số trong Intelligence Index | Inkling 2 Mini | Qwen3.8 27B (xhigh) | Nanbeige4.3-33B |
|---|---|---|---|
| Điểm tổng hợp (cao hơn tốt hơn) | 20 | 20 | 20 |
| Token đầu ra trung bình mỗi tác vụ | Khoảng 152.000 | Khoảng 110.000 | Khoảng 158.000 |
| Chi phí mỗi tác vụ, USD (thấp hơn tốt hơn) | 0,59 | 3,53 | — |
| Thời gian mỗi tác vụ, phút (thấp hơn tốt hơn) | 9,0 | 38,2 | — |
Số liệu: Artificial Analysis. Chi phí của Inkling 2 Mini dùng giá dịch vụ trực tiếp của Thinking Machines; thời gian là kết quả theo cách đo dịch vụ của bộ đánh giá, không phải phép thử MacBook.
Inkling 2 Mini sinh nhiều hơn khoảng 38% token đầu ra so với Qwen3.8 27B trong phép đo này, nhưng vẫn có chi phí mỗi tác vụ thấp hơn. Artificial Analysis tính chi phí tính toán gần đúng bằng số tham số kích hoạt nhân số token và ghi nhận Inkling cần ít hơn khoảng 2,8 lần so với Qwen. Đại lượng đó giúp so sánh khối lượng xử lý, chứ không phải số điện năng tiêu thụ đo ở ổ cắm.
Giá dịch vụ mà Artificial Analysis dùng cho Inkling là 0,15 USD cho một triệu token đầu vào, 0,50 USD cho một triệu token đầu ra và 0,015 USD cho một triệu token đầu vào trúng bộ nhớ đệm. Vì vậy, chênh lệch chi phí trong bảng chịu ảnh hưởng của biểu giá bên cạnh đặc tính mô hình. Người chạy cục bộ không trả khoản phí API đó, nhưng vẫn phải tính đến phần cứng và thời gian máy bận.
Ở nhóm lập trình, Thinking Machines công bố các kết quả sau trong model card. Đây là phép đánh giá của hãng, với công cụ thực thi ghi kèm từng bài thử; khác biệt cấu hình đo giữa các mô hình có thể ảnh hưởng kết quả.
| Phép thử, tỷ lệ hoàn thành (%) — cao hơn tốt hơn | Inkling 2 Mini | Qwen3.8-27B |
|---|---|---|
| DeepSWE v1.1, mini-swe-agent v2.4.6 | 48,2 | 42,2 |
| SWE-bench Pro v2 Hard, mini-swe-agent v2.4.6 | 77,9 | 73,8 |
| Terminal Bench v4.0, mini-swe-agent v2.4.6 | 5,6 | 5,6 |
| Terminal Bench v2.1, pi v0.83.0 | 71,6 | 73,0 |
| SWE-bench Verified, bash only | 79,2 | 77,8 |
Số liệu: Thinking Machines Lab. Các phiên bản Terminal Bench khác nhau là các phép thử riêng, không so trực tiếp điểm giữa hai hàng.
Kết quả lập trình không nghiêng hoàn toàn về một phía: Inkling cao hơn ở DeepSWE và SWE-bench Pro Hard, nhưng thấp hơn ở Terminal Bench v2.1. Điều này củng cố cách chọn thực dụng hơn cho nhà phát triển: dùng công việc thật của mình để kiểm tra, thay vì coi điểm tổng hợp là bảo đảm chất lượng cho cả quy trình.
Mac 32GB là ngưỡng chạy, không phải cấu hình cho mọi nhu cầu
Với người đang có Mac dung lượng bộ nhớ phù hợp, giá trị trước mắt là thử mô hình trên chính máy đang dùng, chưa phải lý do để vội nâng cấp phần cứng. Thinking Machines liệt kê MacBook, Mac mini và Mac Studio dùng Apple Silicon từ 32GB bộ nhớ trong nhóm hỗ trợ, cùng NVIDIA DGX Spark; các GPU khác được khuyến nghị từ 32GB VRAM.
Model card công bố cửa sổ ngữ cảnh tối đa một triệu token, nhưng không khẳng định cấu hình Mac tối thiểu có thể khai thác toàn bộ mức đó. Cửa sổ ngữ cảnh là giới hạn khả năng tiếp nhận dữ liệu của mô hình, còn bộ nhớ thực tế còn phải chứa dữ liệu trung gian của phiên suy luận. Không nên ghép hai thông số thành lời hứa xử lý một triệu token trên bất cứ Mac 32GB nào.
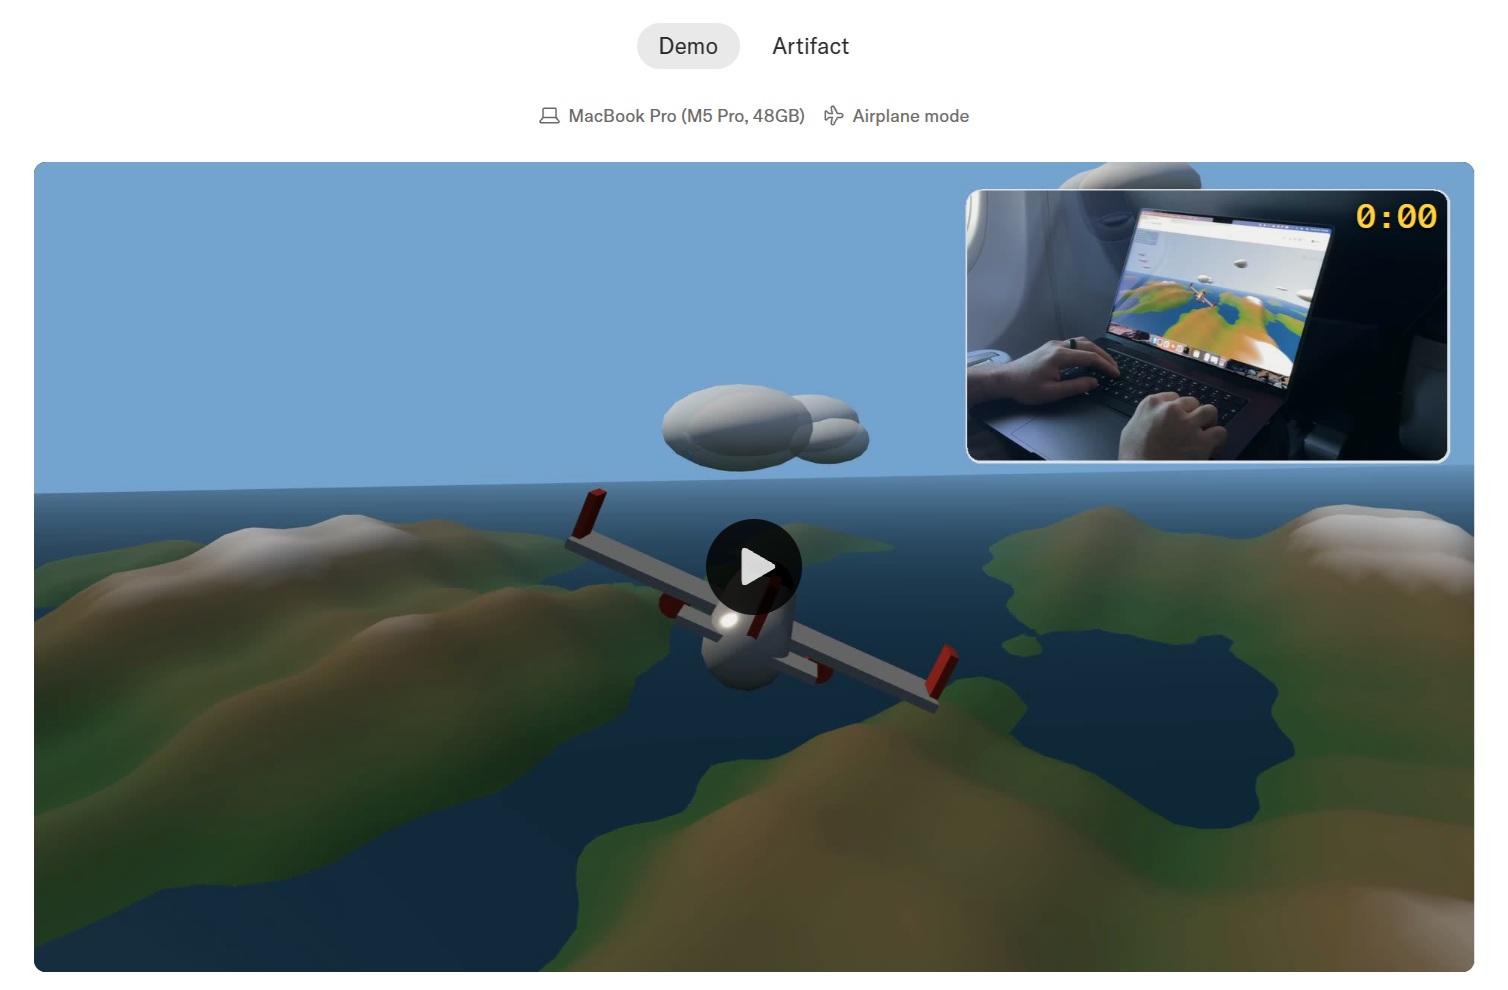
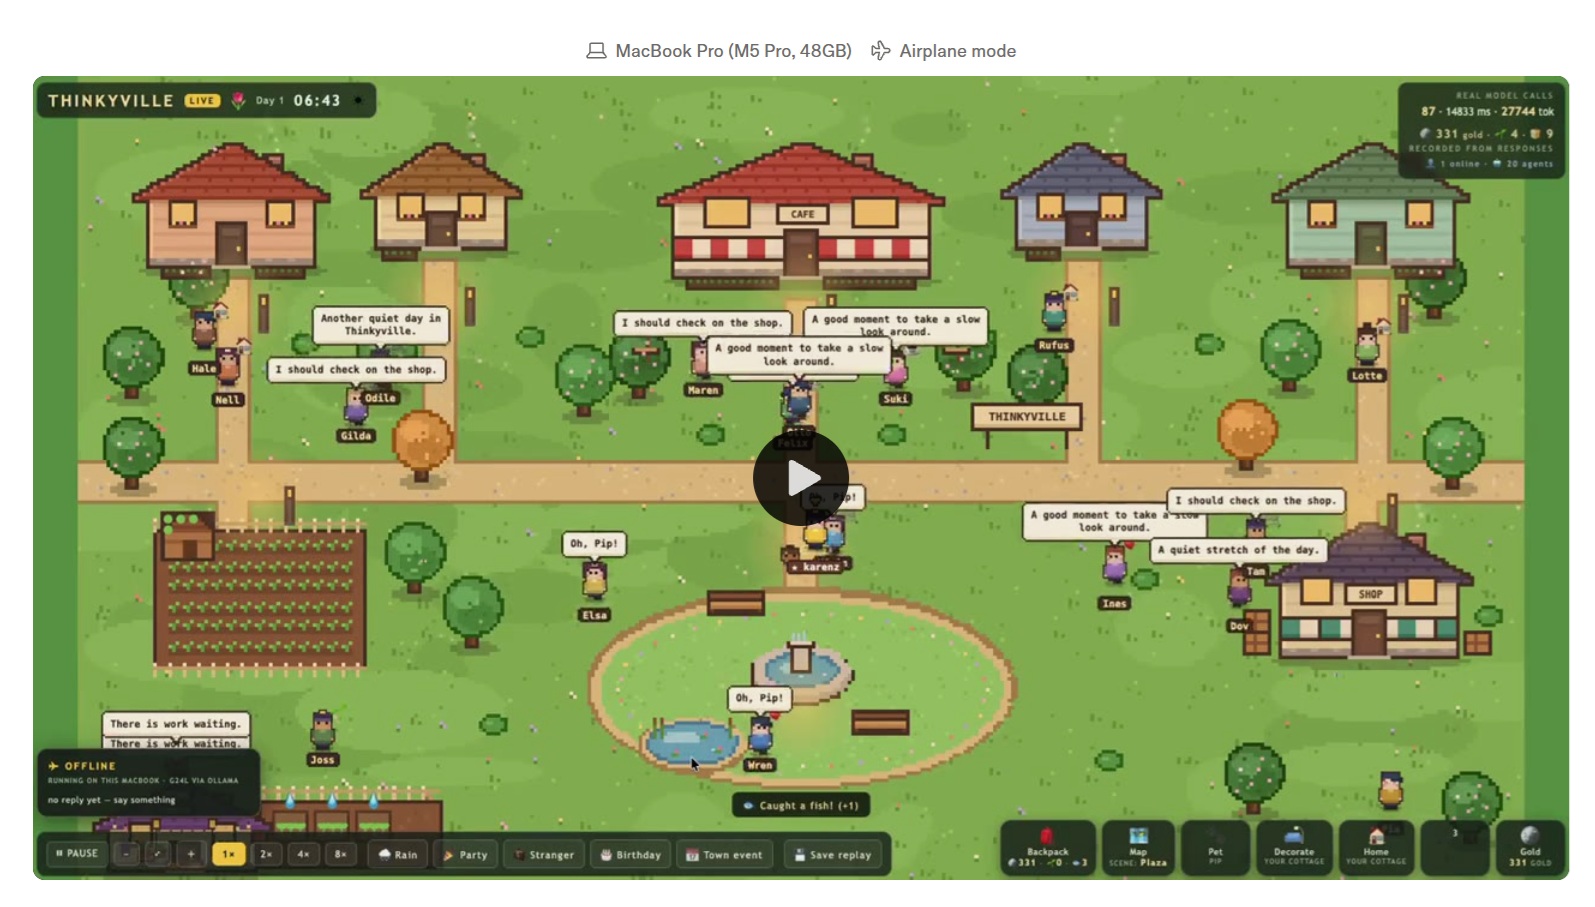
Demo của Thinking Machines được giới thiệu trên MacBook Pro M5 Pro có 48GB bộ nhớ ở chế độ máy bay, gồm tạo trò chơi mô phỏng bay và vận hành các nhân vật trong Thinkyville. Những demo này cho thấy hướng ứng dụng ngoại tuyến, nhưng cấu hình 48GB trong trình diễn khác với ngưỡng 32GB được hỗ trợ. Chúng cũng không cung cấp phép đo đủ để suy ra thời gian phản hồi trên từng đời chip.
Ở Việt Nam, đây là mô hình mở trọng số để tải về theo Apache 2.0, không phải thiết bị có giá bán lẻ trong nước. Người muốn thử có thể bắt đầu từ các nền tảng chạy cục bộ mà hãng liệt kê như Ollama trên Apple Silicon, còn Tinker cung cấp hướng truy cập dịch vụ và tinh chỉnh. Trước khi chọn cách triển khai, cần phân biệt tải mô hình về máy với gửi yêu cầu tới một dịch vụ từ xa.
Chạy ngoại tuyến vẫn phải giới hạn quyền sửa tệp
Giữ suy luận trên máy có thể giảm nhu cầu gửi nội dung công việc ra ngoài, nhưng không làm câu trả lời tự nhiên chính xác hơn hay thao tác với tệp an toàn hơn. Điểm cần ưu tiên khi dùng Inkling làm trợ lý lập trình là phạm vi quyền truy cập, nhất là lúc ứng dụng có thể tự thực thi lệnh.
Thinking Machines cảnh báo trong model card rằng mô hình đôi lúc mắc kẹt trong vòng suy luận dài, liên tục kiểm tra lại mà không tiến triển, đặc biệt khi sửa lỗi mã nguồn. Hãng cũng nêu khả năng xóa hoặc ghi đè tệp mà không xin xác nhận, cũng như báo cáo kết quả công việc không chính xác. Do đó, chạy trong môi trường cô lập, đặt giới hạn token đầu ra và số lượt tác nhân, đồng thời buộc xác nhận trước thao tác phá hủy là điều nên làm ngay khi thử.
Với nhóm phát triển ứng dụng tiếng Việt, mức điểm chung cũng chưa thay thế được phép kiểm tra ngôn ngữ thực tế. Model card lưu ý chất lượng ngoài tiếng Anh có thể thấp hơn và khả năng làm theo nhiều ràng buộc còn hạn chế. Một bộ câu hỏi tiếng Việt gắn với tài liệu hoặc mã nguồn của nhóm sẽ hữu ích hơn việc chỉ kiểm tra một đoạn hội thoại ngắn.
Inkling 2 Mini đáng thử với người đã có máy đáp ứng bộ nhớ và muốn một trợ lý cục bộ có thể nhận cả hình ảnh. Còn nếu định mua Mac chỉ để chạy mô hình này, thông tin còn cần chờ là tốc độ theo từng chip, mức dùng bộ nhớ theo độ dài ngữ cảnh và độ ổn định trên công việc dài; số phút đo qua dịch vụ chưa trả lời được các câu hỏi đó.
Nguồn tham khảo: Thinking Machines Lab — model card Inkling 2 Mini; Artificial Analysis — đánh giá Inkling 2 Mini; Wccftech — thông tin và hình ảnh trình diễn.