Tóm tắt nhanh
- Luật sư Nick Mermiges nâng cấp máy chủ tám Tesla V100-SXM2 32GB để chạy DeepSeek-V4.1-Flash-1017 bằng cách kết hợp chuyên gia NVFP4 với bản nén IQ2-class.
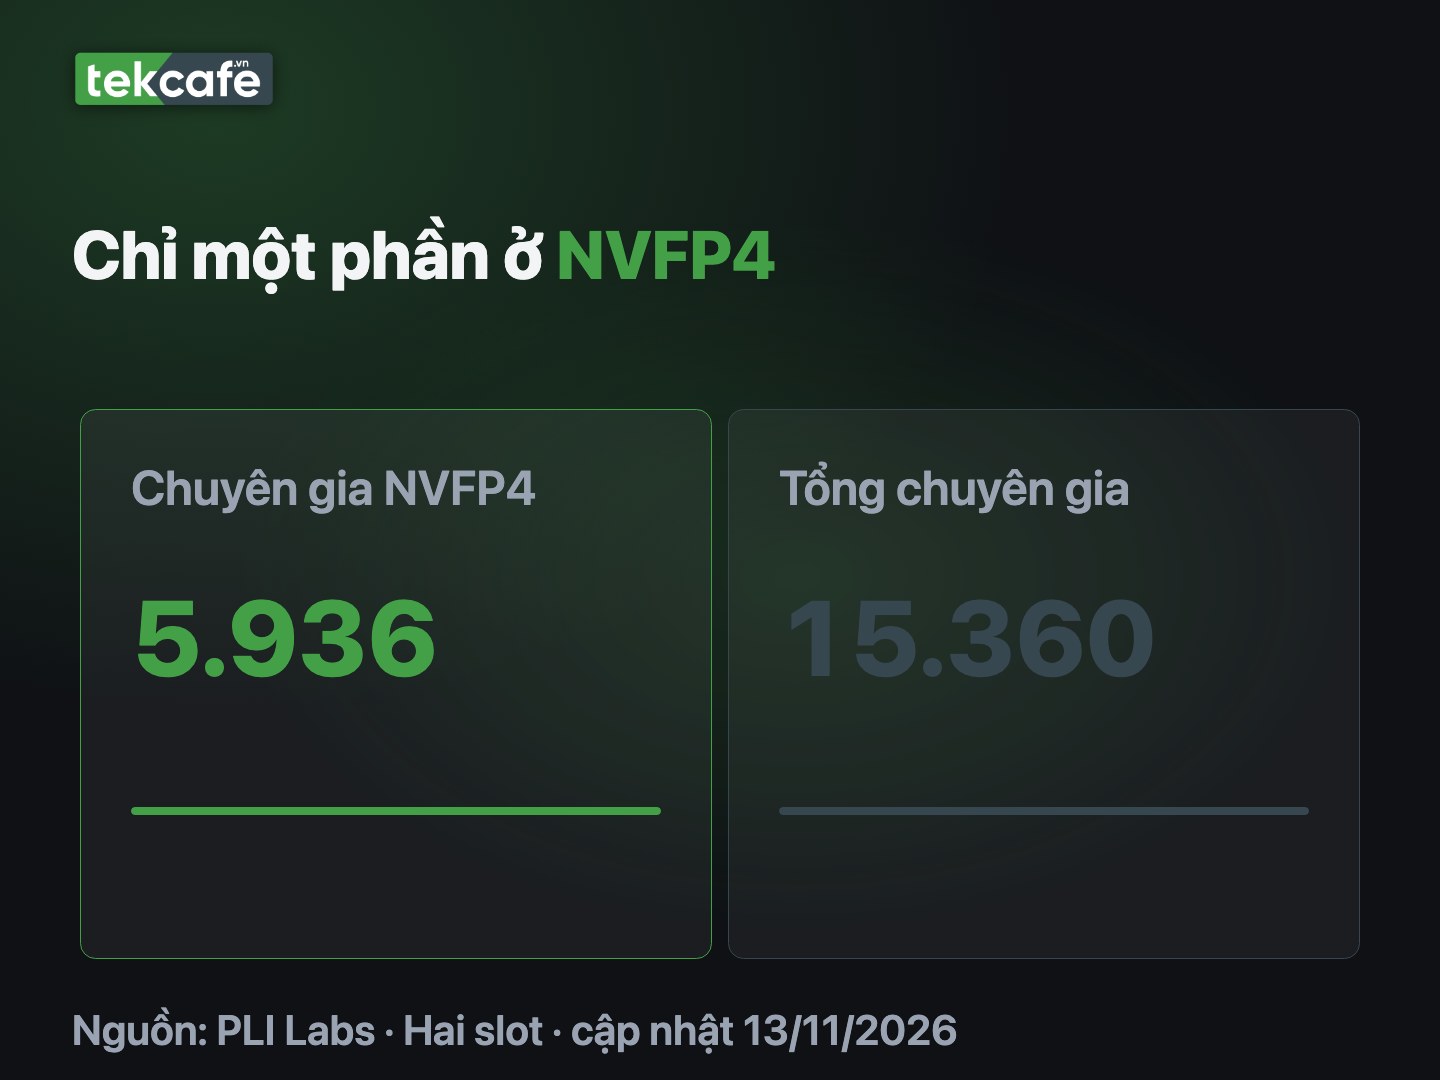
- Cấu hình hai slot cập nhật ngày 13/11 giữ 5.936 trong 15.360 chuyên gia ở NVFP4; tỷ lệ lượt định tuyến vào nhóm này được dự đoán khoảng 78–85%, không phải toàn bộ trọng số.
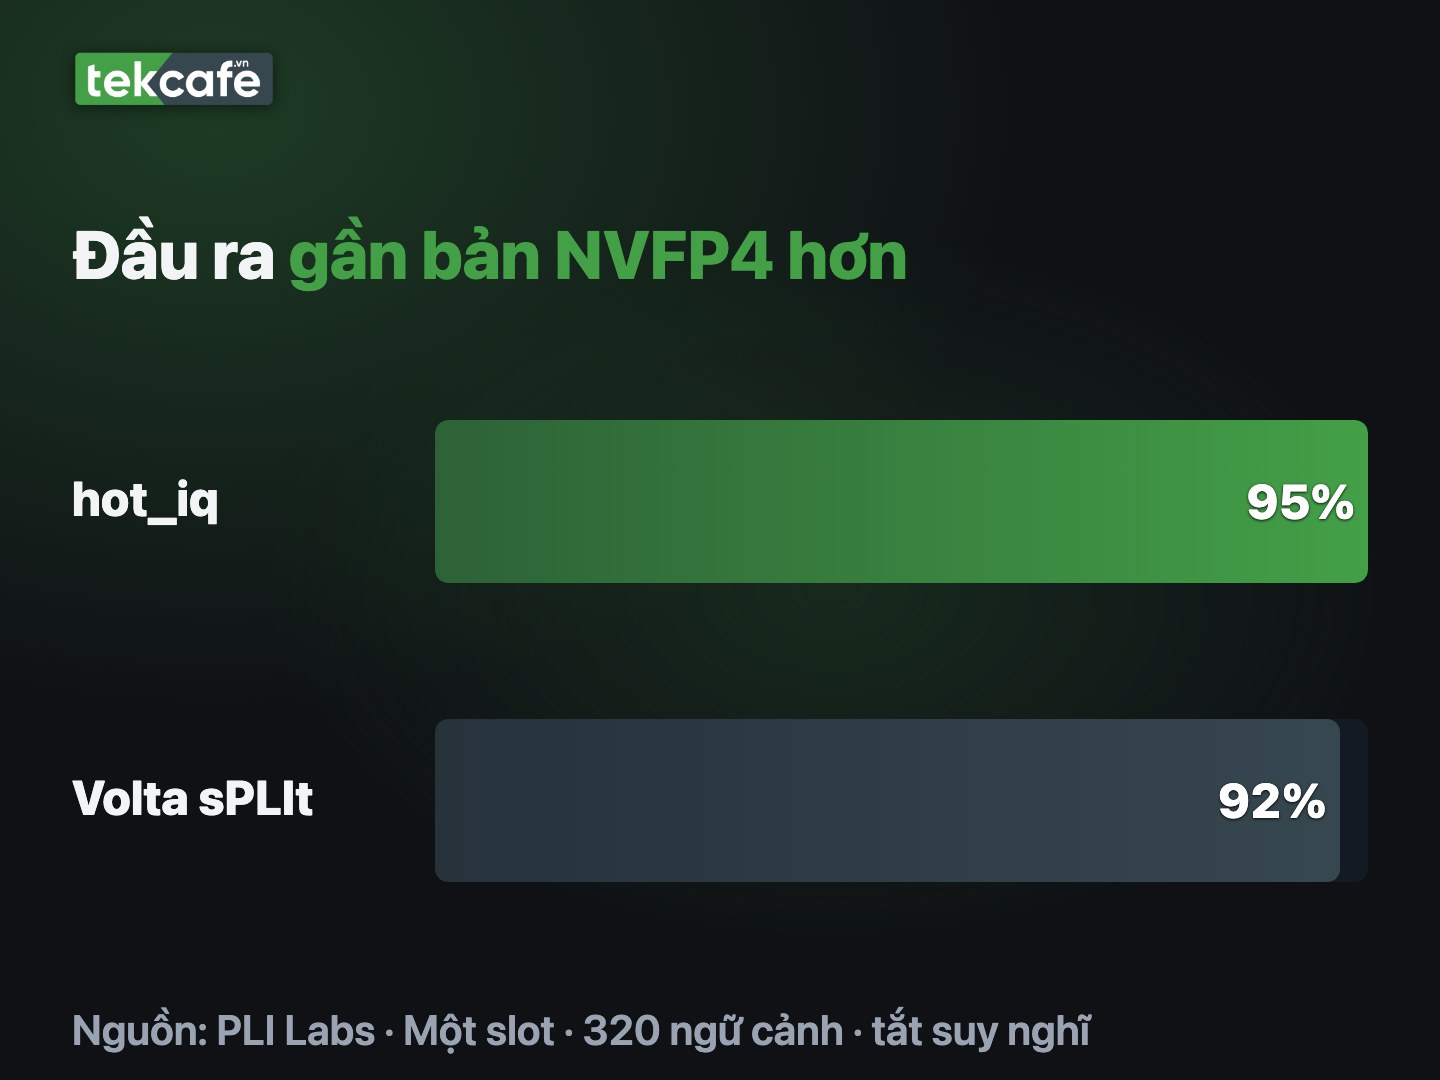
- Thử nghiệm một slot của chủ dự án cho tỷ lệ trùng token kế tiếp với bản tham chiếu NVFP4 là 95,1%; con số này không phải độ chính xác trả lời.
- RAM hệ thống tăng lên 1TB, còn khả năng phục vụ nhiều yêu cầu vẫn phải chia sẻ bộ nhớ GPU với các chuyên gia có độ trung thực cao hơn.
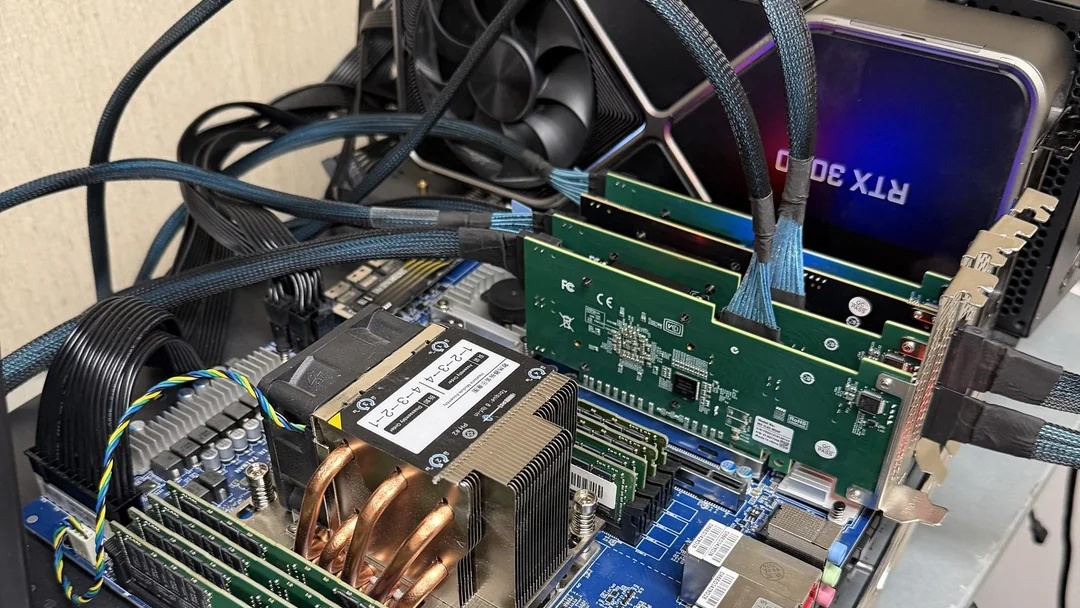
Nick Mermiges, luật sư và người sáng lập PLI Labs, đã cập nhật máy chủ AI cá nhân từ bản DeepSeek nén sâu sang Volta Max uPLIft, một cách triển khai dành riêng cho tám GPU V100 cũ. Điểm đáng chú ý nằm ở cách phân bổ bộ nhớ: giữ các chuyên gia được gọi thường xuyên ở NVFP4, còn phần ít dùng hơn tiếp tục dùng bản IQ2-class để mọi chuyên gia định tuyến vẫn nằm trên GPU khi sinh văn bản.
Đây là cách tận dụng phần cứng cũ bằng phần mềm tùy biến, chứ không phải bằng chứng V100 có thể chạy nguyên trạng gói NVFP4 của NVIDIA. Cũng cần tách hai câu hỏi: đầu ra giống bản tham chiếu đến đâu, và hệ thống trả lời nhanh, ổn định đến đâu. Bản nâng cấp cải thiện vế đầu trong các phép thử đã công bố, nhưng không xóa được giới hạn của vế sau.
Giữ chuyên gia dùng nhiều ở NVFP4, không nâng toàn bộ mô hình
Bộ nhớ GPU được dùng hiệu quả hơn khi ưu tiên phần mô hình thực sự làm nhiều việc, thay vì chia đều độ chính xác cho mọi chuyên gia. Với mô hình hỗn hợp chuyên gia, mỗi lượt sinh token chỉ định tuyến đến một phần trong số các chuyên gia có sẵn; bởi vậy, tỷ lệ chuyên gia và tỷ lệ lượt sử dụng chuyên gia là hai đại lượng khác nhau.
Theo tài liệu PLI Labs, hệ thống dùng tám Tesla V100-SXM2 32GB, tổ chức thành hai tầng xử lý nối tiếp, mỗi tầng chia phép tính trên bốn GPU, tức PP2 × TP4. Dung lượng bộ nhớ danh nghĩa cộng lại là 256GB, nhưng không thể dành hết cho trọng số: bộ thực thi và trạng thái của từng yêu cầu cũng cần chỗ. Thêm một phiên phục vụ đồng thời vì thế có thể buộc hệ thống giảm số chuyên gia được giữ ở mức NVFP4.
Cách xếp của hot_iq bắt đầu bằng các bản ghi IQ2-class nhỏ hơn trên GPU, rồi nâng từng chuyên gia sang trọng số NVFP4 theo mức sử dụng trên mỗi byte tăng thêm cho đến khi hết ngân sách bộ nhớ. Tiêu chí này khác với việc chọn các chuyên gia rẻ bộ nhớ nhất để nâng được số lượng lớn nhất. Mục tiêu là đưa nhiều lượt định tuyến vào nhóm có độ trung thực cao hơn, không phải làm đẹp số lượng chuyên gia NVFP4.
Ở cấu hình hai slot sau điều chỉnh dự trữ bộ nhớ ngày 13/11/2026, model card PLI Labs ghi 5.936 trong 15.360 chuyên gia định tuyến ở NVFP4. Mức dự đoán khoảng 78–85% lượt định tuyến khi sinh token dựa trên thống kê hỗn hợp của tác giả, chưa phải phép đo trực tiếp trên cấu hình hai slot này. Các kết quả đo một slot trước đó nằm khoảng 80–86%; không nên tráo chúng thành kết quả đã đo của bản hai slot.
Nhóm chuyên gia ưu tiên được chọn từ bốn loại văn bản có trọng số ngang nhau, gồm cả công việc pháp lý riêng của chủ máy. Danh sách này cố định, không tự thay đổi theo cuộc chat. Nếu tác vụ thực tế khác tập văn bản dùng để chọn, nhiều lượt gọi có thể rơi vào chuyên gia nén hơn dự kiến. Với người muốn chạy AI tiếng Việt, tỷ lệ định tuyến đẹp trên tập thử ấy chưa đủ để suy ra kết quả tương tự trên tài liệu của mình.
Ranh giới phần cứng cũng rất rõ: model card NVIDIA của DeepSeek-V4.1-Flash-NVFP4 liệt kê Blackwell là kiến trúc tương thích và GB300 là phần cứng đánh giá. Volta Max uPLIft dùng bộ thực thi, cách chia trọng số và cấu hình riêng cho V100; gói này không phải mô hình có thể tải vào llama.cpp hay vLLM nguyên bản rồi chạy ngay. Phần mềm tùy biến mới là điều làm nên khả năng triển khai, không phải nhãn 4-bit tự nó bảo đảm tương thích.
Khớp token hơn không đồng nghĩa trả lời đúng hơn
Độ trung thực với bản tham chiếu là lợi ích có bằng chứng rõ nhất của bản nâng cấp, nhưng gọi nó là mức tăng độ chính xác sẽ làm sai ý nghĩa phép đo. Hai mô hình có thể chọn cùng token mà vẫn cùng trả lời sai; ngược lại, hai cách diễn đạt khác nhau chưa chắc khác nhau về tính đúng đắn.
Trong thử nghiệm do PLI Labs công bố ngày 11/11, hot_iq được đối chiếu với gói NVFP4 tham chiếu trên cùng hệ V100 bằng bộ thực thi của dự án. Đây không phải đường chạy Blackwell của NVIDIA. Bộ thử gồm 320 ngữ cảnh và 513 câu MMLU, chạy lần lượt một yêu cầu, chọn token theo cách tham lam, tắt chế độ suy nghĩ. Mỗi ngữ cảnh chỉ sinh tối đa 32 token, nên kết luận không tự mở rộng sang những câu trả lời dài hay chế độ lấy mẫu ngẫu nhiên.
| Chỉ số | Volta sPLIt | hot_iq | Cách đọc |
|---|---|---|---|
| Trùng token kế tiếp với tham chiếu | 92,2% | 95,1% | Cao hơn là khớp hơn |
| Độ phân kỳ KL, top 20 token | 0,1958 nat | 0,0794 nat | Thấp hơn là gần hơn; cận dưới của KL đầy đủ |
| Ngữ cảnh trùng toàn bộ 32 token | 10,9% | 25,6% | Không phải tỷ lệ trả lời đúng |
| Đáp án MMLU khác bản tham chiếu | 15,4% | 1,6% | Đếm khác biệt, không đếm cải thiện |
| Độ chính xác MMLU | 84,4% | 83,6% | Bản tham chiếu đạt 83,8% |
Số liệu: PLI Labs, thử nghiệm độ khớp ngày 11/11/2026; bản Volta sPLIt được thu dữ liệu từ ngày 10/11. Các giá trị không đại diện cho cấu hình hai slot đọc prompt nhanh.
Kết quả cho thấy hot_iq bám bản NVFP4 sát hơn ở nhiều cách đo, nhưng độ chính xác MMLU không tăng theo cùng một chiều. Với kích thước mẫu này, tác giả không phân biệt được độ chính xác của hai bản nén với bản tham chiếu ở mức thống kê đã đặt ra. Không thể lấy 95,1% rồi diễn giải thành mô hình trả lời đúng 95,1% câu hỏi, hoặc khẳng định chất lượng bằng mô hình chưa lượng tử hóa.
Ngay cả bản tham chiếu cũng là một gói đã lượng tử hóa. Phép đo vì thế trả lời câu hỏi hẹp: mức nén thêm làm đầu ra lệch khỏi NVFP4 bao nhiêu. Nó không đo toàn bộ khoảng cách từ máy chủ này đến mô hình gốc, càng không xác nhận chất lượng công việc pháp lý. Độ khớp token là một phép kiểm hữu ích khi thay đổi trọng số, còn quyết định dùng cho công việc cần dựa trên bài thử đúng tác vụ và kiểm tra đầu ra.
Một giới hạn khác là bộ thử độ khớp không bao phủ các tùy chọn nhiều slot và đọc prompt nhanh được bổ sung sau đó. Số đo chất lượng của bản một slot không phải tấm bảo đảm cho mọi cấu hình phục vụ chỉ vì chúng dùng cùng tên hot_iq.
Tốc độ sinh code giảm, còn nhiều yêu cầu giúp tăng tổng thông lượng
Đổi trọng số nén sâu lấy độ trung thực cao hơn có chi phí tốc độ, nhưng chi phí đó thay đổi theo độ dài đầu vào và kiểu công việc. Thời gian chờ token đầu tiên cũng là chỉ số khác tốc độ sinh tiếp: hệ thống có thể bắt đầu trả lời sớm hơn mà vẫn viết chậm hơn sau đó.
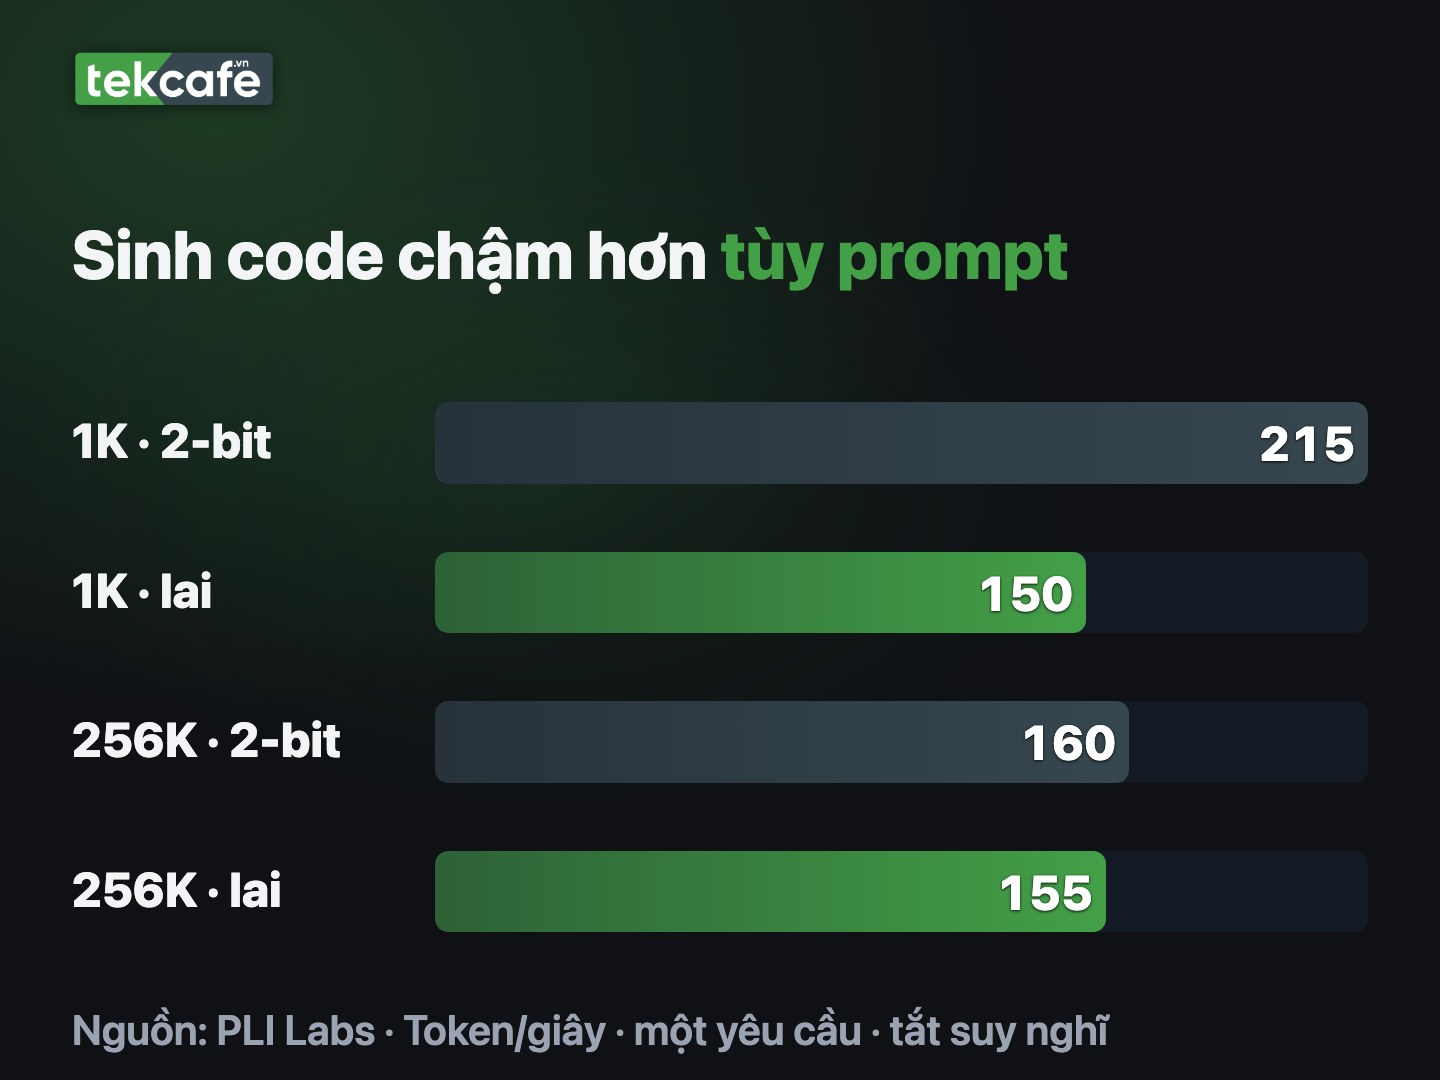
Bảng được Tom’s Hardware dẫn từ phép đo của chủ máy so sánh Volta sPLIt ngày 5/11 với bản lai ngày 12/11, một yêu cầu tại một thời điểm, tắt suy nghĩ và dùng giải mã tham lam. Đây là so sánh hai bản triển khai hoàn chỉnh, không phải thử nghiệm cô lập tác động của riêng độ chính xác trọng số.
| Prompt | Chờ token đầu: 2-bit / lai (giây) | Sinh code: 2-bit / lai (token/giây) | Văn bản pháp lý: 2-bit / lai (token/giây) |
|---|---|---|---|
| 1K token | 1,2 / 1,0 | 215,0 / 150,1 | 117,6 / 105,5 |
| 32K token | 17,2 / 16,0 | 200,5 / 165,1 | 116,5 / 93,4 |
| 128K token | 59,2 / 54,3 | 182,8 / 151,4 | 110,9 / 87,3 |
| 256K token | 118,7 / 108,4 | 160,0 / 154,6 | 103,1 / 93,5 |
Số liệu: PLI Labs, được Tom’s Hardware dẫn lại. Bản lai là cấu hình ngày 12/11, hai slot nhưng chỉ chạy một yêu cầu; không trộn với kết quả cập nhật ngày 13/11.
Ở đầu vào ngắn, khoảng cách sinh code lớn hơn đáng kể so với đầu vào dài nhất trong bảng. Với người dùng, điều này quan trọng hơn một khoảng tốc độ quảng bá: tác vụ hỏi nhanh và tác vụ đưa vào cả tài liệu dài không có cùng thời gian chờ, cũng không chịu cùng mức đánh đổi sau khi bắt đầu nhận câu trả lời.
Cho nhiều yêu cầu chạy cùng lúc giúp tận dụng máy tốt hơn về tổng sản lượng. Trong phép đo ngày 12/11 do PLI Labs công bố, hai yêu cầu trên cấu hình hai slot đạt tổng 159,0 token/giây, so với 118,9 token/giây khi chỉ chạy một yêu cầu. Con số tổng này không có nghĩa mỗi người dùng đều nhận được 159 token/giây. Mỗi slot còn lấy thêm bộ nhớ trạng thái, làm giảm chỗ dành cho các chuyên gia NVFP4.
Bản cập nhật ngày 13/11 lại có điều kiện khác: model card ghi giới hạn công suất mặc định 300W và xung tối đa 1.530MHz, thay cho mức 175W và 1.522MHz của đợt 12/11. Tác giả báo code khoảng 143–175 token/giây theo prompt, còn ba yêu cầu trên cấu hình ba slot đạt tổng 176,2 token/giây. Không nên ghép các kết quả này thành một bảng tăng tốc chung, bởi cấu hình slot, ngân sách bộ nhớ và điều kiện công suất đã thay đổi.
Đáng lưu ý hơn với văn phòng dùng chung máy là tình huống đọc tài liệu dài trong lúc phục vụ yêu cầu ngắn. Theo model card, ở đợt 13/11, yêu cầu ngắn gửi vào khi đang đọc prompt dài chỉ sinh khoảng 15,3 token/giây cho đến khi lượt đọc kết thúc. Thông lượng tổng đo trong điều kiện thuận lợi không thay thế được độ trễ khi những tác vụ khác nhau tranh tài nguyên.
Với văn phòng Việt Nam, vận hành ổn định quan trọng hơn săn GPU cũ
Giá trị thực tế của một máy AI tại chỗ nằm ở việc nó xử lý công việc đều đặn, không chỉ ở khả năng nạp được mô hình. Trường hợp này cho thấy RAM, cách bố trí GPU và đường cấp điện có thể trở thành vấn đề vận hành ngay sau khi bài toán trọng số đã giải được.
Theo thông tin cấu hình chủ máy công bố qua Tom’s Hardware, RAM tăng từ tám thanh 32GB lên tám thanh 128GB, tổng 1TB, chạy 2.933 MT/s. Bộ RAM trước đó phải chạy DDR4-2666 do gặp lỗi ECC ở tốc độ cao hơn. Sau nâng cấp, hệ thống nhận hai nút NUMA và đã có lượt khởi động treo ở bước truyền dữ liệu giữa các cụm GPU, dẫn tới việc sắp lại thứ tự card trong phần mềm.
RAM hệ thống nhiều hơn không biến thành bộ nhớ HBM trên GPU. Khi sinh văn bản, chủ đích của hot_iq vẫn là giữ mọi chuyên gia định tuyến trên card để tránh phải tải chuyên gia qua PCIe. Bởi vậy, dung lượng RAM lớn và số chuyên gia NVFP4 trên GPU phải được xem là hai phần khác nhau của cấu hình, không cộng lại thành một khối bộ nhớ tương đương.
Vấn đề treo máy ban đầu bị nghi liên quan PCIe, nhưng sau thay đổi đường cấp điện, chủ dự án báo chín trên chín cuộc chat dài hoàn tất không lỗi. Tác giả cho rằng nguyên nhân có lẽ là một bộ nguồn không tốt; đây chưa phải chẩn đoán độc lập, và số lần chạy ấy cũng không phải chứng nhận độ tin cậy. Điều có thể rút ra là phải kiểm tra nguồn cấp song song với phần mềm, thay vì mặc định mọi lỗi đều đến từ kết nối GPU.
Một RTX 3090 đã được bổ sung vào máy, còn kế hoạch chuyển mô hình nháp nhỏ của DeepSeek sang card này chưa hoàn tất ở thời điểm công bố bản cập nhật này. Không thể tính lợi ích của kế hoạch đó vào tốc độ hiện tại. Tương tự, máy chủ thứ hai là hướng mở rộng dự kiến, chưa phải năng lực đang có của hệ thống được đo.
Đối với một nhóm nhỏ tại Việt Nam, cấu hình này đáng tham khảo như một cách phân bổ bộ nhớ, không phải danh sách mua sắm tám GPU cũ để làm theo ngay. Gói phần mềm gắn chặt với V100-SXM2, cách nối các card và bộ thực thi riêng; chỉ tìm đúng tên V100 chưa bảo đảm dựng lại được hệ thống. Trước khi mua phần cứng, cần thử tác vụ tiếng Việt thực tế, đo thời gian chờ khi nhiều người dùng và xác định ai sẽ bảo trì khi máy treo.
Chạy trong văn phòng có thể giúp hạn chế việc gửi tài liệu tới dịch vụ ngoài, nhưng địa điểm đặt máy không tự bảo đảm an toàn dữ liệu hay tuân thủ. Quyền truy cập, lưu nhật ký và quy trình kiểm tra câu trả lời vẫn cần được thiết kế riêng. Bản nâng cấp này đáng chú ý vì chọn rõ đánh đổi giữa độ trung thực, tốc độ và bộ nhớ; việc còn phải chứng minh là các đánh đổi ấy có phù hợp với chính công việc sẽ giao cho máy hay không.
Nguồn tham khảo: PLI Labs — model card hot_iq và điều kiện đo; PLI Labs — mã nguồn và nhật ký triển khai; NVIDIA — DeepSeek-V4.1-Flash-NVFP4; Tom’s Hardware — cập nhật máy chủ của Nick Mermiges.