Tóm tắt nhanh
- Trên GPU 8GB, cần dành bộ nhớ cho cả trọng số model và ngữ cảnh; nạp được model chưa có nghĩa là đủ chỗ cho một cuộc hội thoại dài.
- Bắt đầu bằng model nhỏ đáp ứng được công việc, sau đó mới tăng kích thước hoặc bật suy luận khi kết quả thực sự cần đến.
- Mức context khoảng 30k token và Min-p 0,03–0,05 trong chia sẻ của XDA là cấu hình tham khảo của một người dùng, không phải công thức chung.
- Min-p lọc lựa chọn token theo xác suất tương đối, có thể giúp giữ mạch văn khi tăng temperature nhưng không bảo đảm câu trả lời đúng sự thật.
GPU 8GB buộc người chạy LLM cục bộ phải lựa chọn: dành bộ nhớ cho model lớn hơn hay giữ chỗ cho tài liệu, lịch sử trò chuyện và phần trả lời. Đẩy context lên mức tối đa mà model hỗ trợ có thể khiến cấu hình trở nên kém thực dụng, nhất là khi máy còn mở trình duyệt hoặc phần mềm thiết kế.
Cách tối ưu hợp lý là giải quyết dung lượng bộ nhớ trước, rồi mới chỉnh cách model chọn token. Một câu trả lời mạch lạc từ model vừa sức vẫn hữu ích hơn cấu hình trông rất cao trên bảng thông số nhưng liên tục làm công việc bị ngắt quãng.
Model nhỏ là lựa chọn khởi đầu hợp lý cho việc nhỏ
Chọn model theo công việc giúp tránh dùng hết tài nguyên cho năng lực không cần đến. Sửa một chi tiết giao diện hay xử lý đoạn văn ngắn không đặt ra cùng yêu cầu với việc phân tích nhiều tài liệu hoặc giải quyết một bài toán có nhiều bước phụ thuộc nhau.
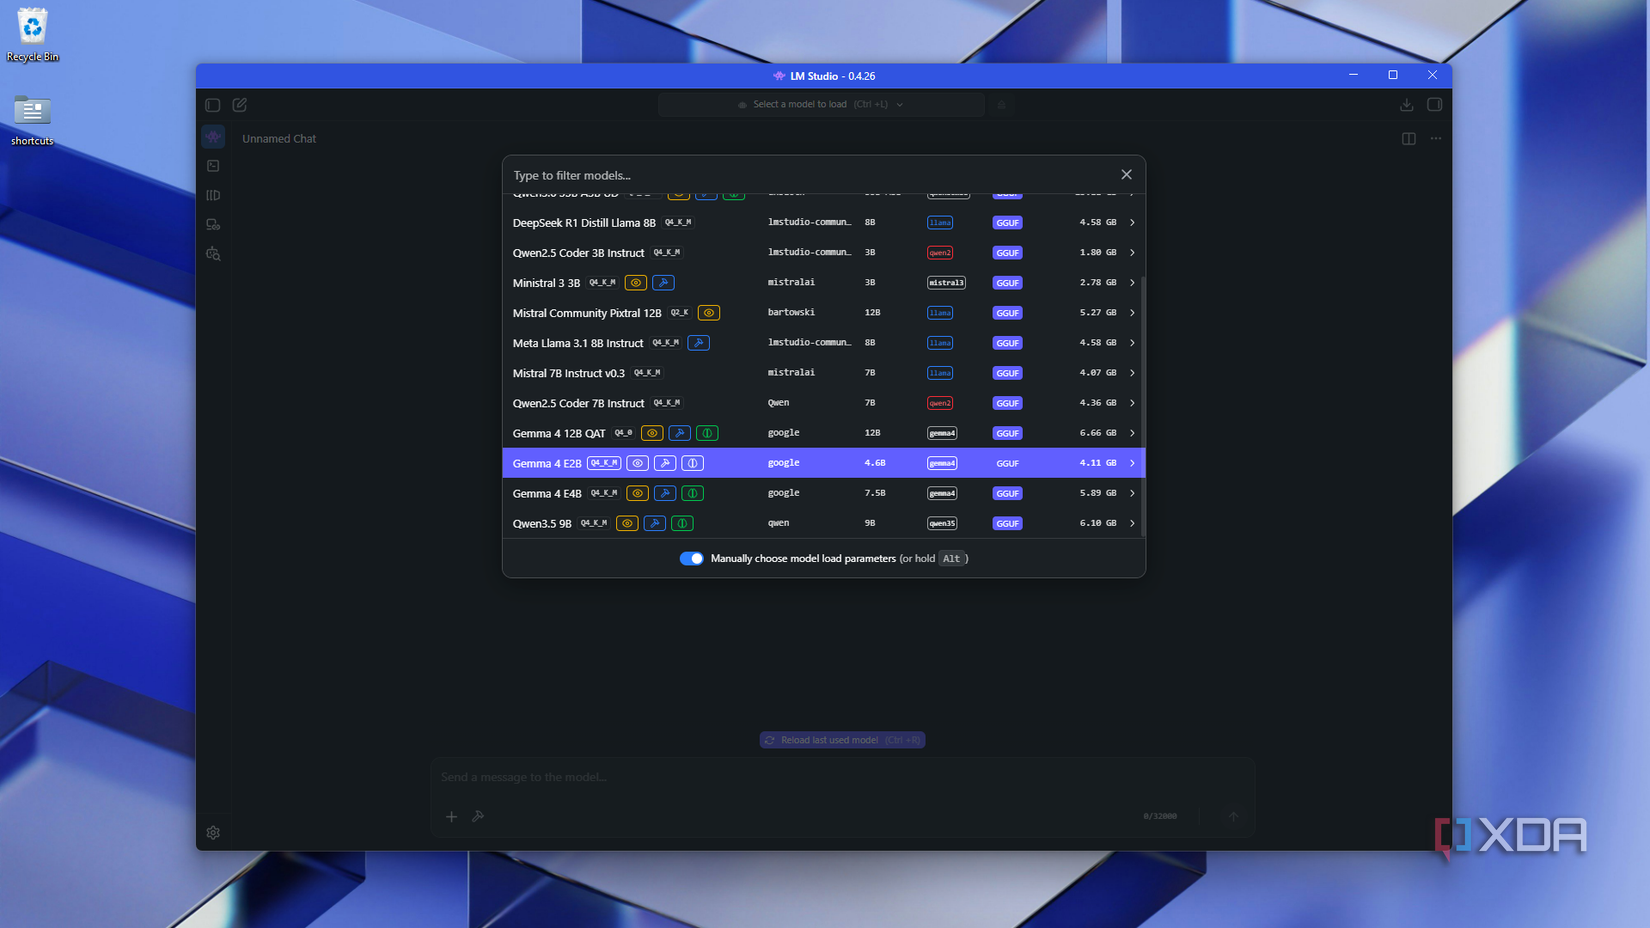
Trong chia sẻ trên XDA, nhóm model nhỏ được dùng gồm Gemma E2B, E4B và Qwen 3.5 4B; Qwen 3.5 4B nhận các việc lập trình nhỏ. Đây là ví dụ về cách phân việc, không phải bằng chứng rằng mọi model cùng kích thước đều làm tốt các tác vụ đó. Chất lượng tiếng Việt, khả năng tuân thủ yêu cầu và độ chính xác vẫn phải được kiểm tra trên chính việc bạn định giao.
Ở LM Studio, chọn model vừa sức rồi thử bằng một yêu cầu quen thuộc mà bạn có thể tự kiểm tra kết quả. Với đoạn mã, kiểm tra xem thay đổi có chạy đúng và có làm hỏng phần liên quan hay không; với văn bản tiếng Việt, kiểm tra tên riêng, ý nghĩa và yêu cầu định dạng. Chỉ nâng lên model lớn hơn khi bản nhỏ không đáp ứng được tiêu chí này.
Dung lượng tệp tải về cũng không phải toàn bộ bộ nhớ cần khi chạy. Ngoài trọng số, quá trình sinh câu trả lời còn cần bộ nhớ làm việc và bộ nhớ phục vụ ngữ cảnh. Vì thế, một model vừa khít VRAM lúc mới nạp có thể không còn thoải mái khi cuộc trò chuyện kéo dài.
Context dài hơn không đồng nghĩa với câu trả lời tốt hơn
Giới hạn context nên bám theo lượng nội dung cần xử lý, thay vì số token tối đa ghi trên trang model. Trong cách triển khai Transformer thông dụng, KV cache giữ lại các giá trị key và value của những token đã xử lý để không phải tính lại toàn bộ phần trước ở mỗi bước sinh tiếp theo.
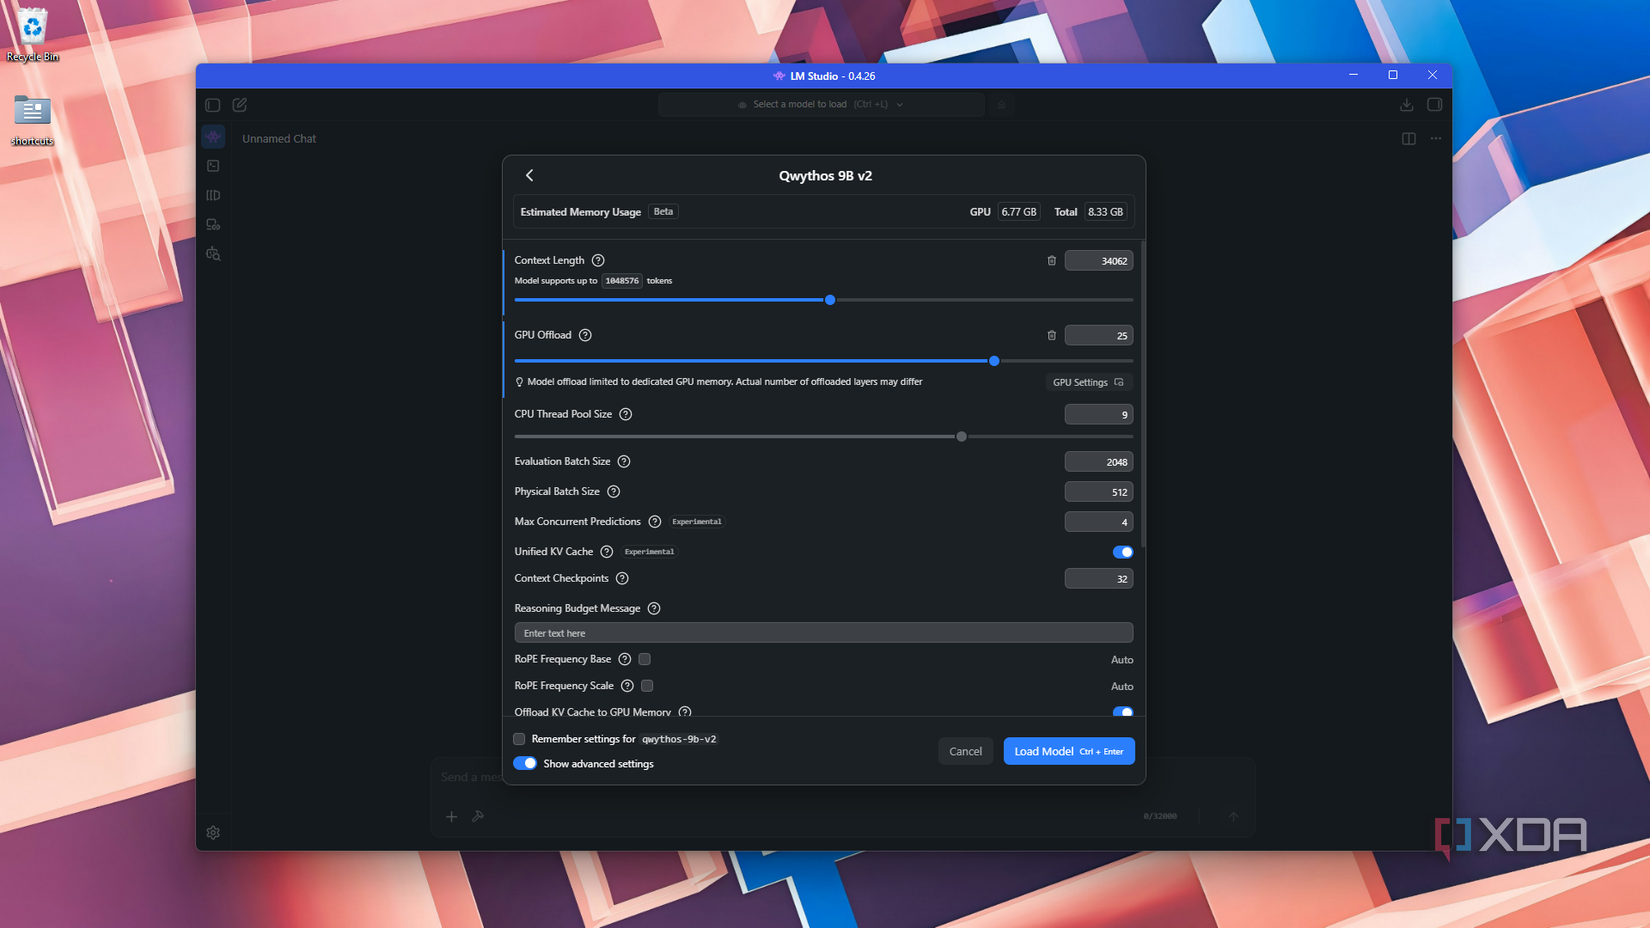
Với cùng kiến trúc và cách lưu cache, chuỗi token dài hơn thường cần nhiều bộ nhớ cache hơn. Mức tiêu thụ cụ thể còn phụ thuộc model và thiết lập phần mềm, nên không thể lấy một con số context rồi suy ra nó sẽ vừa với mọi card 8GB. Context được hỗ trợ về mặt kiến trúc khác với context chạy thuận tiện trên máy của bạn.
XDA ghi nhận cấu hình thường dùng khoảng 30k token trên GPU 8GB, dù tác giả có thể chạy đến khoảng 80k token trong điều kiện của mình. Hai mốc này chỉ mô tả một hệ thống và nhu cầu sử dụng cụ thể; chúng không xác lập mức an toàn hoặc mức tối ưu cho máy khác.
Khi nạp model trong LM Studio, xem mục Context Length và ước tính bộ nhớ, sau đó chọn mức đủ cho tài liệu thực sự cần đọc cùng phần trả lời dự kiến. Thử lại trong trạng thái làm việc bình thường, với những ứng dụng bạn thường mở, thay vì chỉ kiểm tra khi máy gần như trống.
Nếu cấu hình dùng quá nhiều bộ nhớ, hãy giảm lượng nội dung không liên quan hoặc hạ giới hạn context trước khi kết luận phải mua GPU mới. Một cuộc trò chuyện mới, chỉ giữ yêu cầu và dữ kiện còn cần, thường dễ kiểm soát hơn việc mang theo toàn bộ lịch sử của các công việc đã xong.
Cũng cần tách áp lực bộ nhớ khỏi chất lượng đọc hiểu. Nhét thêm tài liệu có thể làm model khó tìm đúng chi tiết cần thiết, nhưng không có nghĩa cứ dùng ít VRAM là tự động tránh được mọi lỗi nhớ sai. Nếu công việc cần đối chiếu các phần cách xa nhau, phải thử khả năng tìm đúng dữ kiện chứ không chỉ quan sát tốc độ sinh chữ.
Chỉ bật thinking khi kết quả đáng với số token phải trả
Thinking cần được xem như một lựa chọn theo tác vụ, không phải nút tăng chất lượng vô điều kiện. Phần suy luận được sinh ra cũng sử dụng token; khi nằm trong chuỗi mà phần mềm tiếp tục xử lý, nó còn chiếm chỗ trong ngân sách ngữ cảnh.
XDA ghi nhận tắt thinking giúp tiết kiệm từ vài trăm đến khoảng một nghìn token mỗi lượt hỏi trong cách dùng local của tác giả. Không nên biến quan sát đó thành mức tiết kiệm cố định, bởi lượng suy luận thay đổi theo model và câu hỏi.
Với model có hỗ trợ chuyển chế độ, thử tắt thinking cho những công việc có kết quả dễ kiểm tra. Giữ nguyên yêu cầu rồi bật lại để so sánh nếu câu trả lời bỏ sót điều kiện hoặc giải quyết sai bài toán. Tránh đổi cả model, context và thinking cùng lúc vì khi đó khó biết yếu tố nào làm kết quả khác đi.
Các tác vụ cần lập luận nhiều bước có thể vẫn hưởng lợi từ suy luận dài hơn. Nếu tắt thinking khiến model nhanh nhưng sai, cấu hình đó không đạt mục tiêu tối ưu. Còn khi ứng dụng chỉ ẩn phần suy luận khỏi giao diện, cũng đừng mặc định rằng nó đã ngừng sinh phần này; cần phân biệt tùy chọn hiển thị với chế độ suy luận thực sự của model.
Min-p giữ lại token tương đối hợp lý, không kiểm chứng sự thật
Chỉnh Min-p chỉ có ý nghĩa sau khi model đã chạy ổn định và bạn biết mình muốn thay đổi điều gì ở câu trả lời. Temperature điều chỉnh độ tập trung của phân phối xác suất; khi tăng temperature, những lựa chọn ít có khả năng hơn có thêm cơ hội được chọn, làm câu chữ đa dạng hơn nhưng cũng dễ mất mạch.
Top-p giữ một nhóm token có tổng xác suất đạt ngưỡng đặt trước. Min-p dùng cách khác: lấy xác suất của token có khả năng cao nhất, nhân với ngưỡng cơ sở rồi loại những token nằm dưới kết quả đó. Công thức trong nghiên cứu của Nguyễn Nhật Minh và cộng sự là p_scaled = p_base × p_max, sau đó chuẩn hóa lại xác suất của nhóm còn được giữ.
Vì ngưỡng phụ thuộc token dẫn đầu, tập lựa chọn thay đổi theo mức tập trung của phân phối ở từng bước. Điểm hữu ích là lọc bớt các lựa chọn quá xa nhóm có khả năng cao, thay vì chỉ cố đạt một tổng xác suất cố định. Nhưng độ tự tin của model không phải độ đúng của kiến thức: một khẳng định sai vẫn có thể nhận xác suất cao.
Trong cấu hình XDA chia sẻ, Min-p được đặt khoảng 0,03–0,05 khi temperature vượt 0,3. Còn nghiên cứu gốc nêu khoảng ngưỡng cơ sở 0,05–0,1 như hướng dẫn thực nghiệm, với kết quả phụ thuộc model và tác vụ. Hai khoảng này không cần bị ép thành một con số duy nhất, vì chúng xuất phát từ điều kiện đánh giá khác nhau.
Nếu phần mềm đang dùng có Min-p, lưu lại cấu hình hiện tại rồi chỉ thay thông số này khi so sánh. Không nên vừa tăng temperature vừa chỉnh nhiều bộ lọc token và mức phạt lặp; kết quả có thể thay đổi do tương tác giữa các thiết lập, khiến bạn khó tìm ra nguyên nhân.
Benchmark cho thấy Min-p có giới hạn rõ khi tăng temperature
Min-p có thể giảm mức suy sụp chất lượng ở nhiệt độ cao, nhưng không biến việc tăng temperature thành cách nâng độ chính xác. Bảng thực nghiệm trên Mistral 7B trong nghiên cứu gốc cho thấy lợi thế đó khác nhau giữa bài hỏi kiến thức chuyên sâu và bài toán phổ thông có chuỗi suy luận.
Các bảng sau giữ nguyên tỷ lệ trả lời đúng của hai phương pháp Top-p và Min-p ở các mức temperature đã công bố. GPQA Main dùng thiết lập 5-shot, còn GSM8K CoT dùng 8-shot; kết quả không phải phép đo trên GPU 8GB hoặc model đang chạy trên máy của bạn.
| GPQA Main, độ chính xác % (cao hơn tốt hơn) | Mistral 7B · Top-p | Mistral 7B · Min-p |
|---|---|---|
| Temperature 0,7 | 29,02 | 29,18 |
| Temperature 1,0 | 25,00 | 25,89 |
| Temperature 1,5 | 24,78 | 28,13 |
| Temperature 2,0 | 6,47 | 26,34 |
| Temperature 3,0 | 0,46 | 24,55 |
Số liệu: Turning Up the Heat, bảng 2. Hai phương pháp chạy bằng vLLM; bài nghiên cứu lưu ý sai số chuẩn khoảng 1–1,5 điểm phần trăm.
Khoảng cách ở temperature thấp không đủ để khẳng định Min-p luôn tốt hơn trong thực tế. Lợi thế rõ hơn nằm ở việc duy trì kết quả khi temperature tăng cao, chứ không phải làm model đột nhiên hiểu thêm kiến thức.
| GSM8K CoT, độ chính xác % (cao hơn tốt hơn) | Mistral 7B · Top-p | Mistral 7B · Min-p |
|---|---|---|
| Temperature 0,7 | 36,09 | 35,18 |
| Temperature 1,0 | 27,67 | 30,86 |
| Temperature 1,5 | 0,68 | 18,42 |
| Temperature 2,0 | 0,00 | 6,21 |
| Temperature 3,0 | 0,00 | 0,00 |
Số liệu: Turning Up the Heat, bảng 2; độ chính xác trên GSM8K CoT với Mistral 7B, chạy bằng vLLM.
Ở bài toán có suy luận, cả hai cách đều về mức không trả lời đúng tại temperature cao nhất trong bảng. Vì vậy, nếu mục tiêu là sửa mã hoặc tính toán chính xác, đừng lấy khả năng giữ mạch văn làm tiêu chí duy nhất để đẩy temperature lên.
Kiểm tra bằng công việc tiếng Việt trước khi giữ cấu hình
Với người dùng Việt Nam, cấu hình đáng giữ phải hoàn thành được công việc tiếng Việt chứ không chỉ đạt một con số đẹp trong benchmark tiếng Anh. Các phép thử ở trên không xác nhận rằng một model nhỏ sẽ giữ đúng thuật ngữ, tên riêng hoặc ý nghĩa khi tóm tắt tài liệu của bạn.
Hãy dùng lại một nhóm yêu cầu quen thuộc, giữ nguyên nội dung khi thay thiết lập và tự kiểm tra đáp án. Bắt đầu từ model vừa bộ nhớ với context đủ dùng, sau đó so sánh thinking nếu cần; chỉ đến bước sau mới thử sampling. Ghi lại cấu hình đã cho kết quả tốt để có thể quay về khi lần chỉnh tiếp theo làm câu trả lời kém đi.
Nếu kết quả vẫn sai kiến thức dù đã giữ câu chữ mạch lạc, việc cần làm là đổi model hoặc cung cấp tài liệu liên quan đáng tin cậy, không tiếp tục vặn Min-p. Nếu tài liệu có nội dung nhạy cảm, việc chuyển tác vụ khó sang dịch vụ đám mây cũng cần được quyết định riêng, thay vì mặc định đó là bước tiếp theo của quy trình local.
Chỉ nên cân nhắc nâng phần cứng sau khi xác định cấu hình đang thiếu chỗ cho model cần thiết hay cho lượng ngữ cảnh thật sự phải xử lý. Một preset hoàn thành đúng việc trên chiếc máy đang có giá trị hơn mức context tối đa mà bạn không dùng đến.
Nguồn tham khảo: XDA Developers; Turning Up the Heat: Min-p Sampling for Creative and Coherent LLM Outputs.