Tóm tắt nhanh
- Kiến trúc xử lý: Vi xử lý RTX Spark N1X tích hợp CPU Grace 20 nhân (10 nhân Cortex-X925 kết hợp 10 nhân Cortex-A725) cùng đồ họa tích hợp Blackwell tối đa 6.144 nhân trên một SoC duy nhất với mức công suất 45–80W; trong khi kiến trúc Fusion ghép hai die của dòng M-series mang lại 18 nhân CPU (6 nhân Super core và 12 nhân Performance core) cùng đồ họa tối đa 40 nhân.
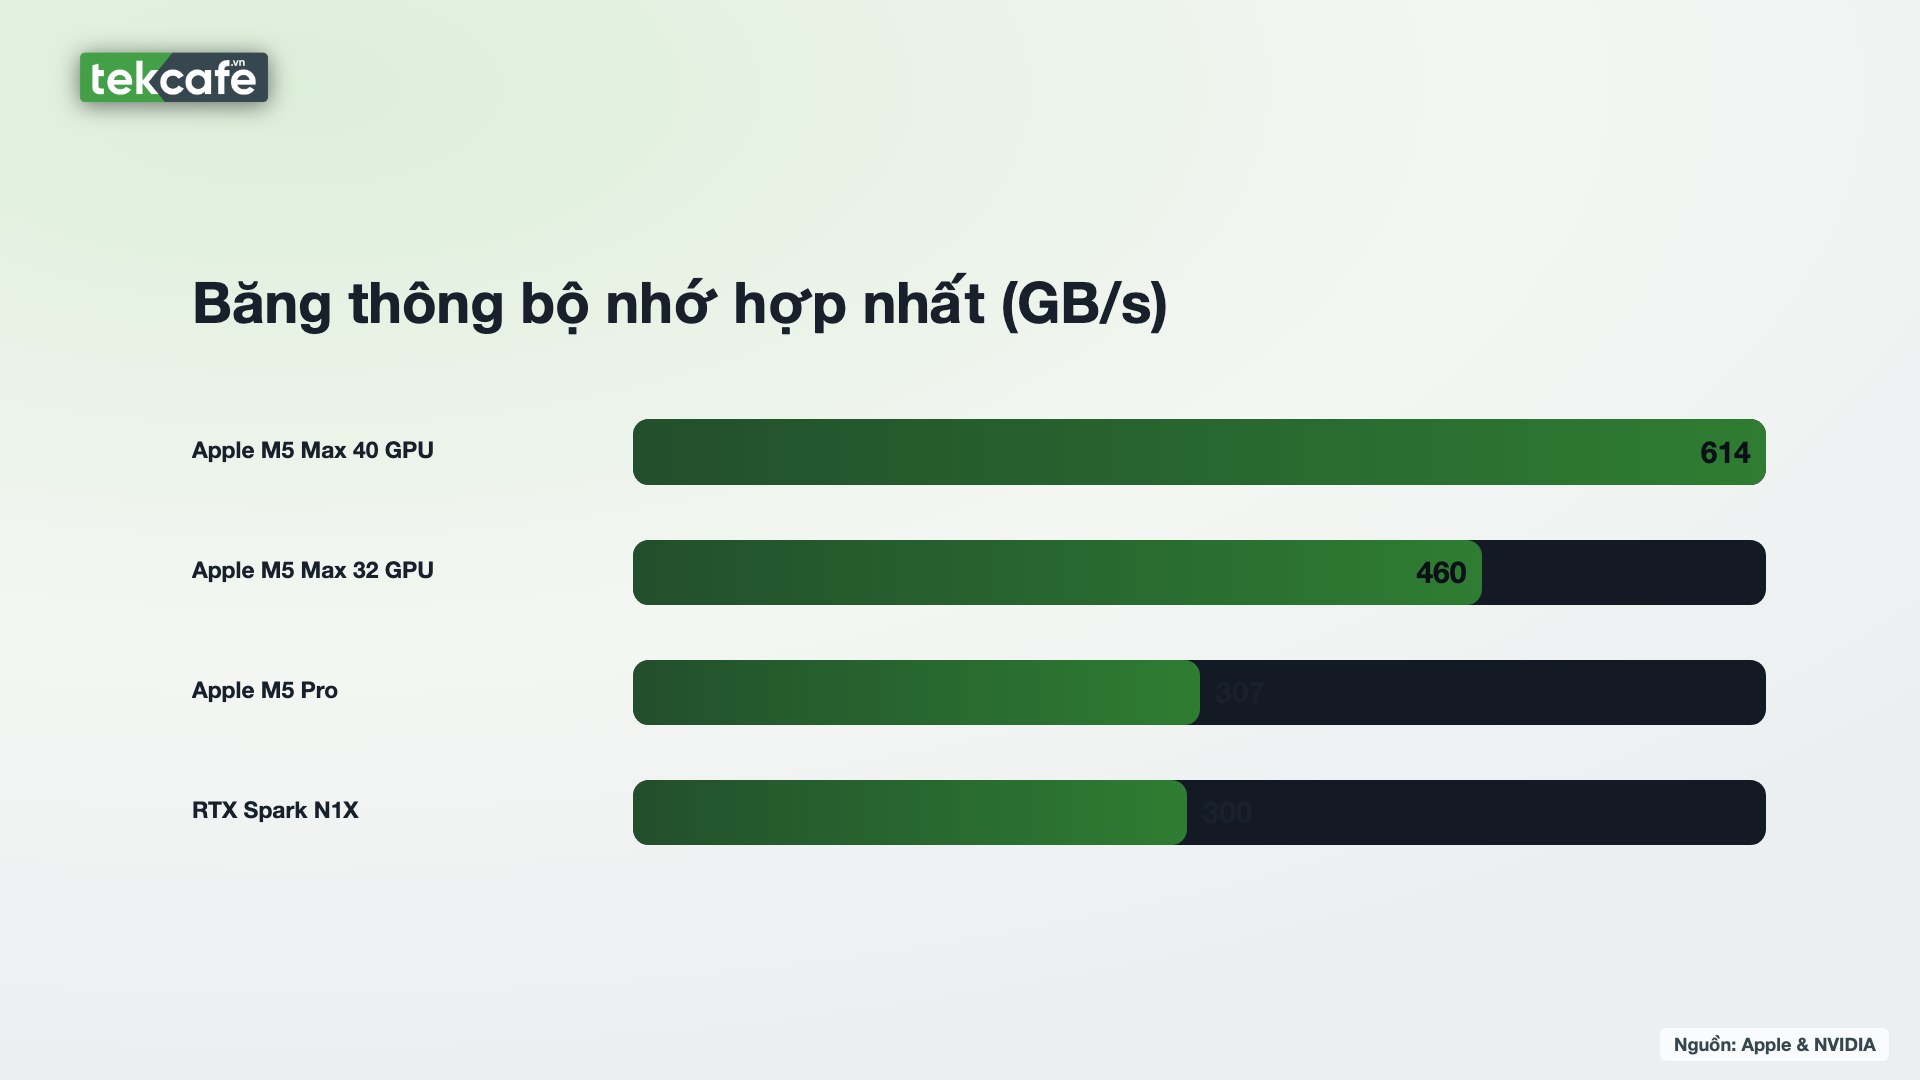
- Bản chất Unified Memory: M5 Max sở hữu băng thông bộ nhớ 614 GB/s trên giao tiếp rộng, gấp xấp xỉ 2,05 lần mức 300 GB/s của RTX Spark N1X; đồng thời macOS phân bổ trực tiếp cho bộ xử lý đồ họa toàn quyền sử dụng gần như toàn bộ RAM mà không bị giới hạn bởi cơ chế cắt phân vùng carveout cứng nhắc như Windows on Arm.
- Bản chất chênh lệch AI: Số liệu do Microsoft và NVIDIA công bố về việc RTX Spark vượt trội 2,1 lần thời gian xuất token đầu tiên (TTFT) và 6,2 lần khi tạo video AI dựa trên bài thử nghiệm so sánh với bản MacBook Pro 16 inch M5 Pro 64GB ở định dạng lượng tử hóa NVFP4, hoàn toàn không phản ánh tốc độ suy luận ở độ chính xác gốc khi đặt cạnh M5 Max 128GB.
- Khả năng mã hóa media: Cụm Media Engine của nhà Táo với hai bộ giải mã và hai bộ mã hóa ProRes chuyên biệt duy trì ưu thế vượt trội về độ ổn định khi dựng video nhiều luồng định dạng nén cao; trong khi RTX Spark dựa vào một bộ mã hóa NVENC thế hệ 9 và một bộ giải mã NVDEC thế hệ 6 kết hợp sức mạnh thuần từ nhân Tensor.
- Giá tại Việt Nam: ASUS ProArt P16 chạy RTX Spark mở đặt trước từ 8/10 đến 15/10/2026, bản 128GB bộ nhớ hợp nhất có giá đề xuất 194,99 triệu đồng.
Kiến trúc phần cứng: Siêu chip tích hợp RTX Spark đối đầu thiết kế ghép hai die M-series
Cuộc đối đầu vi xử lý trên các dòng máy trạm di động cao cấp đang bước vào giai đoạn tái định hình cấu trúc. Thay vì mô hình truyền thống ghép nối một CPU x86 tiêu tốn điện năng với một card đồ họa rời thông qua giao thức PCIe hạn chế băng thông, cả hai nền tảng hàng đầu hiện nay đều chọn con đường tích hợp sâu nhằm tối ưu hóa đường truyền dữ liệu và hiệu suất năng lượng.
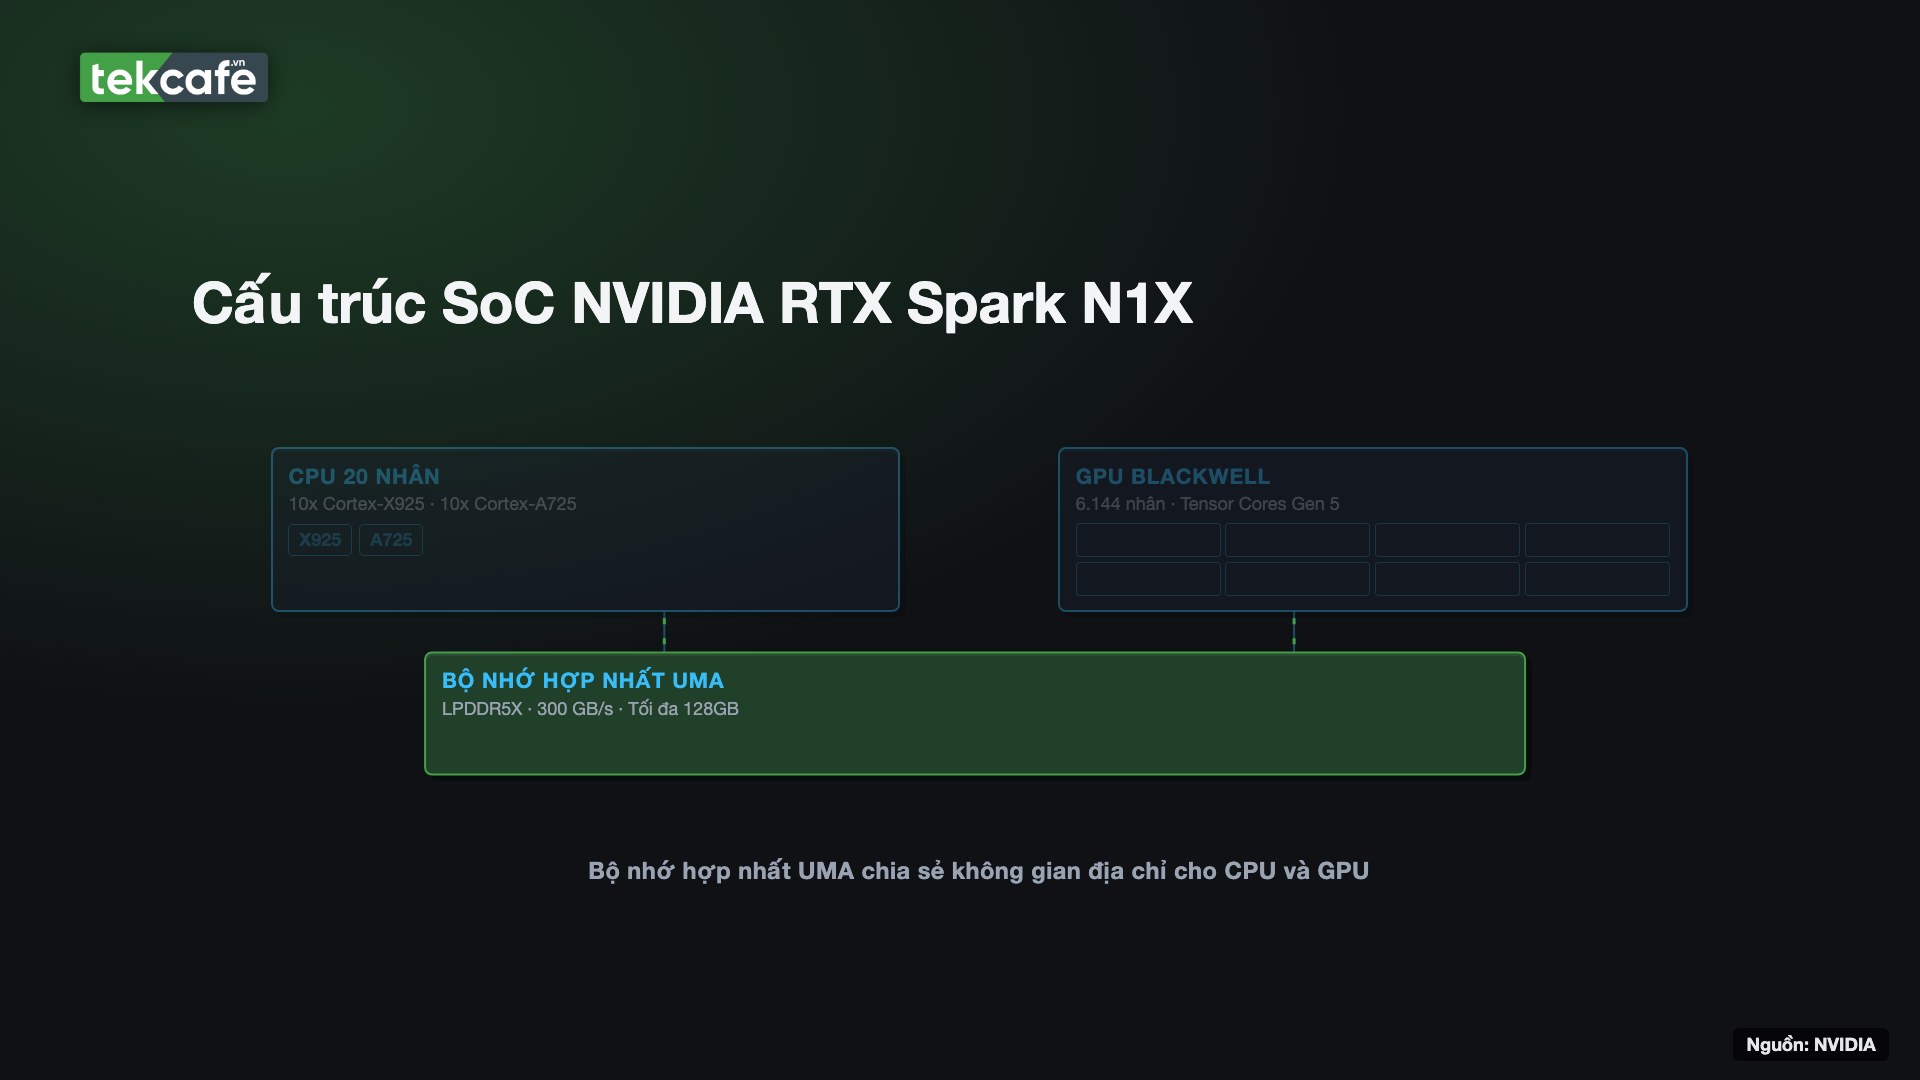
Dòng vi xử lý RTX Spark N1X đánh dấu bước chuyển mình của đội xanh sang kiến trúc SoC tích hợp hoàn chỉnh dành cho các máy tính xách tay Windows mỏng nhẹ. Dòng vi xử lý này kết hợp trực tiếp cụm CPU Grace dựa trên tập lệnh Armv9.2 với khối đồ họa tích hợp dựa trên kiến trúc Blackwell. Toàn bộ các thành phần tính toán được đặt trên cùng một đế bán dẫn và chia sẻ chung một khối bộ nhớ LPDDR5X. Theo tài liệu kỹ thuật chính thức, SoC này hoạt động ở dải công suất nhiệt thiết kế (TDP) từ 45W đến 80W trên laptop. Cần phân biệt rõ phiên bản di động này với dòng máy trạm để bàn DGX Spark chạy chip GB10, vốn hoạt động ở mức công suất 140W và có băng thông bộ nhớ 273 GB/s. Việc giới hạn dải công suất ở mức 45–80W cho thấy mục tiêu trực diện của đội xanh là cạnh tranh với các dòng máy xách tay chuyên nghiệp dùng chip M-series trong cùng một khung vỏ mỏng nhẹ.
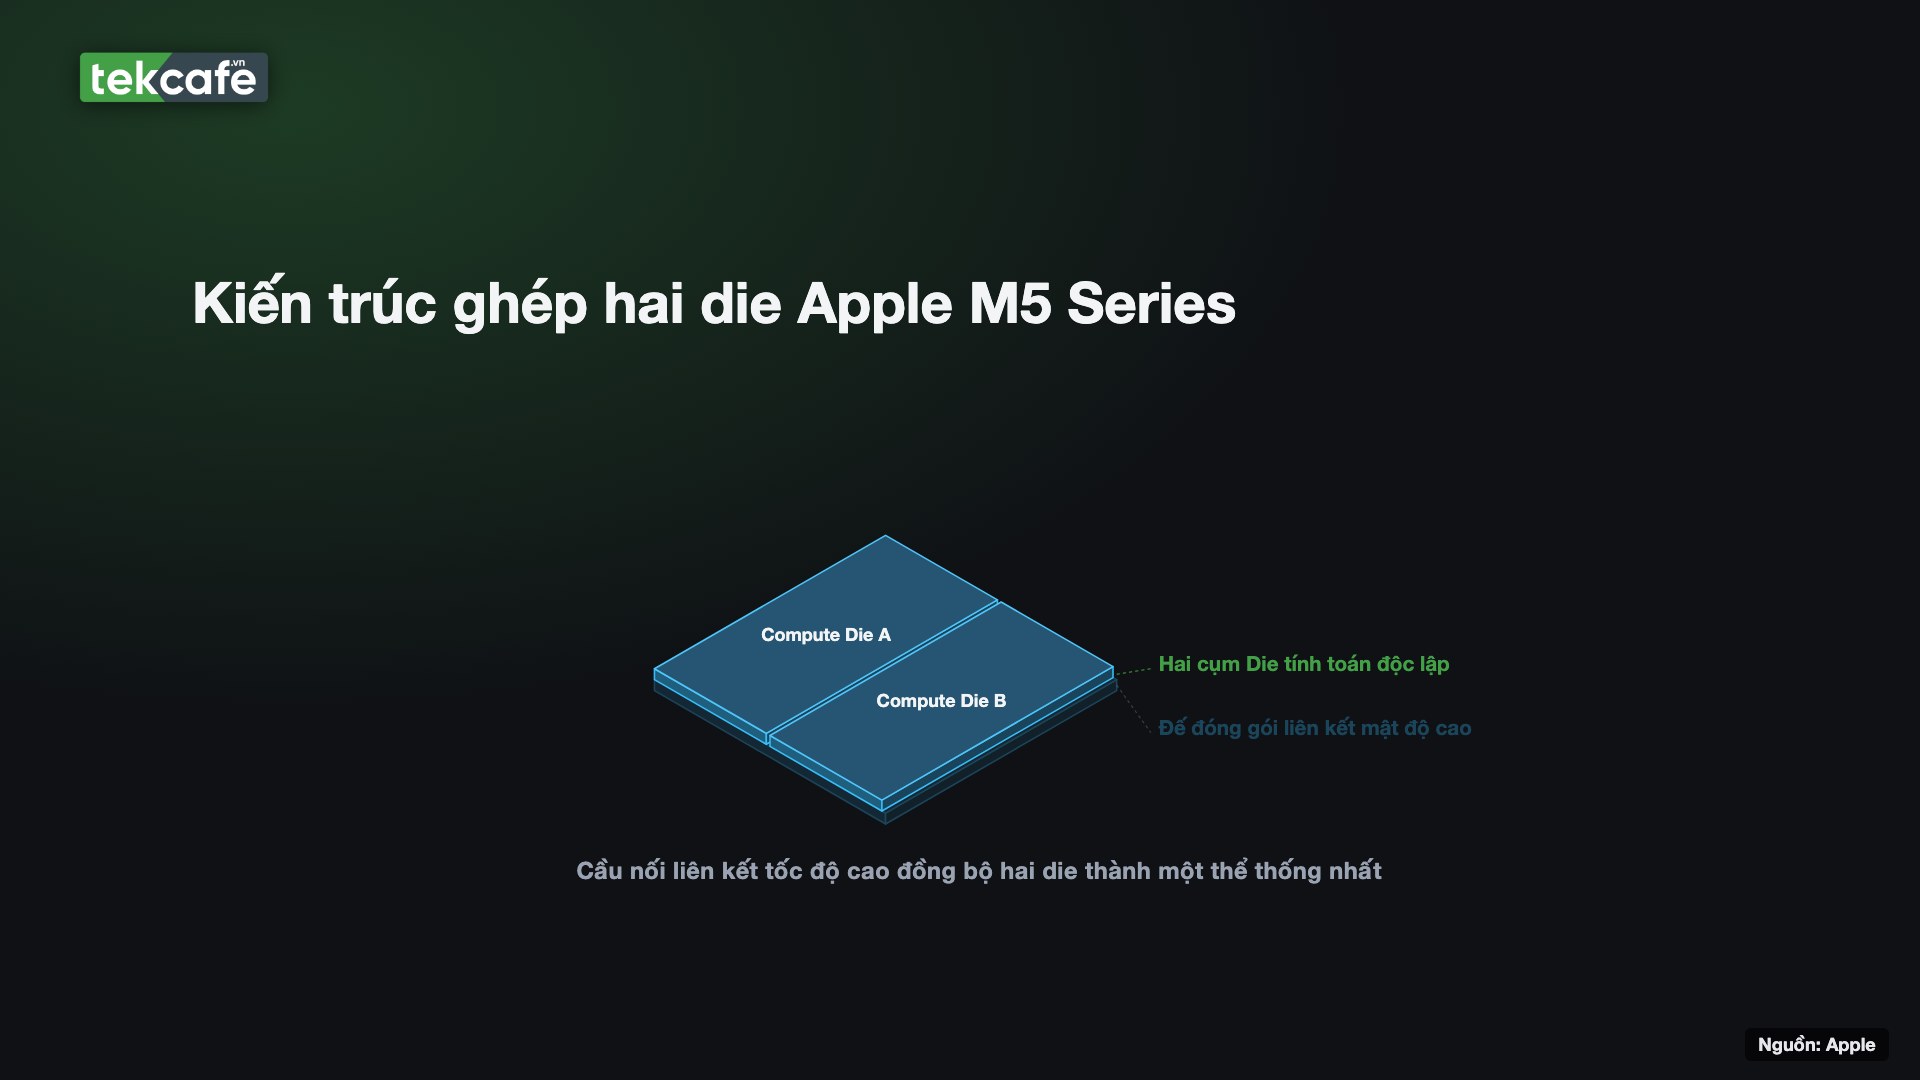
Về phía nền tảng Mac, bộ đôi M5 Pro và M5 Max đại diện cho đỉnh cao của công nghệ đóng gói chip với thiết kế Fusion Architecture hoàn toàn mới do Apple công bố. Thay vì sản xuất một khối đế silicon nguyên khối khổng lồ vốn chịu rủi ro lỗi phiến bán dẫn rất cao, giải pháp được áp dụng là ghép hai die riêng biệt thông qua cầu nối liên kết siêu dày đặc với độ trễ cực thấp. Cách tiếp cận này cho phép mở rộng quy mô diện tích silicon, tích hợp tới 18 nhân CPU, tối đa 40 nhân đồ họa, cụm 16 nhân Neural Engine thế hệ mới và hàng loạt khối điều khiển chuyên dụng. Cầu nối giữa hai die đảm bảo dữ liệu di chuyển liền mạch như trên một phiến silicon đơn nhất, giúp bộ vi xử lý giữ vững sự đồng nhất bộ nhớ tuyệt đối.
Sự khác biệt cốt lõi giữa hai hướng đi nằm ở triết lý cân bằng tài nguyên. Kiến trúc Blackwell tận dụng lợi thế dẫn đầu về điện toán ma trận và tập lệnh đồ họa để biến một vi xử lý máy tính xách tay thành trạm tính toán AI thu nhỏ. Ngược lại, nền tảng Mac tập trung tối đa vào thông lượng truyền dẫn dữ liệu từ bộ nhớ vào các cụm tính toán, hạn chế tối đa tình trạng nhân xử lý phải chờ nạp dữ liệu từ RAM.
Bộ vi xử lý trung tâm: Phép so sánh giữa cụm nhân Armv9 Cortex và kiến trúc Super Core
Về mặt tính toán đa dụng, cả hai nền tảng đều dựa trên nền tảng kiến trúc tập lệnh Arm hiện đại nhưng đi theo hai trường phái thiết kế nhân xử lý hoàn toàn trái ngược nhau.
Phiên bản cao cấp nhất của RTX Spark N1X trang bị CPU 20 nhân kiến trúc Armv9.2. Cụm CPU này được chia thành hai cụm điện toán độc lập, mỗi cụm gồm 10 nhân với cơ cấu đan xen đối xứng: 5 nhân hiệu năng cao Cortex-X925 và 5 nhân tiết kiệm điện năng Cortex-A725. Việc sử dụng nhân Cortex-X925 mang lại xung nhịp tức thời và chỉ số IPC (chỉ thị trên mỗi chu kỳ) rất cao cho các tác vụ đơn luồng. Cấu trúc đan xen xen kẽ theo thứ tự E-P-E-P được điều khiển thông qua mặt nạ phân luồng affinity mask trong hệ điều hành Windows on Arm, giúp phân phối tác vụ nền và tác vụ nặng tương đối linh hoạt. Tuy nhiên, do phụ thuộc vào thiết kế nhân tiêu chuẩn từ Arm, năng lực duy trì xung nhịp liên tục của Cortex-X925 khi chịu tải nặng kéo dài phụ thuộc rất lớn vào cơ chế tản nhiệt và giới hạn nhiệt độ của từng nhà sản xuất máy tính.
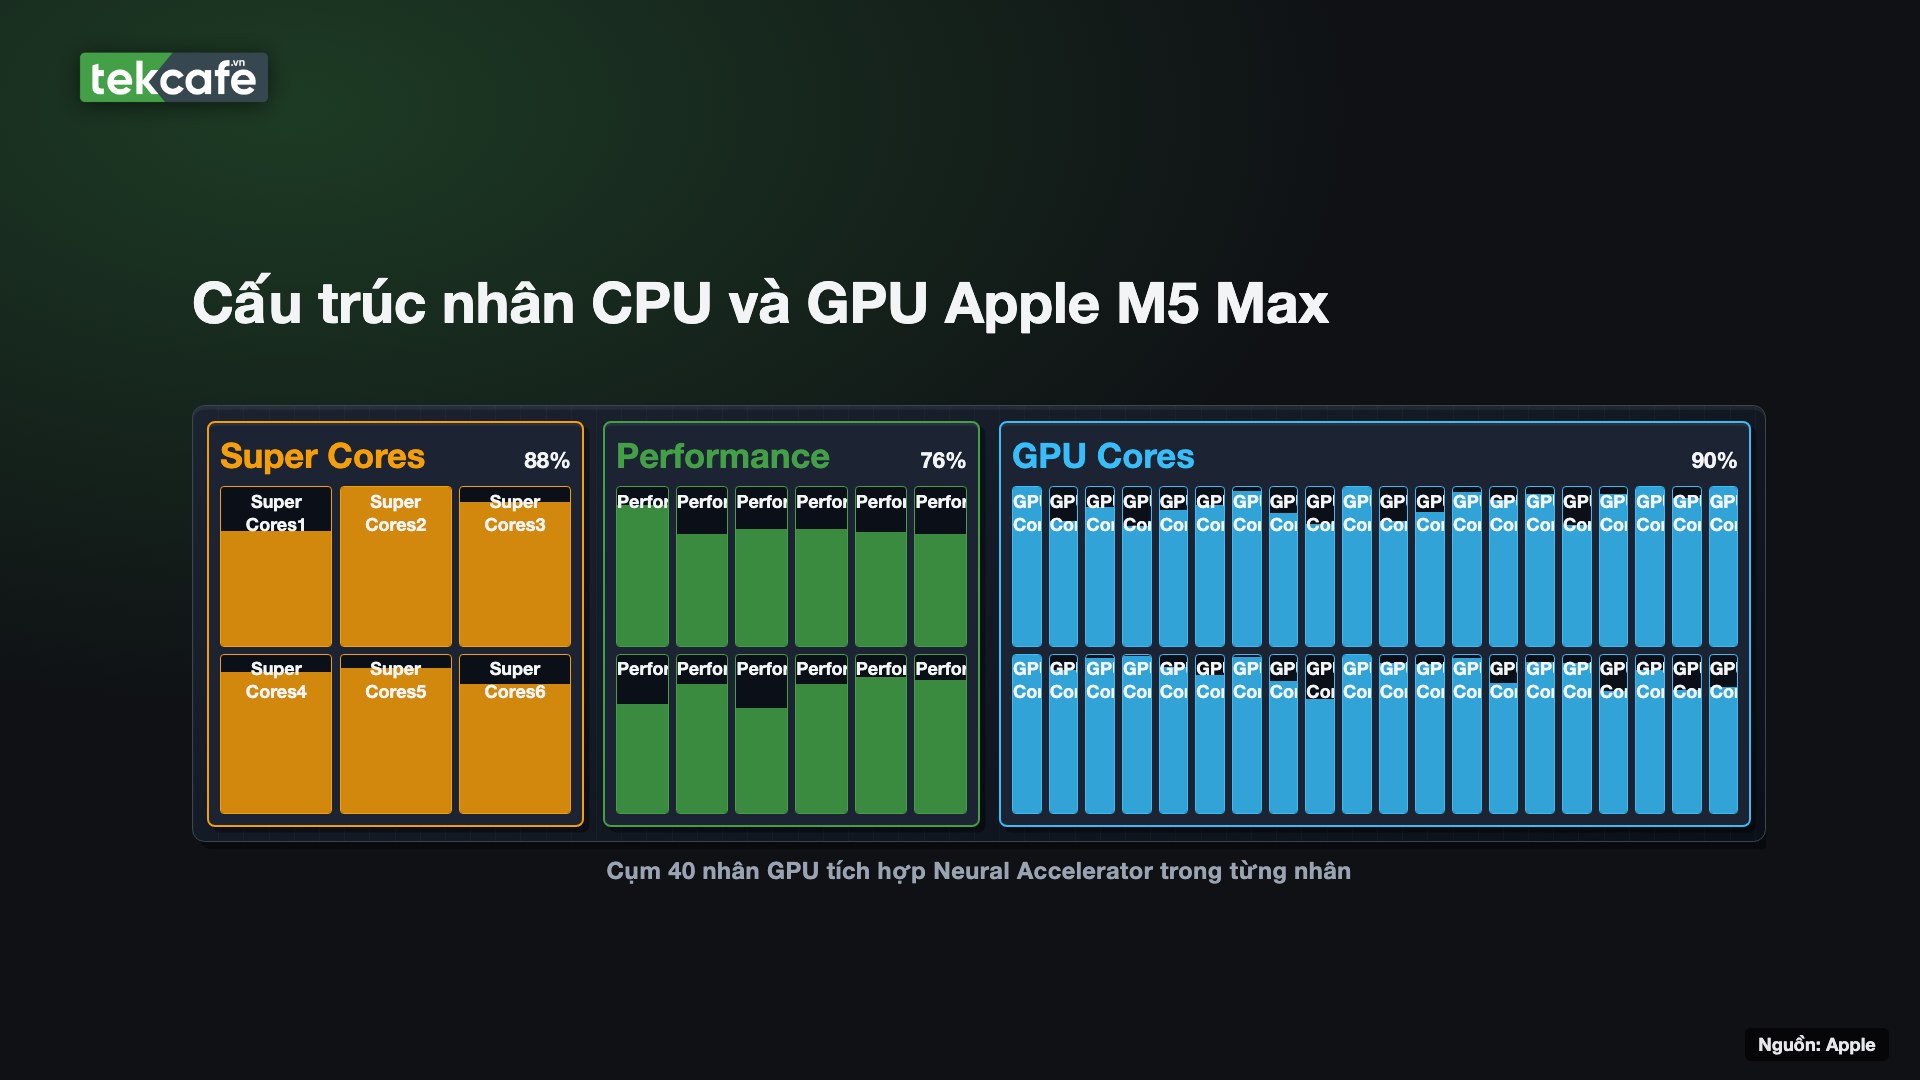
Nhà Táo lựa chọn con đường tự thiết kế vi kiến trúc nhân tùy biến hoàn toàn trên M5 Pro và M5 Max. Cấu hình cao cấp nhất mang đến 18 nhân CPU, bao gồm 6 nhân hiệu năng đỉnh cao được đặt tên là Super core, đi kèm 12 nhân hiệu năng cao Performance core. Cần lưu ý rằng 12 nhân thứ cấp này không phải là nhân tiết kiệm điện (Efficiency core) theo cách phân loại của các thế hệ trước, mà là các nhân xử lý đa luồng tối ưu hóa về mặt tỷ lệ hiệu năng trên công suất tiêu thụ điện. Cụm 6 nhân Super core sở hữu bộ nhớ đệm lệnh và hàng đợi thực thi lệnh ngoài trật tự (out-of-order execution) có kích thước vượt trội so với Cortex-X925, cho phép giải mã lượng lớn tập lệnh trong mỗi chu kỳ với mức xung nhịp vừa phải, từ đó giữ cho nhiệt độ chip luôn ở ngưỡng kiểm soát tốt.
Bảng đối chiếu thông số phần cứng tổng thể dưới đây làm sáng tỏ các điểm khác biệt then chốt giữa hai nền tảng:
| Thông số kỹ thuật | RTX Spark N1X | M5 Pro | M5 Max |
|---|---|---|---|
| Kiến trúc CPU | 20 nhân (10x Cortex-X925 + 10x Cortex-A725) | 15 hoặc 18 nhân (tối đa 6 Super cores + 12 Performance cores) | 18 nhân (6 Super cores + 12 Performance cores) |
| Kiến trúc GPU | Blackwell iGPU (tối đa 6.144 nhân CUDA/RTX) | Kiến trúc thế hệ mới Metal 4 (16 hoặc 20 nhân đồ họa) | Kiến trúc thế hệ mới Metal 4 (32 hoặc 40 nhân đồ họa) |
| Khối tăng tốc AI | Tensor Cores thế hệ 5 (hỗ trợ FP4, FP8, FP16) | 16 nhân Neural Engine + Neural Accelerator trong từng nhân đồ họa. | 16 nhân Neural Engine + Neural Accelerator trong từng nhân đồ họa. |
| Bộ nhớ RAM tối đa | LPDDR5X tối đa 128GB | LPDDR5X tối đa 64GB | LPDDR5X tối đa 128GB |
| Băng thông bộ nhớ | 300 GB/s (Bus 256-bit) | 307 GB/s | 614 GB/s (bản 40 cụm đồ họa) |
| Hiệu năng AI lý thuyết | Lên tới 1 Petaflop FP4 | Tăng gấp 4 lần GPU compute AI so với thế hệ M4 | Tăng gấp 4 lần GPU compute AI so với thế hệ M4 |
| Mức tiêu thụ điện (TDP) | 45W – 80W (Laptop) | — | — |
| Bộ mã hóa Media | 1x NVENC thế hệ 9, 1x NVDEC thế hệ 6 | 1x Video decode, 1x Video encode, 1x ProRes engine | 1x Decode, 2x Video encode, 2x ProRes engine |
Số liệu: Tài liệu kỹ thuật phần cứng chính thức và thông số công bố
Nhìn vào cơ cấu CPU, RTX Spark N1X có lợi thế về số lượng luồng thực thi khi sở hữu 20 nhân vật lý, hỗ trợ đắc lực cho các tác vụ biên dịch mã nguồn hoặc dựng hình thuần CPU. Tuy nhiên, sức mạnh đơn nhân thuần túy của các nhân Super core trên M5 Pro và M5 Max lại mang đến phản hồi nhanh nhạy hơn trong các ứng dụng văn phòng, thiết kế giao diện và xử lý luồng đơn trong phần mềm dựng hình âm thanh.
Đồ họa và tính toán ma trận: 6.144 nhân Blackwell so với 40 nhân GPU Metal 4
Một trong những sai lầm phổ biến nhất khi so sánh phần cứng giữa hai hệ điều hành là lấy số lượng nhân đồ họa thuần túy ra để cân đo. Nhiều người nhìn vào con số 6.144 nhân trên RTX Spark N1X và vội vàng suy diễn rằng chip của đội xanh mạnh gấp hàng chục lần so với 40 nhân đồ họa của M5 Max. Đây là một so sánh sai lệch hoàn toàn về mặt bản chất kỹ thuật.
Khối GPU trên RTX Spark N1X được xây dựng trên vi kiến trúc Blackwell. Con số 6.144 nhân đại diện cho các bộ xử lý dòng (CUDA Cores) đơn lẻ, được nhóm thành các khối xử lý đa luồng (Streaming Multiprocessors – SM). Mỗi SM chứa các nhân tính toán số nguyên, dấu phẩy động FP32, nhân Ray Tracing thế hệ 4 và nhân Tensor thế hệ 5 chuyên dụng cho các phép toán ma trận dày đặc. Sức mạnh của Blackwell nằm ở khả năng tương thích hoàn hảo với tập lệnh CUDA – tiêu chuẩn thực tế của ngành khoa học máy tính và trí tuệ nhân tạo hiện đại. Các phần mềm 3D như Blender, Maya hay các thư viện PyTorch, TensorFlow đều được tối ưu hóa sâu sắc cho kiến trúc này.
Trong khi đó, 40 nhân đồ họa trên M5 Max là 40 cụm tính toán đồ sộ (Compute Units) được thiết kế riêng cho API Metal 4. Mỗi nhân đồ họa chứa hàng trăm đơn vị tính toán số học cùng hàng loạt đường ống lệnh độc lập. Đáng chú ý nhất trên thế hệ M5 Pro và M5 Max là việc tích hợp trực tiếp một khối Neural Accelerator vào bên trong từng nhân đồ họa. Điều này giúp các nhân đồ họa có thể trực tiếp xử lý các phép tính tensor mà không cần phải đẩy dữ liệu qua cụm Neural Engine độc lập, giảm thiểu độ trễ giao tiếp nội bộ.
Khi xử lý các tác vụ dựng hình đồ họa 3D truyền thống có kích hoạt tính năng dò tia (Ray Tracing), nhân RT thế hệ 4 vẫn chứng minh độ vượt trội về năng lực tính toán giao điểm tia với hình học phức tạp. Bù lại, ở các bài kiểm tra dựng hình rasterization thông thường và xử lý hiệu ứng trong DaVinci Resolve hay Final Cut Pro, độ rộng băng thông lớn của M5 Max giúp 40 nhân đồ họa duy trì hiệu suất ổn định mà không bị nghẽn đường truyền dữ liệu.
Bộ nhớ hợp nhất: Cơ chế phân vùng RAM trên Windows on Arm và ưu thế băng thông
Cả hai nhà sản xuất đều quảng bá mạnh mẽ tính năng bộ nhớ hợp nhất (Unified Memory) với dung lượng tối đa lên đến 128GB. Tuy nhiên, cách thức hoạt động thực tế của bộ nhớ hợp nhất trên Windows on Arm và macOS là hai khái niệm hoàn toàn khác biệt nhau.
Trên nền tảng máy Mac, kiến trúc Unified Memory thực sự là một không gian địa chỉ bộ nhớ vật lý đồng nhất hoàn toàn (coherent flat memory space). CPU, GPU và Neural Engine cùng truy cập vào một khối RAM duy nhất mà không cần sao chép dữ liệu qua lại. Quan trọng hơn, trình quản lý bộ nhớ của macOS cho phép GPU cấp phát phần lớn dung lượng RAM của hệ thống khi cần thiết. Điều này đồng nghĩa với việc trên một chiếc MacBook Pro M5 Max trang bị 128GB RAM, người dùng có thể tải thẳng một mô hình ngôn ngữ lớn (LLM) chiếm dụng gần như toàn bộ bộ nhớ vào GPU để thực hiện suy luận mà không gặp bất kỳ rào cản phần mềm nào.
Ngược lại, kiến trúc bộ nhớ hợp nhất của RTX Spark N1X khi hoạt động trên hệ điều hành Windows on Arm lại chịu sự ràng buộc bởi các quy định phân bổ bộ nhớ nghiêm ngặt của hệ điều hành. Theo tài liệu kỹ thuật chính thức, không gian RAM vật lý tối đa 128GB LPDDR5X trên RTX Spark được chia thành ba vùng logic tách biệt:
- Vùng bộ nhớ GPU dành riêng (Dedicated GPU memory carveout): Đây là phân vùng được cố định sẵn từ bộ nhớ DRAM hệ thống và báo cáo cho Windows như thể là VRAM của một card đồ họa rời. Phân vùng này có giới hạn dung lượng nhất định tùy theo cấu hình BIOS của nhà sản xuất, đóng vai trò như bộ nhớ VRAM chuyên dụng.
- Vùng bộ nhớ hệ thống chia sẻ (Shared system memory): Vùng bộ nhớ do Windows quản lý, có thể được truy cập bởi cả CPU và GPU nhưng phải chịu sự điều phối phân bổ của hệ điều hành. Khi GPU sử dụng vùng nhớ này, độ ưu tiên truy xuất và độ trễ sẽ bị ảnh hưởng nếu CPU cũng đang thực hiện tác vụ nặng.
- Vùng bộ nhớ chỉ dành riêng cho CPU (CPU-only system memory): Phần dung lượng bộ nhớ còn lại được bảo lưu hoàn toàn cho hệ điều hành và các tiến trình CPU, GPU bị cấm tuyệt đối không được phép cấp phát vùng nhớ này.
Cơ chế phân vùng này tạo ra một rào cản kỹ thuật đáng kể. Người dùng sở hữu một cỗ máy RTX Spark 128GB RAM không thể tùy tiện giao toàn bộ RAM cho mô hình AI chạy trên GPU như trên macOS. Trình điều khiển đồ họa trên Windows sẽ áp đặt một ngân sách bộ nhớ (memory budget) nghiêm ngặt; nếu một ứng dụng AI cố tình cấp phát vượt qua hạn ngạch carveout và bộ nhớ chia sẻ cho phép, hệ thống sẽ tự động hoán đổi dữ liệu (paging) ra ổ cứng SSD hoặc kích hoạt lỗi tràn bộ nhớ (Out of Memory – OOM).
Bên cạnh cơ chế phân vùng, khoảng cách về băng thông truyền tải giữa hai đối thủ là vô cùng rõ rệt:
| Tiêu chí bộ nhớ | RTX Spark N1X | M5 Pro | M5 Max (Bản 40-core) |
|---|---|---|---|
| Dung lượng tối đa | 128 GB LPDDR5X | 64 GB LPDDR5X | 128 GB LPDDR5X |
| Độ rộng bus bộ nhớ | 256-bit | 256-bit | 512-bit |
| Băng thông tối đa | 300 GB/s | 307 GB/s | 614 GB/s |
| Tỷ lệ băng thông so với RTX Spark | 1,0x (Mốc so sánh) | 1,02x | 2,05x |
| Cơ chế phân quyền bộ nhớ | Chia 3 vùng (Carveout, Shared, CPU-only) | Bộ nhớ phẳng hoàn toàn (Flat Coherent Pool) | Bộ nhớ phẳng hoàn toàn (Flat Coherent Pool) |
| Khả năng cấp phát tối đa cho GPU | Bị giới hạn bởi phân vùng Carveout và Budget | Toàn quyền sử dụng theo nhu cầu tiến trình | Toàn quyền sử dụng theo nhu cầu tiến trình |
Số liệu: Tài liệu kỹ thuật UMA và thông số phần cứng
Băng thông 614 GB/s của M5 Max gấp xấp xỉ 2,05 lần mức 300 GB/s của RTX Spark N1X. Con số chênh lệch này mang lại ưu thế truyền dữ liệu vượt trội cho việc nạp các mô hình AI lớn.
Hiệu năng suy luận AI: Bản chất cuộc đua giữa băng thông bộ nhớ và định dạng FP4
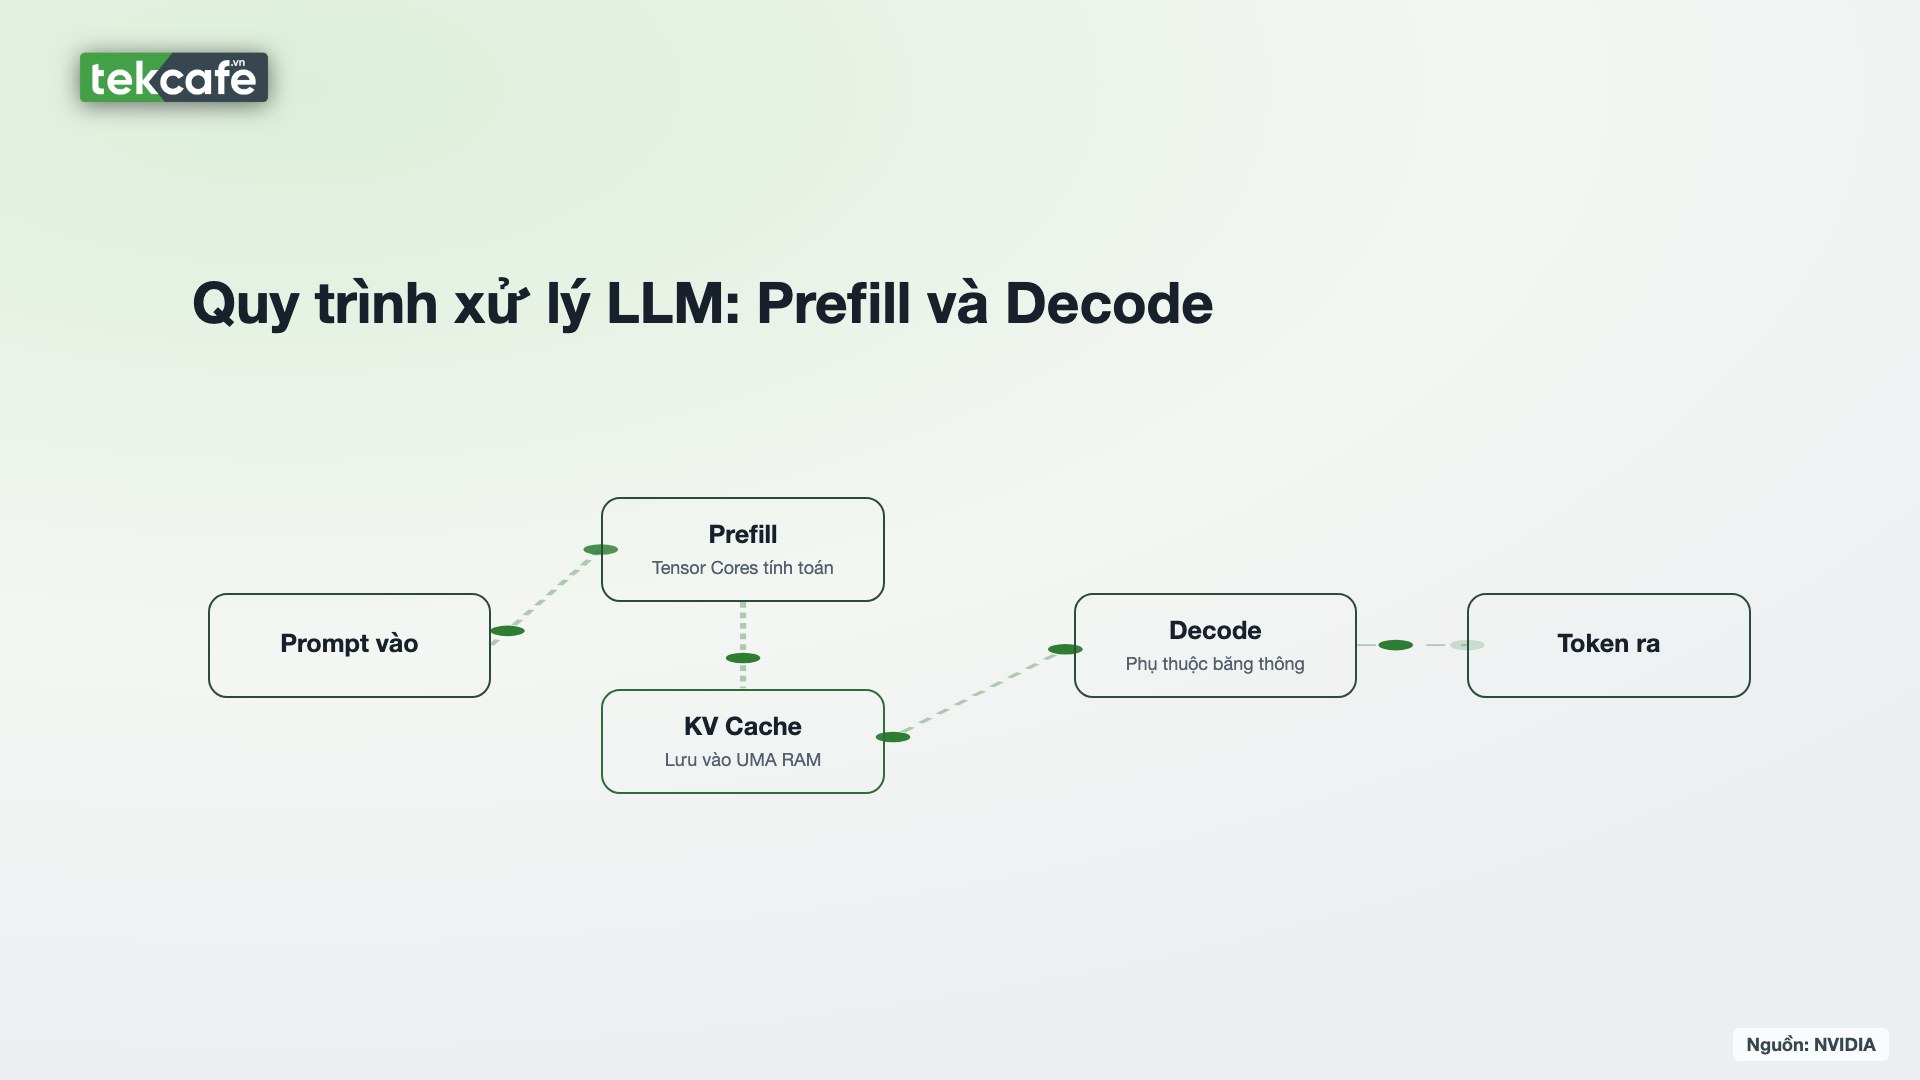
Để hiểu rõ hiệu năng thực tế của hai con chip khi chạy các mô hình trí tuệ nhân tạo cục bộ, cần tách bạch hai giai đoạn cốt lõi của quá trình suy luận mô hình ngôn ngữ lớn (LLM): giai đoạn đọc hiểu đề bài (prefill phase) và giai đoạn sinh từng từ kế tiếp (decode phase).
Giai đoạn prefill phụ thuộc nặng nề vào năng lực tính toán ma trận thô (compute-bound). Đây chính là sân chơi mà kiến trúc Blackwell chiếm ưu thế nhờ nhân Tensor thế hệ 5. Thông số kỹ thuật công bố cho thấy hiệu năng AI tính toán đỉnh của RTX Spark đạt tới 1 petaflop ở độ chính xác cực thấp FP4 (4-bit Floating Point). Ở định dạng lượng tử hóa sâu NVFP4, các nhân Tensor có thể thực hiện phép nhân ma trận với tốc độ lớn, giúp máy nạp hàng nghìn token ngữ cảnh trong thời gian ngắn. Nếu người dùng thường xuyên làm việc với các prompt dài hàng chục nghìn token hoặc chạy các mô hình khuếch tán hình ảnh (diffusion models) vốn cần tính toán ma trận dày đặc lặp đi lặp lại qua nhiều bước khử nhiễu, RTX Spark sẽ phát huy sức mạnh tối đa.
Tuy nhiên, giai đoạn decode – quá trình sinh ra từng token câu trả lời tiếp theo – lại là bài toán bị nghẽn bởi tốc độ đọc từ bộ nhớ (memory-bandwidth bound). Ở mỗi bước sinh một từ mới, toàn bộ trọng số của mô hình phải được đọc một lần từ RAM vào các nhân tính toán của GPU. Mức băng thông lý thuyết 614 GB/s của M5 Max 40 nhân GPU gấp xấp xỉ 2,05 lần mức 300 GB/s của RTX Spark N1X; sự chênh lệch này giúp giảm tải áp lực nghẽn cổ chai đường truyền khi đọc trọng số lớn ở pha decode. Khi vận hành các mô hình lớn mà không muốn làm suy giảm khả năng suy luận logic bằng cách ép xuống 4-bit, giải pháp băng thông rộng của M5 Max đem lại độ mượt mà đáng tin cậy.
Sự đánh đổi ở đây rất rõ ràng: đội xanh chọn giải pháp nén nhỏ mô hình bằng công nghệ lượng tử hóa tiên tiến FP4 để vượt qua giới hạn băng thông 300 GB/s; trong khi nhà Táo chọn giải pháp xây dựng một đường truyền dữ liệu 614 GB/s để mô hình có thể di chuyển ở kích thước nguyên bản.
Bóc tách số liệu đo lường: Sự thật đằng sau mức chênh lệch 6,2 lần
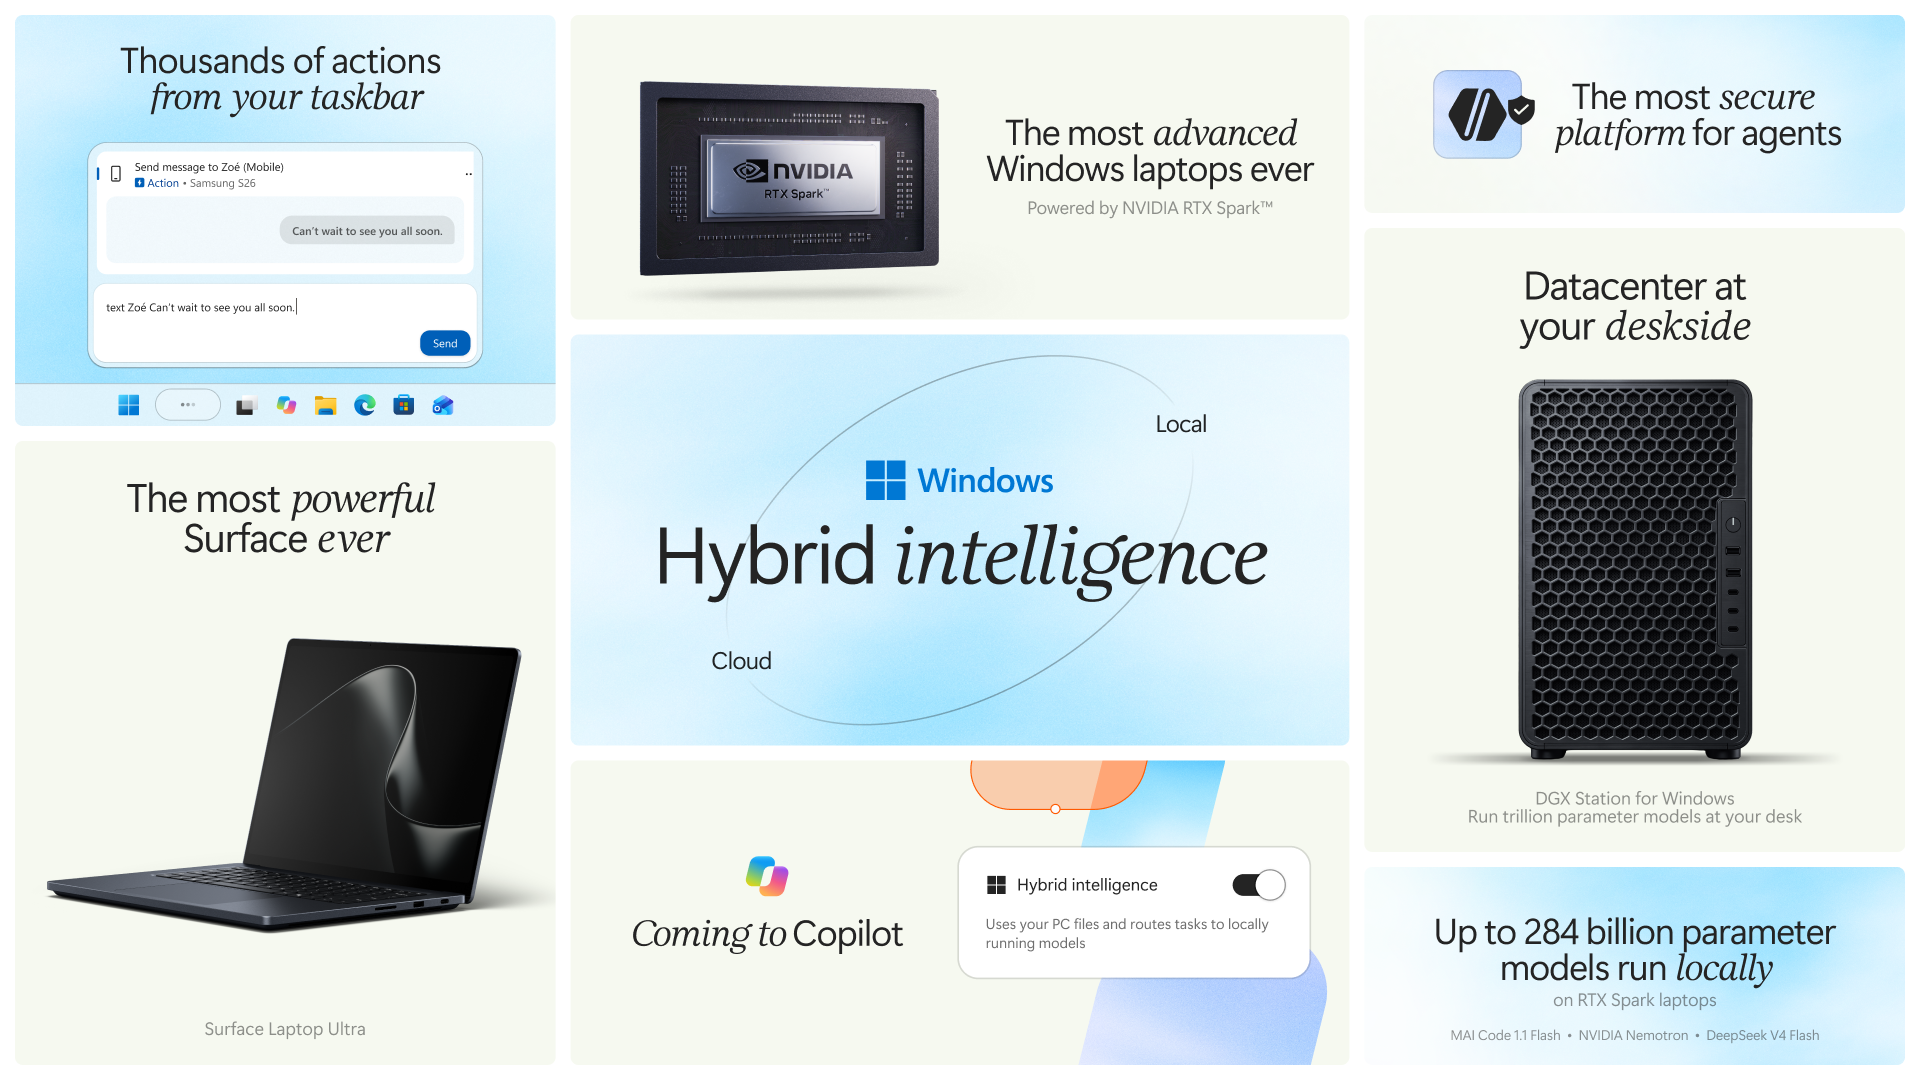
Trong bài công bố gần đây về định hướng phát triển hệ điều hành cho trí tuệ nhân tạo lai (hybrid intelligence), một loạt biểu đồ so sánh được đưa ra nhằm khẳng định các máy tính Windows trang bị chip RTX Spark vượt trội so với máy tính xách tay đối thủ. Tuy nhiên, mọi con số so sánh cần được đặt vào đúng bối cảnh thử nghiệm cụ thể.
Theo thử nghiệm do Microsoft công bố vào tháng 9/2026 trên máy tiền sản xuất so với MacBook Pro 16 inch M5 Pro 64GB ở điều kiện lượng tử hóa NVFP4: thời gian xuất token đầu tiên (TTFT) được đo lường nhanh hơn tới 2,1 lần, tốc độ tạo ảnh AI nhanh hơn tới 4,3 lần và tốc độ tạo video AI nhanh hơn tới 6,2 lần.
Những con số này nhanh chóng tạo nên làn sóng tranh luận sôi nổi trong cộng đồng công nghệ. Tuy nhiên, khi đào sâu vào phần chú thích kỹ thuật (footnotes) đính kèm tài liệu thử nghiệm, bức tranh thực tế lại xuất hiện những chi tiết quan trọng cần được làm sáng tỏ.
| Bài kiểm tra | Con số công bố | Cấu hình máy thử nghiệm Windows | Đối thủ được đem ra so sánh | Mô hình và định dạng thử nghiệm |
|---|---|---|---|---|
| Time to First Token (TTFT) | Nhanh hơn tới 2,1x (theo thử nghiệm công bố) | Máy tiền sản xuất Surface Laptop Ultra (RTX Spark, 64GB RAM) | MacBook Pro 16 inch M5 Pro (64GB RAM) | llama.cpp, mô hình Qwen3.5 27B (Q4K-Medium), prompt cố định 8.192 token |
| Tạo ảnh AI (Image Gen) | Nhanh hơn tới 4,3x (theo thử nghiệm công bố) | Máy tiền sản xuất NVIDIA RTX Spark (64GB RAM) | MacBook Pro 16 inch M5 Pro (64GB RAM) | ComfyUI, mô hình FLUX.2 Klein 4B, định dạng NVFP4, 4 bước lấy mẫu, 1024×1024 |
| Tạo video AI (Video Gen) | Nhanh hơn tới 6,2x (theo thử nghiệm công bố) | Máy tiền sản xuất NVIDIA RTX Spark (64GB RAM) | MacBook Pro 16 inch M5 Pro (64GB RAM) | ComfyUI, mô hình LTX 2.3 22B, định dạng NVFP4, 121 khung hình, 25 fps, 8 bước, 720p |
Số liệu: Footnotes 5, 6, 7, 8 trong công bố của nhà phát triển Windows (Kiểm nghiệm thực hiện tháng 9/2026)
Có ba điểm mấu chốt cần được làm sáng tỏ từ bảng dữ liệu trên:
Thứ nhất, đối tượng so sánh bị hạ cấp. Bài kiểm tra không hề đem RTX Spark ra đối đầu với con chip mạnh nhất là M5 Max trang bị 40 nhân GPU và 128GB RAM. Thay vào đó, cấu hình được chọn là chiếc MacBook Pro 16 inch sử dụng chip M5 Pro với dung lượng RAM 64GB. M5 Pro chỉ sở hữu tối đa 20 nhân GPU và băng thông 307 GB/s – tức chỉ bằng một nửa sức mạnh phần cứng của bản M5 Max. Đặt một SoC sở hữu 6.144 nhân đồ họa cao cấp nhất của kiến trúc Blackwell bên cạnh một cấu hình tầm trung rõ ràng là một phép thử có chủ đích nghiêng về phía đội nhà.
Thứ hai, định dạng dữ liệu lượng tử hóa NVFP4. Trong cả hai bài thử nghiệm tạo ảnh FLUX.2 Klein và tạo video LTX 2.3 trên phần mềm ComfyUI, thử nghiệm đều chạy mô hình ở định dạng lượng tử hóa độc quyền NVFP4. Định dạng 4-bit này được thiết kế để khai thác tối đa nhân Tensor thế hệ 5 của Blackwell. Trong khi đó, hệ sinh thái phần mềm Metal của nhà Táo chưa có sự tối ưu hóa tương đương cho định dạng FP4 này, buộc máy Mac phải chạy ở các định dạng độ chính xác cao hơn hoặc thông qua các lớp chuyển đổi chưa tối ưu. Sự chênh lệch 6,2 lần về tốc độ tạo video phản ánh mức độ tối ưu hóa sâu của phần mềm cho định dạng nén dữ liệu mới hơn là phản ánh khoảng cách về năng lực thiết bị thuần túy.
Thứ ba, tình trạng thiết bị tiền sản xuất. Toàn bộ các thử nghiệm được thực hiện trên các mẫu máy tiền sản xuất trong điều kiện phòng thí nghiệm nội bộ vào tháng 9 năm 2026. Hiệu năng thực tế trên các dòng máy thương mại khi người dùng sử dụng thực tế còn chịu sự chi phối của việc điều tiết nhiệt độ, thời lượng pin và trình điều khiển hoàn thiện.
Xử lý đa phương tiện: Media Engine hai khối mã hóa đối đầu cụm NVENC và NVDEC thế hệ mới
Đối với các nhà sáng tạo nội dung chuyên nghiệp trong lĩnh vực dựng phim, năng lực mã hóa và giải mã video đóng vai trò quyết định đến trải nghiệm biên tập thực tế.
RTX Spark N1X trang bị một bộ mã hóa NVENC thế hệ thứ 9 duy nhất và một bộ giải mã NVDEC thế hệ thứ 6. Bộ mã hóa NVENC thế hệ 9 hỗ trợ đầy đủ các chuẩn nén video hiện đại nhất bao gồm AV1 10-bit, HEVC và H.264 với hiệu suất nén cao và chất lượng hình ảnh tốt. Đây là công cụ đắc lực cho những người làm công việc phát sóng trực tiếp hoặc xuất file đồ họa nhanh chóng. Tuy nhiên, việc chỉ trang bị một bộ NVENC duy nhất đặt ra giới hạn khi người dùng cần xuất đồng thời nhiều luồng video hoặc thực hiện các tác vụ chuyển đổi mã định dạng hàng loạt ở độ phân giải 8K.
M5 Max thể hiện sự đầu tư lớn vào phân khúc sản xuất video chuyên nghiệp thông qua cụm Media Engine thế hệ mới. Trên phiên bản M5 Max đầy đủ, nhà Táo tích hợp hai bộ mã hóa video tiêu chuẩn (Video encode engines) và hai bộ giải mã/mã hóa định dạng ProRes chuyên biệt (ProRes encode and decode engines). Cụm xử lý này cho phép người dựng phim phát lại đồng thời hàng chục luồng video ProRes 422 hoặc ProRes RAW chuẩn 4K và 8K trong Final Cut Pro hay DaVinci Resolve mà CPU và GPU gần như không phải hoạt động, giữ cho máy hoàn toàn mát mẻ và tiết kiệm pin tối đa.
| Tính năng Media | RTX Spark N1X | M5 Pro | M5 Max |
|---|---|---|---|
| Bộ giải mã video (Decode) | 1x NVDEC thế hệ 6 (H.264, HEVC, AV1) | 1x Video decode engine chuyên dụng | 1x Video decode engine chuyên dụng |
| Bộ mã hóa video (Encode) | 1x NVENC thế hệ 9 (H.264, HEVC, AV1) | 1x Video encode engine | 2x Video encode engines |
| Tăng tốc chuyên biệt ProRes | Xử lý qua nhân CUDA thông thường | 1x ProRes encode và decode engine | 2x ProRes encode và decode engines |
| Hiệu năng dựng phim nhiều luồng | Phụ thuộc vào chia sẻ tài nguyên SM | Xuất sắc với định dạng ProRes | Dẫn đầu trong các luồng 8K ProRes |
Số liệu: Thông số kỹ thuật chính thức từ hai hãng
Đối với quy trình sản xuất video thương mại sử dụng máy quay điện ảnh của RED, ARRI hay Sony FX, cấu trúc hai bộ tăng tốc ProRes của M5 Max mang lại độ mượt mà khi cắt dựng thời gian thực mà các giải pháp đồ họa dựa trên NVENC đơn luồng khó lòng bắt kịp.
Tác động thực tế và bài toán đầu tư tại thị trường Việt Nam
Việc lựa chọn nền tảng nào giữa RTX Spark N1X và M5 Pro hay M5 Max phụ thuộc chặt chẽ vào đặc thù công việc cụ thể và hiện trạng thị trường máy tính tại Việt Nam.
Tại thị trường Việt Nam, các dòng MacBook Pro trang bị chip M5 Pro và M5 Max hiện đã có mặt chính thức trên kệ hàng của các hệ thống bán lẻ ủy quyền lớn như CellphoneS. Mức giá khởi điểm ghi nhận từ 66,99 triệu đồng cho phiên bản MacBook Pro 14 inch M5 Pro tiêu chuẩn, trong khi các tùy chọn cấu hình cao cấp dùng chip M5 Max với 64GB hoặc 128GB RAM có giá lên tới trên 110 triệu đồng cho bản cấu hình cao. Ưu thế lớn nhất của máy Mac tại Việt Nam là tính sẵn có, chính sách bảo hành chính hãng phủ khắp và độ ổn định đã được kiểm chứng của hệ điều hành macOS đối với giới thiết kế sáng tạo, lập trình viên di động và dựng phim chuyên nghiệp.
Trong khi đó, thiết bị đầu tiên dùng RTX Spark N1X đã có giá chính thức tại Việt Nam. ASUS mở đặt trước ProArt P16 từ ngày 8/10 đến hết ngày 15/10/2026 trên ASUS Store Online. Bản cao nhất có giá đề xuất 194.990.000 đồng, đi kèm 128GB bộ nhớ hợp nhất và màn hình cảm ứng 4K OLED 120Hz. Người đặt trước trong khung thời gian này được tặng gói bảo hành trị giá 2.980.000 đồng, gồm 2 năm bảo vệ tai nạn và 1 năm mở rộng bảo hành chính hãng. Các cấu hình khác của P16 và mẫu P14 chưa có giá tại Việt Nam, và 128GB là cấu hình cao nhất nên không đại diện cho bản giá khởi điểm. Ở thị trường quốc tế, giá khởi điểm của dòng này từ 2.599 USD (khoảng 65 triệu đồng). Tham khảo thêm tại bài về ASUS ProArt P16 mở đặt trước tại Việt Nam. Người cần mua sớm nên so giá bản cao nhất này với các bản MacBook Pro M5 Max 128GB nói trên.
Về khía cạnh chuyên môn, bức tranh phân định rất rõ ràng:
RTX Spark N1X là sự lựa chọn ưu tiên dành cho các kỹ sư nghiên cứu AI, nhà phát triển phần mềm cần môi trường CUDA nguyên bản trên hệ thống máy trạm gọn nhẹ, những người sáng tạo nội dung dựa vào các mô hình tạo sinh hình ảnh, video với quy trình tự động hóa phức tạp, và người dùng cần sự tương thích tuyệt đối với các ứng dụng kỹ thuật chỉ hoạt động trên môi trường Windows.
M5 Pro và đặc biệt là M5 Max giữ vững vị thế là cỗ máy toàn diện cho các nhà làm phim chuyên nghiệp, nhà dựng hình âm thanh, lập trình viên xây dựng ứng dụng trong hệ sinh thái của nhà Táo, và những ai cần một không gian bộ nhớ hợp nhất dung lượng lớn với băng thông 614 GB/s để vận hành các mô hình ngôn ngữ lớn chất lượng cao mà không bị phân mảnh hay ràng buộc bởi các rào cản phân vùng phần mềm.
Cuộc cạnh tranh sòng phẳng này mang lại lợi ích to lớn cho người dùng chuyên nghiệp: lần đầu tiên sau nhiều năm, người dùng Windows đã có một nền tảng SoC tích hợp sở hữu sức mạnh AI đáng chú ý để tạo sức ép thực sự lên vị thế dẫn đầu của dòng chip M-series.
Nguồn tham khảo: NVIDIA RTX Spark, NVIDIA Windows on Arm Porting Guide, NVIDIA Unified Memory Architecture Guide, Apple Newsroom M5 Pro và M5 Max, Apple MacBook Pro Specifications, Microsoft Windows Blog, ASUS Pressroom.