
Tóm tắt nhanh
- Dữ liệu OpenRouter do a16z công bố ghi nhận các AI agent đạt mức tiêu thụ 7,3 nghìn tỷ token vào tháng 8/2026, gấp hơn 5 lần mức 1,4 nghìn tỷ token của người dùng trực tiếp.
- Hơn 85% tổng lượng token từ AI agent đến từ prompt được cache, phản ánh đặc thù đọc đi đọc lại ngữ cảnh thay vì sinh mới nội dung liên tục.
- Áp lực hạ tầng tập trung vào dung lượng bộ nhớ duy trì KV-cache cho ngữ cảnh dài, trong khi chi phí thực tế được giảm thiểu đáng kể nhờ cơ chế tái sử dụng bộ đệm.
- Doanh nghiệp cần theo dõi chi phí trên từng tác vụ hoàn thành và tỷ lệ cache hit thay vì chỉ quan sát tổng số lượng token danh nghĩa.
Lưu lượng agent vượt người dùng: Tăng trưởng 14 lần và mốc 7,3 nghìn tỷ token
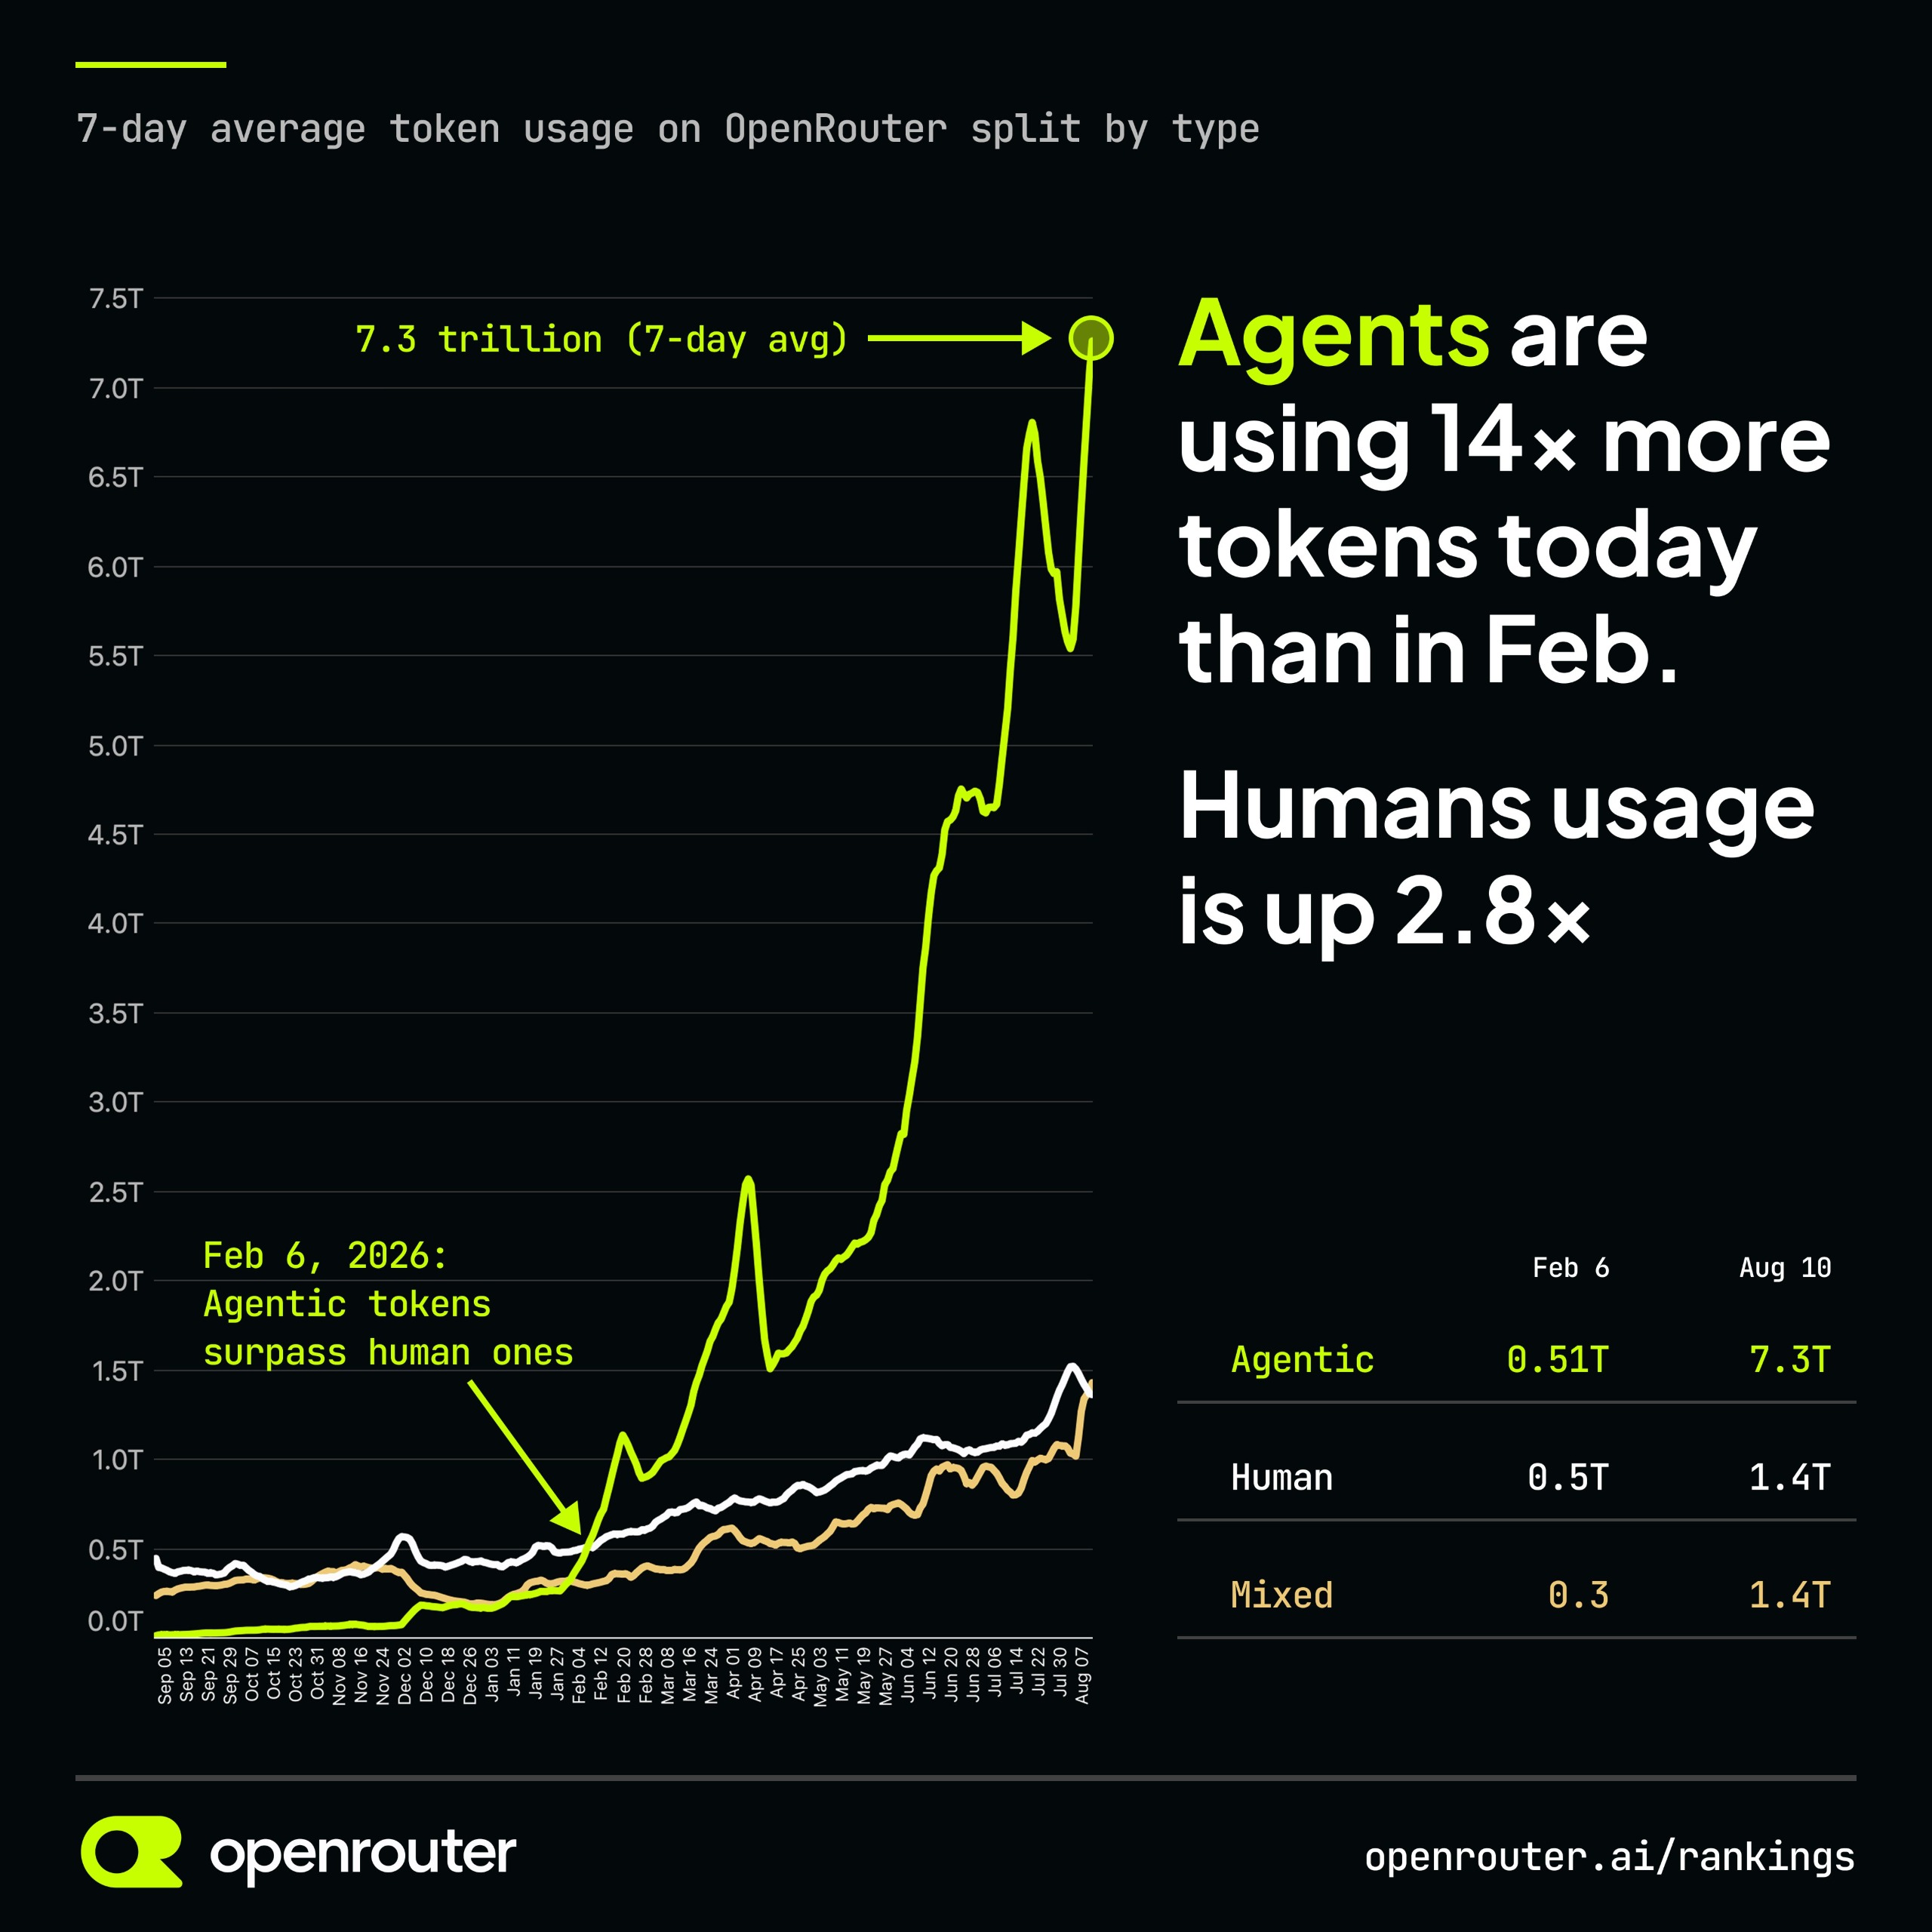
Báo cáo tổng hợp từ quỹ đầu tư mạo hiểm Andreessen Horowitz (a16z) dựa trên số liệu của nền tảng định tuyến mô hình OpenRouter cho thấy một bước chuyển dịch lớn trong phương thức khai thác trí tuệ nhân tạo. Vào ngày 6/2/2026, lượng token tiêu thụ bởi các tác tử tự hành (AI agent) đã chính thức vượt qua lượng token do người dùng thao tác trực tiếp. Đến ngày 7/8/2026, lưu lượng từ các agent tự động đã tăng gấp 14 lần so với thời điểm đầu năm, chạm ngưỡng 7,3 nghìn tỷ token tính theo mức trung bình 7 ngày.
Cùng thời điểm đó, mức tiêu thụ của người dùng cá nhân chỉ đạt 1,4 nghìn tỷ token, tương đương mức tăng 2,8 lần. Chênh lệch này khiến tỷ lệ tiêu thụ giữa agent và con người nới rộng lên hơn 5 lần. Giám đốc điều hành hãng phân tích Futurum Group, ông Daniel Newman, đưa ra nhận định trên mạng xã hội X rằng con số này có thể tiếp tục tiến tới mốc 10 lần hoặc cao hơn khi các quy trình tự động hoá đa bước đi sâu vào môi trường doanh nghiệp.
| Thời điểm ghi nhận | Lưu lượng AI Agent (token) | Lưu lượng người dùng (token) | Lưu lượng kết hợp (token) |
|---|---|---|---|
| Tháng 2/2026 (Mốc bắt đầu vượt) | 0,51 nghìn tỷ | 0,50 nghìn tỷ | 0,30 nghìn tỷ |
| Tháng 8/2026 (Mốc bứt phá) | 7,30 nghìn tỷ | 1,40 nghìn tỷ | 1,40 nghìn tỷ |
| Mức độ tăng trưởng | Tăng 14 lần | Tăng 2,8 lần | Tăng 4,7 lần |
Số liệu: Báo cáo phân tích từ a16z và OpenRouter
Bảng đối chiếu cho thấy tốc độ mở rộng lưu lượng của các hệ thống tự động vượt trội hoàn toàn so với mô hình hội thoại thông thường. Người dùng cuối thường dừng lại ở quy trình hỏi đáp đơn lẻ, trong khi một agent xử lý công việc phải chạy qua nhiều vòng lặp, tự kiểm tra mã nguồn, đối chiếu tài liệu và gọi các công cụ ngoại vi trước khi trả về kết quả cuối cùng.
Bóc tách chi phí và áp lực hạ tầng: Bản chất nằm ở KV-cache
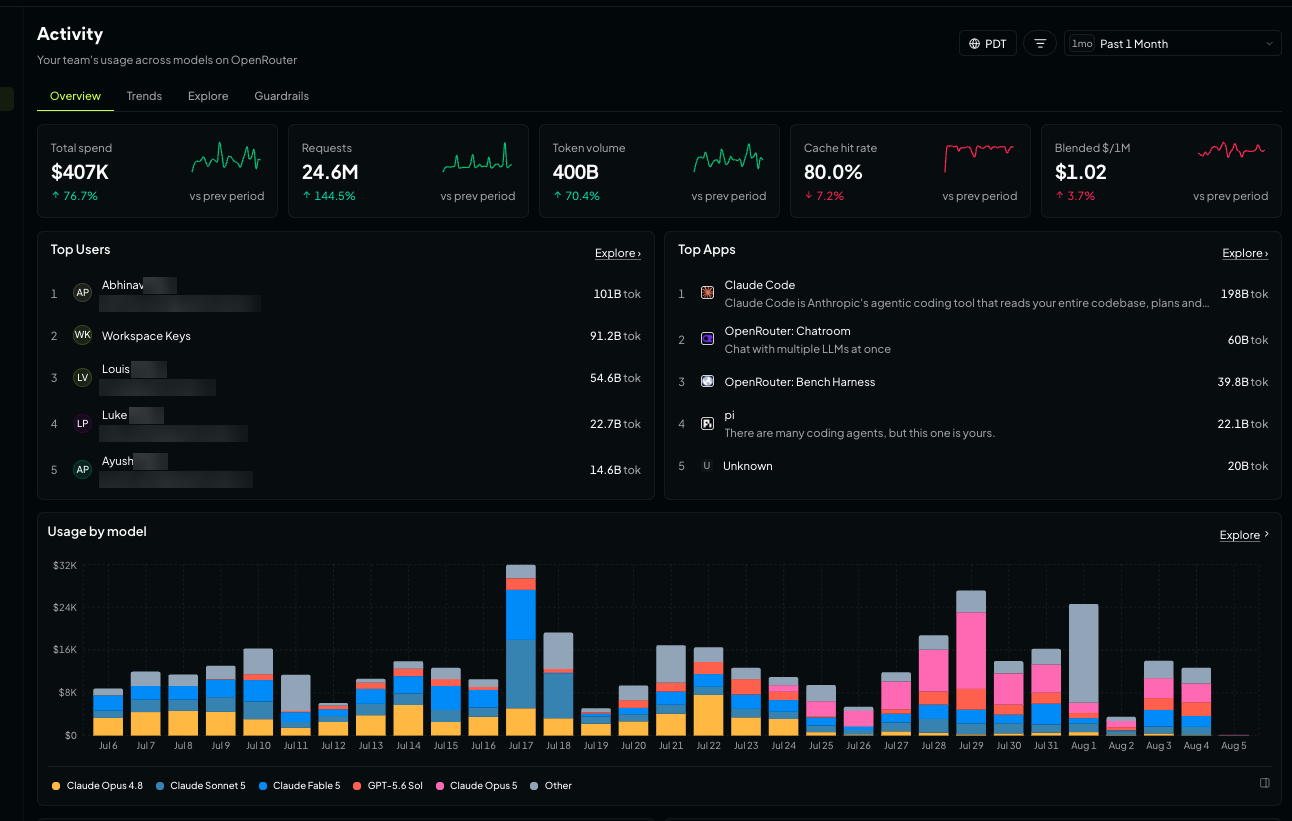
Điểm mấu chốt trong con số 7,3 nghìn tỷ token không nằm ở việc các mô hình phải tính toán suy luận toàn bộ từ đầu. Phân tích của a16z chỉ ra rằng hơn 85% lượng token tiêu thụ từ agent thực chất đến từ các đoạn prompt đã được lưu trong bộ đệm (cached prompt). Khi khởi chạy, agent luôn phải nạp một lượng lớn ngữ cảnh ban đầu gồm quy chuẩn dự án, tài liệu API, hướng dẫn an toàn và lịch sử các bước đã thực hiện. Trong mỗi chu kỳ hành động tiếp theo, phần ngữ cảnh này được đọc lại gần như nguyên vẹn kèm theo một vài dòng lệnh hoặc kết quả công cụ mới.
Hiện tượng này tạo ra hai tác động trái ngược lên hạ tầng kỹ thuật và ngân sách triển khai:
- Về mặt chi phí: Hầu hết các nhà cung cấp nền tảng AI lớn hiện nay đều áp dụng mức giá cho token cache rẻ hơn từ 50% đến 80% so với token nhập liệu thông thường. Do đó, việc lượng token danh nghĩa tăng vọt gấp 5 lần không đồng nghĩa với việc hóa đơn thanh toán của doanh nghiệp cũng nhân lên 5 lần tương ứng.
- Về mặt phần cứng máy chủ: Để duy trì bộ đệm ngữ cảnh (KV-cache) cho hàng nghìn phiên làm việc kéo dài của agent, hệ thống máy chủ suy luận đòi hỏi dung lượng bộ nhớ băng thông cao (HBM) và DRAM rất lớn. Điều này giải thích vì sao nhu cầu mở rộng bộ nhớ tại các trung tâm dữ liệu tiếp tục căng thẳng dù tốc độ sinh token mới của mô hình đã được tối ưu hóa.
Góc nhìn tối ưu cho kỹ sư và doanh nghiệp phát triển AI
Sự bùng nổ của các luồng tác vụ tự hành đòi hỏi các đội ngũ kỹ thuật thay đổi căn bản cách thức quản lý và đo lường chi phí AI. Nếu chỉ quan sát tổng số lượng token tiêu thụ trên bảng điều khiển, doanh nghiệp rất dễ đưa ra những đánh giá sai lệch về hiệu quả đầu tư hoặc vội vã cắt giảm các chu trình tự động hữu ích.
Thay vì đếm token thô, các đơn vị vận hành cần thiết lập hệ thống quan sát sâu theo từng nhiệm vụ cụ thể:
- Tối ưu cấu trúc prompt để tăng cache hit: Đặt các phần nội dung cố định như system prompt, tài liệu hướng dẫn và schema công cụ ở đầu ngữ cảnh, hạn chế thay đổi giữa các lượt gọi API để tận dụng tối đa cơ chế prefix caching của nhà cung cấp.
- Đo lường chi phí trên từng tác vụ hoàn tất: Đơn vị tính toán thực tế phải là số tiền bỏ ra để giải quyết xong một lỗi phần mềm, xử lý một tài liệu hoặc hoàn thành một lượt tổng hợp dữ liệu, thay vì so sánh số token trung bình giữa người và máy.
- Dọn dẹp ngữ cảnh định kỳ: Với các luồng làm việc dài, việc loại bỏ các phản hồi trung gian không còn giá trị khỏi ngữ cảnh giúp giảm tải dung lượng bộ nhớ máy chủ và duy trì độ chính xác của mô hình khi suy luận.
Nguồn tham khảo: Tom’s Hardware, OpenRouter Blog, AI FrontPage