
Tóm tắt nhanh
- MAI-Transcribe-2-Streaming nhận âm thanh liên tục, tạo bản chép lời tạm thời sau hơn 100 ms và hỗ trợ 60 ngôn ngữ.
- Microsoft cho biết mô hình đứng đầu bảng Artificial Analysis ở độ chính xác của cả bản chép lời tạm thời lẫn bản cuối; WER bản cuối được nguồn đối chiếu ghi nhận là 2,5%.
- MAI-Voice-2.1-Flash có độ trễ đầu-cuối 150 ms theo Microsoft. Ghép hai đầu vào-ra có thể giảm phần thời gian chờ của một trợ lý giọng nói, nhưng không quyết định toàn bộ độ trễ.
- Giá khởi điểm của phiên âm là 0,54 USD mỗi giờ âm thanh đến hết năm 2026; đây là giá dịch vụ API, chưa bao gồm các chi phí khác của ứng dụng.
Đưa chữ ra trước khi người dùng nói xong giúp trợ lý có thêm thời gian
Điểm đáng chú ý của MAI-Transcribe-2-Streaming không chỉ là chuyển giọng nói thành chữ nhanh hơn. Mô hình trả về các giả thuyết tạm thời khi âm thanh vẫn đang đến, rồi cập nhật chúng khi có thêm ngữ cảnh và chốt bản ổn định sau đó. Theo Microsoft, partial đầu tiên xuất hiện chỉ hơn 100 mili-giây sau khi nhận âm thanh.
Cách làm này thay đổi thời điểm phần mềm có thể bắt đầu xử lý yêu cầu. Một trợ lý có thể nhận diện ý định sơ bộ, chuẩn bị gọi công cụ hoặc tìm dữ liệu trong lúc người gọi vẫn đang nói, thay vì đợi hết câu mới khởi động. Đổi lại, ứng dụng phải biết phân biệt văn bản tạm với kết quả đã chốt: nếu hành động không thể đảo ngược được kích hoạt từ một partial sai, trải nghiệm sẽ tệ hơn việc chờ thêm một nhịp.
Con số độ trễ chỉ có ý nghĩa khi tính cả vòng hội thoại
Một cuộc trò chuyện bằng giọng nói đi qua nhiều công đoạn: thu âm, nhận dạng, suy luận, truy xuất hoặc gọi công cụ, rồi tổng hợp tiếng trả lời. Tăng tốc riêng khâu phiên âm không bảo đảm câu trả lời đến nhanh nếu mô hình suy luận hoặc hệ thống phía sau vẫn mất nhiều thời gian.
Microsoft ghép câu chuyện phiên âm với MAI-Voice-2.1-Flash, mô hình chuyển văn bản thành tiếng nói mà hãng công bố có thể tạo 45 giây âm thanh với độ trễ đầu-cuối 150 ms. Hai con số này không nên cộng hoặc so trực tiếp như một phép đo hoàn chỉnh của voice agent: chúng mô tả các thành phần và điều kiện riêng, còn độ trễ thực tế phụ thuộc vào mạng, độ dài đầu vào, suy luận và cách ứng dụng xử lý partial.
Vì vậy, lợi ích kỹ thuật nằm ở ngân sách thời gian được giải phóng ở hai đầu cuộc hội thoại. Nhà phát triển có thể dùng một phần thời gian đó cho kiểm tra câu trả lời hay gọi công cụ, thay vì chỉ tối ưu để máy nói thật nhanh. Đây là hướng tiếp cận hữu ích cho tổng đài và trợ lý cần phản hồi tự nhiên, nhưng muốn xác nhận chất lượng vẫn phải đo toàn bộ luồng bằng kịch bản thực tế.
WER thấp là điểm khởi đầu, không phải bảo đảm cho mọi cuộc gọi
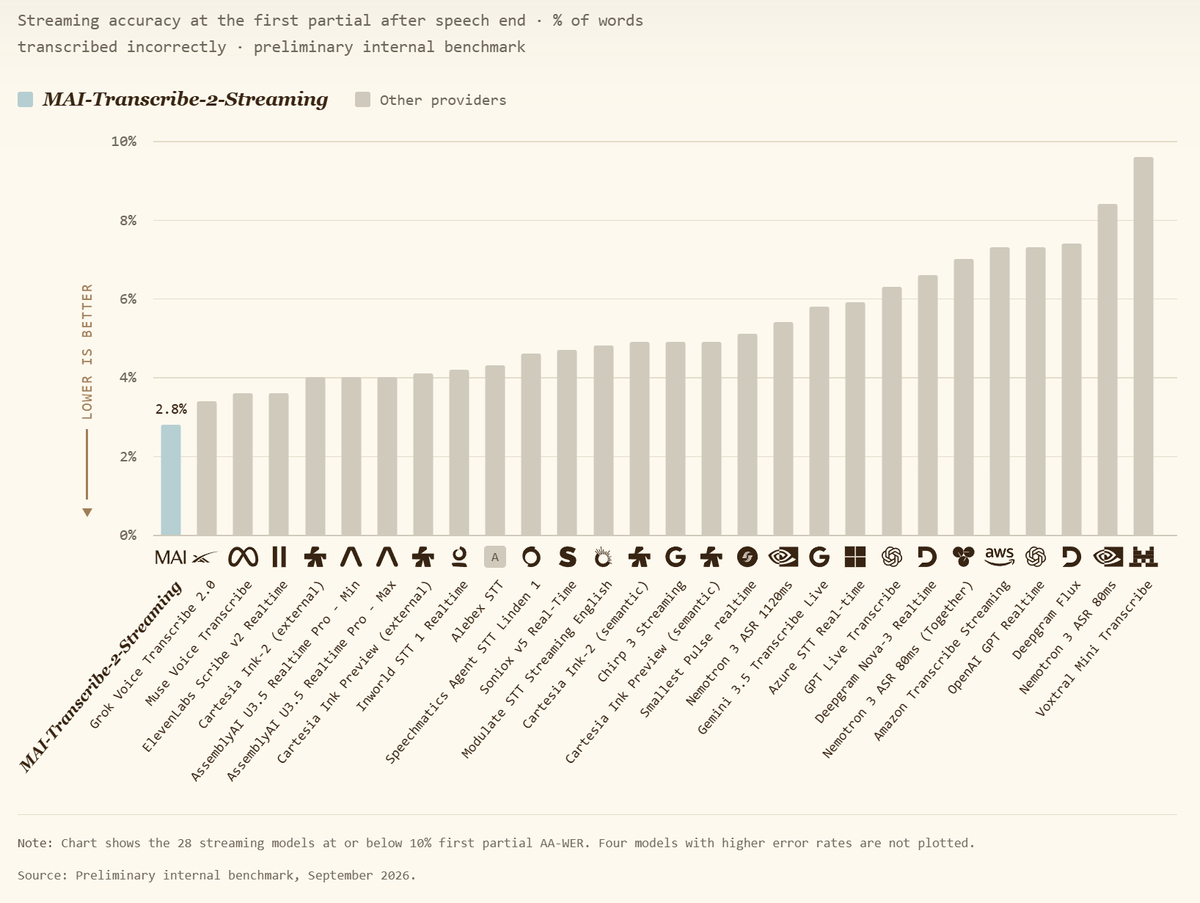
Artificial Analysis xếp mô hình ở vị trí đầu về độ chính xác của cả bản cuối và bản tạm. Bảng được Unite.AI dẫn lại ghi WER 2,5% cho bản cuối và 2,8% cho partial đầu tiên; WER càng thấp thì tỷ lệ từ bị nhận sai hoặc bỏ sót càng nhỏ trong tập đánh giá đó. Microsoft cũng nêu thời điểm chữ xuất hiện thường sớm nhất khoảng 320 ms, so với hơn 500 ms ở đối thủ gần nhất trong phần lớn trường hợp.
Các kết quả này cho thấy mô hình hướng tới cân bằng giữa độ chính xác và phản hồi sớm, nhưng không thay thế kiểm thử theo miền dữ liệu. Tên riêng, tiếng lóng, âm thanh nền, chất lượng micro và cách người dùng đổi ngôn ngữ đều có thể làm kết quả khác đi. Do đó, doanh nghiệp nên đánh giá trên mẫu cuộc gọi của chính mình, nhất là các câu chứa mã đơn hàng, địa chỉ hoặc thuật ngữ chuyên ngành.
Hỗ trợ 60 ngôn ngữ cần được kiểm tra riêng với tiếng Việt
Microsoft công bố nhận dạng liên tục 60 ngôn ngữ cùng tính năng tự phát hiện ngôn ngữ. Đây là nền tảng đáng quan tâm với dịch vụ đa ngôn ngữ, nhưng số lượng ngôn ngữ hỗ trợ không tự nói lên độ chính xác của từng ngôn ngữ, giọng vùng miền hay hội thoại trộn tiếng Việt với tiếng Anh.
Với doanh nghiệp Việt Nam, bài toán triển khai nên bắt đầu từ bộ dữ liệu đại diện: giọng Bắc, Trung, Nam; tiếng ồn ở môi trường tổng đài; tên thương hiệu và thuật ngữ thường gặp. Mức giá giới thiệu 0,54 USD mỗi giờ âm thanh tương đương khoảng 13.800 đồng theo tỷ giá quy đổi, nhưng chi phí vận hành còn tùy thời lượng âm thanh được gửi lên, hạ tầng và các dịch vụ bổ sung. Đây là API đám mây cho nhà phát triển, không phải giá bán một sản phẩm phần cứng.
Chi phí phiên âm thấp chưa đủ để kết luận tổng đài AI rẻ
Ở mức giá Microsoft công bố, riêng khâu phiên âm có cách tính dễ dự toán theo giờ âm thanh. Hai mô hình giọng nói được niêm yết theo ký tự: MAI-Voice-2.1 ở 22 USD mỗi triệu ký tự và bản Flash ở 15 USD mỗi triệu ký tự. Mức giá giới thiệu cho phiên âm được Microsoft áp dụng đến hết năm 2026.
So sánh chi phí giữa các hệ thống cần đưa cả lượt tổng hợp tiếng nói, suy luận mô hình, lưu trữ, kết nối tổng đài và thời gian nhân viên xử lý các trường hợp chuyển tiếp vào cùng phép tính. Giá đầu vào cạnh tranh có thể làm thử nghiệm ban đầu dễ tiếp cận hơn, nhưng hiệu quả kinh doanh chỉ rõ khi tính trên một yêu cầu được giải quyết thành công, không phải chỉ trên một giờ âm thanh.
Với nhóm xây dựng trợ lý thoại, điều đáng theo dõi là khả năng phối hợp giữa partial, suy luận và phản hồi âm thanh trong điều kiện mạng thật. Microsoft đã đưa ra các thành phần để xây dựng vòng hội thoại nhanh hơn; bước còn lại là chứng minh chúng giữ được độ chính xác và chi phí dự đoán được trên tiếng Việt cùng quy trình cụ thể của từng doanh nghiệp.
Nguồn tham khảo: Microsoft AI; Azure AI Foundry; Unite.AI