
Tóm tắt nhanh
- Đừng quyết định mua Mac mini chạy AI chỉ dựa trên giá khởi điểm hay tốc độ sinh token (tok/s) lý thuyết.
- Mac mini M6 tại Việt Nam có giá từ 24.999.000 đồng; cấu hình M6 tối đa 32 GB bộ nhớ thống nhất, còn M5 Pro tối đa 64 GB.
- Apple công bố Mac mini M6 có băng thông bộ nhớ 170 GB/s (M5 Pro đạt 307 GB/s); các con số benchmark và chi phí nâng cấp RAM cần được đối chiếu thực tế với nhu cầu model cụ thể.
- Trước khi mua, hãy xác định model, lượng RAM thực dùng, độ dài ngữ cảnh và đo cả thời gian chờ token đầu tiên lẫn tốc độ sinh.
Khi cân nhắc đầu tư Mac mini để chạy các mô hình ngôn ngữ lớn (LLM) cục bộ, câu hỏi thực tế nhất là: mua máy theo cấu hình tối đa có thực sự giúp chạy AI tốt hơn, hay chỉ khiến chi phí đội lên không cần thiết? Để chọn máy chuẩn xác, người dùng cần nắm rõ các giới hạn phần cứng thực tế, phân biệt tốc độ sinh token lý thuyết với thời gian phản hồi thực sự, cũng như đối chiếu trực tiếp với các thông số kiến trúc do Apple công bố.
Giá khởi điểm không nói được model nào vừa bộ nhớ
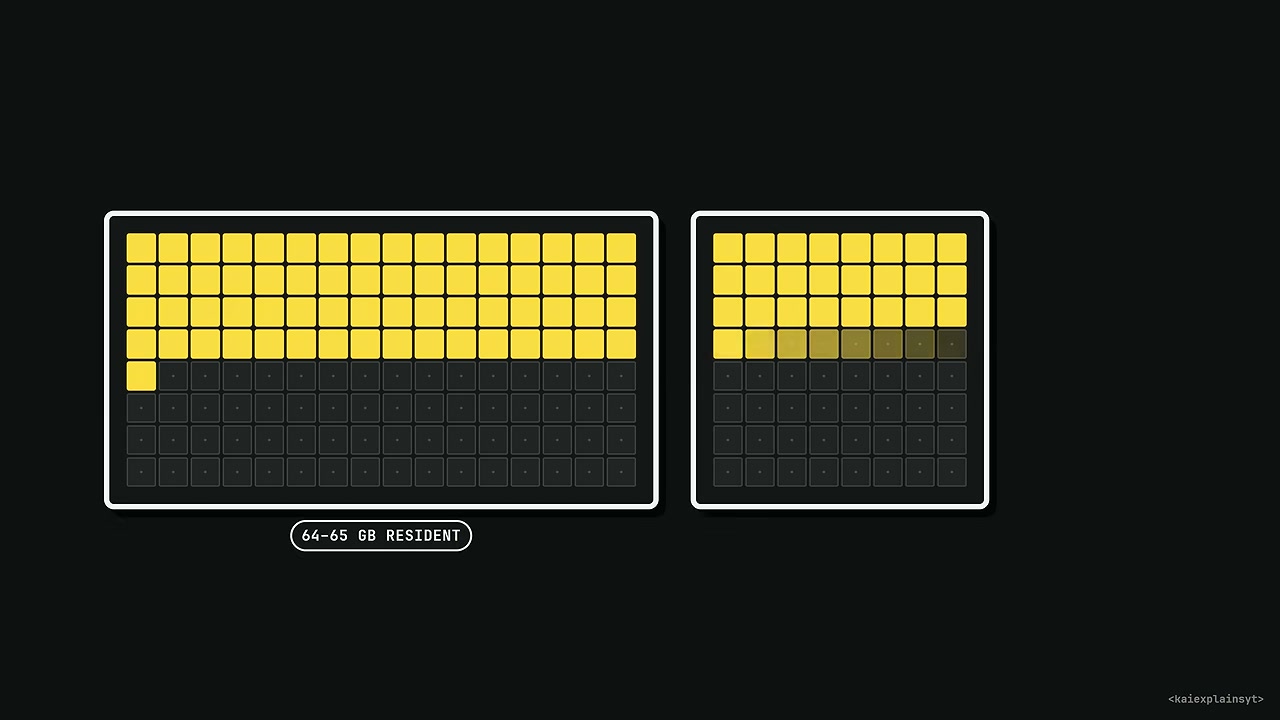
Với mô hình ngôn ngữ chạy tại máy, RAM thống nhất là giới hạn cứng trước khi tốc độ trở thành vấn đề. Nếu trọng số đã chiếm gần hết bộ nhớ khả dụng, hệ điều hành và KV cache cho lịch sử hội thoại sẽ làm phần còn lại càng chật. Một cấu hình có giá thấp vì vậy không mặc nhiên là lựa chọn phù hợp; ngược lại, mua mức RAM cao nhất khi chưa biết model cần chạy cũng dễ biến khoản đầu tư thành phần dự phòng không dùng tới.
Apple Newsroom Việt Nam công bố Mac mini M6 giá từ 24.999.000 đồng, với bộ nhớ thống nhất 16 GB tiêu chuẩn và cấu hình tối đa 32 GB. Mac mini M5 Pro có giá từ 47.999.000 đồng, cấu hình bộ nhớ tối đa 64 GB. Đây là giá Apple công bố tại Việt Nam; mức giá thực tế và tùy chọn cấu hình ở đại lý có thể khác. Chênh lệch giữa hai dòng máy đáng kể, nên câu hỏi đầu tiên không phải “máy nào mạnh hơn” mà là “model cụ thể mình dùng cần bao nhiêu bộ nhớ, kể cả phần dành cho ngữ cảnh?”.
Tại thị trường quốc tế, mức giá niêm yết chênh lệch rất lớn giữa bản tiêu chuẩn và các cấu hình mở rộng bộ nhớ cao cấp. Tuy nhiên, khi quy đổi và tính toán bài toán đầu tư tại Việt Nam, người dùng cần tính trực tiếp trên chi phí cấu hình cụ thể thay vì các phép tính dự báo giá linh kiện thiếu cơ sở kiểm chứng.
Chênh lệch băng thông có ý nghĩa, nhưng không thay thế phép thử
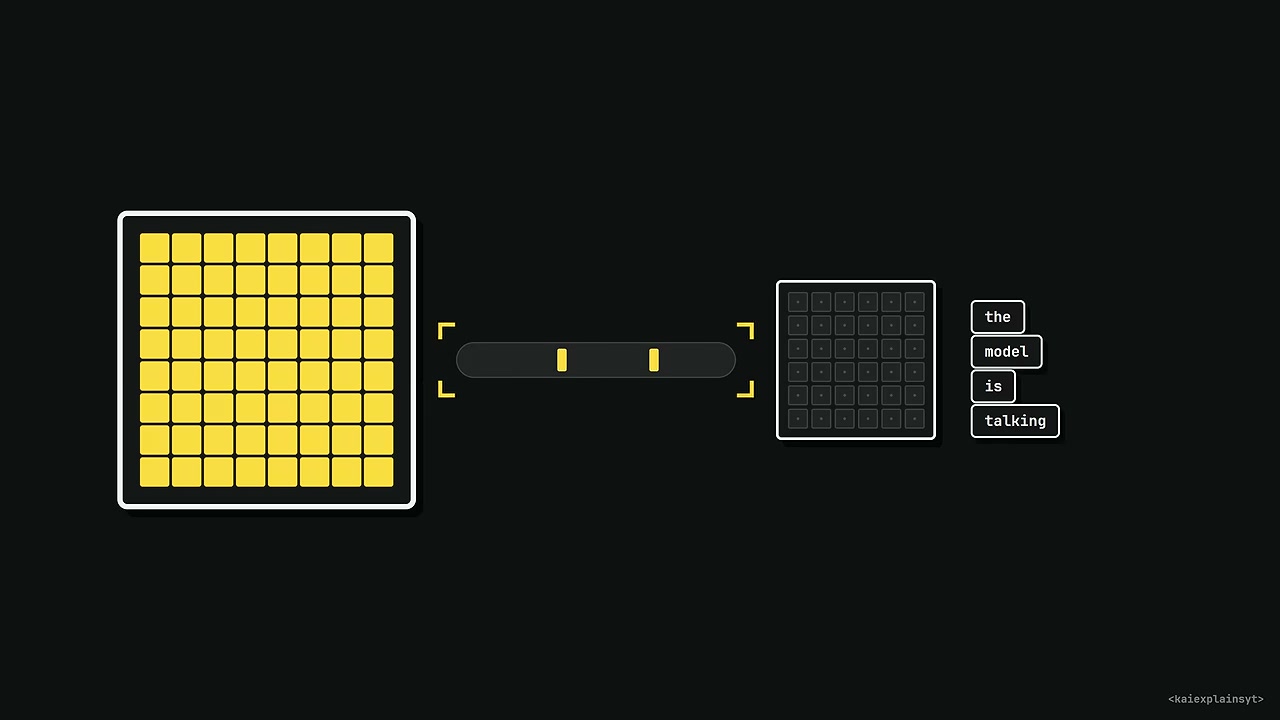
Băng thông bộ nhớ ảnh hưởng rõ đến tốc độ sinh từng token sau khi mô hình đã đọc prompt. Apple Machine Learning Research phân biệt giai đoạn tạo token đầu tiên với các token tiếp theo: giai đoạn đầu chịu ảnh hưởng lớn từ tính toán trên prompt, còn decode thường phụ thuộc băng thông bộ nhớ. Vì vậy, một máy có băng thông cao hơn có thể sinh câu trả lời nhanh hơn trong một số điều kiện, nhưng không có nghĩa toàn bộ trải nghiệm sẽ nhanh gấp đôi.
Theo công bố chính thức từ Apple, chip M6 sở hữu băng thông bộ nhớ tối đa 170 GB/s, trong khi M5 Pro đạt mức 307 GB/s (thay vì các số liệu đo lường không chuẩn xác ở mức 153 GB/s thường thấy ở một số thử nghiệm ban đầu). Apple cũng ghi nhận trong LM Studio: M6 nhanh tối đa 4,8 lần so với M4, còn M5 Pro nhanh tối đa 4 lần so với M4 Pro. Dù vậy, đây là kết quả trong điều kiện thử nghiệm tiêu chuẩn của hãng, không thể suy rộng thành mức tăng đồng đều cho mọi framework, backend hay độ dài prompt thực tế.
Điều cần mang theo từ phần này không phải là “chọn chip Pro bằng mọi giá”, mà là kiểm tra cả dung lượng lẫn băng thông trên đúng model và phần mềm. Một cấu hình có băng thông cao nhưng không đủ RAM cho trọng số và KV cache vẫn không giải quyết được giới hạn chính.
Tok/s cao không đồng nghĩa câu trả lời bắt đầu nhanh
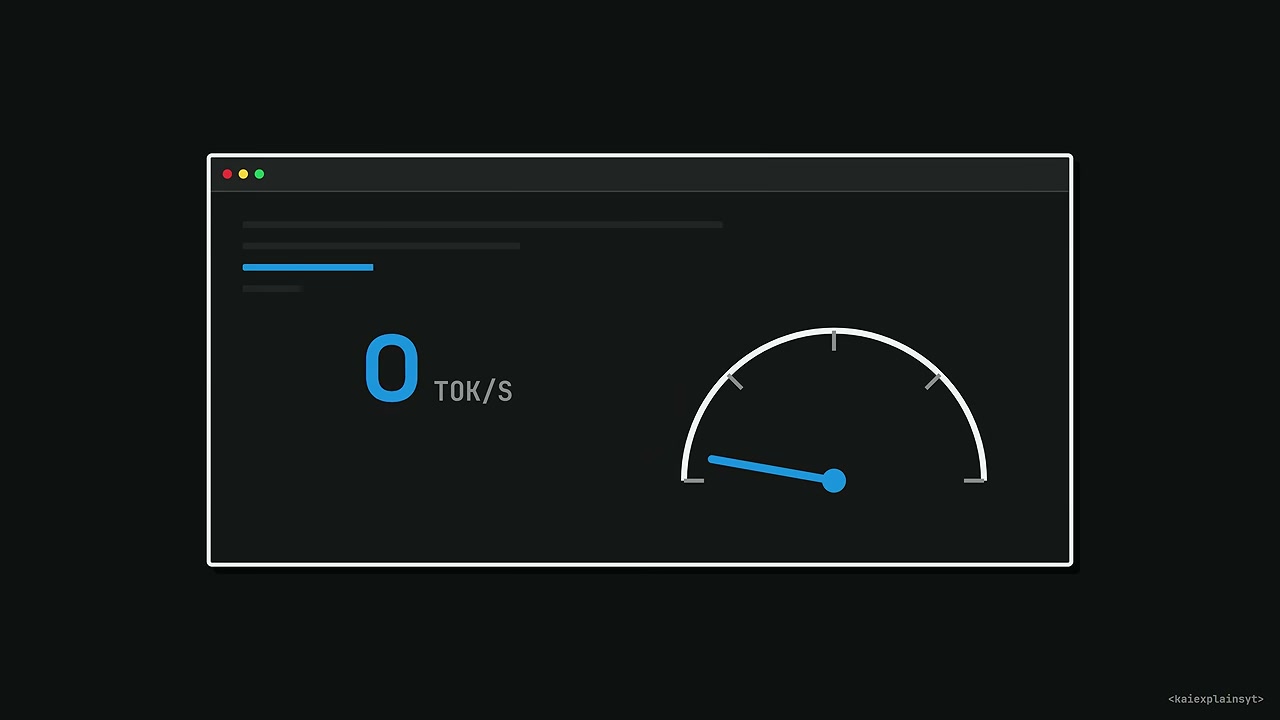
Chỉ nhìn vào tốc độ sinh token (decode) có thể che khuất hoàn toàn độ trễ thực tế trước khi mô hình bắt đầu đưa ra phản hồi. Trên thực tế, ở ngữ cảnh dài (ví dụ 8.000 token), một hệ thống dù hiển thị tốc độ decode đạt 57 tok/s nhưng tốc độ đầu-cuối thực tế có thể tụt xuống chỉ còn khoảng 3 tok/s do thời gian prefill chiếm phần lớn. Thậm chí việc tối ưu inference server có thể giúp rút ngắn thời gian xử lý prefill từ hàng chục giây xuống dưới 2 giây. Điểm mấu chốt là người dùng cần đo lường cả độ trễ toàn trình thay vì chỉ nhìn vào một con số sinh từ đơn lẻ.
Prefill là lúc hệ thống xử lý prompt trước khi hiện token đầu tiên; decode là lúc các token tiếp theo lần lượt được sinh ra. Với prompt dài, người dùng có thể phải chờ lâu dù con số tok/s sau đó trông ấn tượng. Apple ML Research công bố thử nghiệm MLX với prompt 4.096 token và sinh 128 token, đồng thời tách thời gian tạo token đầu tiên khỏi tốc độ sinh tiếp theo. Phép đo như vậy cho bối cảnh rõ hơn một con số tốc độ đơn lẻ, dù kết quả trên cấu hình thử nghiệm của Apple không bảo đảm sẽ giống trên Mac mini hay backend khác.
Nếu đang dùng máy hiện có, hãy ghi riêng thời gian từ lúc gửi prompt đến token đầu tiên, tốc độ decode sau đó, độ dài prompt/context, model và quantization, phiên bản backend cùng cấu hình máy. Đổi backend có thể là thử nghiệm chi phí thấp hơn mua thêm RAM, nhưng chỉ kết luận sau khi chạy lại cùng model và cùng prompt; nếu thay nhiều biến cùng lúc, không biết phần nào tạo ra khác biệt.
Kiến trúc MoE giúp tối ưu tốc độ, nhưng RAM vẫn là giới hạn cứng
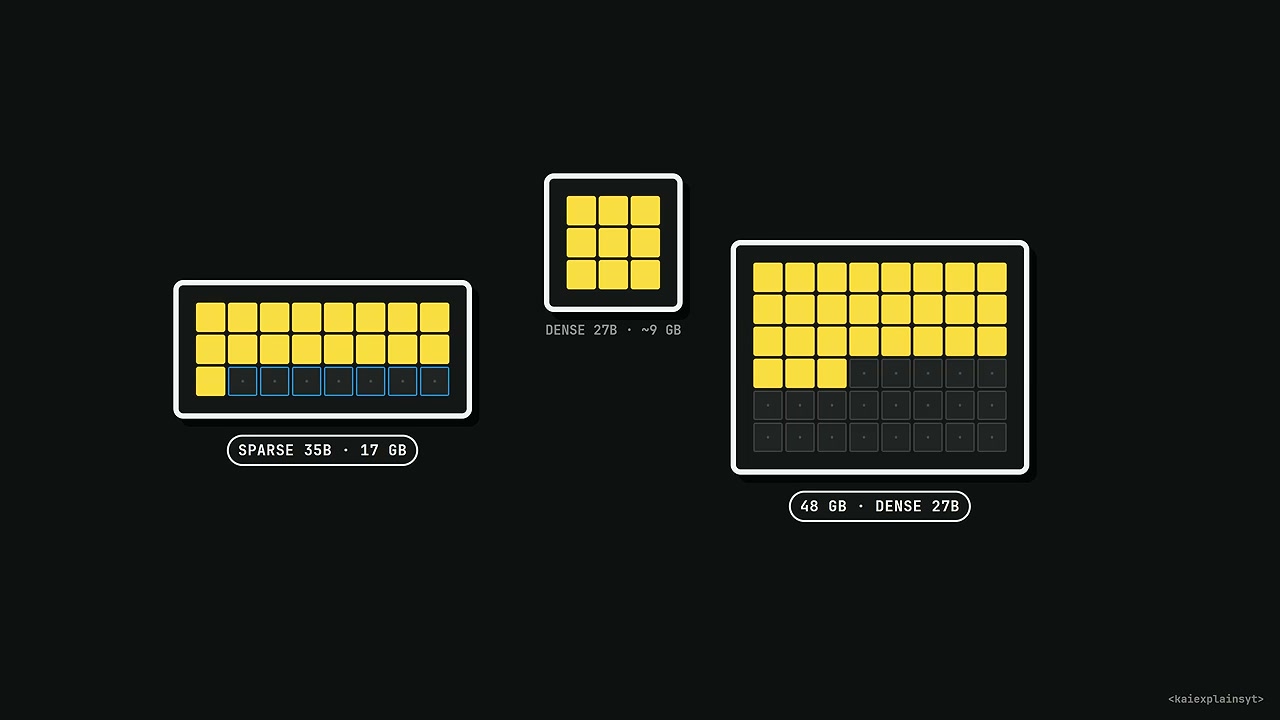
Mixture of Experts (MoE) là kiến trúc sparse: mỗi token chỉ kích hoạt một phần chuyên gia trong mô hình, thay vì dùng toàn bộ tham số như một mô hình dense tương ứng. Cách tổ chức này có thể giảm lượng tính toán trên mỗi token, nhưng không có nghĩa toàn bộ trọng số không hoạt động biến mất khỏi bộ nhớ. Dung lượng model, KV cache, cách triển khai và backend vẫn quyết định máy có tải được model hay không.
Khi so sánh thực tế trên các dòng Apple Silicon, mô hình MoE (ví dụ cấu trúc sparse 35 tỷ tham số kích hoạt một phần) có thể đạt tốc độ sinh token cao hơn đáng kể (lên tới 78 tok/s) so với mô hình dense 27 tỷ tham số (khoảng 14,7 tok/s) cùng ở mức lượng tử hóa 4-bit. Dù vậy, kích thước trọng số của mô hình sparse vẫn chiếm dung lượng đáng kể (khoảng 17 GB so với 9 GB của dense), đồng nghĩa với việc yêu cầu bộ nhớ RAM thực tế vẫn là bài toán tiên quyết trước khi tính đến lợi thế tốc độ.
Apple ML Research có một ví dụ có thể kiểm tra điều kiện rõ hơn: Qwen3-30B-A3B-MLX-4bit có memory footprint 17,31 GB trong bảng thử nghiệm của hãng; bài viết dùng 4.096 token prompt và 128 token sinh. Con số đó cho thấy ngay một model quantization 4-bit vẫn có thể chiếm phần đáng kể bộ nhớ 16 GB, nhưng footprint model không phải tổng mức sử dụng hệ thống. Cần thêm chỗ cho hệ điều hành, runtime và cache; độ dài context càng lớn thì phần dự phòng càng quan trọng.
Chọn cấu hình theo model đã thử, không theo viễn cảnh nâng cấp
Nhiều khuyến nghị phổ biến thường hướng người dùng đến cấu hình M6 32 GB cho nhu cầu cơ bản và M5 Pro 64 GB cho các model lớn hơn. Tuy nhiên, dữ liệu thử nghiệm độc lập thực tế từ các nhà phát triển (như Kunal Ganglani trên macOS Sequoia, Ollama và llama.cpp) cho thấy: với model Mistral 7B Q4_K_M, chip tiêu chuẩn đạt khoảng 35 tok/s trong khi bản Pro đạt 62 tok/s. Điều này chứng minh hiệu năng chênh lệch tỉ lệ thuận với băng thông, nhưng không phải mọi nhu cầu đều đòi hỏi phải chi gấp đôi ngân sách.
Ở Việt Nam, mức khởi điểm chính thức 24.999.000 đồng của M6 là mốc cần cân nhắc cùng cấu hình bộ nhớ tối đa 32 GB, trong khi M5 Pro bắt đầu từ 47.999.000 đồng và tối đa 64 GB. Nếu model thường dùng vừa trong cấu hình thấp hơn, chạy ổn với context mong muốn và thời gian phản hồi chấp nhận được, chi thêm cho RAM không tự động đem lại giá trị tương xứng. Nếu model đã chọn cần dung lượng lớn hơn mức máy có thể cấu hình, Mac mini không phải lựa chọn phù hợp chỉ vì kích thước nhỏ hoặc giá cơ bản hấp dẫn.
Trước khi mua, hãy thử chính model và cách lượng tử hóa dự định dùng trên phần cứng tương đương, hoặc thuê dịch vụ máy chủ một tháng nếu cần so sánh trải nghiệm cloud với local. Xác định rõ dữ liệu có bắt buộc ở lại thiết bị hay không, prompt thường dài bao nhiêu và mức trễ token đầu tiên có ảnh hưởng đến công việc không. Với yêu cầu riêng tư nghiêm ngặt, chạy local có lợi thế kiểm soát luồng dữ liệu; nhưng cần tính cả chi phí máy và giới hạn năng lực, thay vì mặc định local luôn rẻ hơn.
Mac mini có thể là máy chạy AI cục bộ hợp lý khi model, bộ nhớ và cách sử dụng đã được thử trước. Điều đáng tránh là mua máy theo các con số lý thuyết hoặc nâng RAM tối đa cho nhu cầu chưa được kiểm chứng. Hãy đo thời gian phản hồi đầu-cuối, kiểm tra mức dùng bộ nhớ với context thật, rồi mới chọn cấu hình.
Nguồn tham khảo: Kai Explains – Don’t Buy a Mac Mini For Local AI (Do This); Apple Newsroom Việt Nam – Mac mini M6 và M5 Pro; Apple Machine Learning Research – Exploring LLMs with MLX; Kunal Ganglani – Mac mini M4 vs M4 Pro.