
Tóm tắt nhanh
- GPU 8GB có thể chạy một số mô hình cỡ vừa nếu dùng bản lượng tử hóa và chọn mức GPU Offload phù hợp; đây không phải cách chạy mọi mô hình flagship ở tốc độ cao.
- Qwen 3.5 9B Q4_K_M, Gemma 4 E4B và LFM2.5 1.2B có thể chia nhau việc xử lý văn bản dài, hình ảnh/câu hỏi nhanh và tra cứu web.
- Trong thử nghiệm được XDA-Developers mô tả, Qwen giảm từ khoảng 20 xuống 9 token/giây khi phần tính toán vượt VRAM và phải dùng CPU/RAM hệ thống.
- Nén KV Cache xuống q8_0 và giới hạn ngữ cảnh giúp tiết kiệm bộ nhớ, nhưng kết quả phụ thuộc model, backend và phần cứng cụ thể.
Giới hạn 8GB không biến mất; cách phân bổ bộ nhớ mới là thứ thay đổi
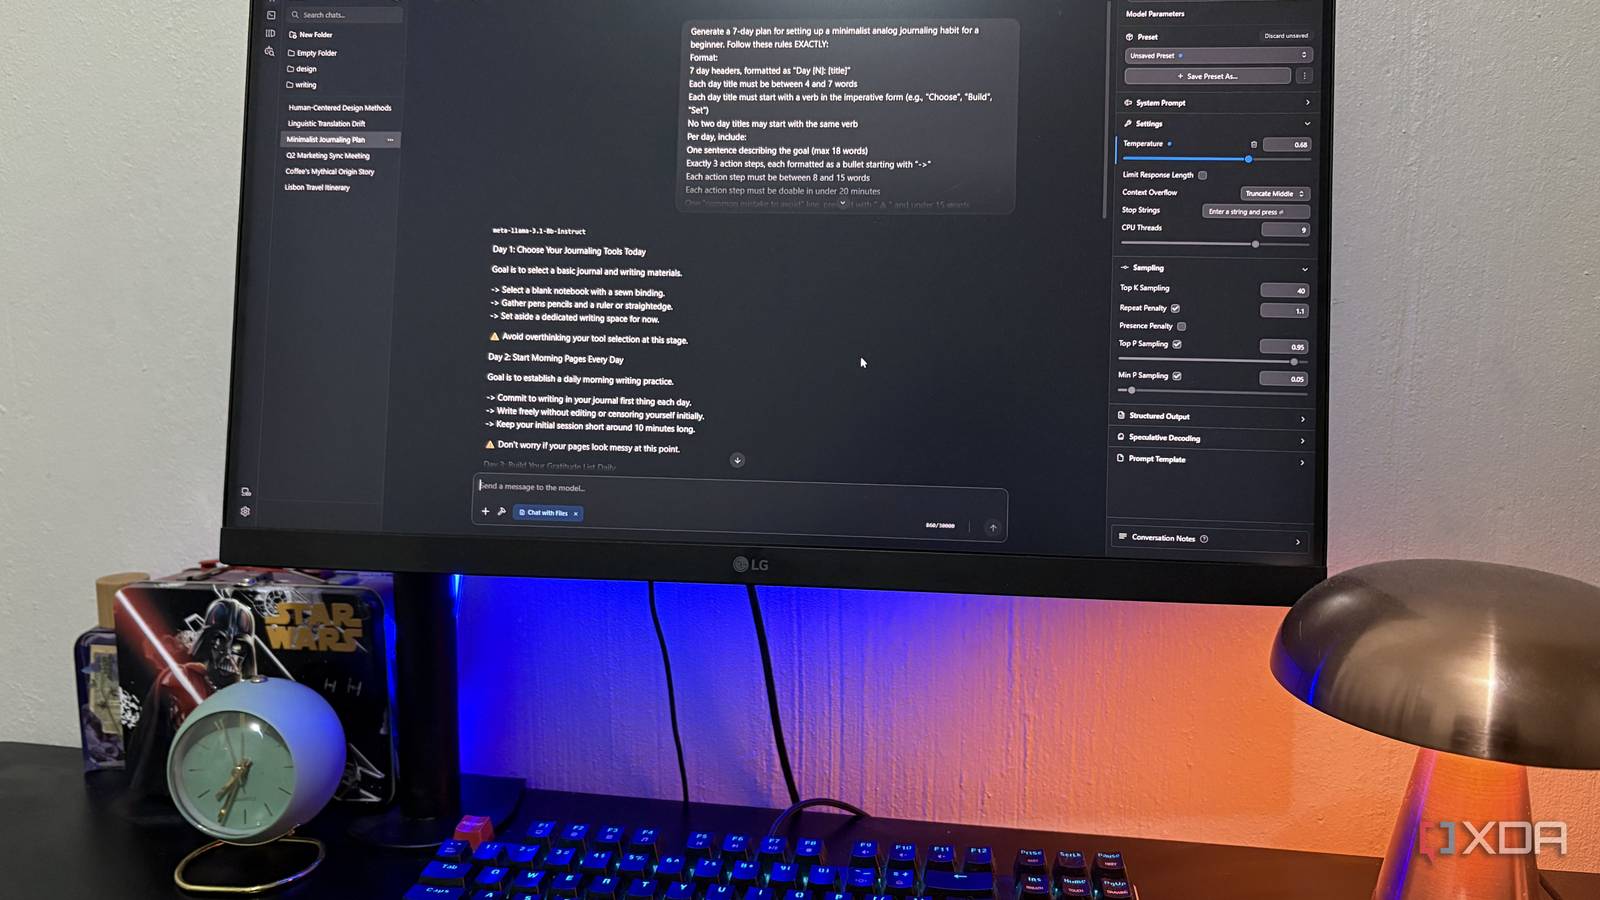
Chạy AI cục bộ trên card đồ họa 8GB không đồng nghĩa có thể nạp bất kỳ mô hình lớn nào rồi dùng như dịch vụ đám mây. VRAM phải chứa trọng số mô hình, KV Cache của hội thoại và phần bộ nhớ dành cho hệ thống đồ họa. Khi tổng nhu cầu vượt dung lượng, một phần lớp tính toán có thể chuyển sang RAM và CPU; mô hình vẫn chạy, nhưng tốc độ thường giảm đáng kể.
Điểm hữu ích trong quy trình mà XDA-Developers mô tả không phải một thủ thuật khiến 8GB tương đương card 24GB. Đó là ghép lượng tử hóa với thiết lập nạp hợp lý, sau đó phân việc cho các mô hình nhỏ thay vì đòi một mô hình duy nhất xử lý mọi thứ. Với người đã có RTX 4060 8GB, cách này đáng thử trước khi bỏ tiền nâng cấp chỉ vì muốn thử nghiệm AI cá nhân.
GPU Offload và KV Cache quyết định mô hình chạy nhanh hay ì ạch
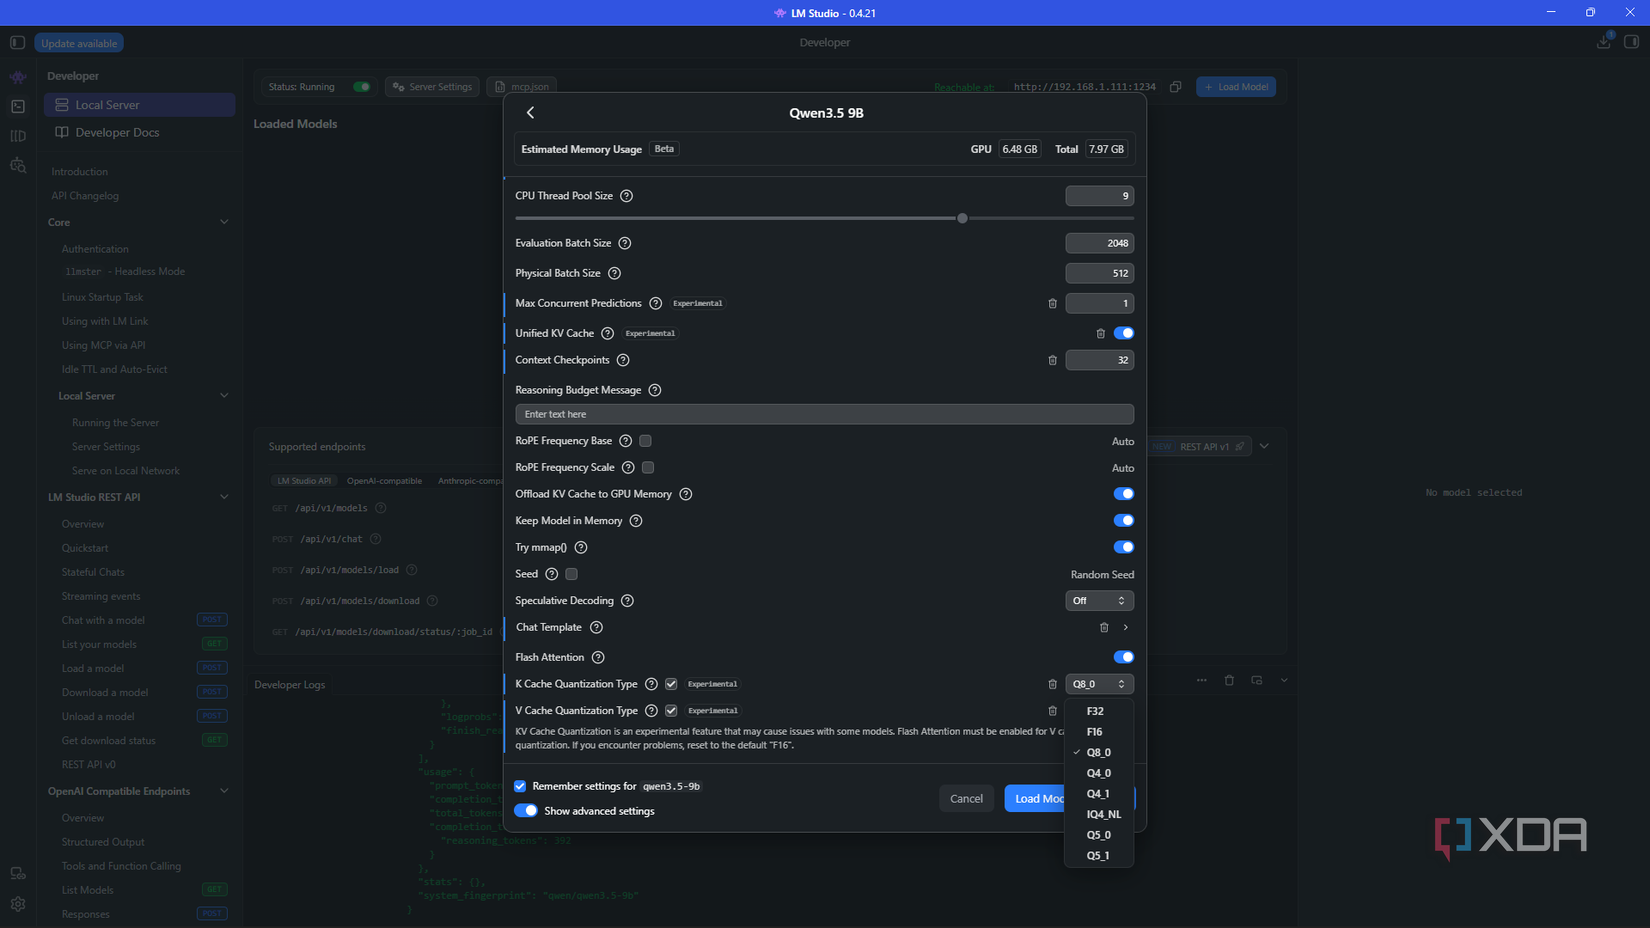
GPU Offload xác định bao nhiêu lớp của mô hình được xử lý trên GPU. Đẩy được nhiều lớp lên GPU thường tăng tốc, nhưng chỉ khi các lớp cùng những vùng nhớ cần thiết còn vừa trong VRAM. Trong phép thử của XDA-Developers, tốc độ Qwen giảm từ khoảng 20 token/giây xuống 9 token/giây sau khi cấu hình vượt ngưỡng bộ nhớ GPU. Con số này là kết quả trên máy thử của tác giả, không phải mức cố định cho mọi card.
KV Cache lưu trạng thái cần thiết để mô hình tiếp tục xử lý ngữ cảnh. Hội thoại hoặc tài liệu càng dài thì phần nhớ này càng lớn. XDA cho biết chuyển K Cache và V Cache sang q8_0 giảm gần một nửa bộ nhớ cache so với định dạng mặc định trong cấu hình họ thử; chất lượng suy giảm đủ nhỏ để tác giả chấp nhận. Đây là lựa chọn đánh đổi, không phải bảo đảm rằng mọi mô hình đều không mất chất lượng.
Định dạng Q4_K_M cũng thu nhỏ trọng số để mô hình vừa với bộ nhớ hạn chế. Nhưng lượng tử hóa thấp hơn có thể ảnh hưởng chất lượng, còn việc dồn quá nhiều lớp sang CPU làm chậm phản hồi. Nên bắt đầu bằng cách kiểm tra ước tính bộ nhớ của LM Studio, giảm GPU Offload hoặc context length từng bước, rồi thử chính tác vụ mình định dùng thay vì mặc định rằng mức tối đa là tốt nhất.
| Thành phần | Ảnh hưởng chính | Cách cân chỉnh |
|---|---|---|
| Lượng tử hóa trọng số | Giảm bộ nhớ mô hình; có thể tác động chất lượng | Thử bản Q4_K_M trước, đánh giá bằng tác vụ thực tế |
| GPU Offload | Nhiều lớp trên GPU có thể nhanh hơn; vượt VRAM thì phần còn lại sang CPU/RAM | Giữ mức vừa dung lượng, quan sát tốc độ và bộ nhớ ước tính |
| Context length | Ngữ cảnh dài làm KV Cache tăng | Chỉ đặt đủ dài cho công việc, không để quá cao mặc định |
| K/V Cache quantization | q8_0 có thể giảm đáng kể phần nhớ cache | So sánh chất lượng đầu ra trước và sau khi bật |
Thông tin hiệu năng và thiết lập: thử nghiệm của XDA-Developers; các tùy chọn Unified KV Cache và xử lý yêu cầu song song được LM Studio mô tả trong tài liệu phiên bản 0.4.0.
Chọn mô hình theo việc cần làm thay vì săn một mô hình vạn năng
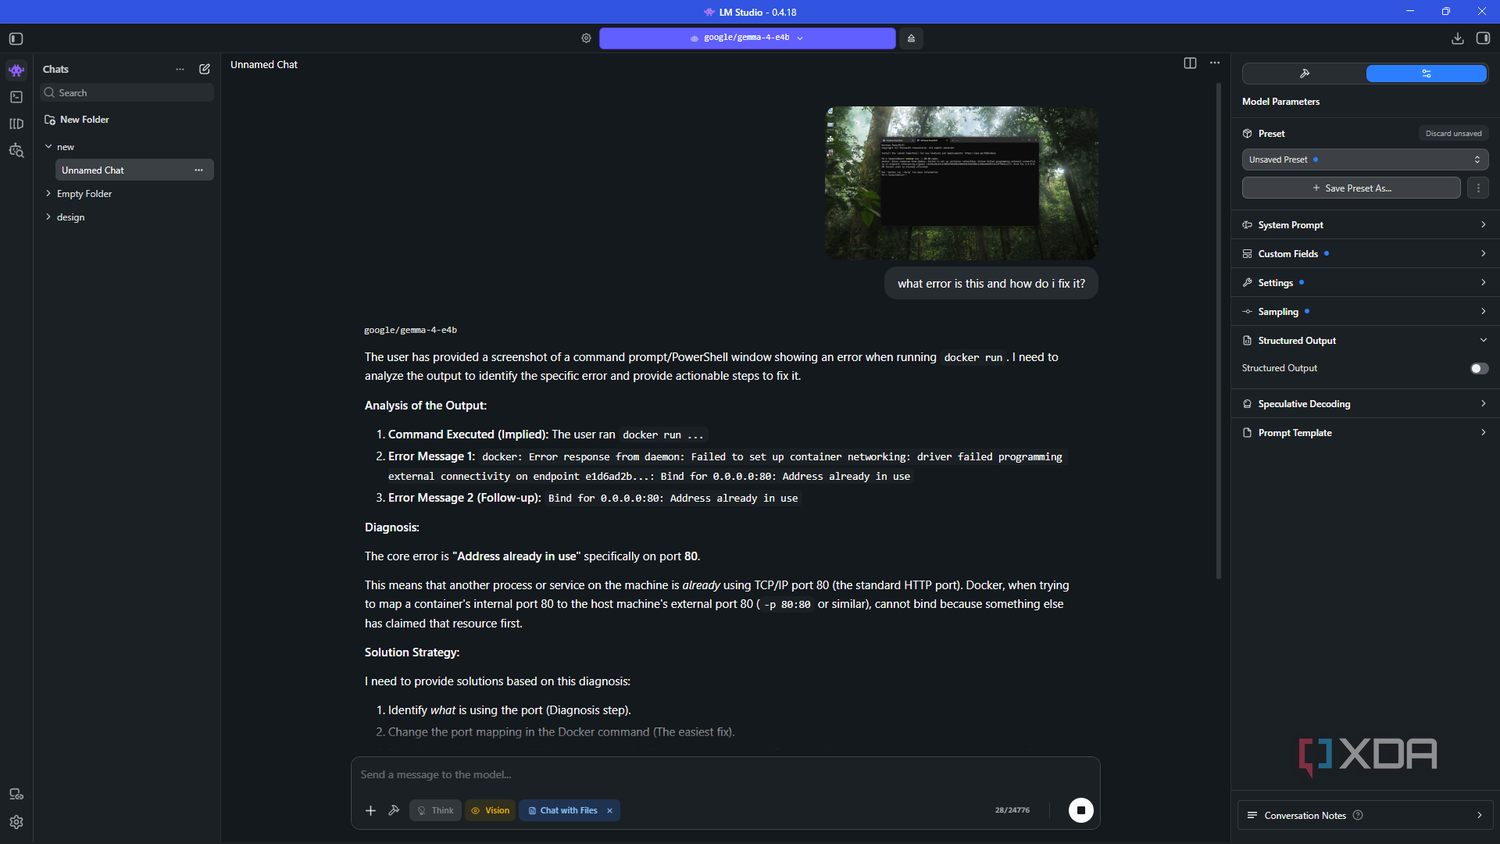
Với cấu hình được XDA mô tả, Qwen 3.5 9B Q4_K_M là mô hình chính cho văn bản dài, công việc liên quan tệp và tác vụ gần với lập trình. Tác giả cho biết 8 trong 32 lớp của mô hình giữ KV Cache tăng theo ngữ cảnh; nhờ đặc điểm đó, họ có thể dùng ngữ cảnh khoảng 20.000–40.000 token thường xuyên và đẩy lên gần 60.000 khi máy rảnh. Đây là trải nghiệm trên cấu hình cụ thể, không nên xem như dung lượng đảm bảo trên tất cả máy 8GB.
Gemma 4 E4B Q4_K_M phù hợp hơn cho câu hỏi nhanh và xử lý ảnh/âm thanh theo ghi nhận trong bài thử. Mức tối đa khoảng 70 token/giây cũng là kết quả được nêu cho cấu hình và tải công việc của tác giả, không phải benchmark chuẩn để so sánh mọi GPU. Mô hình nhỏ LFM2.5 1.2B Instruct được dùng riêng cho gọi Brave Search; tác giả nhận xét nó làm việc này ổn, nhưng không phù hợp khi cần tạo tài liệu học tập có cấu trúc.
Cách phân vai này giảm nhu cầu giữ một mô hình nặng làm mọi tác vụ. Đổi lại, người dùng phải chọn model đúng việc và chấp nhận rằng mô hình nhỏ có thể cần chỉ dẫn chặt hơn, gọi công cụ không ổn định hoặc xử lý yêu cầu nhiều bước kém hơn dịch vụ đám mây mạnh.
Máy chủ cục bộ nối mô hình với ứng dụng, nhưng quyền truy cập vẫn cần giới hạn
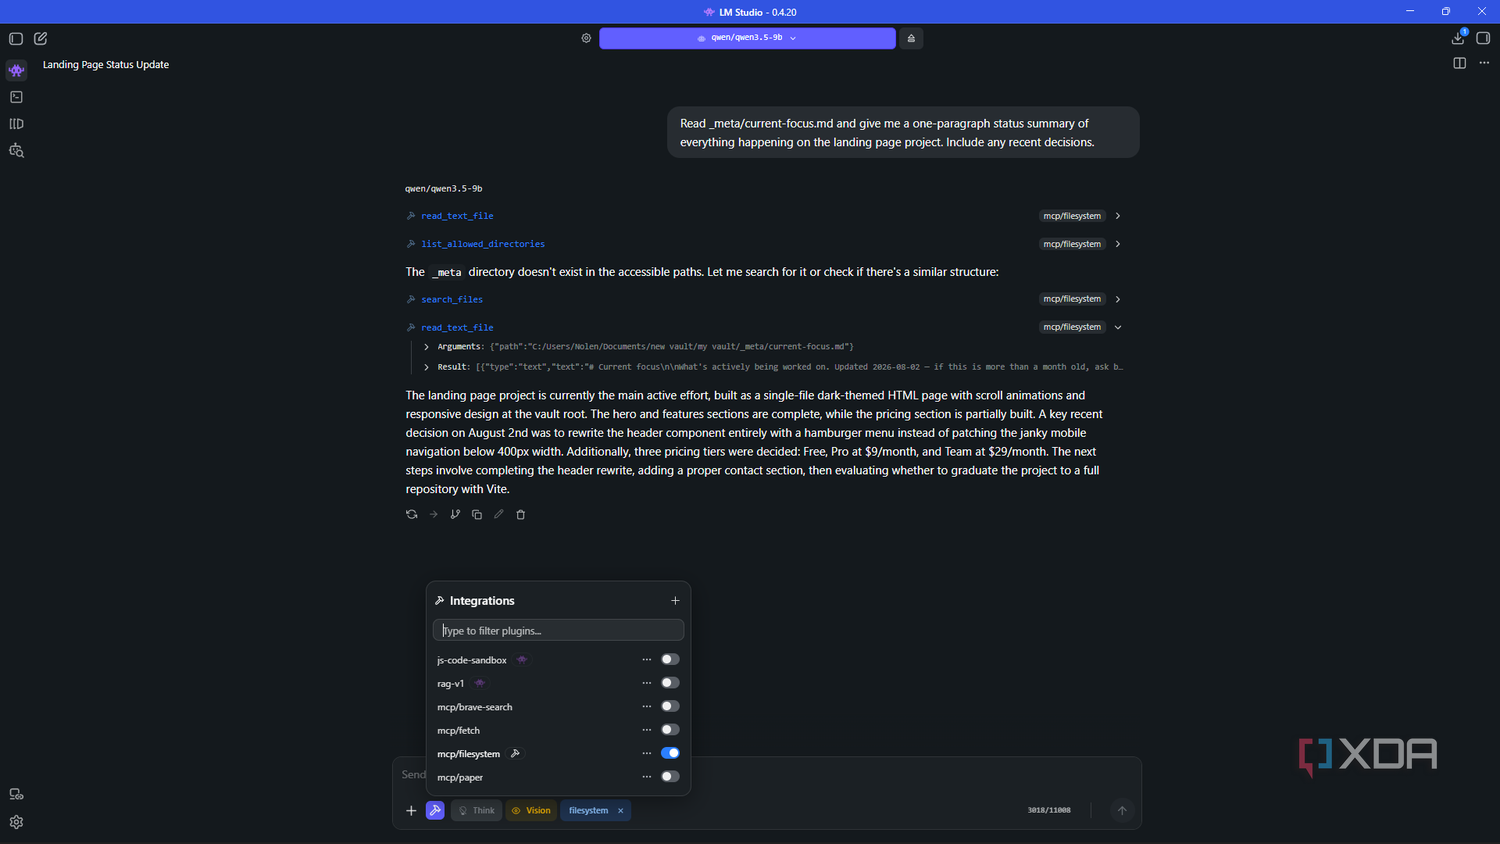
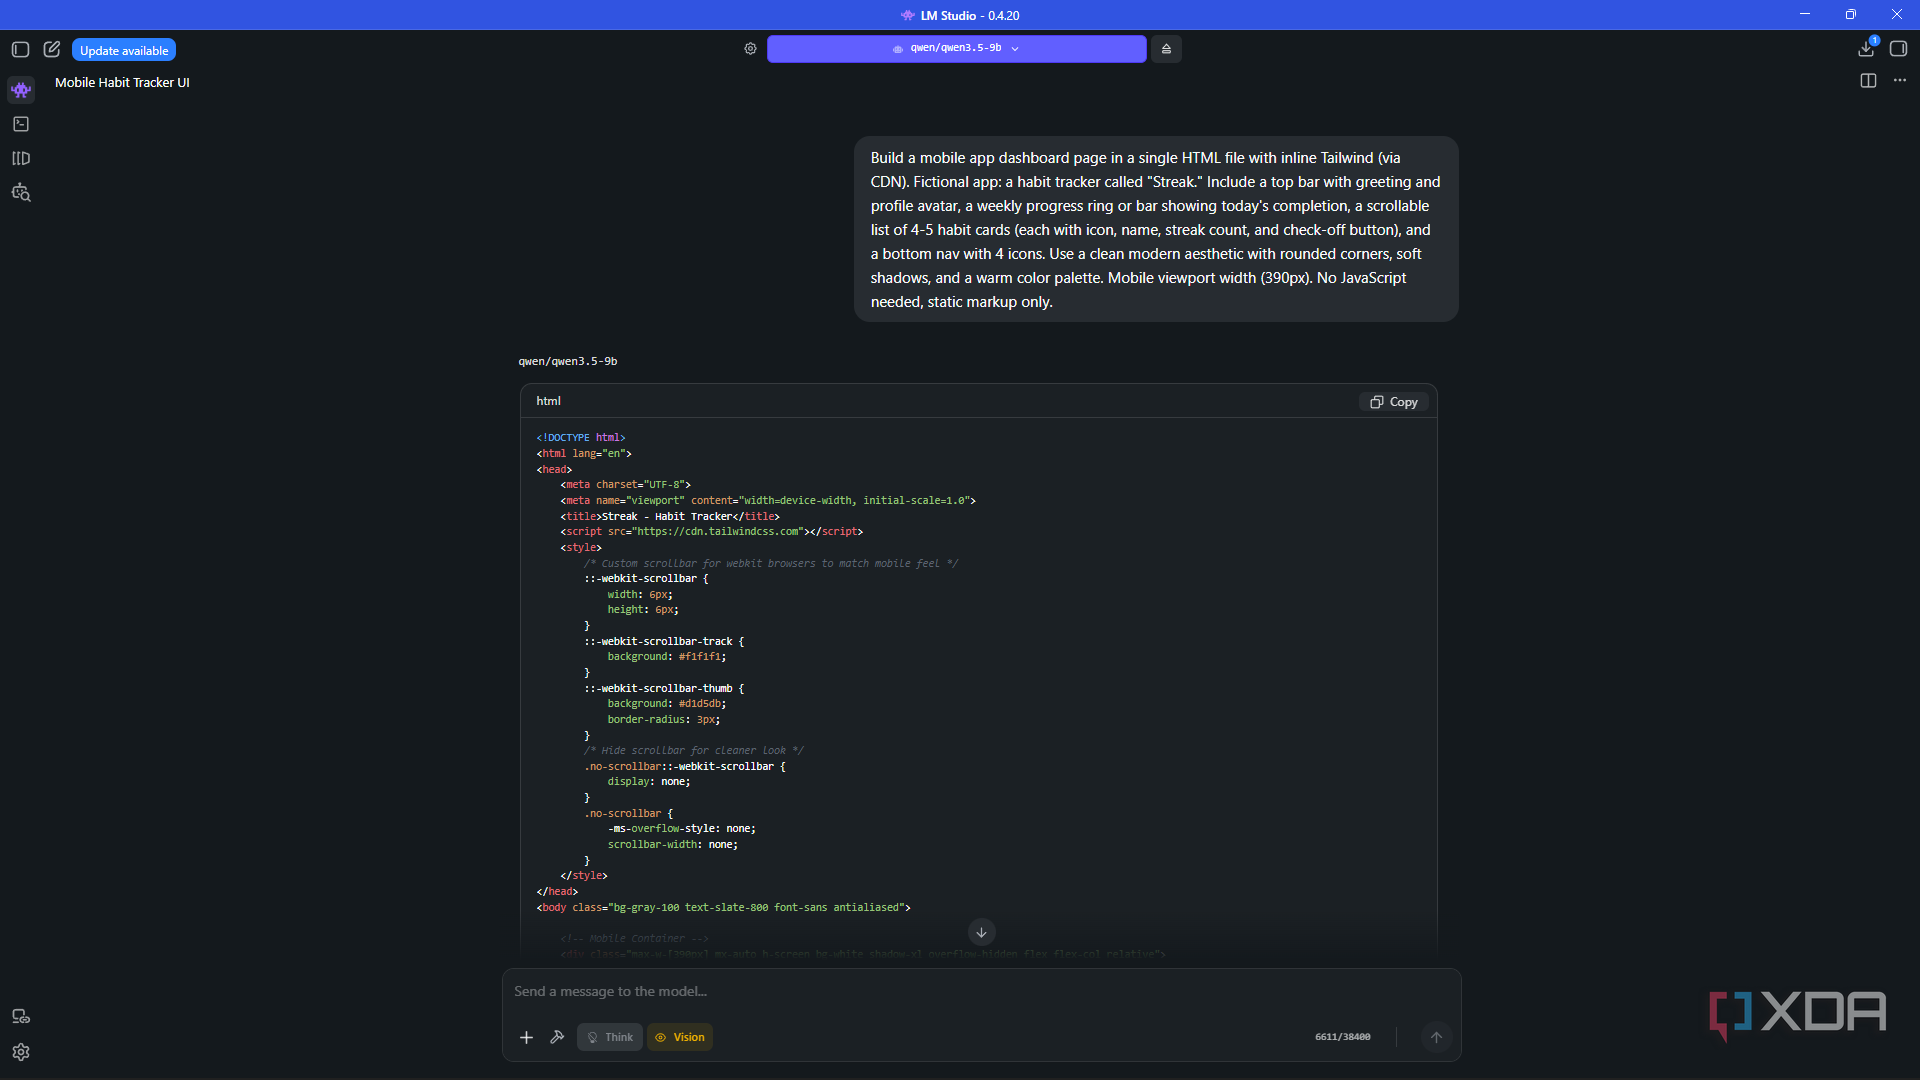
LM Studio có thể cung cấp máy chủ nội bộ tương thích API kiểu OpenAI để ứng dụng khác gửi yêu cầu đến mô hình đang nạp. XDA mô tả việc kết nối Obsidian Copilot, Eigent và một số công cụ thiết kế/lập trình; LM Studio 0.4.0 cũng giới thiệu llmster chạy không cần giao diện đồ họa, yêu cầu song song với continuous batching và endpoint REST có trạng thái hỗ trợ MCP cục bộ.
Filesystem MCP có thể cho mô hình thao tác với tệp nếu người dùng kết nối và cấp quyền. Điều đó tiện cho việc đọc tài liệu hoặc sắp xếp thư mục, nhưng cũng khiến quyền truy cập trở thành phần phải cấu hình cẩn thận: chỉ chia sẻ đúng thư mục cần thiết, kiểm tra quyền ghi và không mở dịch vụ ra mạng công cộng khi chưa thiết lập xác thực. Chạy cục bộ giảm việc gửi nội dung lên dịch vụ bên ngoài; nó không tự động bảo vệ máy khỏi plugin hoặc công cụ được cấp quyền quá rộng.
Với card RTX 4060 8GB đang bán ở Việt Nam, tối ưu có thể là bước thử rẻ hơn
RTX 4060 8GB vẫn được bán tại Việt Nam; Phong Vũ niêm yết RTX 4060 8GB ở mức khoảng 7,95 triệu đồng theo mức giá đã tra cứu, trong khi mức tham khảo tại một số đại lý dao động tùy phiên bản. Giá thay đổi theo thời điểm và mẫu card, vì vậy nên kiểm tra trang bán hàng trước khi mua. Người đã có card 8GB có thể thử quy trình lượng tử hóa và điều chỉnh cache trước; nếu công việc cần tốc độ cao, ngữ cảnh dài liên tục hoặc mô hình lớn nguyên bản, nâng cấp VRAM vẫn là giải pháp trực tiếp hơn.
Giới hạn quan trọng không chỉ là dung lượng card. RAM hệ thống, tốc độ bộ nhớ, backend, thiết lập context và tác vụ nền đều ảnh hưởng đến kết quả. GPU 8GB có thể trở thành máy chạy một bộ công cụ AI cục bộ hữu ích, nhưng không phải thay thế toàn diện cho máy trạm nhiều VRAM. Giá trị của cách làm này nằm ở việc tận dụng phần cứng sẵn có cho tác vụ phù hợp, thay vì kỳ vọng mọi mô hình mới đều chạy mượt.
Nguồn tham khảo: XDA-Developers, LM Studio, Phong Vũ