
Tóm tắt nhanh
- Chuyên gia công nghệ Patrick Moorhead công bố hệ thống AI cục bộ gồm 4 khối DGX Spark gom chung 512GB bộ nhớ hợp nhất.
- Mô hình DeepSeek V4.1-Flash quy mô 552 tỷ tham số đạt tốc độ xuất đỉnh 494 token/giây khi sinh mã nguồn và 280 token/giây khi sinh văn bản.
- Hệ thống sử dụng cấu trúc nối vòng không cần switch mạng quang 200GbE đắt đỏ, tận dụng card mạng ConnectX-7 có sẵn.
- Tổng chi phí phần cứng dao động từ 25.000 đến 40.000 USD (khoảng 540 triệu đồng nếu mua lẻ tại Việt Nam), mở ra lựa chọn bảo mật dữ liệu riêng cho doanh nghiệp.
Cụm 4 máy DGX Spark đạt tốc độ 494 token/giây
Vấn đề lớn nhất khi doanh nghiệp muốn tự vận hành các mô hình ngôn ngữ lớn cục bộ là dung lượng bộ nhớ đồ họa và băng thông liên kết giữa các card tính toán. Chuyên gia công nghệ Patrick Moorhead vừa công bố dàn máy tính toán AI cá nhân gồm 4 thiết bị DGX Spark được đặt gọn trong giá đỡ tec MOJO có quạt làm mát phụ trợ bên dưới. Điểm đáng chú ý là hệ thống này có thể gánh trọn vẹn mô hình DeepSeek V4.1-Flash với tổng quy mô lên đến 552 tỷ tham số, đạt mức chiếm dụng thực tế 476 GB bộ nhớ.
Trong các bài thử nghiệm suy luận đa luồng với 32 yêu cầu đồng thời, hệ thống ghi nhận tốc độ xuất đỉnh lên tới 494 token/giây khi tạo mã nguồn và 280 token/giây đối với văn bản thông thường. Khi xử lý một yêu cầu đơn lẻ, tốc độ duy trì khoảng 96 token/giây cho mã lập trình và 58 token/giây cho văn bản. Đặc biệt, tốc độ nạp ngữ cảnh ban đầu (prefill) đạt tới 4.764 token/giây với độ trễ phản hồi token đầu tiên chỉ 0,2 giây ở trạng thái nghỉ.
Cấu hình phần cứng của mỗi khối tính toán DGX Spark
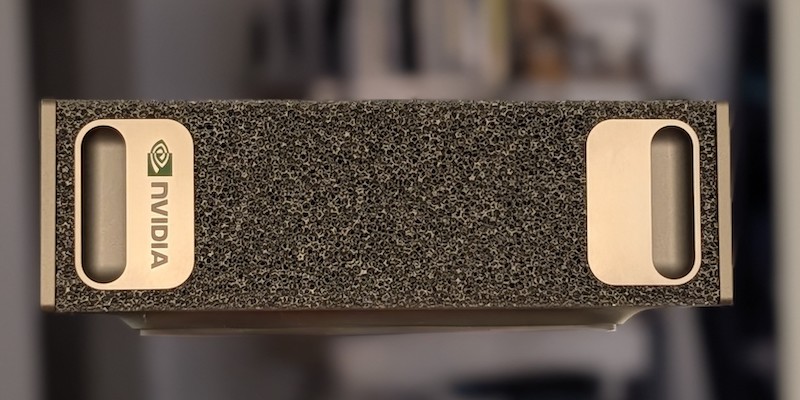
Hãng thiết kế DGX Spark như một nền tảng tính toán AI để bàn thu nhỏ, kết hợp kiến trúc vi xử lý Grace Blackwell với bộ nhớ thống nhất tốc độ cao. Mỗi khối máy tính toán sở hữu cấu hình phần cứng đồng nhất với khả năng xử lý định dạng dấu phẩy động độ chính xác thấp NVFP4 được tối ưu riêng cho các tải suy luận hiện đại.
| Thành phần phần cứng | Thông số kỹ thuật chi tiết |
|---|---|
| Bộ xử lý trung tâm (CPU) | Arm 20 nhân (10 nhân hiệu năng cao Cortex-X925 + 10 nhân tiết kiệm điện Cortex-A725, 32 MB L3 cache) |
| Bộ xử lý đồ họa (iGPU) | GB10 nhân Tensor thế hệ 5, 31 TFLOPs FP32, 1.000 TOPS NVFP4 |
| Bộ nhớ hệ thống hợp nhất | 128 GB LPDDR5X (băng thông ~273 GB/s) |
| Kết nối mạng nội bộ | ConnectX-7 SmartNIC tích hợp, 2 cổng QSFP 200 Gb/s |
| Bộ nhớ lưu trữ & phần mềm | Hệ điều hành DGX OS, bộ công cụ tăng tốc CUDA và Sync Cluster Assistant |
Số liệu: Báo cáo kỹ thuật & Wccftech
Khi ghép 4 thiết bị lại với nhau, tổng bộ nhớ hợp nhất của toàn hệ thống đạt mức 512 GB. Mức dung lượng này vừa vặn vượt qua ngưỡng 476 GB cần thiết để giữ trọn vẹn trọng số mô hình cùng bộ nhớ đệm ngữ cảnh mà không cần chuyển bớt dữ liệu sang ổ lưu trữ thể rắn NVMe, tránh gây nghẽn cổ chai tốc độ suy luận.
Kết nối vòng không cần switch mạng quang
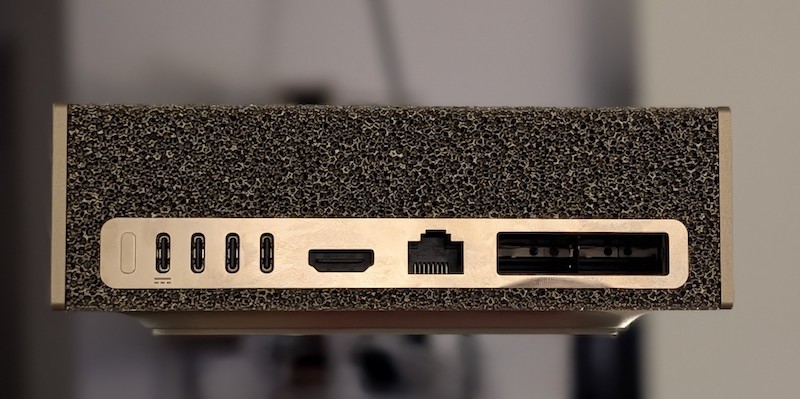
Một trong những rào cản chi phí lớn nhất khi xây dựng cụm máy chủ AI quy mô nhỏ là các bộ chuyển mạch quang 200 GbE chuyên dụng, vốn có giá từ vài nghìn đến cả chục nghìn USD. Để giải quyết bài toán này, dàn máy 4 node DGX Spark sử dụng cấu trúc nối vòng trực tiếp (switchless ring topology) thông qua chính các cổng mạng QSFP kép của card ConnectX-7 có sẵn trên mỗi máy tính.
Theo sơ đồ liên kết, máy 1 nối cáp trực tiếp với máy 2 và máy 4; máy 2 nối với máy 1 và máy 3; máy 3 nối với máy 2 và máy 4; máy 4 nối vòng lại với máy 3 và máy 1. Cấu trúc liên kết này bảo đảm mọi node đều có hai đường truyền dữ liệu độc lập với băng thông 200 Gb/s mà không cần mua thêm thiết bị switch ngoài. Trình điều khiển mạng phân tán Sync Cluster Assistant tự động chia tách và đồng bộ các lớp tính toán mô hình giữa các node qua kết nối trực tiếp này.
Kiến trúc DeepSeek V4.1-Flash giúp tối ưu bộ nhớ đệm
Tốc độ xử lý ấn tượng trên phần cứng cá nhân không chỉ đến từ chip GB10 mà còn nhờ những cải tiến kiến trúc của DeepSeek V4.1-Flash. Mô hình này sở hữu cửa sổ ngữ cảnh lên tới 1.048.576 token, được thiết kế theo dạng hỗn hợp chuyên gia (MoE) kết hợp kiến trúc Causal Encoder-Decoder (CED). Mặc dù tổng số lượng tham số danh định là 552 tỷ, mô hình chỉ kích hoạt 8 tỷ tham số cho mỗi token ở giai đoạn nạp prompt và 16 tỷ tham số ở giai đoạn giải mã sinh từ.
Bên cạnh việc kích hoạt tham số thưa thớt, cơ chế Compressed Sparse Attention 2 (CSA2) kết hợp kỹ thuật nạp lại có giới hạn SWA Bounded Replay đã nén dấu chân bộ nhớ đệm KV (KV cache) xuống mức 890 byte cho mỗi token, giảm tới 4 lần so với phiên bản V4-Flash trước đó. Nhờ vậy, ngay cả khi làm việc với các đoạn prompt dài hàng chục nghìn từ hoặc mã nguồn phức tạp, bộ nhớ hệ thống vẫn không bị quá tải.
Bài toán đầu tư phần cứng AI cục bộ cho doanh nghiệp
Tại thị trường quốc tế, tổng chi phí lắp ráp trọn bộ hệ thống gồm 4 node DGX Spark bản 128 GB, dây cáp mạng QSFP, giá đỡ và quạt tản nhiệt nằm trong khoảng 25.000 đến 40.000 USD. Tại Việt Nam, thiết bị DGX Spark bản 128 GB LPDDR5X của NVIDIA hiện được đơn vị CNTTShop niêm yết phân phối với mức giá 135.999.000 đồng mỗi chiếc. Nếu trang bị đủ cụm 4 máy, chi phí thiết bị rơi vào khoảng 540 triệu đồng chưa bao gồm các phụ kiện giá đỡ hay dây cáp.
Với mức đầu tư này, cụm máy phù hợp cho các nhóm nghiên cứu, công ty phần mềm hoặc tổ chức tài chính có nhu cầu xử lý khối lượng lớn tài liệu nhạy cảm cần độ bảo mật nội bộ tuyệt đối. Việc sở hữu một dàn máy chạy cục bộ giúp loại bỏ hoàn toàn chi phí thuê API đám mây định kỳ theo số lượng token, đồng thời tránh rò rỉ dữ liệu sở hữu trí tuệ ra các máy chủ bên ngoài.
Nguồn tham khảo: Wccftech, NVIDIA Blog, DeepInfra