
Tóm tắt nhanh
- Một người dùng Reddit nói rằng chuyển cáp màn hình từ RTX 4090 sang cổng trên bo mạch chủ giúp giải phóng khoảng 2,5GB VRAM.
- Người này báo cáo cửa sổ ngữ cảnh Qwen3.8-27B tăng từ 65K lên 132K token; chưa có video hoặc phép đo độc lập xác nhận.
- VRAM trống thêm có thể dành cho KV cache, nhưng dung lượng cần thiết thay đổi theo mô hình, lượng tử hóa và cấu hình suy luận.
- Đây là mẹo đáng thử trên máy đã có iGPU, không phải cách bảo đảm nhân đôi context trên mọi RTX 4090.
Với mô hình ngôn ngữ chạy tại chỗ, đôi khi nút thắt không nằm ở sức mạnh tính toán mà ở phần VRAM còn lại sau khi hệ điều hành, màn hình và ứng dụng chiếm chỗ. Một bài đăng trong cộng đồng LocalLLaMA mô tả cách chuyển dây xuất hình khỏi RTX 4090 sang cổng trên bo mạch chủ, để iGPU của CPU xử lý màn hình. Tác giả nói thay đổi này nhường lại khoảng 2,5GB VRAM cho mô hình Qwen3.8-27B.
Khoảng trống vài gigabyte có thể quyết định độ dài hội thoại
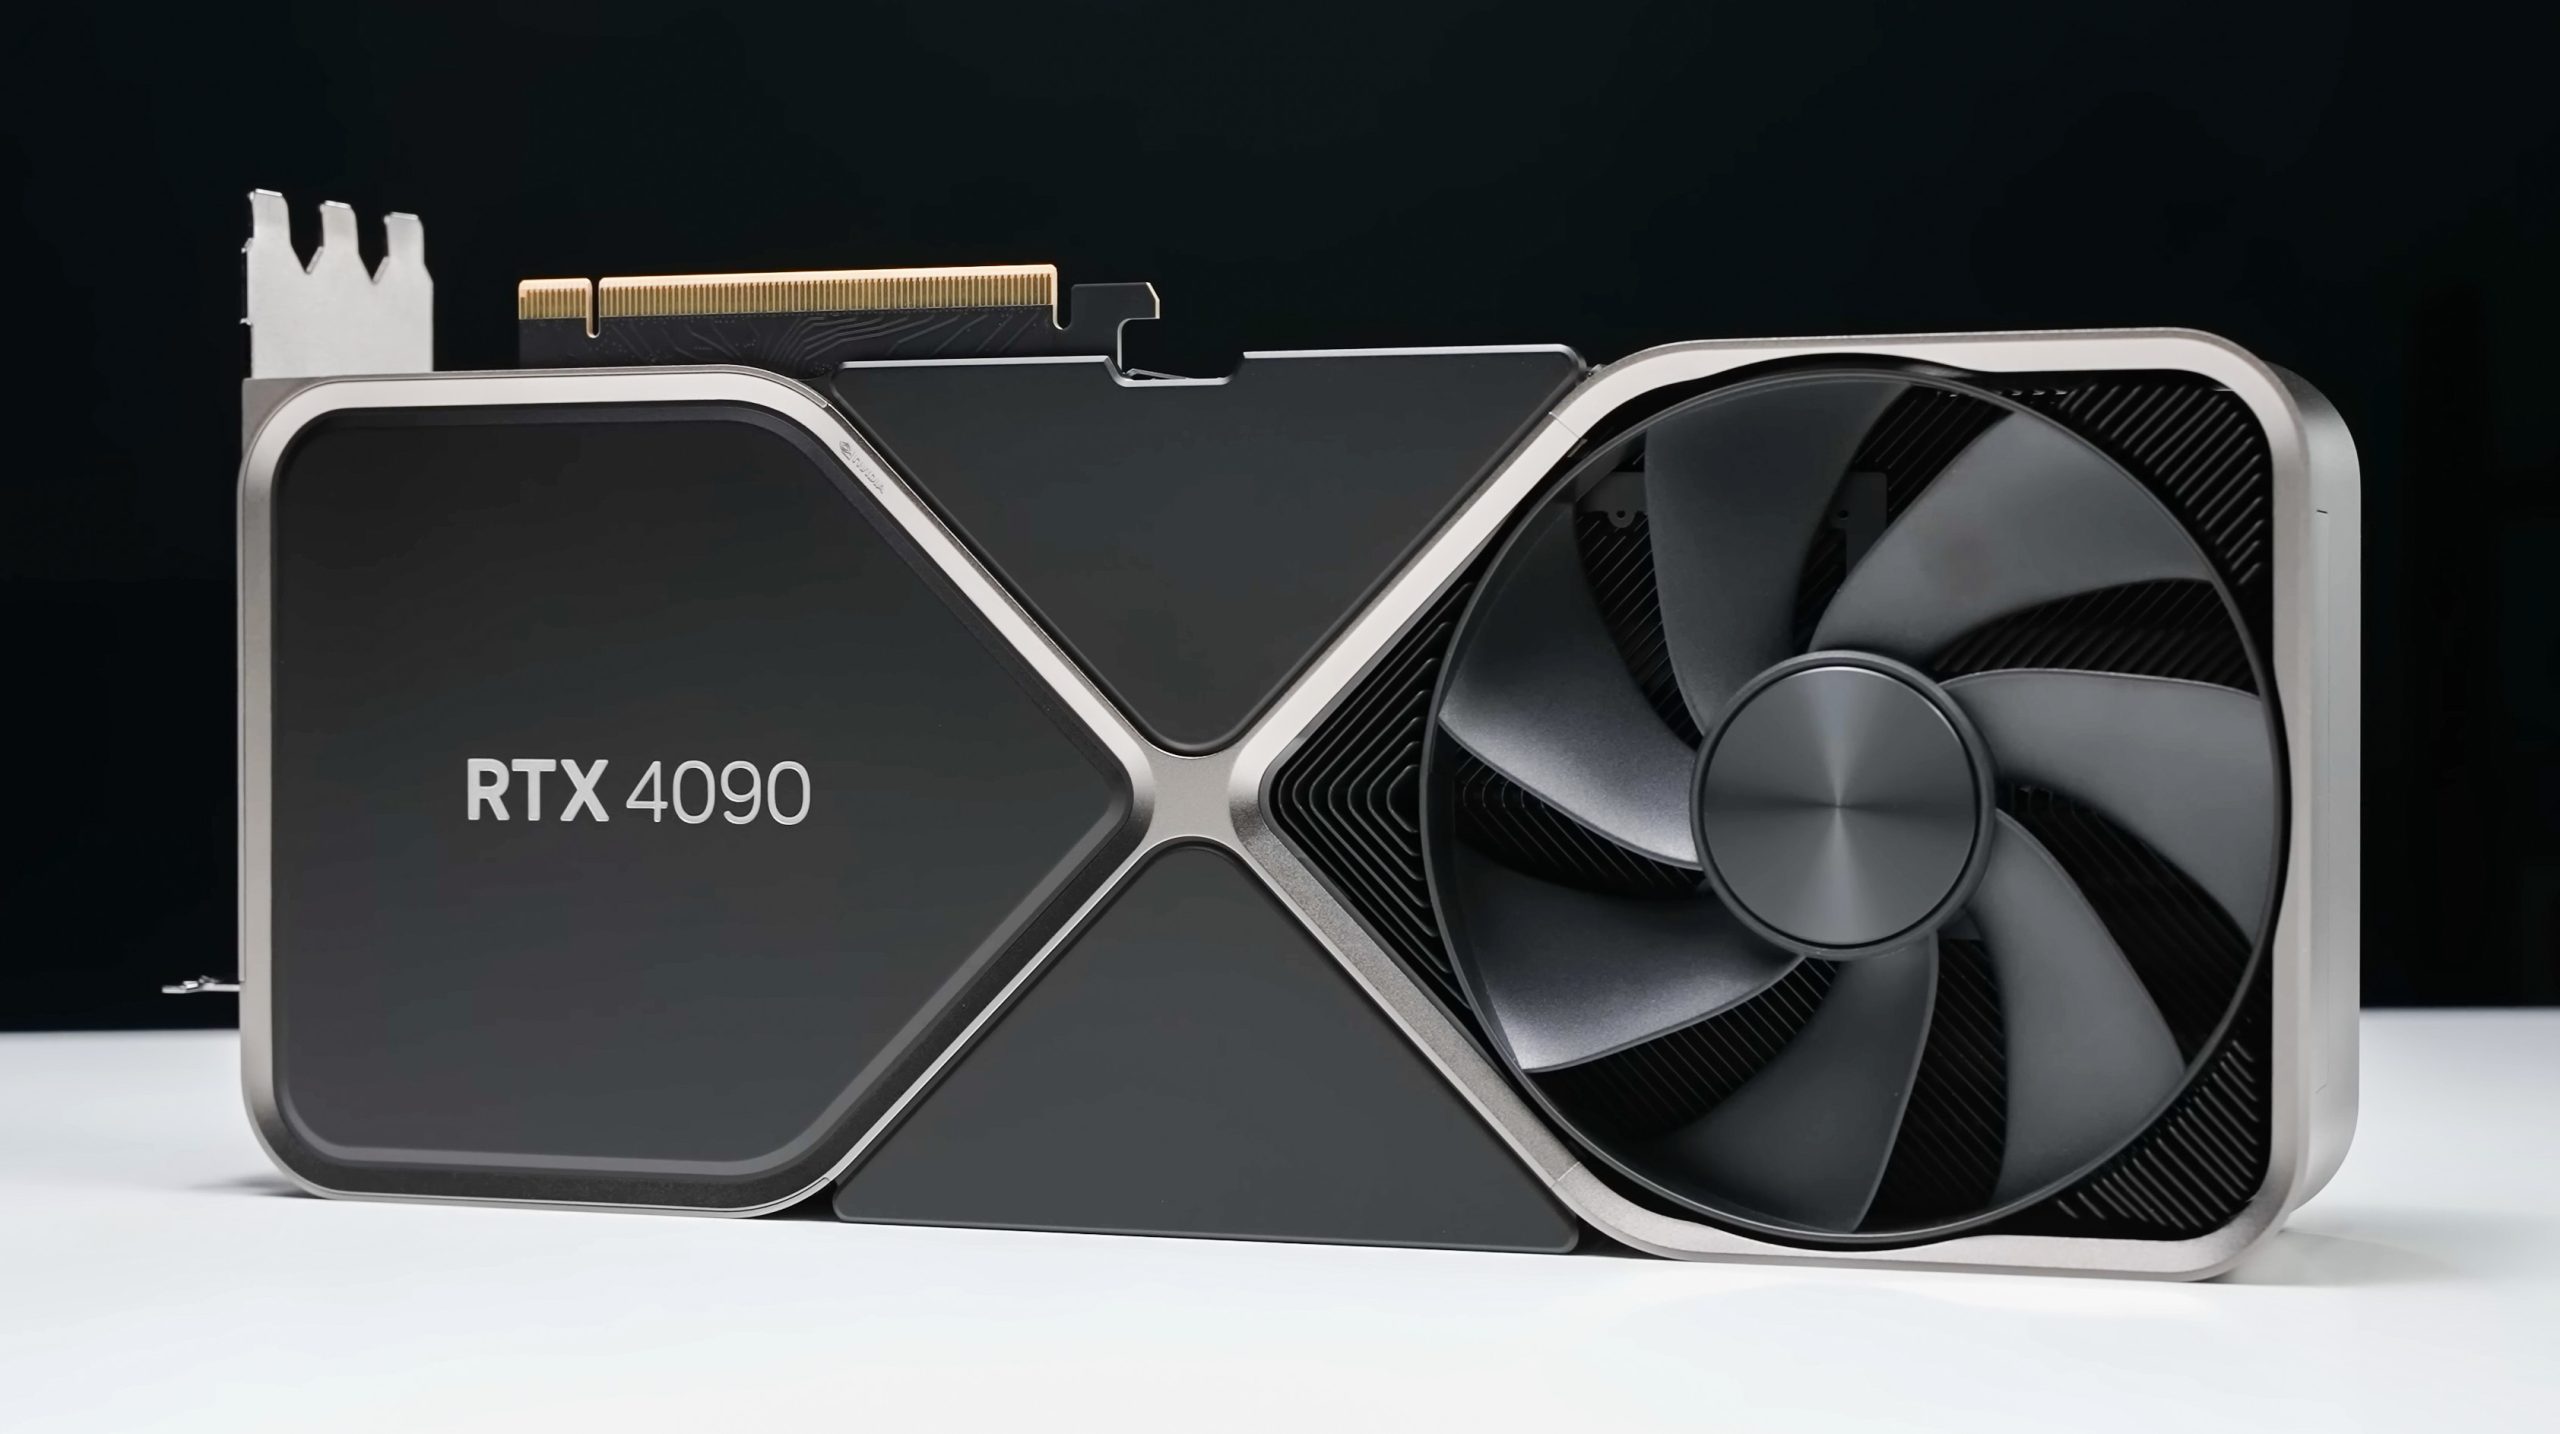
RTX 4090 có 24GB bộ nhớ GDDR6X theo thông số của NVIDIA. Nhưng con số đó không đồng nghĩa toàn bộ dung lượng luôn dành được cho mô hình: trọng số, bộ đệm của runtime, ứng dụng đồ họa và dữ liệu sinh trong lúc suy luận cùng chia sẻ ngân sách bộ nhớ.
Với mô hình có cửa sổ ngữ cảnh dài, KV cache lưu các biểu diễn trung gian của token đã xử lý. Khi số token tăng, phần bộ nhớ này cũng tăng theo; bởi vậy vài gigabyte còn thiếu có thể khiến cấu hình vừa chạy được ở 65K không đủ chỗ cho 132K. Northflank ước tính các bản lượng tử hóa Qwen3.8-27B có trọng số khoảng 14–17GB, nhưng phần còn lại trên card 24GB còn phải gánh KV cache và runtime. Mức tiêu thụ thật phụ thuộc định dạng lượng tử hóa và cách phần mềm nạp mô hình.
Điều đó giải thích vì sao con số 2,5GB nghe có vẻ nhỏ so với 24GB nhưng vẫn có thể tạo khác biệt ở sát ngưỡng. Tuy vậy, context window tăng gấp đôi không tự động đồng nghĩa tốc độ tăng gấp đôi hay chất lượng trả lời tốt hơn. Nó chỉ cho phép mô hình tiếp nhận lượng văn bản dài hơn trước khi phải cắt bớt ngữ cảnh; thời gian xử lý prompt dài và tốc độ sinh vẫn phụ thuộc phần cứng, runtime và thiết lập.
132K token hiện là báo cáo cá nhân, chưa phải kết quả kiểm chứng
Người đăng nói cấu hình RTX 4090 trước đó chỉ chạy được Qwen3.8-27B ở 65K token, rồi đạt 132K sau khi chuyển màn hình sang iGPU; bài đăng còn nêu tốc độ sinh 125 token/giây. Đây là số liệu do người dùng tự báo cáo, chưa kèm video trình diễn hay nhật ký cấu hình đủ để người khác tái lập.
Ngay trong thảo luận được dẫn lại, một người dùng khác báo đã giải phóng khoảng 1GB khi chuyển màn hình sang đồ họa tích hợp trên hệ thống Radeon AI PRO R9700, thấp hơn mức 2,5GB. Các máy còn lại có thể cho kết quả khác: độ phân giải, số màn hình, ứng dụng chạy nền, driver và cách hệ điều hành phân bổ bộ nhớ đều ảnh hưởng lượng VRAM khả dụng. Vì thế không nên xem 2,5GB là mức tiết kiệm mặc định của RTX 4090.
Cũng cần phân biệt việc cắm màn hình vào iGPU với việc chuyển toàn bộ tác vụ AI sang iGPU. Trong trường hợp được mô tả, RTX 4090 vẫn chạy mô hình; CPU tích hợp đồ họa chỉ nhận phần xuất hình. Nếu CPU không có iGPU hoạt động, cổng hình trên bo mạch chủ thường không thể thay thế đầu ra của card rời. Kết quả còn tùy bo mạch, thiết lập firmware, driver và hệ điều hành.
Thử nghiệm này hợp lý nhất khi máy đã có iGPU
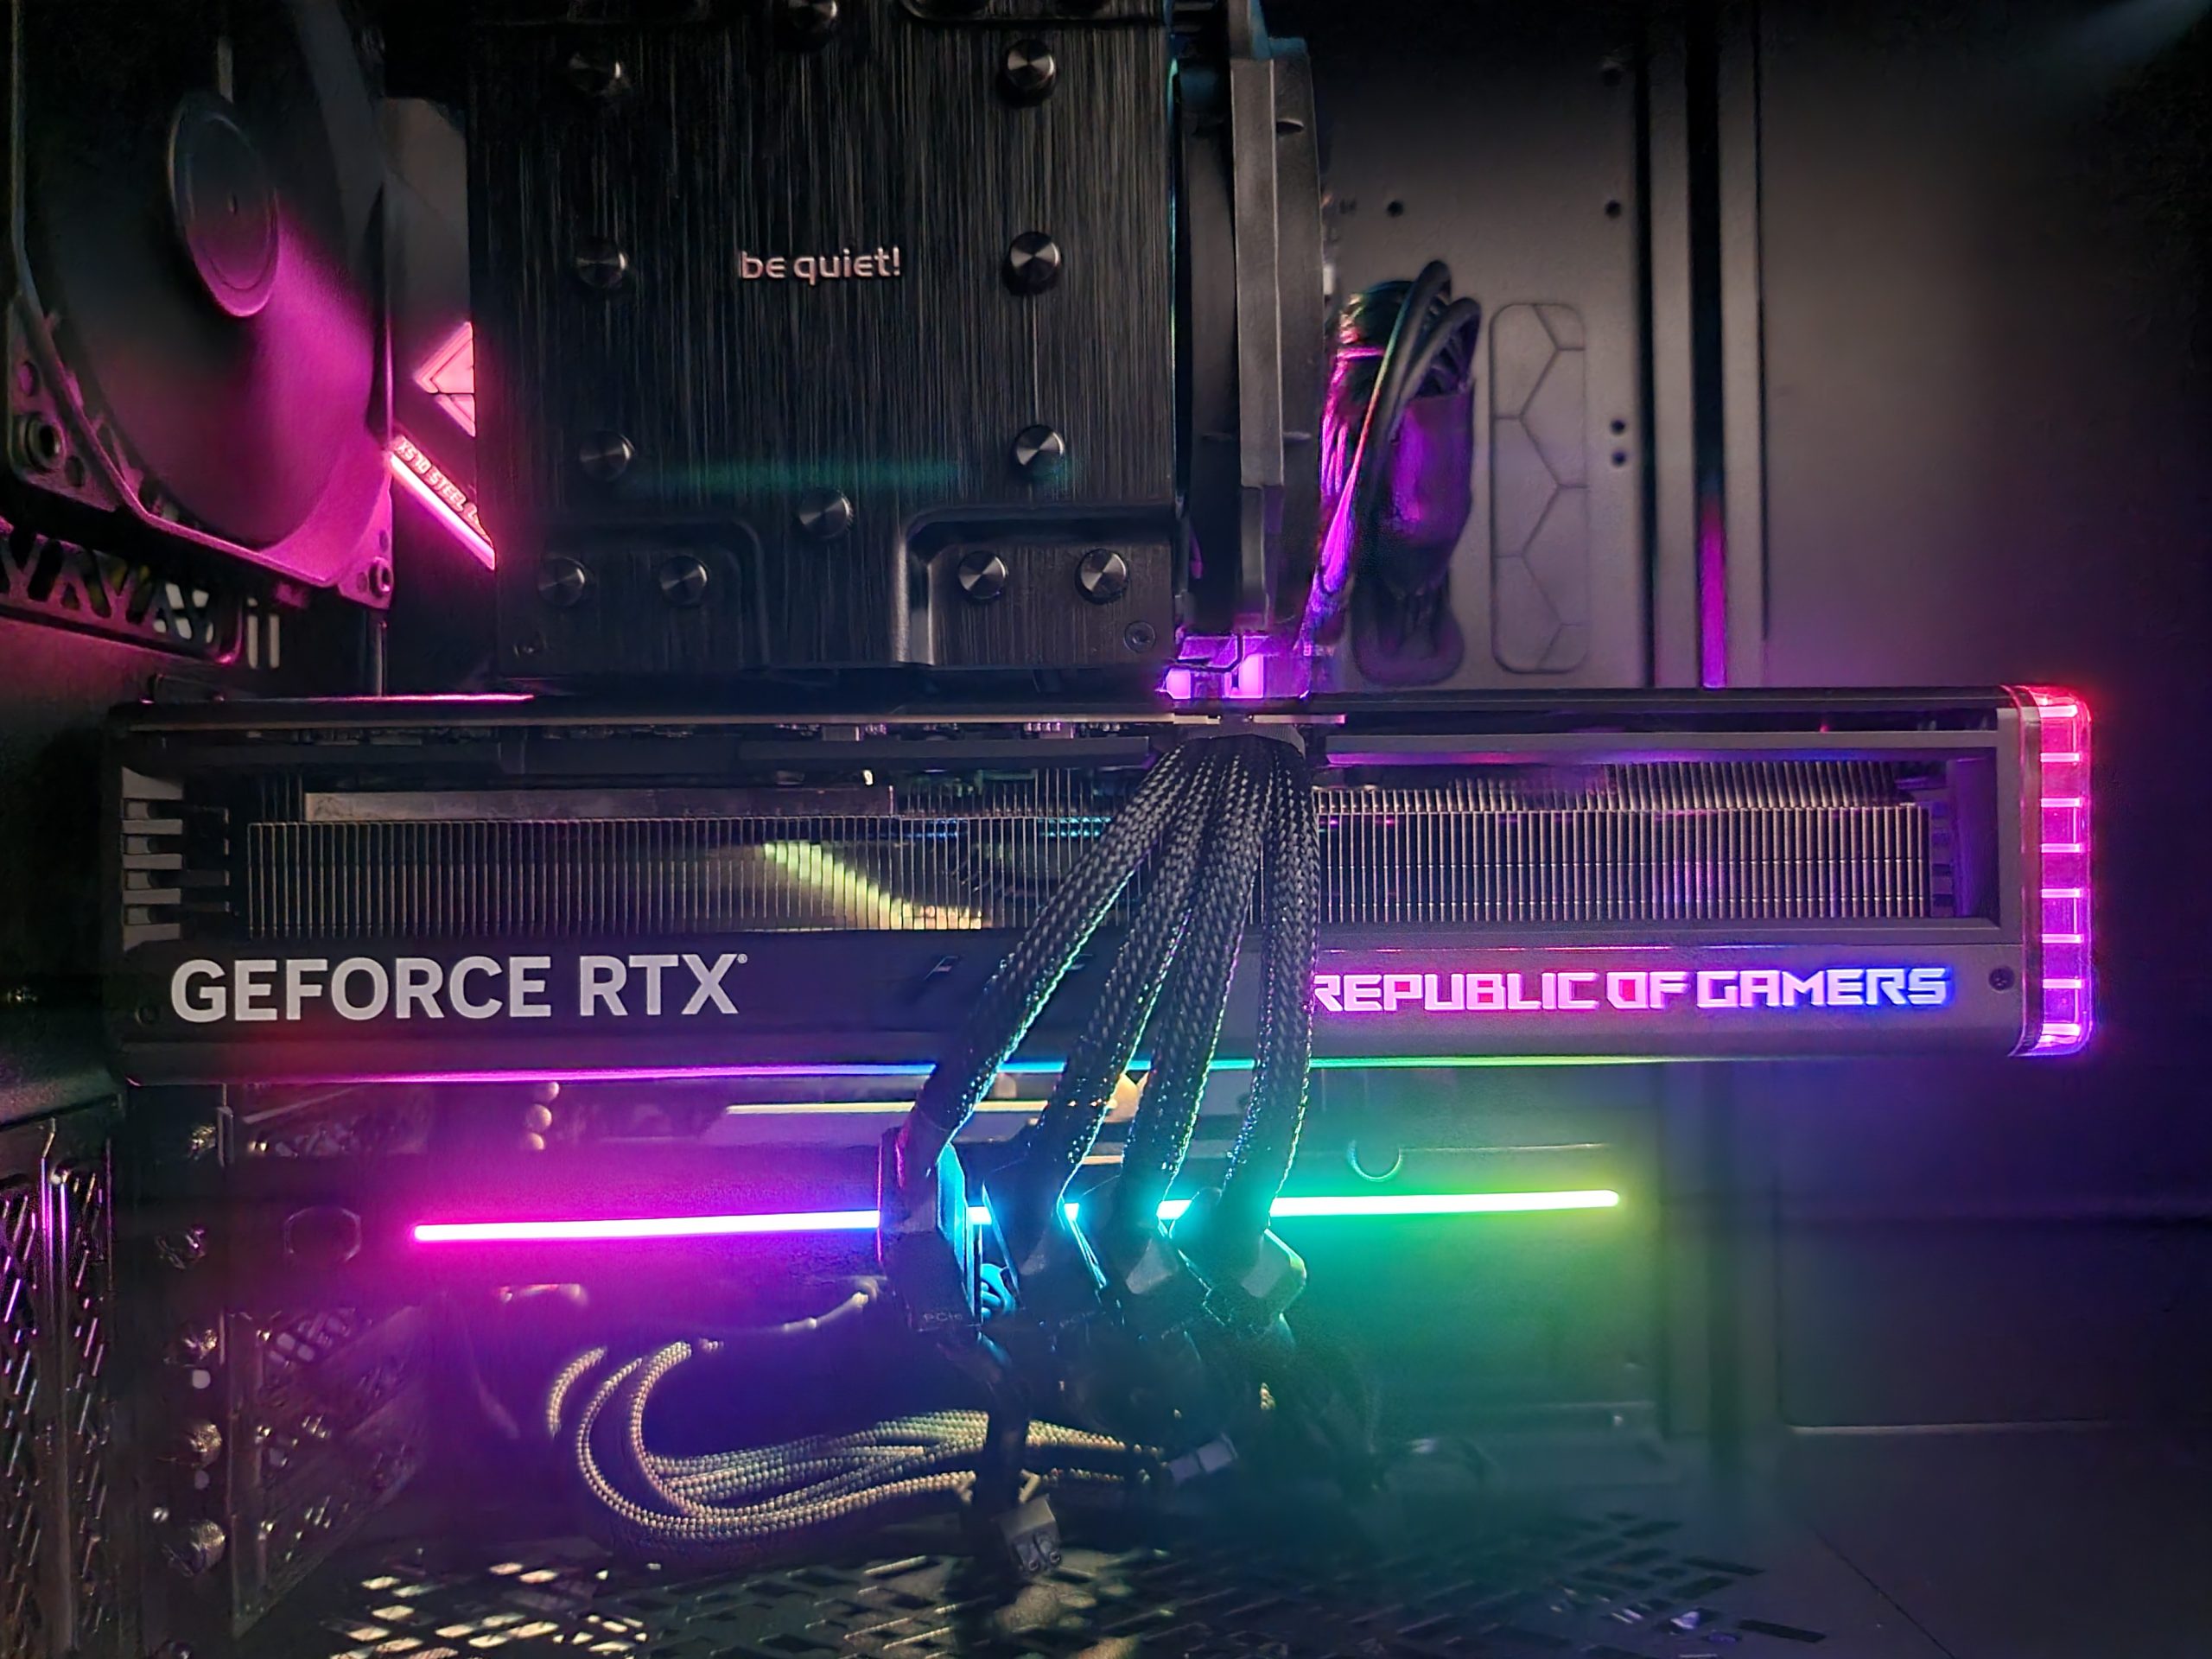
Người dùng đã có CPU và bo mạch hỗ trợ đồ họa tích hợp có thể thử chuyển cáp, rồi so sánh mức VRAM khả dụng và cấu hình context trong cùng một phiên bản runtime. Nên giữ nguyên lượng tử hóa, tham số mô hình và ứng dụng nền; nếu thay nhiều yếu tố cùng lúc thì khó biết phần cải thiện đến từ đâu. Trước và sau khi đổi cổng, kiểm tra cả việc màn hình thực sự chạy trên iGPU lẫn mức VRAM mà runtime báo, thay vì chỉ nhìn vào con số context được chọn trong giao diện.
Đánh đổi rõ nhất là sự tiện dụng. Tác giả bài đăng nói phải chuyển dây về RTX 4090 khi chơi game. Một số cấu hình có thể chọn GPU cho ứng dụng hoặc để card rời xử lý tác vụ nặng trong khi màn hình nối với iGPU, nhưng không thể khẳng định cách thiết lập này hoạt động giống nhau trên mọi máy. Cần kiểm tra đường đi của ứng dụng và hiệu năng thực tế; việc dùng iGPU cũng không tự nó chứng minh có tổn thất PCIe đáng kể cho RTX 4090.
Đối với người dùng Việt Nam đang cân nhắc mua card 24GB chỉ để chạy mô hình cục bộ, mẹo này không nên là cơ sở chính cho quyết định phần cứng. RTX 4090 thuộc phân khúc rất đắt; trước khi mua, hãy tính bộ nhớ cần cho trọng số, KV cache, runtime và các ứng dụng khác, rồi xem xét bản lượng tử hóa hoặc GPU có VRAM lớn hơn. Tận dụng iGPU có thể giúp vắt thêm dung lượng từ một dàn máy sẵn có, nhưng không thay thế phép đo trên chính cấu hình của mình.
Giá bán và tồn kho RTX 4090 tại Việt Nam thay đổi theo mẫu card và nhà bán lẻ; trang sản phẩm CellphoneS được tham khảo không hiển thị mức giá xác minh được trong nội dung truy xuất, nên bài không chốt một con số. Luận điểm đáng giữ lại ở đây không phải “thêm 2,5GB cho mọi người”, mà là VRAM dành cho màn hình có thể là phần ngân sách cần xem xét khi chạy LLM sát giới hạn bộ nhớ.
Nguồn tham khảo: Reddit – LocalLLaMA; NVIDIA – GeForce RTX 4090; Northflank – Qwen3.8-27B; CellphoneS – Gigabyte GeForce RTX 4090 Gaming OC 24G; Wccftech