Tóm tắt nhanh
- Nghiên cứu quy mô lớn từ Đại học Harvard trên 718 doanh nghiệp cho thấy AI coding agent giúp tăng 30% lượng dòng mã và 23% số lượng pull request, nhưng không làm tăng sản lượng tính năng thực tế hoàn thành.
- Nút thắt của toàn bộ chuỗi sản xuất phần mềm dồn về khâu bình duyệt mã nguồn: thời gian xử lý một pull request kéo dài thêm 49% và tỷ lệ yêu cầu sửa đổi tăng gần gấp đôi.
- Các công cụ AI review hiện tại mới chỉ đảm nhận khoảng 23,3% bình luận đánh giá, khiến trách nhiệm kiểm thử logic nghiệp vụ và bảo mật vẫn dồn lên vai các kỹ sư có kinh nghiệm.
- Để khai thác giá trị thực tế của AI agent, các đội ngũ kỹ thuật cần đầu tư mở rộng năng lực kiểm thử tự động và tái cấu trúc quy trình duyệt mã thay vì chỉ thúc ép tăng tốc độ gõ code.
Làn sóng đưa các công cụ trí tuệ nhân tạo vào quy trình phát triển phần mềm đang diễn ra với tốc độ chóng mặt. Từ những trợ lý gợi ý từng dòng mã trong môi trường lập trình như GitHub Copilot hay Cursor ban đầu, các doanh nghiệp đã nhanh chóng chuyển sang triển khai AI agent tự hành như Cursor Agent, Claude Code hay Devin. Những công cụ này có khả năng tự đọc tài liệu kỹ thuật, lên kế hoạch triển khai, viết mã trên nhiều tệp tin và chạy thử nghiệm độc lập. Tuy nhiên, tốc độ viết mã vượt trội không đồng nghĩa với việc phần mềm được phát hành nhanh hơn ra thị trường.
Thực tế vận hành tại hàng trăm doanh nghiệp cho thấy việc đẩy mạnh sản lượng mã thô đang làm bộc lộ một điểm nghẽn nghiêm trọng: khâu bình duyệt và kiểm soát chất lượng từ con người không theo kịp tốc độ sản sinh mã của AI.
Lầm tưởng đo năng suất bằng số lượng mã nguồn
Một sai lầm phổ biến của các nhà quản lý kỹ thuật là đo lường hiệu quả công việc bằng số dòng mã được tạo ra hoặc số lượt commit đẩy lên kho lưu trữ. Đây là các chỉ số trung gian rất dễ thống kê, nhưng lại phản ánh sai lệch giá trị đầu ra của một sản phẩm công nghệ.
Trong công trình nghiên cứu mang tên “Artificial Intelligence in the Firm: Bottlenecks in Software Production”, hai nhà nghiên cứu Fiona Chen và James Stratton từ Đại học Harvard đã phân tích tập dữ liệu thực tế gồm 300 triệu sự kiện công việc của 725.938 nhân sự kỹ thuật tại 718 doanh nghiệp trong giai đoạn từ tháng 1/2021 đến tháng 3/2026. Bằng phương pháp difference-in-differences nhiều giai đoạn kết hợp kiểm soát quy mô doanh nghiệp và các yếu tố thời gian, nhóm nghiên cứu đã bóc tách tác động thực sự của AI assistant và AI agent đối với từng khâu trong chu kỳ phát triển phần mềm.
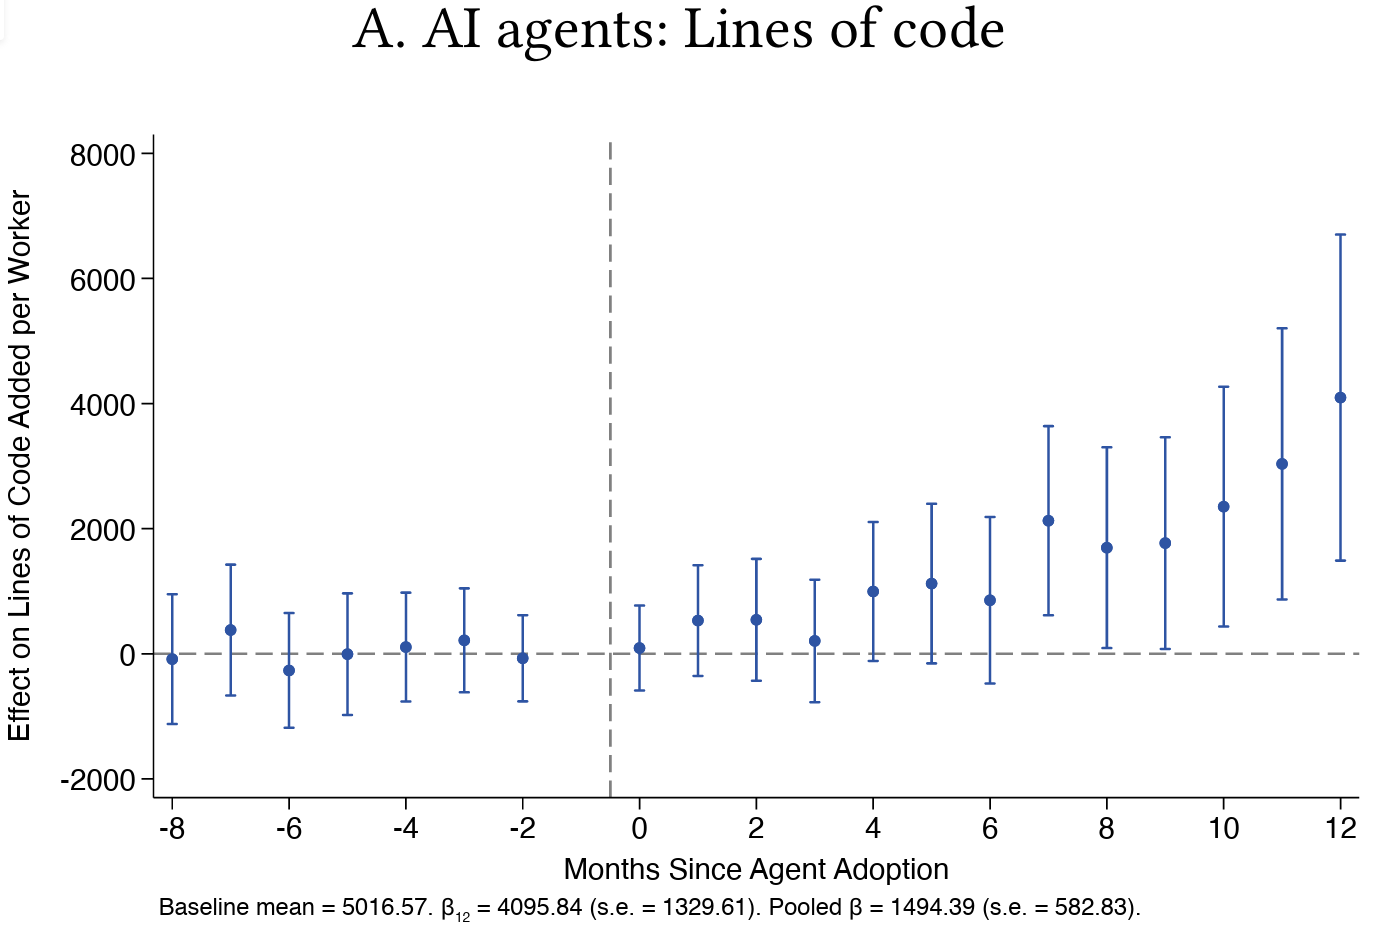
Kết quả chỉ ra rằng khi chuyển từ các trợ lý autocomplete sang AI agent tự hành, khối lượng mã phát sinh tăng vọt. Kỹ sư sử dụng agent đẩy thêm trung bình 1.494 dòng mã mỗi tháng (tăng 30% so với mức cơ sở 5.017 dòng), cùng với số lượt commit tăng 20% và số pull request gửi đi tăng 23%. Tuy nhiên, khi nhìn vào đầu ra kinh doanh thực tế được đo lường bằng các hạng mục công việc hoàn thành trên Jira, sự tăng trưởng này hoàn toàn biến mất.
Sản lượng mã tăng vọt nhưng phần mềm hoàn thiện không đổi
Bảng đối chiếu dưới đây tổng hợp các thước đo chính giữa thế hệ AI assistant ban đầu và AI agent tự hành khi đo lường trên các nhóm kỹ thuật phần mềm:
| Chỉ số đo lường | Mức cơ sở | Mức thay đổi với AI Assistant | Mức thay đổi với AI Agent |
|---|---|---|---|
| Dòng mã bổ sung (mỗi kỹ sư / tháng) | 5.017 dòng | +12% (không có ý nghĩa thống kê) | +30% (có ý nghĩa thống kê) |
| Lượt commit (mỗi kỹ sư / tháng) | 22,58 lượt | +9% (1,40 commit) | +20% (4,57 commit) |
| Pull request gửi đi (mỗi kỹ sư / tháng) | 5,34 PR | +5% (không có ý nghĩa thống kê) | +23% (1,22 PR) |
| Hạng mục Jira giải quyết (issue / tháng) | 3,67 issue | +0,09 (không có ý nghĩa thống kê) | +0,12 (không có ý nghĩa thống kê) |
| Thời gian xử lý pull request | Quy trình tiêu chuẩn | Biến động nhẹ | Tăng 49% (thêm ~3,45 ngày) |
| Tỷ lệ PR bị yêu cầu sửa đổi (changes requested) | Mức thông thường | Không đổi rõ rệt | Gần gấp đôi |
| Số bình luận trên mỗi pull request | Mức thông thường | Tương đương | Tăng 35% |
Số liệu: Nghiên cứu của Fiona Chen và James Stratton (Đại học Harvard), phân tích trên 718 doanh nghiệp và 725.938 nhân sự kỹ thuật từ nền tảng Jellyfish.
Số liệu từ nghiên cứu cho thấy số lượng issue hoàn thành chỉ tăng thêm 0,12 trên mức cơ sở 3,67, một con số hoàn toàn không có ý nghĩa thống kê. Khoảng tin cậy 95% loại trừ khả năng mức tăng tính năng vượt quá 12% mức cơ sở, thấp hơn rất nhiều so với mức tăng 30% của số dòng mã. Để kiểm tra xem các tác vụ sau khi có AI có phức tạp hay đồ sộ hơn hay không, nhóm nghiên cứu đã phân loại độ dài và thời gian chu kỳ dự đoán của các issue, nhưng không phát hiện sự dịch chuyển đáng kể nào về quy mô công việc.
Nói cách khác, lập trình viên tạo ra nhiều bản thảo code hơn, đẩy lên kho mã nhiều hơn, nhưng sản phẩm hoàn thiện được đưa vào vận hành thực tế không hề tăng lên tương ứng.
Nút thắt dồn về khâu bình duyệt pull request
Nguyên nhân trực tiếp dẫn tới hiện tượng đình trệ này nằm ở khâu bình duyệt mã nguồn (code review). Quy trình đưa một đoạn mã vào hệ thống không dừng lại ở việc gõ xong code, mà phải trải qua bước kiểm tra của đồng nghiệp trước khi được hợp nhất (merge) vào nhánh chính.
Khi các kỹ sư sử dụng AI agent để tạo mã với tốc độ cao, họ vô tình đổ dồn một lượng lớn công việc chưa qua sàng lọc kỹ càng vào hàng đợi bình duyệt. Dữ liệu từ nghiên cứu của Chen và Stratton ghi nhận thời gian trung bình từ lúc một pull request được mở đến khi được duyệt hoàn tất đã tăng 49%, tương đương kéo dài thêm 3,45 ngày làm việc. Đồng thời, tỷ lệ pull request bị từ chối và yêu cầu viết lại tăng gần gấp đôi, còn lượng bình luận trao đổi giữa người viết và người duyệt tăng thêm 35%.
Để ứng phó với tình trạng ùn ứ, các công ty buộc phải huy động thêm 14% tỷ lệ kỹ sư tham gia vào công tác bình duyệt. Điều này tạo ra một khoản “thuế giám sát” nặng nề, đặc biệt là với các kỹ sư cấp cao. Thay vì dành thời gian thiết kế kiến trúc hệ thống hoặc giải quyết những bài toán hóc búa, họ phải ngồi đọc từng dòng mã do AI sinh ra để tìm lỗi tiềm ẩn, kiểm tra xem agent có bịa đặt thư viện hay bỏ sót các trường hợp ngoại lệ (edge cases) hay không.
Vì sao công cụ AI review chưa thể giải tỏa áp lực?
Một câu hỏi tự nhiên đặt ra là: nếu AI có thể viết mã, tại sao không dùng chính AI để tự động hóa khâu bình duyệt? Thực tế cho thấy giải pháp này chưa đem lại hiệu quả như kỳ vọng.
Dù khoảng 80% doanh nghiệp trong nghiên cứu đã tích hợp các công cụ hỗ trợ bình duyệt bằng AI vào tháng 3/2026, các mô hình này chỉ chịu trách nhiệm cho 23,3% tổng số bình luận review và đóng góp vào 10,8% số pull request. Phần lớn công việc thẩm định chuyên sâu vẫn thuộc về con người.
Lý do cốt lõi nằm ở bản chất của việc kiểm thử phần mềm. AI review có thể bắt rất nhanh các lỗi cú pháp, vi phạm quy ước đặt tên hoặc những lỗ hổng bảo mật dạng mẫu có sẵn. Nhưng phần mềm trong doanh nghiệp đòi hỏi sự hiểu biết sâu sắc về logic nghiệp vụ, tính toàn vẹn của dữ liệu và sự tương thích với kiến trúc tổng thể. Một đoạn mã có thể hoàn toàn sạch lỗi cú pháp nhưng lại tính sai chiết khấu bán hàng hoặc gây xung đột cơ sở dữ liệu khi tải cao. Những vấn đề mang tính ngữ cảnh đó đòi hỏi tư duy phân tích của con người.
Hơn nữa, việc đọc và hiểu một đoạn mã do người khác (hoặc do máy) viết thường tốn nhiều năng lượng nhận thức hơn việc tự tay triển khai từ đầu. Khi khối lượng mã lạ xuất hiện dồn dập, nguy cơ kỹ sư bị kiệt sức hoặc duyệt ẩu (rubber-stamping) càng tăng cao, vô tình đưa rủi ro vào hệ thống.
Tổng kết
Sự xuất hiện của AI coding agent chứng minh khả năng tự động hóa vượt trội ở giai đoạn viết mã thô. Dù vậy, phần mềm là một chuỗi cung ứng khép kín gồm nhiều công đoạn phụ thuộc lẫn nhau: lập kế hoạch, viết mã, bình duyệt, kiểm thử tự động, tích hợp liên tục và vận hành. Khi một mắt xích được gia tốc đột biến trong khi mắt xích tiếp theo giữ nguyên năng lực tiếp nhận, điểm nghẽn sẽ dịch chuyển và tích tụ áp lực lên toàn bộ hệ thống.
Đối với các doanh nghiệp công nghệ và đội ngũ kỹ thuật tại Việt Nam, bài học từ dữ liệu thực tế này đòi hỏi sự điều chỉnh chiến lược:
- Không đánh giá năng suất bằng số dòng mã: Cần tập trung đo lường giá trị thực tế chuyển giao tới người dùng, như số lượng tính năng chạy ổn định hoặc thời gian phát hành tính năng, thay vì tán dương số lượng commit hay PR.
- Đầu tư vào hạ tầng kiểm thử tự động: Thay vì dồn toàn bộ tải kiểm tra lên mắt thường của kỹ sư, các nhóm phát triển cần bổ sung bộ kiểm thử đơn vị (unit test), kiểm thử tích hợp (integration test) và phân tích tĩnh chuyên sâu để chặn lỗi cơ bản trước khi mở pull request.
- Chia nhỏ quy trình và giới hạn phạm vi PR: Đặt ra quy tắc nghiêm ngặt về kích thước pull request được tạo bởi AI, tránh tình trạng gom hàng chục tệp tin vào một lần nộp khiến người bình duyệt choáng ngợp.
Đầu tư vào AI lập trình chỉ thực sự mang lại lợi nhuận khi doanh nghiệp đồng thời nâng cấp năng lực kiểm chứng và tổ chức lại quy trình làm việc tương xứng.
Nguồn tham khảo: Nghiên cứu của Fiona Chen và James Stratton (Đại học Harvard), Ars Technica, TechRadar, Forkast News