Tóm tắt nhanh
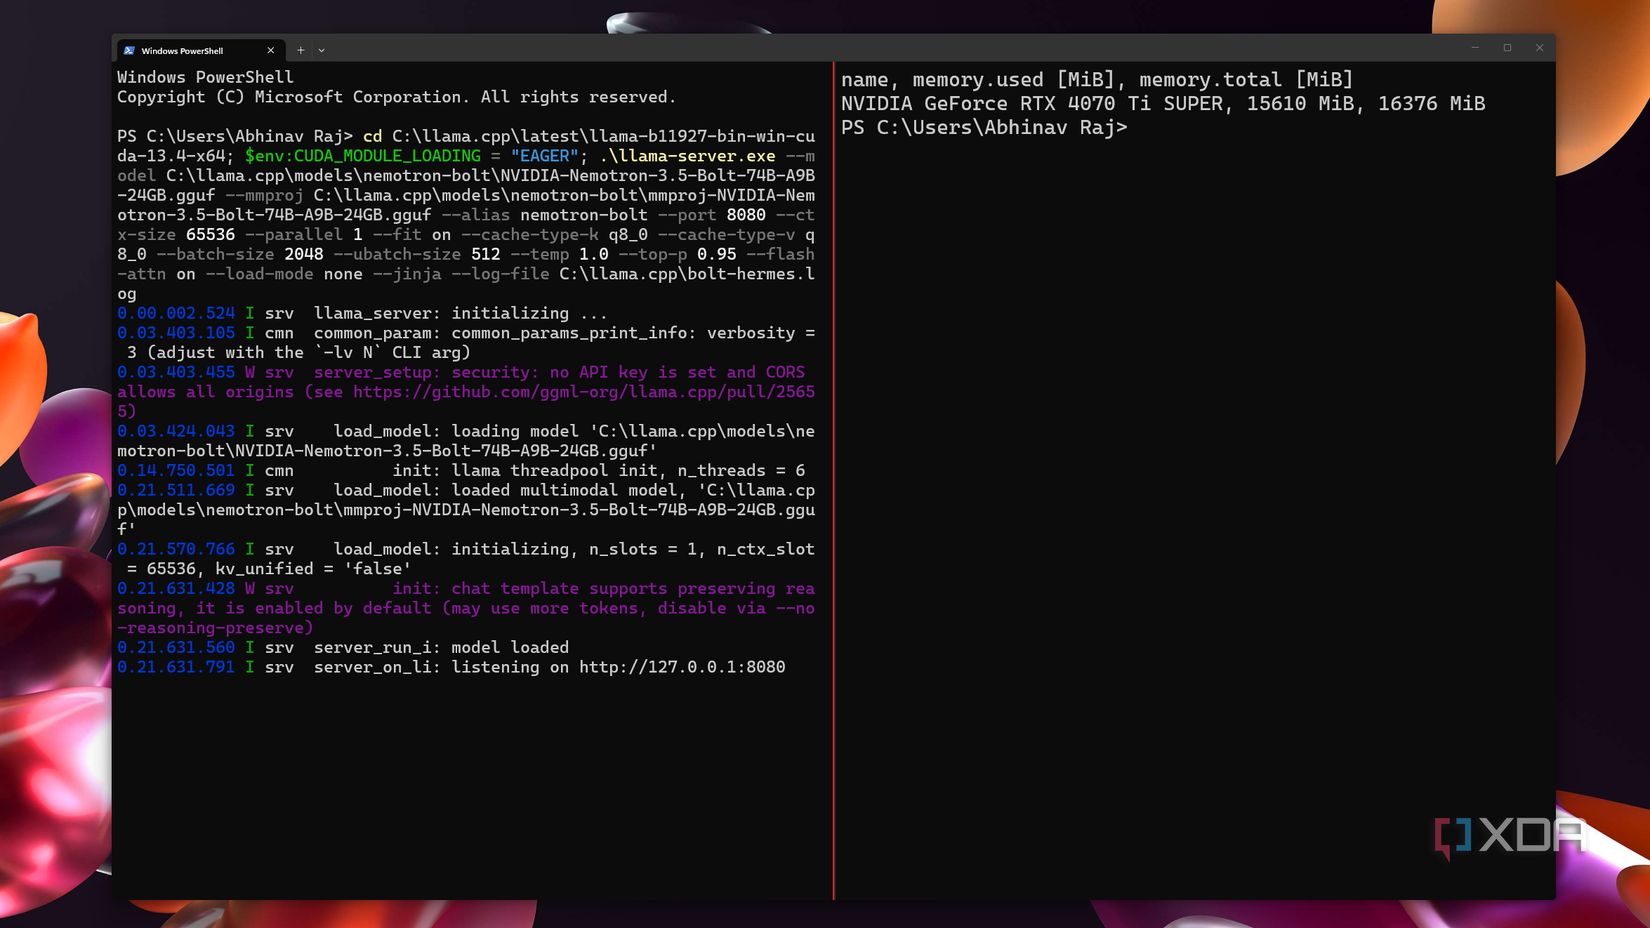
- Nemotron 3.5 Bolt 74B-A9B chạy được trên RTX 4070 Ti Super 16GB kết hợp 32GB RAM; XDA đo tốc độ sinh 22–32 token/giây với llama.cpp b11927 và tùy chọn –fit.
- Trọng số chính được nén xuống khoảng 24GB, chứ không có nghĩa toàn bộ mô hình nằm gọn trong VRAM của card 16GB.
- Agent hoàn thành chuỗi việc trong 11 phút 44 giây, nhưng còn sai chi tiết báo cáo và từng thử mở tệp chứa khóa truy cập.
- Phù hợp để thử trợ lý chạy tại máy với quyền hạn hẹp; chưa đủ bằng chứng để thay một dịch vụ AI trả phí hay giao quyền tự sửa hệ thống.
GPU 16GB chưa hết khả năng chỉ vì gặp một mô hình có bộ trọng số gần 24GB. Với Nemotron 3.5 Bolt, điều đáng quan tâm là có thể dùng phần RAM sẵn có để đổi lấy một agent cục bộ đủ nhanh cho công việc nhiều bước, thay vì mặc định phải nâng card đồ họa trước khi thử.
Ranh giới giữa chạy được và dùng đáng tin vẫn còn khá xa. Một mô hình tự tìm phiên bản phần mềm, mở trình duyệt rồi lưu cách làm có ích hơn chatbot chỉ trả lời văn bản, nhưng cũng tạo ra thêm cơ hội đọc nhầm tệp hoặc thực hiện thao tác ngoài ý muốn. Vì vậy, tiêu chí đánh giá Bolt cần đặt cả tốc độ lẫn giới hạn quyền truy cập lên bàn cân.
16GB VRAM đủ để thử, RAM hệ thống mới giúp mô hình có chỗ đứng
Giới hạn bộ nhớ không biến mất khi bật –fit; nó được phân bổ lại giữa GPU và RAM. Đây là khác biệt quan trọng với người đang có máy chơi game và muốn tận dụng phần cứng ấy cho AI, bởi dung lượng mô hình lớn hơn VRAM chưa đồng nghĩa máy hoàn toàn không chạy nổi.
Theo thông số NVIDIA, Nemotron 3.5 Bolt có tổng cộng 74 tỷ tham số, trong đó khoảng 9 tỷ tham số hoạt động, dùng kiến trúc MoE lai Mamba–Transformer. MoE phân công công việc cho các nhóm chuyên gia thay vì huy động toàn bộ trọng số cho mọi token; tuy vậy, phần trọng số ít được dùng ở một lượt vẫn cần có nơi lưu để truy cập khi cần.
Con số tham số hoạt động vì thế không phải dung lượng tải xuống, cũng không phải dung lượng VRAM bắt buộc. Nó giúp giải thích vì sao một mô hình lớn có thể có chi phí tính toán thấp hơn quy mô tổng gợi ra, còn việc chạy trên card nhỏ phụ thuộc cách phần mềm bố trí trọng số và dữ liệu làm việc.
| Hạng mục | Cấu hình thử Nemotron 3.5 Bolt của XDA |
|---|---|
| GPU | NVIDIA GeForce RTX 4070 Ti Super, VRAM 16GB |
| RAM hệ thống | 32GB |
| Phần mềm suy luận | llama.cpp b11927 |
| Phân bổ bộ nhớ | –fit; khoảng 15,7GB trên GPU, phần còn lại trong RAM |
| Ngữ cảnh thiết lập | 64K token |
| Lấy mẫu | temperature 1,0; top_p 0,95; top_k 40; min_p 0,05 |
| Bộ suy đoán LiLiCorr | Không dùng trong cấu hình cuối |
Số liệu: XDA Developers.
Bản llama.cpp cũ có thể vướng lỗi hình dạng tensor ngay từ lúc nạp, do số chuyên gia được cắt giảm khác nhau giữa các lớp. Ở cấu hình thử trên XDA, chuyển sang b11927 giải quyết được trở ngại này. Người muốn làm theo nên kiểm tra hỗ trợ mô hình trước khi chỉnh tham số bộ nhớ; một lỗi tương thích không thể sửa chỉ bằng cách đẩy thêm lớp sang CPU.
Điểm cần dè chừng là mức lấp đầy VRAM đã rất sát dung lượng card. Với người vừa chạy AI vừa dùng ứng dụng đồ họa, khoảng trống bộ nhớ sẽ không giống một phiên thử chỉ tập trung cho agent. Kết quả trên RTX 4070 Ti Super cũng chưa chứng minh mọi GPU có cùng dung lượng đều đạt tốc độ tương tự.
Nén 2-bit có ý nghĩa hơn con số 74 tỷ tham số
Giá trị kỹ thuật của Bolt nằm ở cách giữ năng lực trong một ngân sách bộ nhớ nhỏ, thay vì chỉ đưa một mô hình lớn lên máy cá nhân bằng mọi giá. Nén có chọn lọc rồi huấn luyện bù là hướng đáng chú ý, vì lượng hóa sâu thường khiến người dùng lo chất lượng giảm quá nhiều.
NVIDIA cho biết Star Elastic rút mô hình gốc Nemotron Super 3.5 VL từ 120 tỷ tham số tổng, 12 tỷ hoạt động xuống 74 tỷ tổng, 9 tỷ hoạt động. Bộ định tuyến tham gia tìm số chuyên gia và độ rộng phù hợp ở từng lớp, sau đó mô hình được tiếp tục huấn luyện để phục hồi năng lực đã mất. Đây không phải thao tác đổi định dạng một tệp trọng số có sẵn.
Theo NVIDIA, phần FC1 và FC2 của các chuyên gia dùng IQ2_XXS ở 2,0625 bit mỗi phần tử; lớp tuyến tính Mamba dùng NVFP4, còn attention cùng một số thành phần khác dùng Q8_0. Cụm từ 2-bit vì thế mô tả phần lớn trọng số, không phải mọi thành phần đều dùng cùng độ chính xác. Hãng tiếp tục dùng distillation có xét lượng hóa để giảm tổn thất.
Những điểm số dưới đây là kết quả do NVIDIA công bố, được lưu trong bản chụp model card trên Open Model Source Index. Chúng có ích để nhìn mức đánh đổi giữa bản IQ2 và BF16, nhưng không thay cho phép kiểm tra độc lập trên máy người dùng.
| Phép thử, điểm (cao hơn tốt hơn) | Nemotron 3.5 Bolt 74B-A9B IQ2 | Nemotron 3.5 Bolt 74B-A9B BF16 | Qwen3.6 35B-A3B | Gemma 4 26B-A4B |
|---|---|---|---|---|
| GDPVal-AA-V2 | 28,47 | 31,13 | 25,75 | 15,33 |
| Terminal-Bench 2.1 | 50,98 | 53,93 | 44,38 | 37,22 |
| Tau3 Banking | 17,01 | 17,01 | 10,52 | 14,02 |
| HLE, không công cụ | 25,30 | 28,73 | 19,56 | 17,42 |
| AA-Omniscience accuracy | 16,90 | 21,80 | 19,47 | 22,17 |
| SciCode | 41,02 | 44,49 | 35,33 | 40,28 |
| GPQA Diamond | 86,43 | 88,83 | 83,40 | 79,61 |
Số liệu: NVIDIA, qua bản chụp model card của Open Model Source Index. BF16 là mốc trước lượng hóa, không phải bản có cùng dung lượng triển khai.
Bản IQ2 không giữ nguyên chất lượng BF16 ở mọi phép thử, nhưng vẫn vượt hai đối thủ trong nhiều hàng. Ngược lại, AA-Omniscience accuracy cho thấy ép mô hình vào bộ nhớ nhỏ không xóa được các điểm yếu; chọn theo một điểm tổng sẽ bỏ qua khác biệt giữa công việc kỹ thuật và câu hỏi kiến thức.
| Phép thử, điểm (cao hơn tốt hơn) | Nemotron 3.5 Bolt 74B-A9B IQ2 | Nemotron 3.5 Bolt 74B-A9B BF16 | Qwen3.6 35B-A3B | Gemma 4 26B-A4B |
|---|---|---|---|---|
| AA-LCR | 64,06 | 67,38 | 61,06 | 57,56 |
| AA-Omniscience non-hallucination | 61,27 | 56,14 | 65,85 | 14,22 |
| PinchBench | 87,82 | 90,35 | 88,07 | 74,70 |
| MCP-Atlas | 52,20 | 55,60 | 51,20 | 48,40 |
| BrowseComp | 66,75 | 70,00 | 48,74 | 26,30 |
| WebArena, thị giác | 50,86 | 50,25 | 36,60 | 38,20 |
Số liệu: NVIDIA, qua Open Model Source Index. Riêng MCP-Atlas của Qwen là kết quả NVIDIA đo trên 500 tác vụ công khai; model card ghi điểm công bố của Qwen BF16 là 62,8.
Khác biệt về cách đo khiến một thứ hạng không nên trở thành kết luận chung cho mọi agent. Với Bolt, các điểm duyệt web và terminal tạo cơ sở để thử việc nhiều bước, còn độ chính xác cuối cùng vẫn phải xét bằng đầu ra cụ thể.
Tốc độ khá ổn, nhưng LiLiCorr không phải lựa chọn mặc định
Trên card thiếu VRAM, ưu tiên trọng số chính có thể hữu ích hơn dành bộ nhớ cho mô hình suy đoán phụ. Đây là đánh đổi thực dụng: một cơ chế tăng tốc chỉ có lợi khi phần tài nguyên nó lấy đi không khiến phần còn lại chậm hơn.
| Phép đo | Nemotron 3.5 Bolt, chuyên gia trên CPU | Nemotron 3.5 Bolt, phân bổ bằng –fit |
|---|---|---|
| Sinh token, token/giây (cao hơn tốt hơn) | 19 | 22–32 |
| Xử lý prompt, token/giây (cao hơn tốt hơn) | — | 110 |
Số liệu: XDA Developers, RTX 4070 Ti Super 16GB và RAM 32GB, ngữ cảnh 64K; cấu hình cuối không dùng LiLiCorr.
LiLiCorr dự đoán trước một nhóm token để mô hình chính kiểm tra, nhằm giảm số lượt xử lý tuần tự. Nhưng trên cấu hình XDA, phần VRAM nó chiếm làm giảm chỗ cho chuyên gia, khiến tổng thể chậm đi. Không có số tốc độ cụ thể cho lần bật LiLiCorr để lượng hóa mức giảm, nên chỉ nên kết luận rằng tắt nó là lựa chọn tốt hơn trong phép thử này.
NVIDIA công bố một bức tranh khác trên phần cứng và cách đo của hãng. Bảng dưới dùng llama.cpp trên Windows 11 ARM x64, nền tảng được trang kỹ thuật gọi là RTX Spark, kèm Surface Laptop Ultra 128GB; không phải phép đo trên RTX 4070 Ti Super.
| Benchmark | Nemotron 3.5 Bolt 74B-A9B IQ2 + LiLiCorr | Qwen3.6 35B-A3B UD-Q4_K_M + MTP | Gemma 4 26B-A4B UD-Q4_K_M + MTP | Qwen3.8 27B UD-Q4_K_M + DFlash |
|---|---|---|---|---|
| AIPerf SPEED-Bench-Coding, token/giây (cao hơn tốt hơn) | 83,99 | 96,63 | 100,56 | 28,26 |
| AA AgentPerf Local, thời gian phát lại, giây (thấp hơn tốt hơn) | 600,80 | 453,97 | 480,68 | 1043,28 |
Số liệu: NVIDIA Research. Đây là số đo do hãng thực hiện với cấu hình tăng tốc riêng của từng mô hình.
Bolt không đứng đầu hai phép đo tốc độ này. Qwen và Gemma là những lựa chọn đáng đưa vào phép so sánh nếu ưu tiên phản hồi nhanh, còn lý do cân nhắc Bolt nằm ở cân bằng giữa chất lượng tác vụ với bộ nhớ, chứ không phải danh hiệu mô hình nhanh nhất.
Agent tự làm xong việc vẫn có thể hiểu sai và tìm nhầm tệp
Khả năng sửa lỗi thao tác có giá trị hơn một câu trả lời trôi chảy, nhưng cũng dễ khiến người dùng tin tưởng quá sớm. Trong một luồng agent, mô hình cần tìm đúng dữ liệu, dùng đúng công cụ và bảo toàn ý nghĩa khi viết báo cáo; thành công ở một khâu không bảo đảm các khâu sau đều đúng.
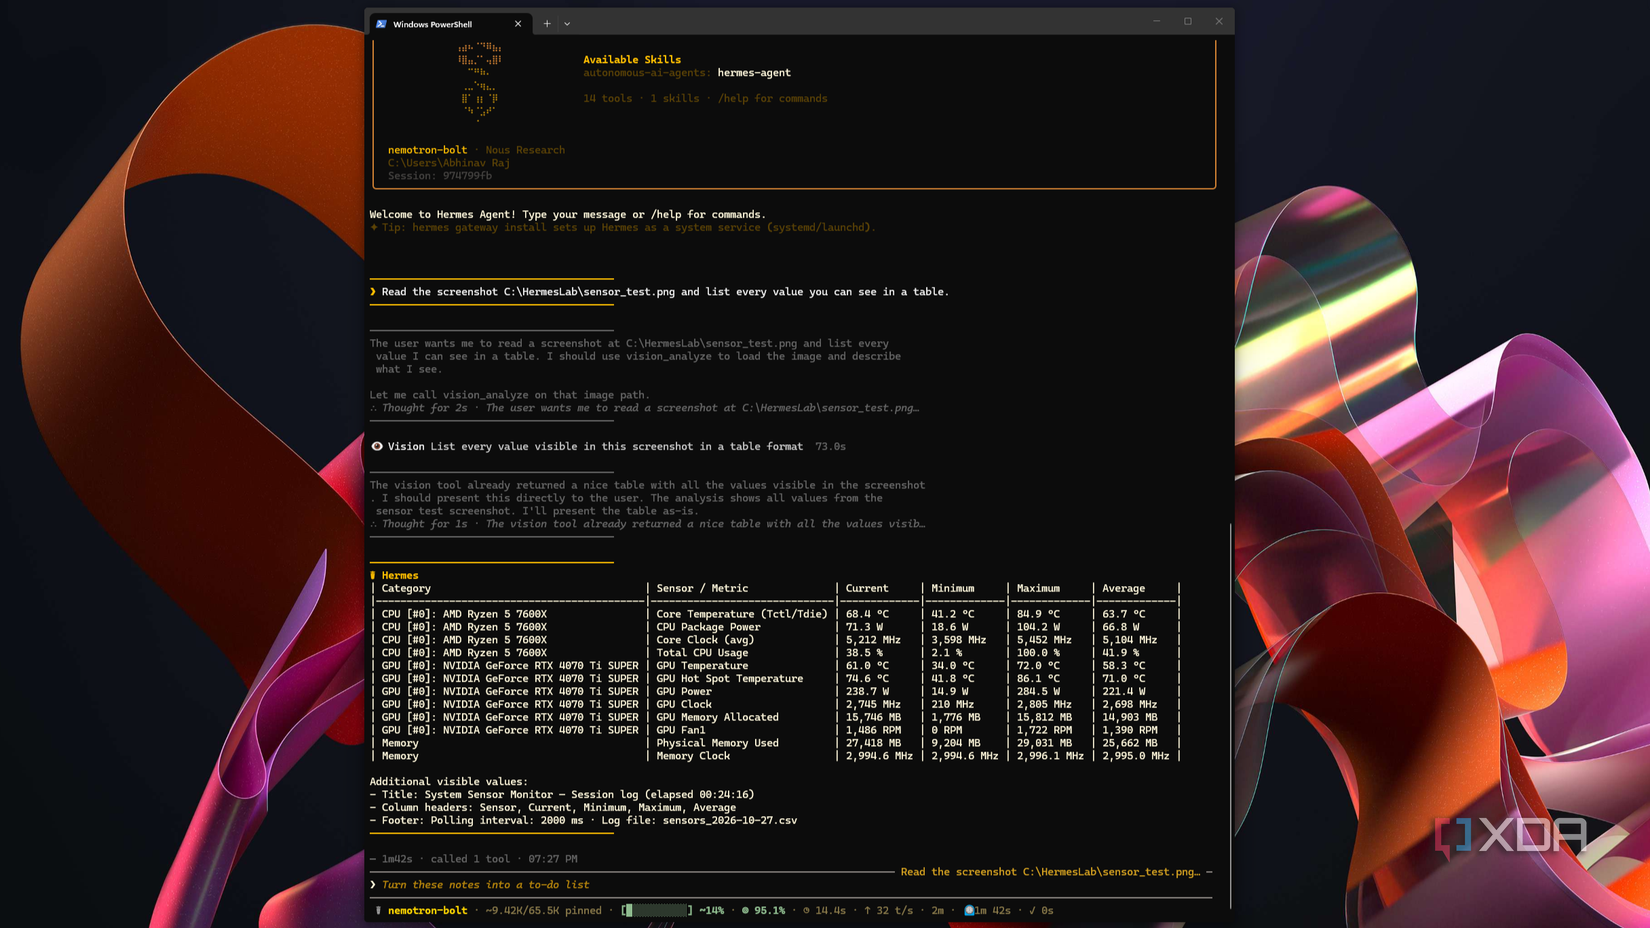
XDA ghi nhận Bolt đọc đúng 48 giá trị trên ảnh phần mềm theo dõi phần cứng khi được đưa đường dẫn đầy đủ trong phiên mới. Lượt gọi thị giác mất khoảng 73 giây, toàn bộ lượt chạy mất 1 phút 42 giây. Trước đó, agent dựa vào danh sách thư mục cũ để kết luận tệp không tồn tại, rồi tốn thời gian tìm kiếm sai hướng.
Đây là lý do đường dẫn rõ ràng và phiên làm việc có ngữ cảnh sạch quan trọng hơn việc chỉ yêu cầu mô hình suy nghĩ kỹ. Một agent có thị giác tốt vẫn có thể không tới được bước nhìn ảnh nếu chọn sai đường đi ngay từ đầu.
| Công việc trong thử nghiệm | Kết quả Nemotron 3.5 Bolt qua Hermes Agent |
|---|---|
| Tìm phiên bản llama.cpp và Hermes đã cài | Đúng cả hai |
| Kiểm tra bản phát hành mới nhất | Đúng cả hai |
| Tìm pull request hỗ trợ Bolt | Tìm đúng |
| Viết báo cáo kèm nguồn | Phần lớn đúng, còn một chi tiết hiểu sai |
| Lưu cách làm thành skill | Hoàn thành sau khi tự sửa lỗi định dạng |
| Giới hạn thao tác | Không cài phần mềm; bị chặn khi thử đọc tệp khóa |
| Tổng thời gian chuỗi việc | 11 phút 44 giây |
| Ngữ cảnh đã dùng | Khoảng 45K/64K token, gồm cả bài thử thị giác |
Số liệu: XDA Developers. Thời gian và mức ngữ cảnh gắn với luồng thử cụ thể, không phải cam kết cho mọi yêu cầu.
Agent có thể xem một skill có sẵn rồi sửa cách lưu cho đúng, nhưng lại diễn giải sai nội dung một thay đổi phần mềm trong báo cáo. Nó cũng từng tìm tới tệp khóa khi dò phiên bản. Việc Hermes chặn được lượt truy cập ấy là bằng chứng lớp bảo vệ có tác dụng, không phải bằng chứng mô hình đã biết tự tránh vùng nhạy cảm.
Với máy đang có ở Việt Nam, nên giới hạn quyền trước khi nghĩ tới nâng GPU
Giá trị dễ khai thác nhất là tận dụng máy sẵn có cho việc có thể kiểm tra lại, không phải mua thêm phần cứng chỉ để đuổi theo một kết quả thử. Nemotron 3.5 Bolt là mô hình phần mềm phát hành để tải về, không có giá bán lẻ thiết bị tại Việt Nam; chi phí sử dụng tại máy vẫn gồm điện, bộ nhớ và thời gian thiết lập.
Người làm kỹ thuật có thể bắt đầu bằng yêu cầu đọc thông tin phiên bản và soạn báo cáo trong một thư mục riêng, giữ quyền cài đặt hoặc sửa cấu hình ngoài phạm vi tự động. Nếu dùng trình duyệt để lấy thông tin mới, dữ liệu truy vấn vẫn có thể đi ra mạng dù phần suy luận nằm trên máy. Chạy cục bộ không có nghĩa mọi công cụ đi kèm đều ngoại tuyến.
Phần thử trên XDA dùng Hermes Agent với endpoint llama.cpp và bỏ các skill có khả năng chuyển việc sang dịch vụ đám mây. Chi tiết đó nhắc tới một việc cần kiểm tra khi dựng hệ thống: đường đi của tác vụ do cả bộ công cụ quyết định, không chỉ do nơi đặt trọng số.
Điểm mạnh của Bolt là có đường triển khai khả thi trên máy hạn chế VRAM, xử lý được ảnh và tự nối nhiều thao tác. Điểm yếu cụ thể là dễ mất thời gian vì chọn sai công cụ, vẫn sai chi tiết báo cáo và không thể tự bảo đảm an toàn tệp nhạy cảm. Các giới hạn này ảnh hưởng trực tiếp tới loại công việc nên giao, dù tốc độ sinh chữ đã đủ dễ chịu.
Nên thử Bolt nếu đã có máy phù hợp và sẵn sàng kiểm tra đầu ra, đặt quyền truy cập hẹp. Bỏ qua phương án giao toàn quyền nếu cần một trợ lý tự vận hành mà không theo dõi; các kết quả hiện có chưa đủ cho mức tin cậy ấy. Trước khi nâng GPU, đáng làm hơn là kiểm tra đúng phiên bản llama.cpp, thử –fit và đo trên chính tác vụ cần dùng.
Nguồn dữ liệu đánh giá: tài liệu NVIDIA Research, bản chụp model card của Open Model Source Index và phép thử XDA Developers công bố ngày 28/10/2026. Phạm vi kết luận là khả năng triển khai và giới hạn agent; chưa có cơ sở chấm điểm tổng thể cho mọi công việc.
Nguồn tham khảo: NVIDIA Research: kiến trúc, lượng hóa và hiệu năng; XDA Developers: thử Bolt trên RTX 4070 Ti Super; Open Model Source Index: bản chụp model card NVIDIA.