Tóm tắt nhanh
- Scott Hanselman phát hành gputaskman, tiện ích mã nguồn mở theo giấy phép MIT để theo dõi GPU từ dòng lệnh.
- Công cụ hiển thị bộ nhớ và hoạt động GPU theo tiến trình, kèm thông tin model AI cục bộ khi có đủ bằng chứng.
- Trên Windows, cách tính Local Usage và Non Local Usage giúp tránh cộng trùng một số bề mặt đồ họa được chia sẻ.
- Phần nhận diện model và ước tính KV cache có giới hạn; đây không phải công cụ đọc nội dung VRAM.
Scott Hanselman, kỹ sư Microsoft, phát hành gputaskman để trả lời câu hỏi mà Task Manager thường bỏ ngỏ: tiến trình nào đang dùng bộ nhớ GPU, và phần bộ nhớ ấy thuộc model, bộ đệm hay ứng dụng nào? Tiện ích chạy trong terminal, hỗ trợ Windows, Linux, WSL và macOS trên Apple Silicon.
Điểm đáng chú ý không nằm ở một con số VRAM tổng khác, mà ở việc gputaskman cố phân biệt dữ liệu hệ điều hành đo được với thông tin công cụ chỉ suy ra từ file model, runtime hoặc log. Với người chạy AI cục bộ, ranh giới đó quan trọng: thấy tên một file GGUF trong tiến trình chưa đồng nghĩa model đang nằm hoàn toàn trên GPU.
Cách tính bộ nhớ theo tiến trình có thể tránh cộng trùng
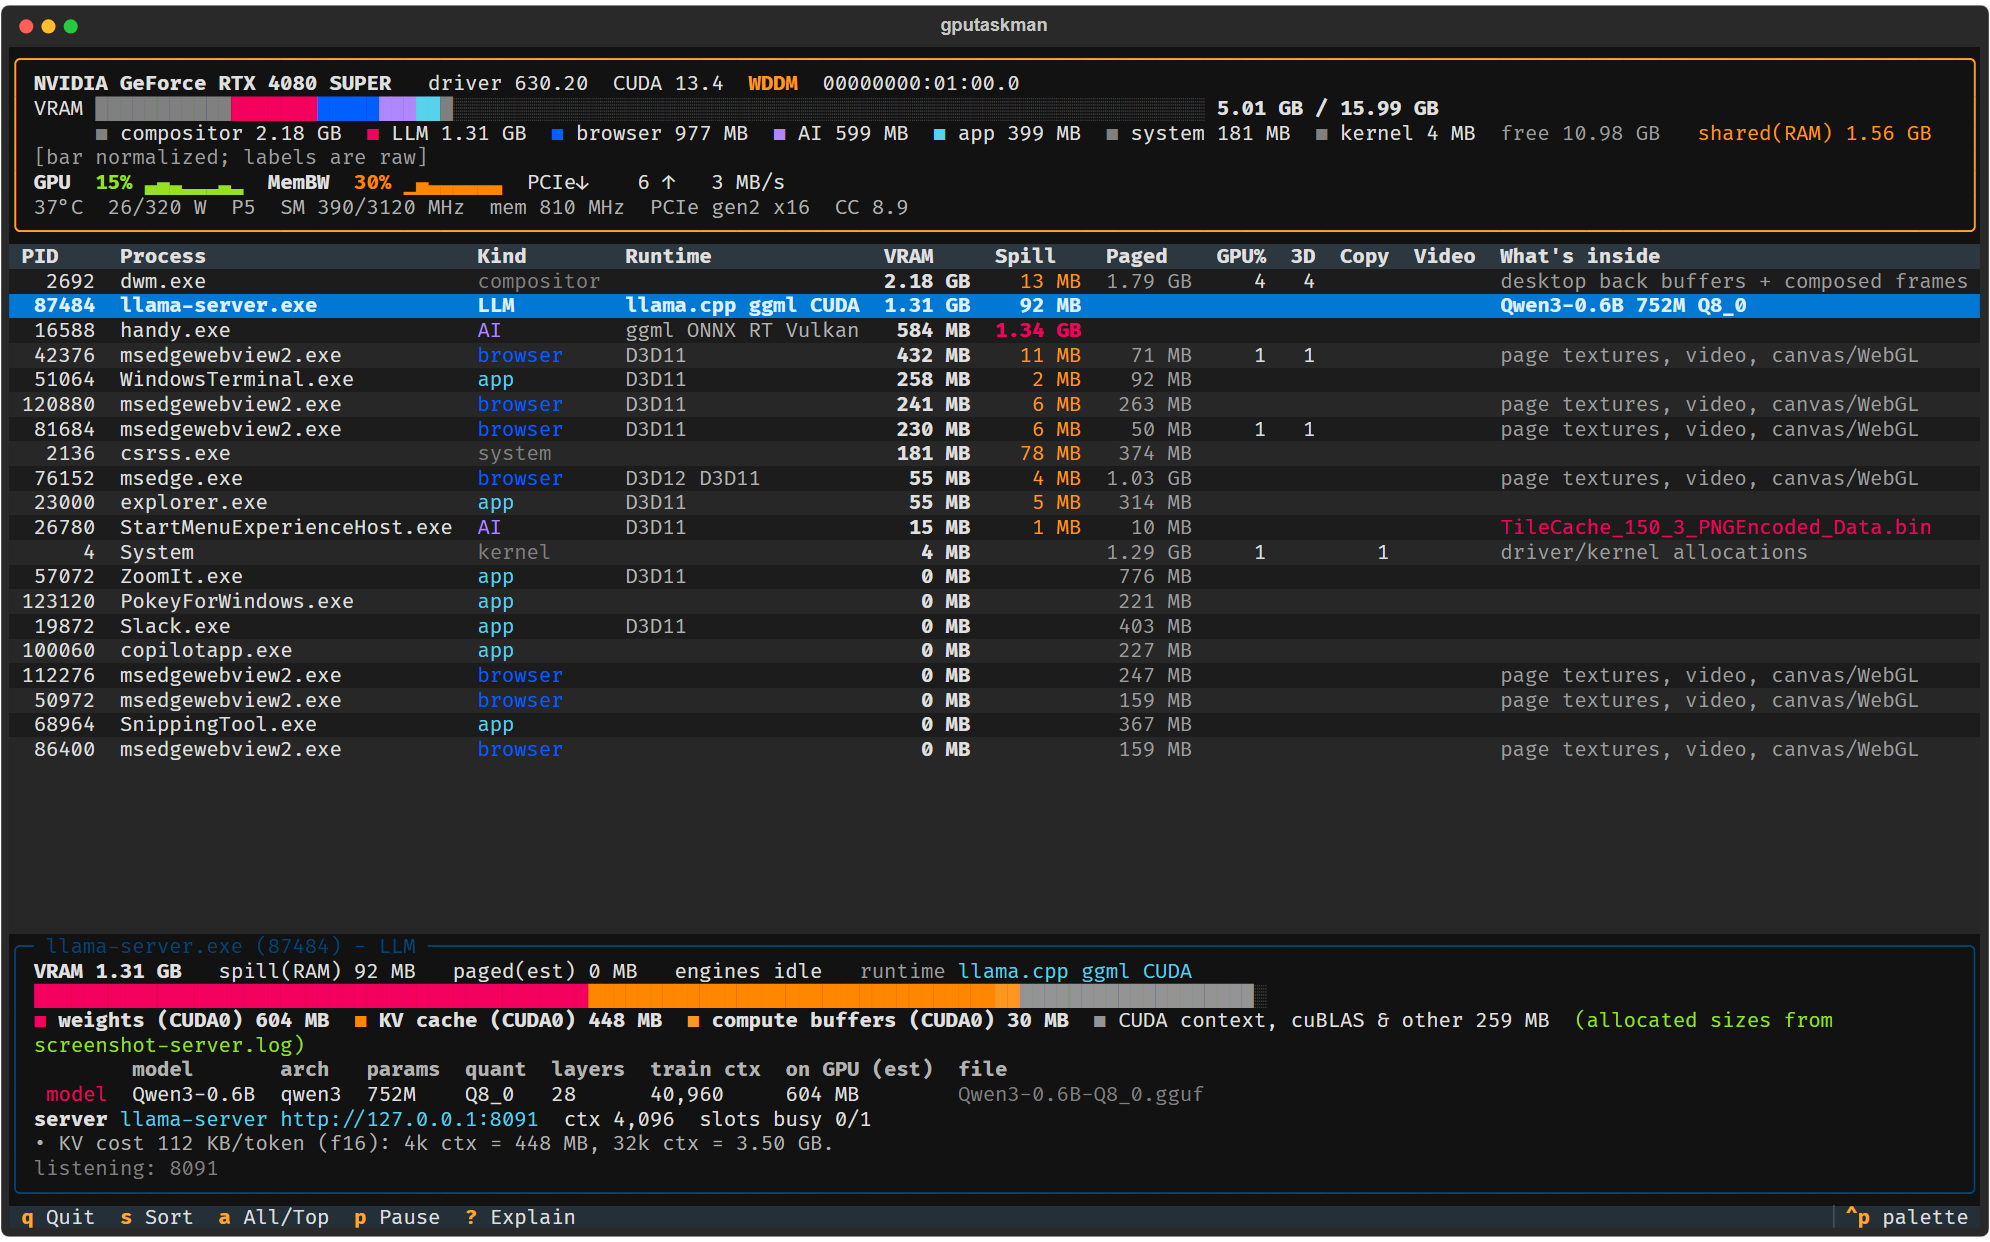
Task Manager có thể khiến tổng bộ nhớ được cộng theo từng tiến trình cao hơn mức thực tế, do một số tài nguyên đồ họa được chia sẻ. Trên Windows, Dedicated Usage của một tiến trình có thể bao gồm tài nguyên dùng chung; cùng một bề mặt có thể xuất hiện dưới ứng dụng, csrss.exe và dwm.exe. Cộng các dòng ấy như những vùng nhớ độc lập sẽ đếm lặp.
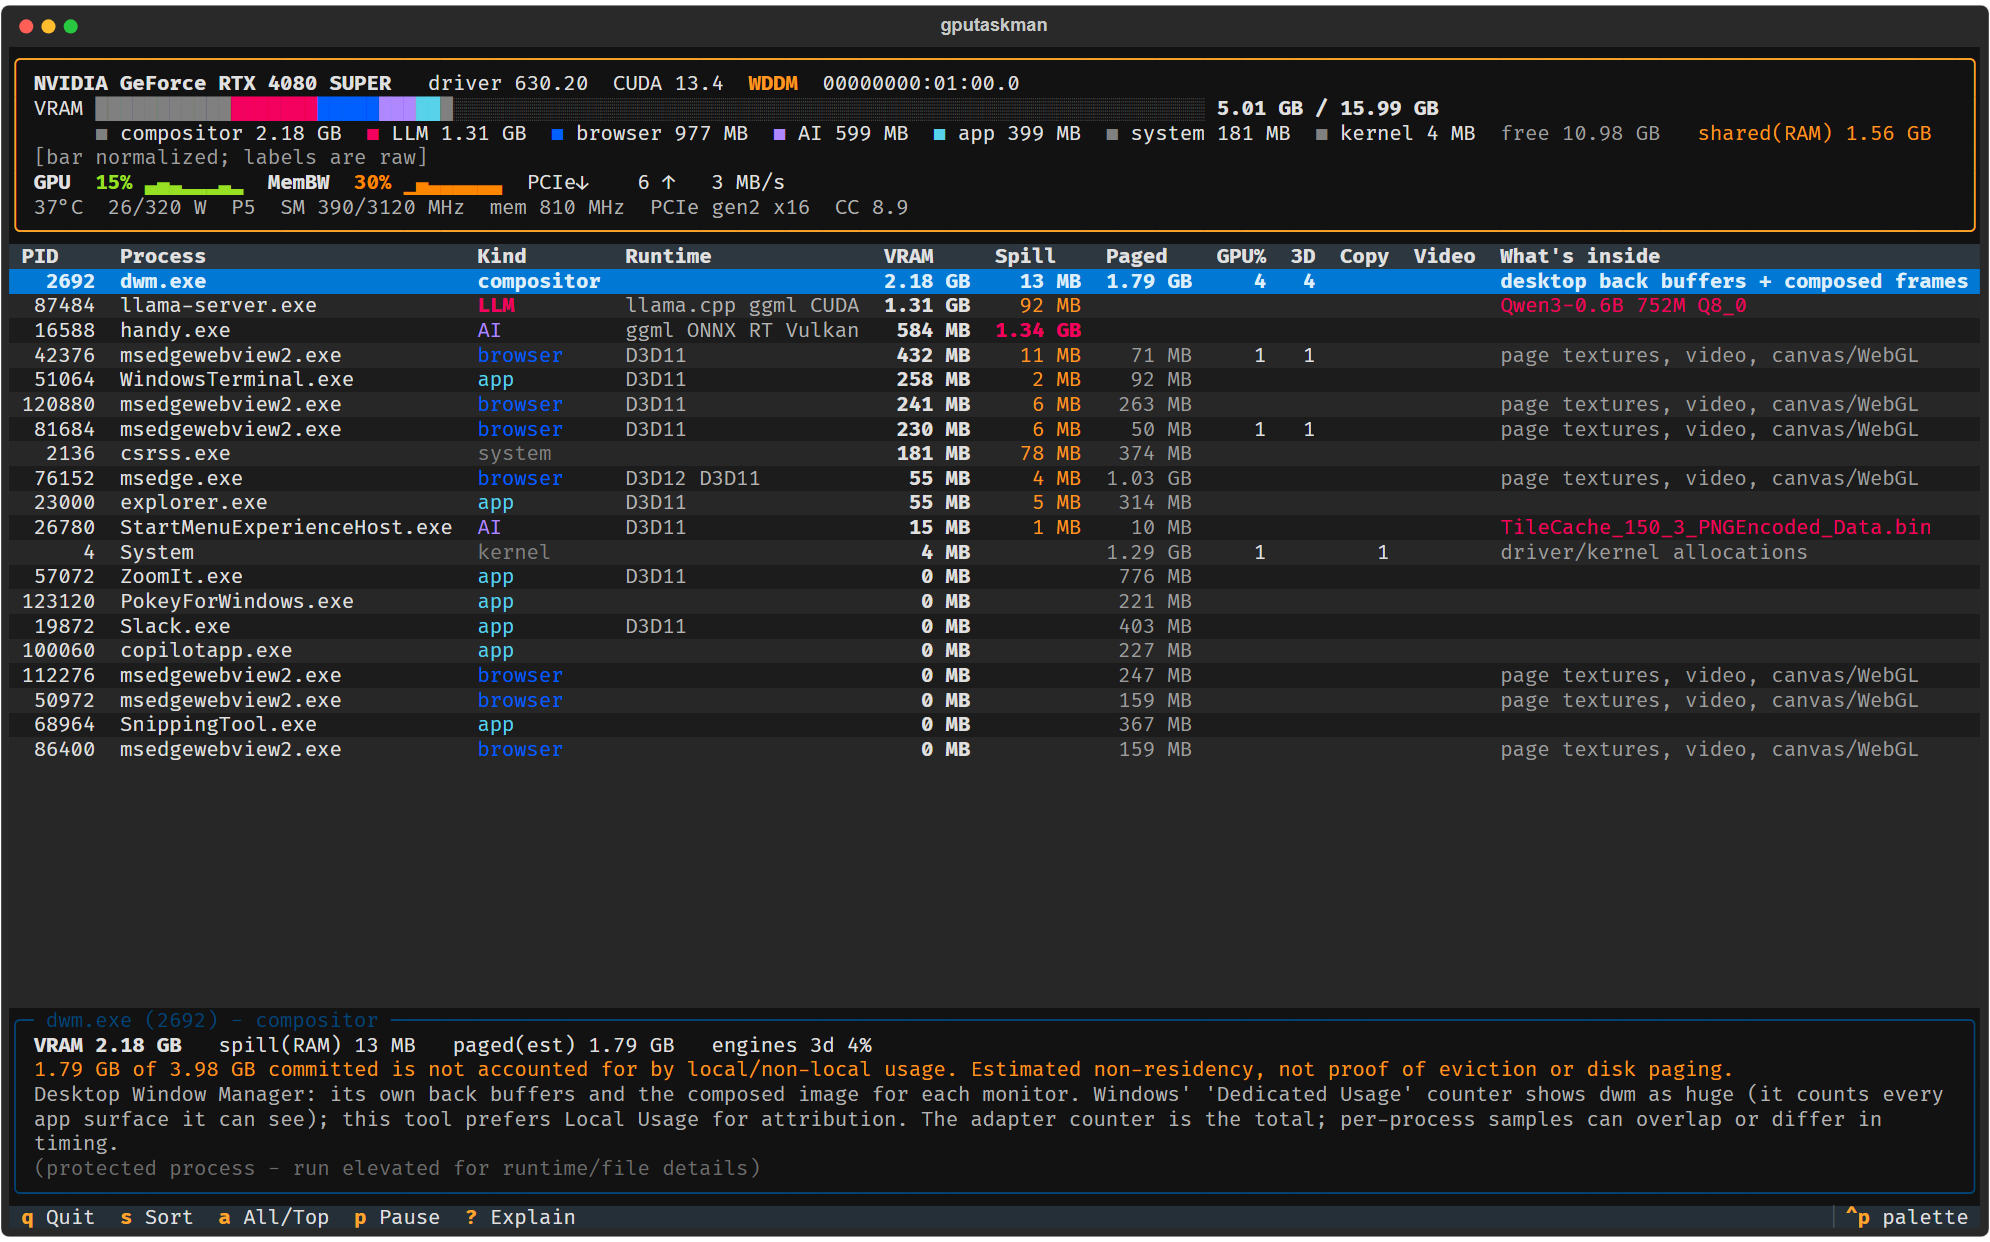
gputaskman ưu tiên Local Usage và Non Local Usage, rồi mới dùng Dedicated Usage và Shared Usage nếu không thể cộng các bộ đếm ưu tiên. Trong một mẫu đo được dự án mô tả, con số cũ của DWM khoảng 15,3 GiB, trong khi Local Usage khoảng 1,4 GiB. Đây là kết quả trên một hệ thống, không phải bảo đảm mọi driver đều cho tổng tiến trình khớp chính xác với bộ nhớ của card.
Phần mềm còn hiển thị mức sử dụng theo thiết bị, hoạt động GPU, lưu lượng PCIe, nhiệt độ, công suất và xung video khi phần cứng cùng driver cung cấp. Các số đo thiếu sẽ để trống hoặc hiện N/A; người dùng không nên đọc một ô trống thành mức 0.
Model weights và KV cache được tách khỏi số đo trực tiếp
Với workload AI, gputaskman có thể tìm runtime như CUDA, HIP, Vulkan hay ONNX Runtime, đọc file model được ánh xạ vào tiến trình và dùng metadata GGUF hoặc log tương thích để phân loại model weights, KV cache và compute buffers. Công cụ cũng có thể lấy một số trạng thái từ API cục bộ của Ollama, LM Studio hoặc llama.cpp.
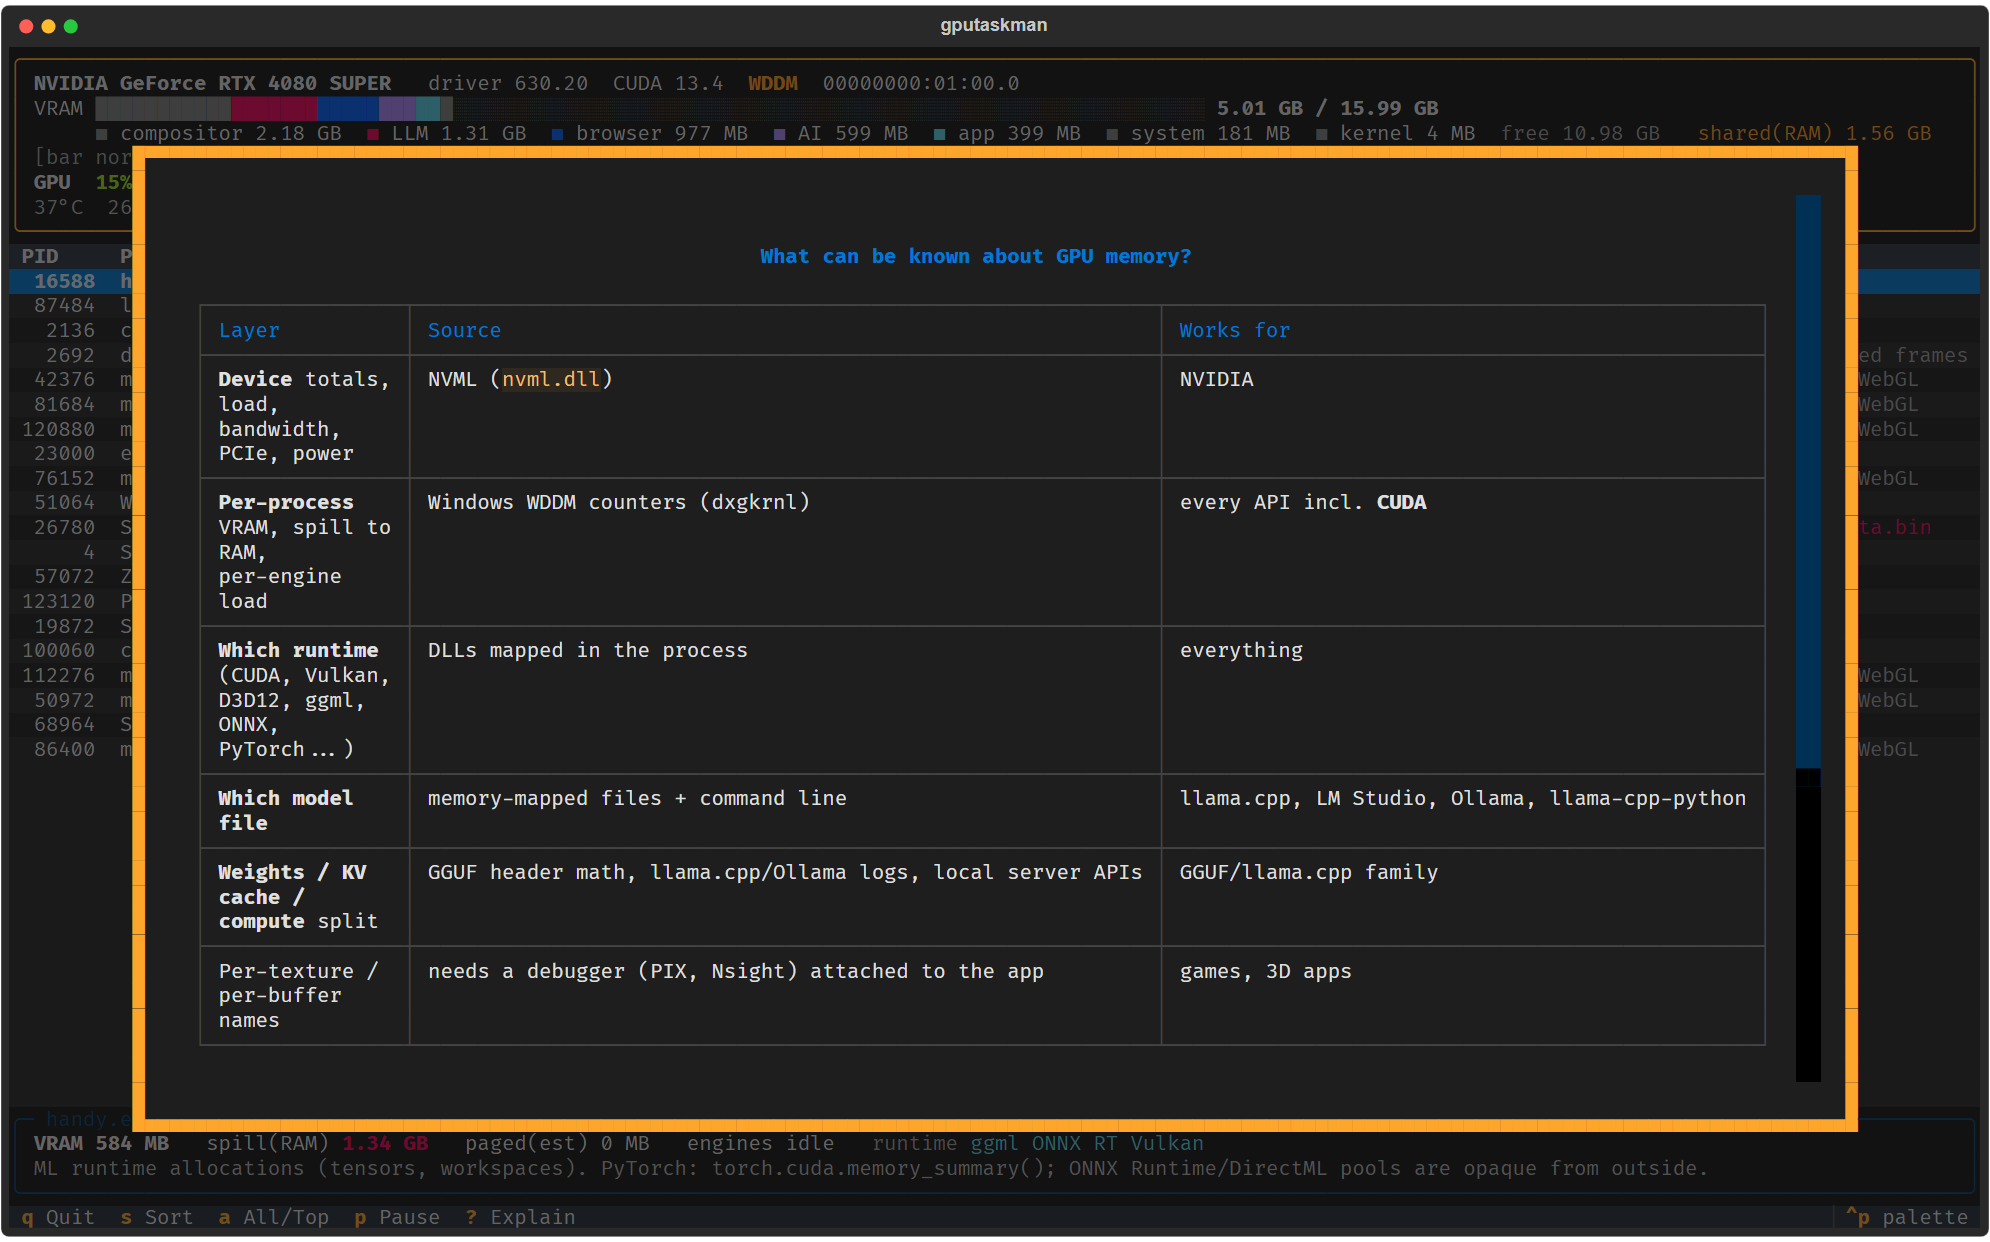
Những phần này không có cùng độ chắc chắn. Bộ đếm GPU theo tiến trình là số liệu hệ thống; dung lượng buffer từ log là thông tin runtime báo; còn KV cache suy ra từ metadata là ước tính. Một DLL CUDA chỉ cho thấy runtime có mặt, không chứng minh model cụ thể đang chạy. Tương tự, file model được ánh xạ không chứng minh nó đang nằm trên VRAM hay đang được sử dụng.
Khác biệt ấy thấy rõ khi đổi context của một model: ở ví dụ dự án ghi lại với Gemma 3 270M, ước tính KV cache tăng 504 MB khi đổi từ context 4.096 sang 32.768, nhưng bộ nhớ dedicated đo được chỉ tăng 83 MB. Kiến trúc sliding-window khiến phần ước tính có thể cao hơn mức cấp phát thực tế. Con số giúp khoanh vùng thay đổi, không thay thế phép đo runtime.
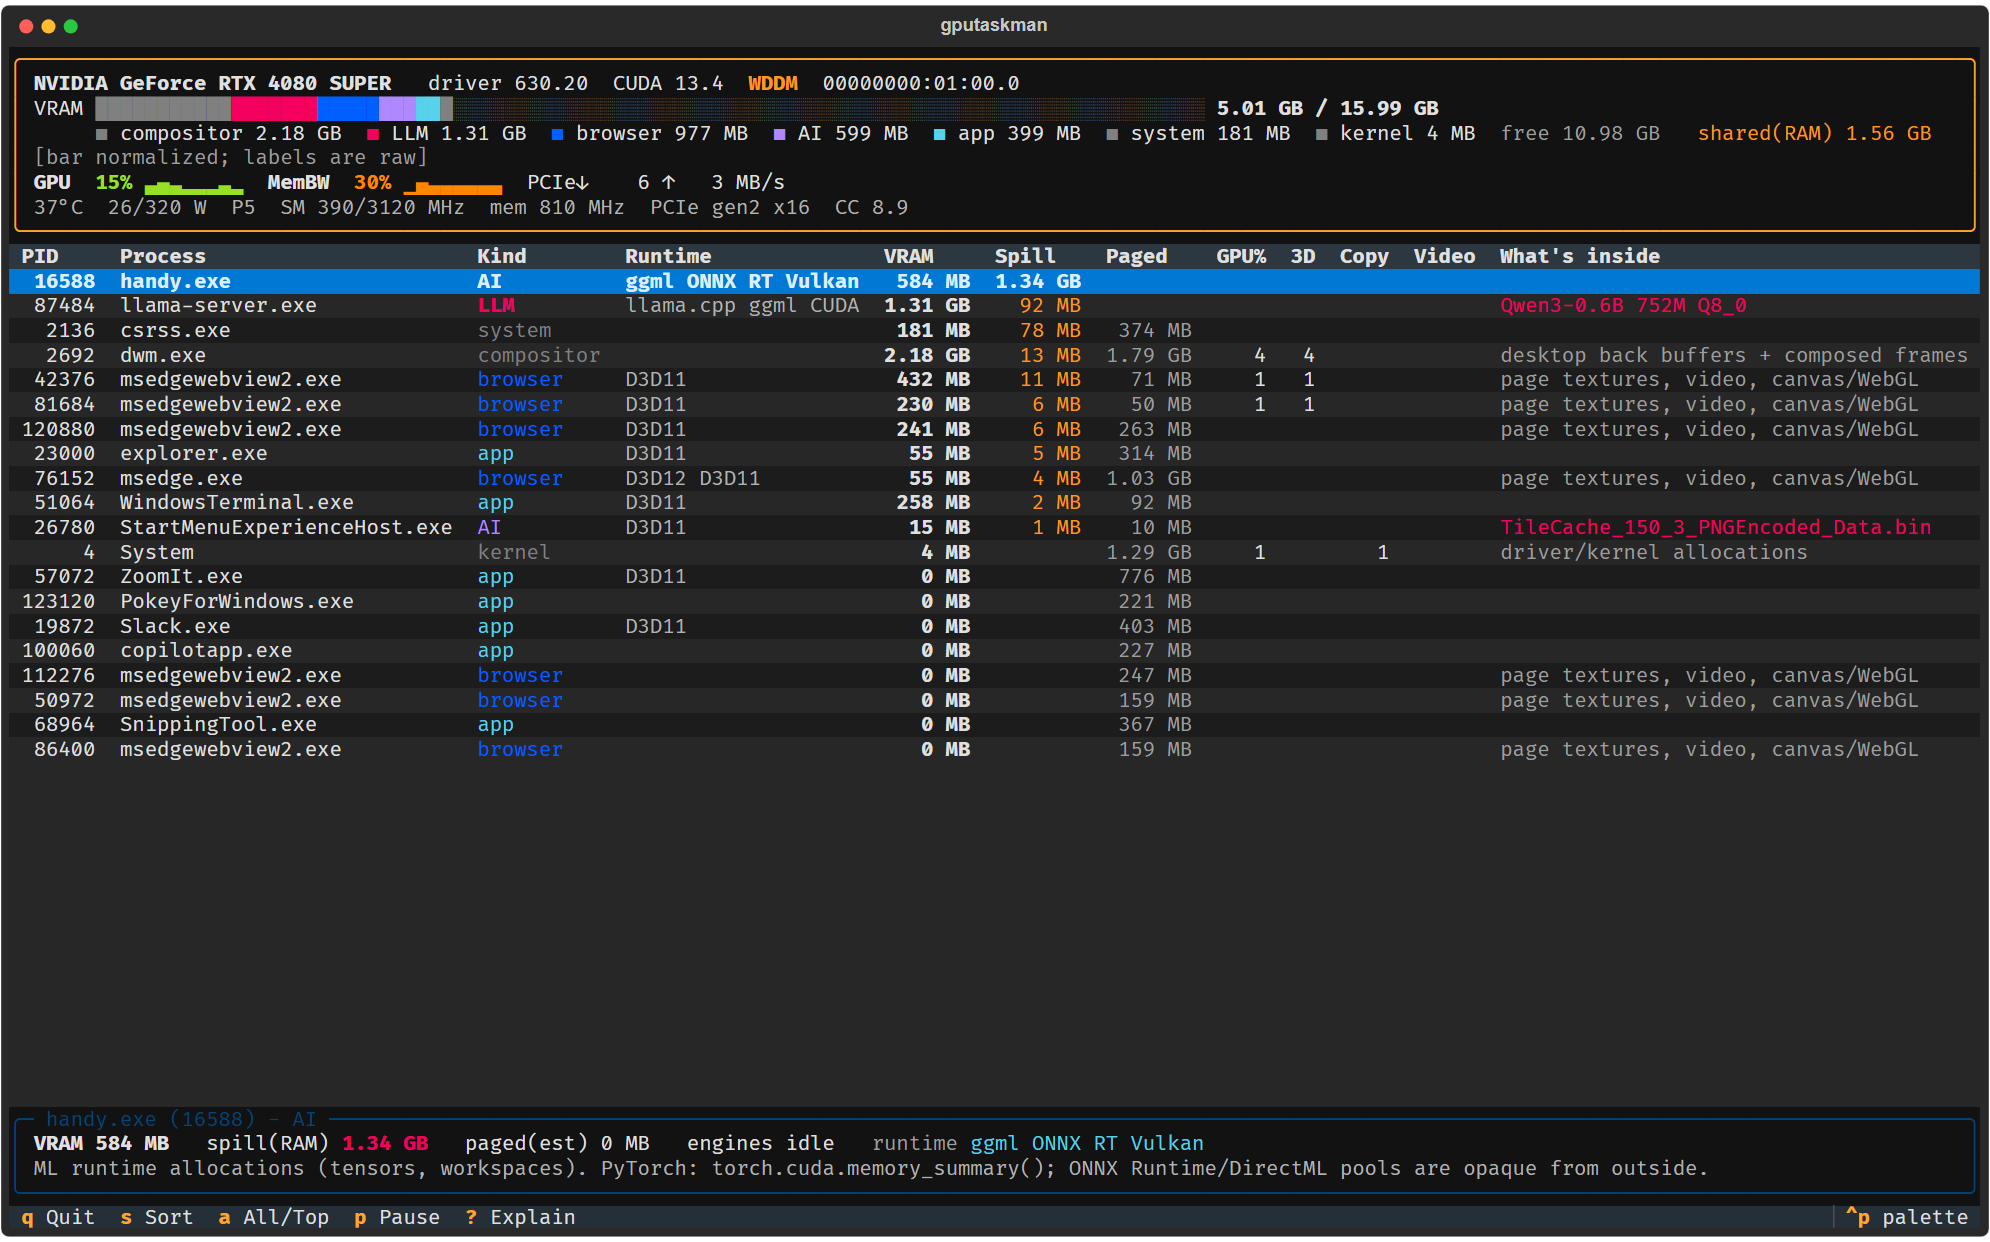
Chỉ số Spill cũng cần đọc đúng nghĩa. Nó là RAM hệ thống mà GPU có thể truy cập, có thể gồm buffer host được cấp phát có chủ đích; riêng chỉ số này không xác nhận VRAM đã tràn. Paged là ước tính từ tổng committed trừ Local Usage và Non Local Usage, không phải bản ghi cho thấy Windows vừa đẩy dữ liệu nào ra khỏi VRAM.
Hữu ích với máy chạy AI cục bộ, nhưng không phải công cụ soi mọi workload
Người dùng có thể mở giao diện TUI để xem liên tục hoặc xuất một snapshot dạng văn bản hay JSON. Trên Windows, bản portable yêu cầu driver WDDM phù hợp; gputaskman cũng có thể chạy từ mã nguồn qua uv hoặc pip. Dự án đang ở giai đoạn thử nghiệm, nên mức dữ liệu có thể xem phụ thuộc hệ điều hành, GPU, driver và runtime.
Trên Linux, nhiều chỉ số theo tiến trình đến từ NVML; phần Spill và Paged không khả dụng như trên Windows. WSL lấy tổng bộ nhớ từ Windows host rồi ghép các tiến trình Linux bằng dấu hiệu và thứ tự xuất hiện, do đó một số dòng được đánh dấu suy luận hoặc phỏng đoán. Trên macOS Apple Silicon, CPU và GPU dùng chung bộ nhớ nên không có cách tách VRAM như card rời.
Đây là lựa chọn đáng thử nếu Task Manager chỉ báo GPU đang dùng nhiều bộ nhớ mà chưa giúp xác định tiến trình, đặc biệt khi chạy model cục bộ. Nhưng nếu cần biết tensor, texture hay kernel cụ thể nào nằm trong VRAM, gputaskman không cung cấp mức soi đó; dự án chỉ đọc bộ đếm, metadata và dấu vết runtime, không dump bộ nhớ GPU.
gputaskman là tiện ích độc lập do Hanselman phát triển, không phải tính năng Microsoft tích hợp vào Windows 11. Mã nguồn, hướng dẫn cài đặt và các bản phát hành nằm trên GitHub; giấy phép MIT cho phép tải và sử dụng miễn phí.
Nguồn tham khảo: GitHub – shanselman/gputaskman; pyproject.toml