Tóm tắt nhanh
- NPU là bộ xử lý chuyên cho các phép toán AI; ứng dụng và mô hình phải tương thích mới sử dụng được phần cứng này.
- Lợi ích đáng quan tâm là chuyển tác vụ AI chạy liên tục khỏi CPU hoặc GPU, thay vì mặc định mọi ứng dụng đều nhanh hơn.
- Trong phép thử Frigate của Techno Tim, GPU và NPU gần ngang tốc độ nhưng công suất toàn máy lần lượt là 24,8 W và 18,3 W, với cùng cấu hình và tác vụ.
- Ngưỡng NPU 40+ TOPS gắn với nhiều tính năng Copilot+ PC của Microsoft, không phải yêu cầu chung cho mọi phần mềm AI.
Một laptop có NPU vẫn có thể chạy chatbot cục bộ bằng CPU, còn một máy có GPU xử lý AI tốt chưa chắc đáp ứng điều kiện NPU của Copilot+ PC. Hai chuyện tưởng mâu thuẫn này thực ra phản ánh cùng một vấn đề: phần cứng tính toán và phần mềm giao việc cho nó là hai điều khác nhau.
Vì thế, câu hỏi hữu ích khi chọn laptop không phải chỉ là NPU có bao nhiêu TOPS, mà là ứng dụng đang dùng có đưa việc sang NPU hay không, và việc chuyển đó giúp tiết kiệm điện hay giải phóng tài nguyên nào. Phân biệt được những điểm này sẽ tránh trả thêm tiền cho một thông số chưa phục vụ nhu cầu của mình.
NPU nhận phần suy luận AI, không nhận thay toàn bộ công việc của máy
NPU, viết tắt của Neural Processing Unit, là bộ xử lý được thiết kế cho các phép toán của mạng nơ-ron. Khi một mô hình đã được huấn luyện nhận đầu vào rồi tạo kết quả, chẳng hạn xác định người trong khung hình, quá trình đó gọi là suy luận. Đây là nhóm công việc NPU hướng tới, còn chuyện huấn luyện mô hình là một bài toán khác.
Các mạng nơ-ron sử dụng nhiều phép nhân ma trận và hàm kích hoạt. Phần cứng chuyên dụng có thể thực hiện những thao tác lặp lại này hiệu quả, nhưng đổi lại không linh hoạt như CPU và cũng không thay GPU cho mọi loại tính toán song song. NPU nên được hiểu là một nơi nữa để chạy mô hình phù hợp, chứ không phải bản nâng cấp khiến CPU hay GPU trở nên thừa.
Làm mờ nền khi họp video là ví dụ dễ thấy: việc tách người khỏi phông nền diễn ra liên tục trong cuộc gọi, trong khi máy vẫn phải xử lý âm thanh, trình duyệt và các ứng dụng đang mở. Nếu phần mềm hỗ trợ NPU, phần suy luận có thể chuyển sang đó để CPU hoặc GPU bớt gánh việc. Hiệu quả cuối cùng còn phụ thuộc cách ứng dụng tổ chức toàn bộ luồng xử lý.
Ngược lại, sử dụng ChatGPT hay Gemini chạy trên hạ tầng của nhà cung cấp không đòi máy người dùng phải có NPU để thực hiện suy luận ấy. Một mô hình ngôn ngữ lớn chạy cục bộ lại đặt ra yêu cầu về bộ nhớ và phần cứng tương thích; không thể suy từ chữ AI trên vỏ máy rằng NPU sẽ chạy tốt mọi mô hình.
Phần mềm quyết định NPU hoạt động hay tiếp tục nằm chờ
NPU không tự nhận mọi tác vụ có nhãn AI. Tài liệu Microsoft Learn nêu rõ phần mềm phải được lập trình để tận dụng phần cứng này; có NPU trên máy chỉ là điều kiện ban đầu, chưa bảo đảm ứng dụng thực sự dùng đến nó.
Microsoft hiện khuyến nghị Windows ML để ứng dụng truy cập NPU. Bên dưới là ONNX Runtime và các execution provider, có thể hiểu là thành phần kết nối việc chạy mô hình với phần cứng tương ứng. Windows ML hỗ trợ phát hiện phần cứng và chọn thành phần phù hợp; nếu lựa chọn ưu tiên không khả dụng hoặc gặp lỗi, hệ thống có thể chuyển sang GPU hay CPU.
Khả năng chuyển sang phần cứng khác giúp ứng dụng tiếp tục chạy, nhưng cũng tạo ra một khác biệt đáng lưu ý: thấy tính năng AI hoạt động chưa đủ để kết luận NPU đang xử lý. Muốn biết máy có tận dụng phần cứng hay không, người dùng cần kiểm tra hoạt động thực tế, còn nhà phát triển phải xem mô hình và đường thực thi đã nhắm đúng thiết bị chưa.
Định dạng mô hình cũng là một phần của điều kiện tương thích. Theo Microsoft Learn, nhiều NPU dùng phép toán số nguyên độ chính xác thấp như INT8 nhằm tăng hiệu năng và hiệu quả năng lượng, trong khi mô hình gốc có thể ở FP32. Vì vậy, quá trình triển khai thường cần chuyển đổi hoặc lượng tử hóa mô hình, thay vì tải một tệp bất kỳ rồi mong nó chạy ngay trên NPU.
Trong Task Manager của Windows, mục NPU cho biết mức sử dụng phần cứng ở thời điểm quan sát. Đồ thị nằm yên khi duyệt web thông thường không tự chứng minh máy có vấn đề; có thể đơn giản là chưa có ứng dụng nào giao tác vụ phù hợp cho nó.
Chạy được cùng mô hình chưa có nghĩa dùng cùng bộ xử lý
Sự khác biệt giữa hai bộ công cụ có thể làm thay đổi nơi xử lý, ngay cả khi người dùng yêu cầu cùng một mô hình tạo văn bản. Đó là lý do tên mô hình hay nhãn AI của ứng dụng chưa đủ để dự đoán NPU sẽ bận đến đâu.
Trong thử nghiệm do Engadget công bố trên ASUS Zenbook Duo UX8406 đời 2024 có RAM 32 GB, NPU Intel AI Boost có năng lực riêng 11 TOPS, còn tổng năng lực nền tảng được nêu là 34 TOPS. Hai số này không thể dùng thay cho nhau: tổng CPU, GPU và NPU không phải năng lực của riêng NPU.
Với Mistral 7B chạy qua OpenVINO trên cấu hình đó, Engadget ghi nhận NPU đạt mức sử dụng 98%, còn CPU ở 3%. Khi chạy cùng mô hình bằng Ollama mà không dùng NPU, CPU lên 52% và bộ nhớ sử dụng khoảng 17 GB. Các mức này mô tả hoạt động của máy trong hai cách triển khai cụ thể, không phải bảng đo tốc độ sinh văn bản hay chất lượng câu trả lời.
Không thể từ đó kết luận OpenVINO luôn nhanh hơn Ollama, hoặc mọi laptop đều sẽ giảm tải CPU theo đúng tỷ lệ ấy. Giá trị có thể rút ra là đường thực thi của phần mềm quyết định bộ xử lý nào nhận việc. Việc thiết lập OpenVINO trong ví dụ này cũng cần bộ công cụ phù hợp và kiến thức kỹ thuật, khác với trải nghiệm cài ứng dụng rồi sử dụng ngay.
Trong tác vụ chạy liên tục, điện năng có thể đáng giá hơn chênh lệch tốc độ
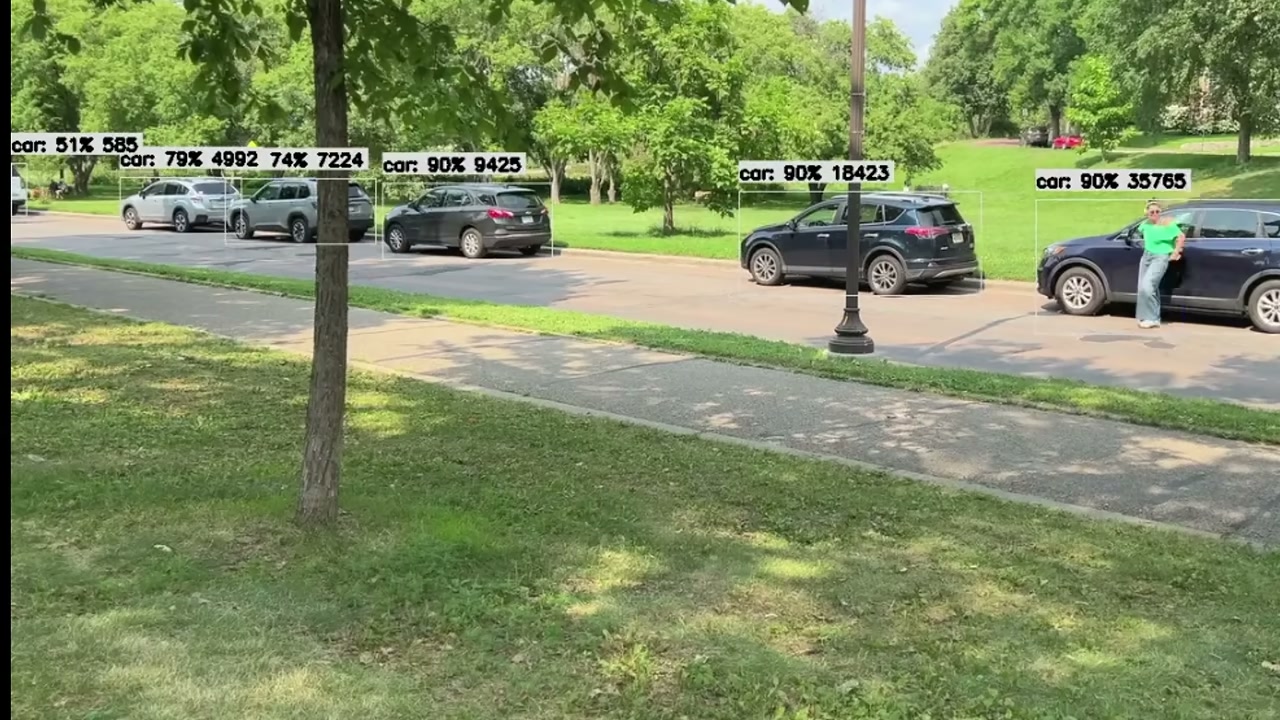
Một NPU không cần thắng GPU về tốc độ trong mọi phép thử mới có ích. Nếu cùng công việc được hoàn thành ở tốc độ tương đương nhưng tiêu thụ ít điện hơn và nhường GPU cho việc khác, đó đã là một lợi ích có thể đo được.
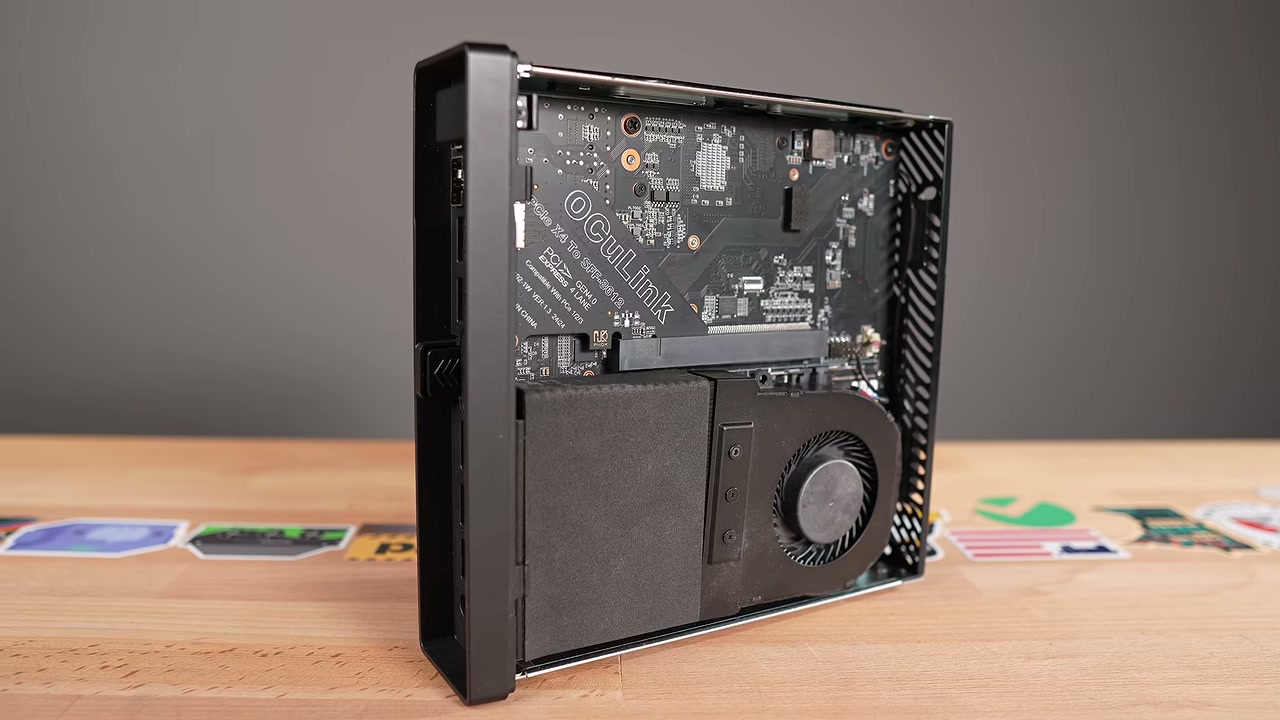
Phép thử của Techno Tim sử dụng Minisforum MS03 với Intel Core Ultra 9 386H và NPU 50 TOPS. Đây là một mini PC dùng bộ xử lý di động, không phải phép đo pin laptop. Tác vụ là phát hiện vật thể trong Frigate qua OpenVINO, chạy mô hình YOLOv9-tiny với đầu vào 640 × 640 trên bốn luồng video lặp lại; thiết lập giải mã bằng GPU được giữ nguyên khi đổi thiết bị chạy phần phát hiện.
Mỗi lượt đo kéo dài khoảng năm phút và được lặp năm lần. Bảng ghi kết quả do Techno Tim công bố; công suất được đo cho cả máy tại ổ cắm, không phải riêng khối CPU, GPU hoặc NPU.
| Phép đo Frigate | CPU trên MS03 | GPU tích hợp trên MS03 | NPU trên MS03 |
|---|---|---|---|
| Độ trễ suy luận, ms (thấp hơn tốt hơn) | 30,4 | 9,7 | 9,7 |
| Thông lượng phát hiện, fps (cao hơn tốt hơn) | 33 | 53,5 | 53,3 |
| Công suất toàn máy tại ổ cắm, W (thấp hơn tốt hơn) | 51,4 | 24,8 | 18,3 |
Số liệu: Techno Tim; cùng Minisforum MS03, mô hình và thiết lập Frigate nêu trên.
GPU và NPU gần như hòa về tốc độ trong cấu hình này; chênh lệch công suất toàn máy mới là điểm đáng chú ý. Mức giảm 6,5 W khi chuyển từ GPU sang NPU thuộc đúng phép thử đó, không phải mức tiết kiệm mặc định cho mọi laptop hay mọi ứng dụng.
Trong lượt dùng GPU để phát hiện, Techno Tim ghi nhận GPU hoạt động khoảng 99%. Khi chuyển phần phát hiện sang NPU, NPU trung bình ở khoảng 18%, còn GPU xuống khoảng 30% và chủ yếu giải mã video. Như vậy, lợi ích còn nằm ở việc phân chia công việc: NPU nhận suy luận, GPU vẫn làm phần việc video của nó thay vì phải gánh cả hai.
Không nên đổi mức chênh công suất này thành lời hứa laptop sẽ dùng lâu thêm bao nhiêu giờ. Máy thử không đo pin, còn mức tiêu thụ của màn hình, cấu hình máy và tác vụ trên laptop sẽ khác. Điều phép thử chứng minh được là hiệu quả năng lượng phải được đánh giá trong một luồng công việc xác định.
Benchmark mô hình và tốc độ ứng dụng là hai phép đo khác nhau
Đo riêng mô hình giúp nhận ra khả năng tính toán, nhưng không phản ánh đầy đủ ứng dụng còn phải giải mã video, di chuyển khung hình và xử lý kết quả. Khi các phần việc ấy cùng tồn tại, tăng tốc suy luận chưa chắc làm thông lượng toàn hệ thống tăng tương ứng.
Phép đo mô hình riêng bằng benchmark_app của OpenVINO được thực hiện ở chế độ độ trễ, mỗi lượt 30 giây, sau đó có thêm phép thử đồng bộ gần với cách Frigate vận hành hơn. Các con số sau thuộc hai bài thử riêng, không ghép trực tiếp với fps phát hiện của Frigate.
| Phép đo mô hình trên MS03 | CPU | GPU tích hợp | NPU |
|---|---|---|---|
| OpenVINO benchmark_app: độ trễ, ms (thấp hơn tốt hơn) | 28,6 | 4,2 | 2,2 |
| OpenVINO benchmark_app: thông lượng, fps (cao hơn tốt hơn) | 34,5 | 221 | 315 |
| Thử đồng bộ: độ trễ, ms (thấp hơn tốt hơn) | 29,3 | 5,5 | 4,8 |
| Thử đồng bộ: thông lượng, fps (cao hơn tốt hơn) | 34,2 | 179 | 200,5 |
Số liệu: Techno Tim; phép thử mô hình riêng trên Minisforum MS03, khác với luồng xử lý Frigate đầy đủ.
NPU dẫn trước GPU trong cả hai phép thử tách mô hình, còn vào Frigate thì gần như hòa. Bởi vậy, chọn một con số đẹp nhất rồi tuyên bố NPU luôn nhanh hơn GPU sẽ bỏ qua chính điều ứng dụng thực tế đang cho thấy.
Phần mềm còn ảnh hưởng đến khả năng triển khai ngay từ đầu. Với phần cứng mới trong phép thử này, bản phần mềm Intel đi kèm container Frigate chưa theo kịp, khiến việc chạy thử cần dựng lại container. Đó là chi phí thiết lập cần tính đến nếu định mua máy để tận dụng NPU cho một hệ thống cụ thể, thay vì chỉ nhìn thông số phần cứng.
Chọn laptop ở Việt Nam nên bắt đầu từ ứng dụng, không phải nhãn AI
Với người mua laptop để học tập, làm văn phòng hoặc họp trực tuyến, NPU nên được đánh giá theo tính năng có thể dùng ngay trên cấu hình định mua. Một ứng dụng hỗ trợ làm mờ nền bằng NPU có thể hữu ích trong cuộc gọi dài, nhưng không có nghĩa mọi phần mềm họp hay mọi phiên bản trên mọi nền tảng đều chạy theo cùng cách.
Microsoft đặt yêu cầu NPU 40+ TOPS cho nhiều tính năng Windows AI trên Copilot+ PC. Đây là ngưỡng của nhóm tính năng và phần cứng được hỗ trợ, không phải giới hạn dưới cho mọi ứng dụng AI. Tổng TOPS cộng dồn của nền tảng cũng không thay thế số TOPS riêng của NPU khi xem điều kiện này.
Nếu chủ yếu dùng chatbot trên web, không nên đổi một màn hình tốt hơn hay dung lượng RAM phù hợp lấy NPU có chỉ số cao hơn chỉ với kỳ vọng câu trả lời sẽ đến nhanh hơn. Phần suy luận của dịch vụ đám mây không chuyển sang laptop vì máy có thêm NPU.
Nếu dự định chạy mô hình cục bộ hoặc phát hiện vật thể liên tục, thứ cần kiểm tra trước khi mua lại cụ thể hơn: ứng dụng có hỗ trợ NPU của máy hay không, mô hình nào tương thích, bộ nhớ có đáp ứng và việc cài đặt có nằm trong khả năng xử lý của mình. Với tính năng liên quan tiếng nói, người dùng Việt Nam còn cần kiểm tra ngôn ngữ được hỗ trợ, thay vì suy rằng có NPU là mọi tính năng đều dùng được bằng tiếng Việt.
Không có tác vụ phù hợp thì NPU nằm chờ không đem lại giá trị rõ ràng. Có đúng ứng dụng, nó có thể nhận phần suy luận lặp đi lặp lại để CPU và GPU làm việc khác, trong khi mức tiêu thụ của cả hệ thống giảm xuống. Đó là tiêu chí đáng dùng để quyết định trả thêm tiền; con số TOPS đứng riêng chưa trả lời được.
Nguồn tham khảo: Microsoft Learn — phát triển ứng dụng cho Copilot+ PC; Engadget — NPU trên laptop và thử nghiệm Mistral 7B; Techno Tim — thử nghiệm CPU, GPU và NPU với Frigate.