Tóm tắt nhanh
- NVIDIA cho biết kernel tối ưu riêng cho Olympus giúp Vera đạt 21,75 phép tính FP64 mỗi chu kỳ, tăng gần 39% so với kernel cũ trong một phép thử nhân ma trận cụ thể.
- Ngay cả khi chạy cùng kernel Neoverse V2, Vera vẫn đạt 15,69 phép tính FP64 mỗi chu kỳ, cao hơn khoảng 20% so với Grace trong bài thử này.
- Vera có 88 nhân Olympus, 176 luồng SMT và bộ nhớ SOCAMM2 LPDDR5X băng thông tối đa 1,2 TB/s; NVIDIA định vị chip cho hạ tầng AI và các tác vụ cần hiệu năng đơn luồng cao, không phải máy chủ đa dụng.
NVIDIA cho biết vi xử lý Vera có thể tăng gần 39% thông lượng tính toán khi phần mềm được tối ưu riêng cho nhân Olympus. Con số này đến từ một phép thử nhân ma trận chạy trong cache L1, không đại diện cho mức tăng của mọi ứng dụng; điểm đáng chú ý hơn là cùng một bộ xử lý có thể để lại phần đáng kể năng lực vector nếu mã nguồn chưa được điều chỉnh theo kiến trúc mới.
Kernel cũ đã nhanh hơn trên Vera, nhưng vẫn chưa khai thác hết phần cứng
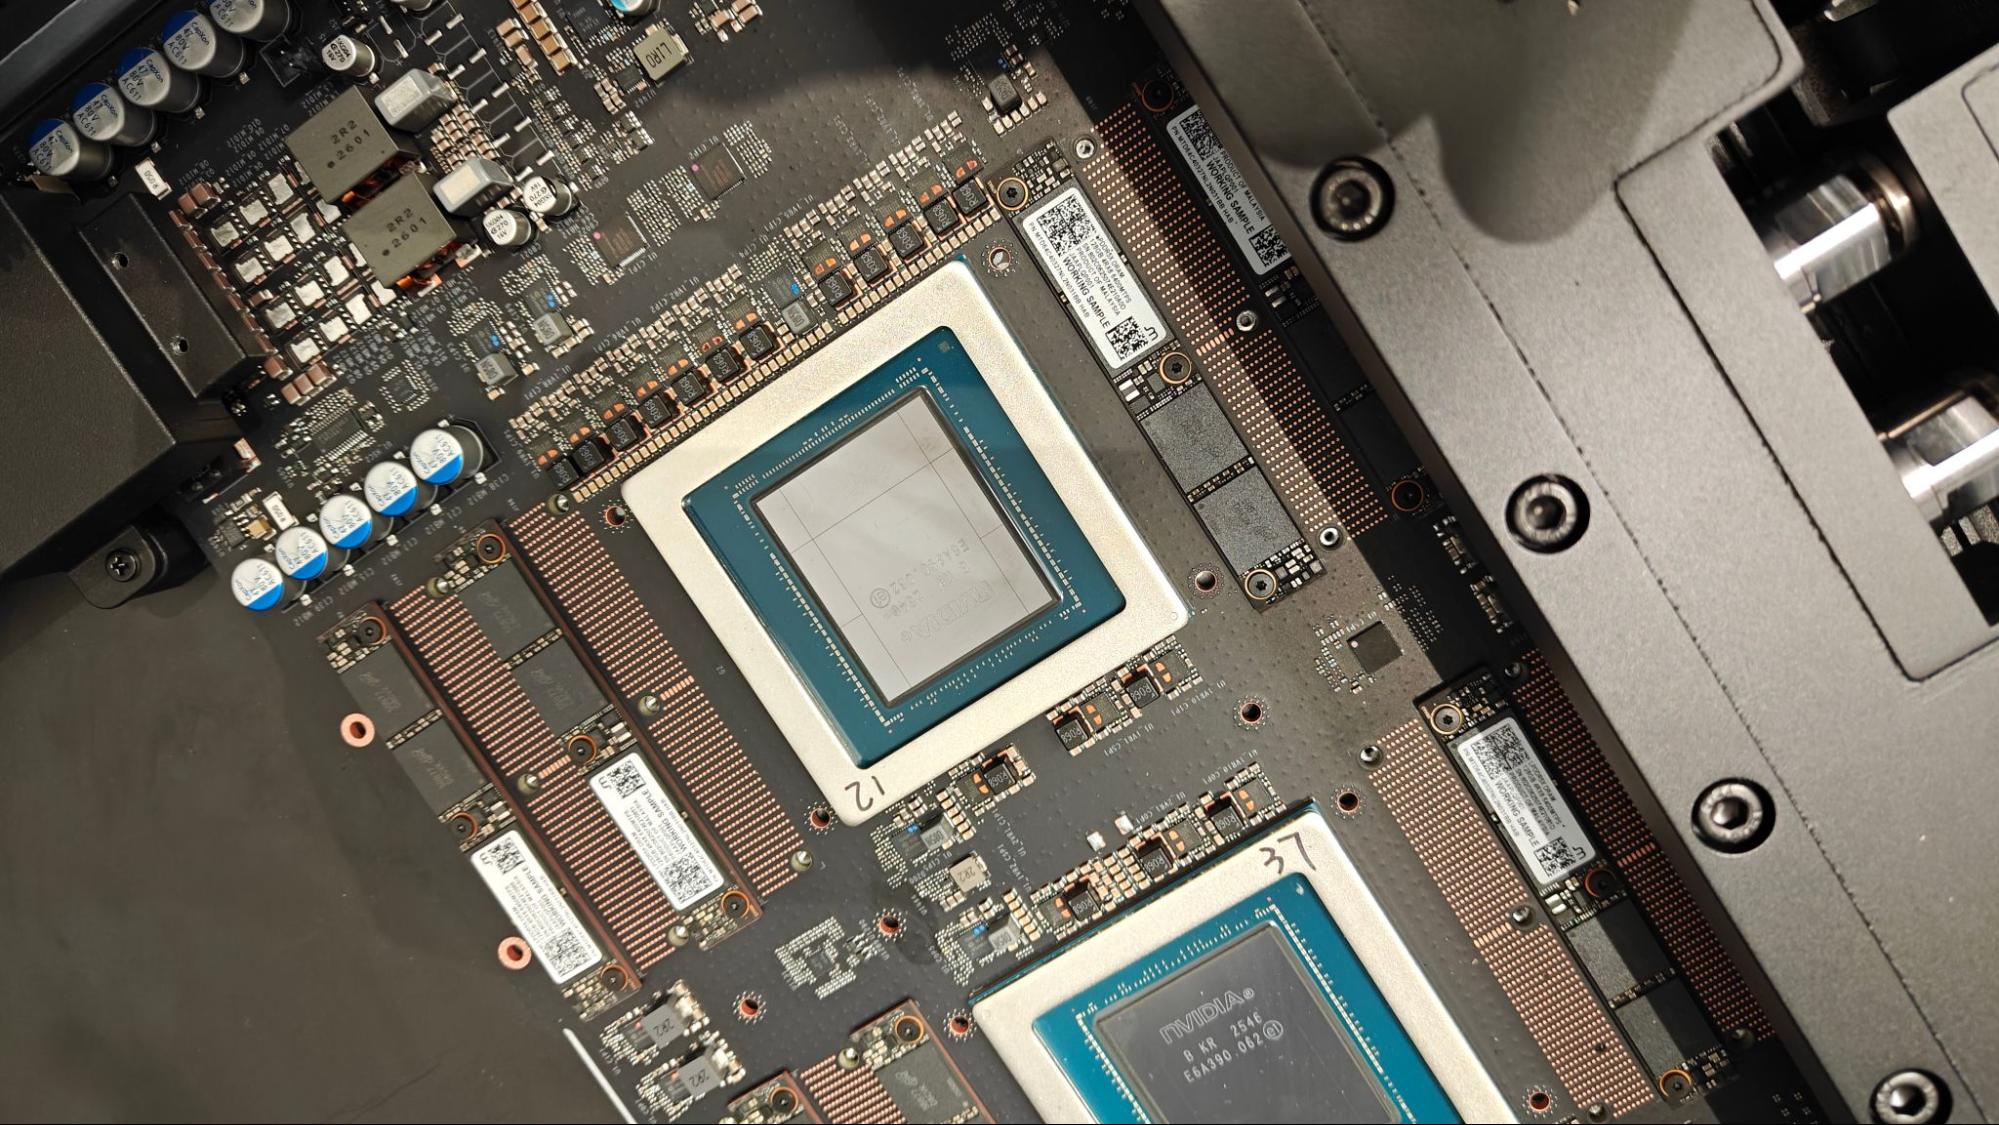
Để so sánh Olympus với Neoverse V2 trên CPU Grace, nhóm nghiên cứu NVIDIA dùng miniKernelGEMM, một phép nhân ma trận dấu phẩy động chính xác kép (DGEMM) kích thước 128 × 128, vừa với cache L1 của cả hai chip. Mã thử nghiệm dựa trên kernel assembly của OpenBLAS vốn được viết cho Neoverse V2; thư viện này chưa có kernel riêng cho Olympus.
| Chip và kernel | IPC | FP64 mỗi chu kỳ | Mức sử dụng thông lượng FP64 đỉnh |
|---|---|---|---|
| Grace, kernel Neoverse V2 | 4,51 | 13,03 | 81,4% |
| Vera, cùng kernel Neoverse V2 | 5,43 | 15,69 | 66,5% |
| Vera, kernel tối ưu cho Olympus | 7,53 | 21,75 | 90,6% |
Số liệu: NVIDIA, qua bài phân tích kết quả tại SC26 của Tom’s Hardware. Phép thử miniKernelGEMM 128 × 128 nằm trong cache L1; kernel riêng cho Olympus điều chỉnh cách chia tile ma trận, phân bổ thanh ghi và lịch phát lệnh.
Chạy cùng kernel cũ, Vera đạt 5,43 lệnh mỗi chu kỳ (IPC) và 15,69 phép tính FP64 mỗi chu kỳ, so với 4,51 IPC và 13,03 phép tính của Grace. Đây là mức cải thiện khoảng 20% về thông lượng FP64 trong bài thử, dù phần mềm chưa được viết riêng cho Olympus. Khi nhóm nghiên cứu điều chỉnh kernel cho kiến trúc này, kết quả của Vera tăng lên 7,53 IPC và 21,75 phép tính FP64 mỗi chu kỳ.
Mức gần 39% được tính từ 15,69 lên 21,75 phép tính FP64 mỗi chu kỳ trên Vera, giữa hai phiên bản kernel. Còn so với Grace chạy kernel Neoverse V2, kết quả tối ưu trên Vera cao hơn gần 67% trên mỗi nhân, mỗi chu kỳ trong chính phép thử đó. Hai cách so sánh trả lời hai câu hỏi khác nhau; không nên biến chúng thành lời hứa rằng mọi phần mềm sẽ chạy nhanh hơn 39% hay 67%.
Olympus dành diện tích cho năng lực mỗi nhân thay vì chạy đua số nhân
Vera có 88 nhân Olympus và 176 luồng thông qua công nghệ Spatial Multithreading (SMT). Theo NVIDIA, nhân này gồm bộ giải mã rộng 10 lệnh, bộ dự đoán rẽ nhánh neural, sáu pipeline vector, bốn pipeline tải và hai pipeline ghi. Thiết kế ưu tiên khả năng xử lý trên từng nhân, thay vì đẩy số nhân lên mức tối đa.
Đây là lựa chọn có ý nghĩa với một số tác vụ AI tác tử: mỗi tiến trình có thể phải chạy mã, gọi công cụ, truy xuất dữ liệu rồi chờ các bước phụ thuộc nhau hoàn thành. Trong những đoạn xử lý nối tiếp hoặc nhiều nhánh, thêm nhân không nhất thiết rút ngắn thời gian phản hồi của từng tác vụ; hiệu năng đơn luồng và độ trễ truy cập bộ nhớ cũng có thể trở thành giới hạn. Tuy vậy, mô tả này là định hướng thiết kế của NVIDIA, chưa phải bằng chứng độc lập rằng Vera sẽ vượt các CPU khác trên mọi khối lượng công việc AI.
Hệ thống bộ nhớ của Vera dùng SOCAMM2 LPDDR5X, với băng thông tổng thể tối đa 1,2 TB/s, tương đương tối đa 14 GB/s mỗi nhân theo NVIDIA. Chip còn có 164 MB cache L3 hợp nhất. Băng thông lớn có thể giúp các tác vụ đồng thời có thêm dữ liệu để xử lý, nhưng không tự động loại bỏ độ trễ hay khiến phần mềm tận dụng đủ các đơn vị tính toán. Kết quả DGEMM cho thấy lịch phát lệnh, cách chia dữ liệu và phân bổ thanh ghi vẫn ảnh hưởng trực tiếp tới hiệu năng.
Mức tăng 39% phụ thuộc vào phần mềm và loại tác vụ
Phép thử được công bố tại SC26 cho thấy lợi ích của tối ưu hóa ở cấp kiến trúc: thay đổi kernel từ mã hướng tới Neoverse V2 sang mã phù hợp với Olympus giúp tăng mức sử dụng thông lượng FP64 đỉnh trên Vera từ 66,5% lên 90,6%. Nhưng đây là một vi kiểm chuẩn nhân ma trận nhỏ nằm trong cache L1. Bài thử chưa trả lời mức tăng sẽ ra sao với cơ sở dữ liệu, máy chủ web, tác vụ AI khác hay ứng dụng có thời gian chờ bộ nhớ dài.
NVIDIA cũng không định vị Vera như CPU đa dụng để thay thế trực tiếp các bộ xử lý máy chủ thông thường. Hãng nhắm đến AI tác tử và những khối lượng công việc cần hiệu năng mỗi nhân cao, băng thông bộ nhớ lớn và độ trễ thấp. Vì vậy, kết quả thực tế sẽ phụ thuộc vào việc phần mềm có được biên dịch và tinh chỉnh cho Olympus hay không, cũng như tác vụ có phù hợp với ưu tiên thiết kế của Vera hay không.
Vera là CPU trung tâm dữ liệu, không phải linh kiện bán lẻ cho người dùng phổ thông tại Việt Nam. Câu hỏi còn bỏ ngỏ là các ứng dụng ngoài phép nhân ma trận có thể thu được mức cải thiện bao nhiêu khi được tối ưu cho Olympus — điều cần benchmark trên từng loại tác vụ, thay vì suy ra từ một con số duy nhất.
Nguồn tham khảo: Tom’s Hardware; NVIDIA Developer Blog