
Tóm tắt nhanh
- Phần cứng trung tâm: Cỗ máy chạy siêu chip đơn NVIDIA GB300 Grace Blackwell Ultra Desktop Superchip gồm 72 nhân Arm Neoverse V2 kết hợp cùng GPU Blackwell Ultra B300.
- Không gian bộ nhớ khổng lồ: Tổng cộng 748 GB bộ nhớ khả kiến hợp nhất (coherent memory), bao gồm 252 GB HBM3e băng thông 7,1 TB/s và 496 GB LPDDR5X, liên kết qua NVLink-C2C đạt 900 GB/s.
- Khả năng mở rộng mạng: Tích hợp sẵn 2 cổng mạng NVIDIA ConnectX-8 SuperNIC QSFP112 với tổng băng thông 800 Gb/s, cho phép ghép đôi trực tiếp 2 máy trạm thành cụm 1.496 GB bộ nhớ.
- Định vị thị trường: Dạng tháp deskside 27 kg có quai xách kim loại, nguồn Titanium 1.600W, mức giá dự kiến dao động từ 100.000 đến 120.000 USD phục vụ doanh nghiệp và phòng nghiên cứu.
Thiết kế tháp để bàn 27 kg mang phong cách thực dụng
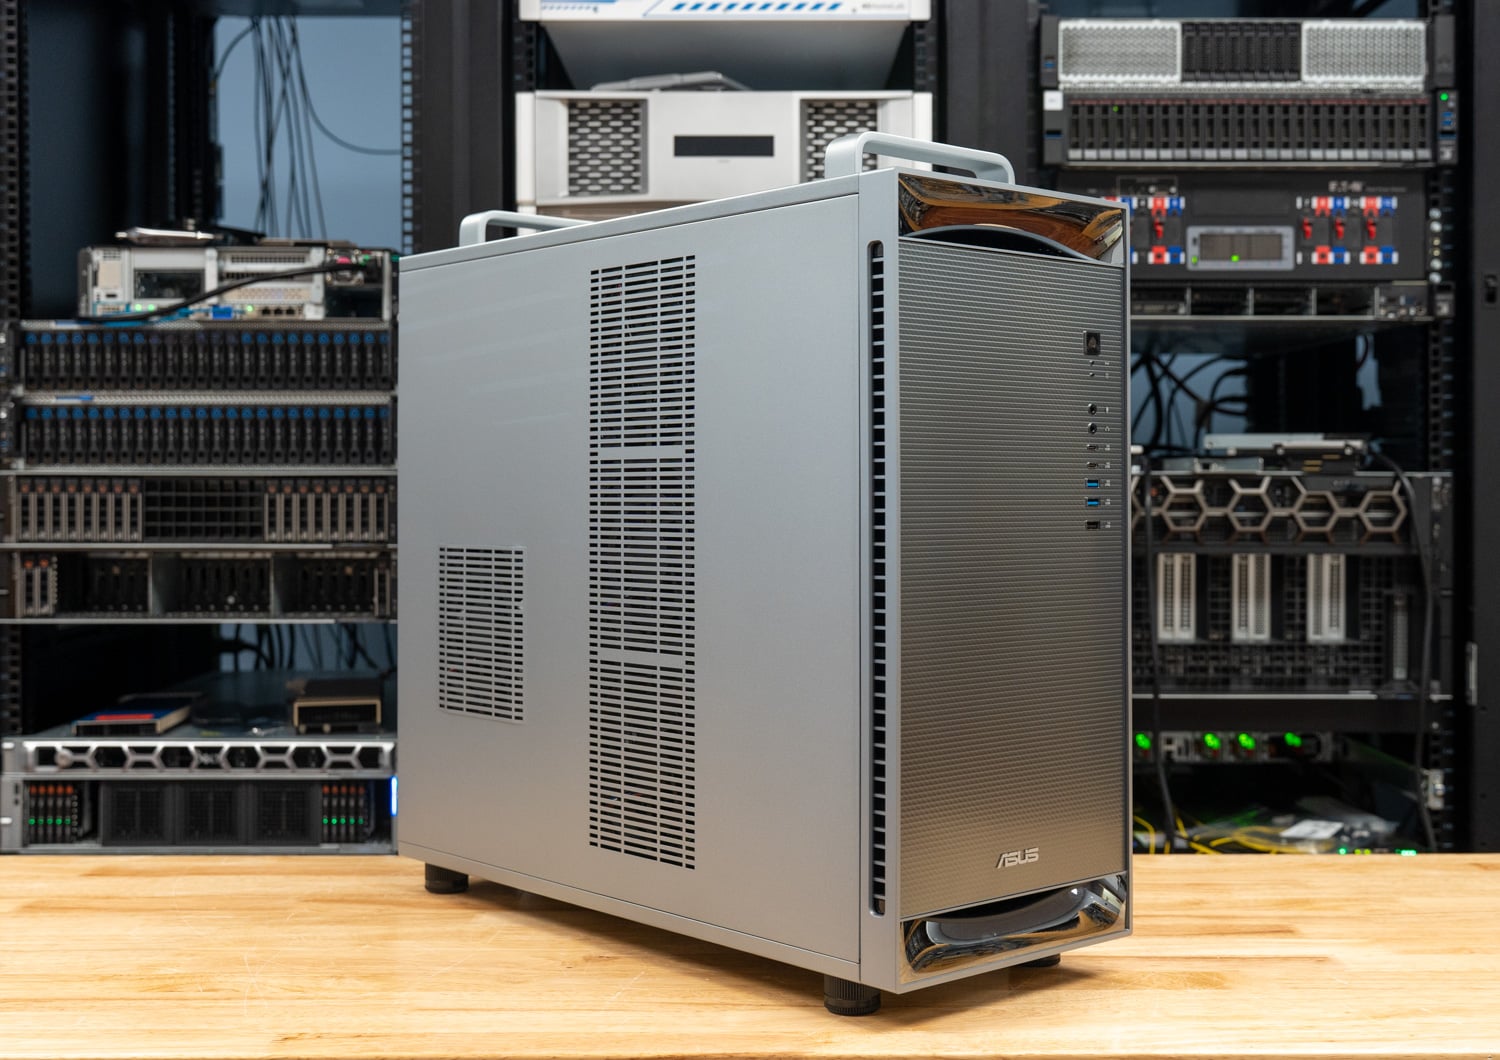
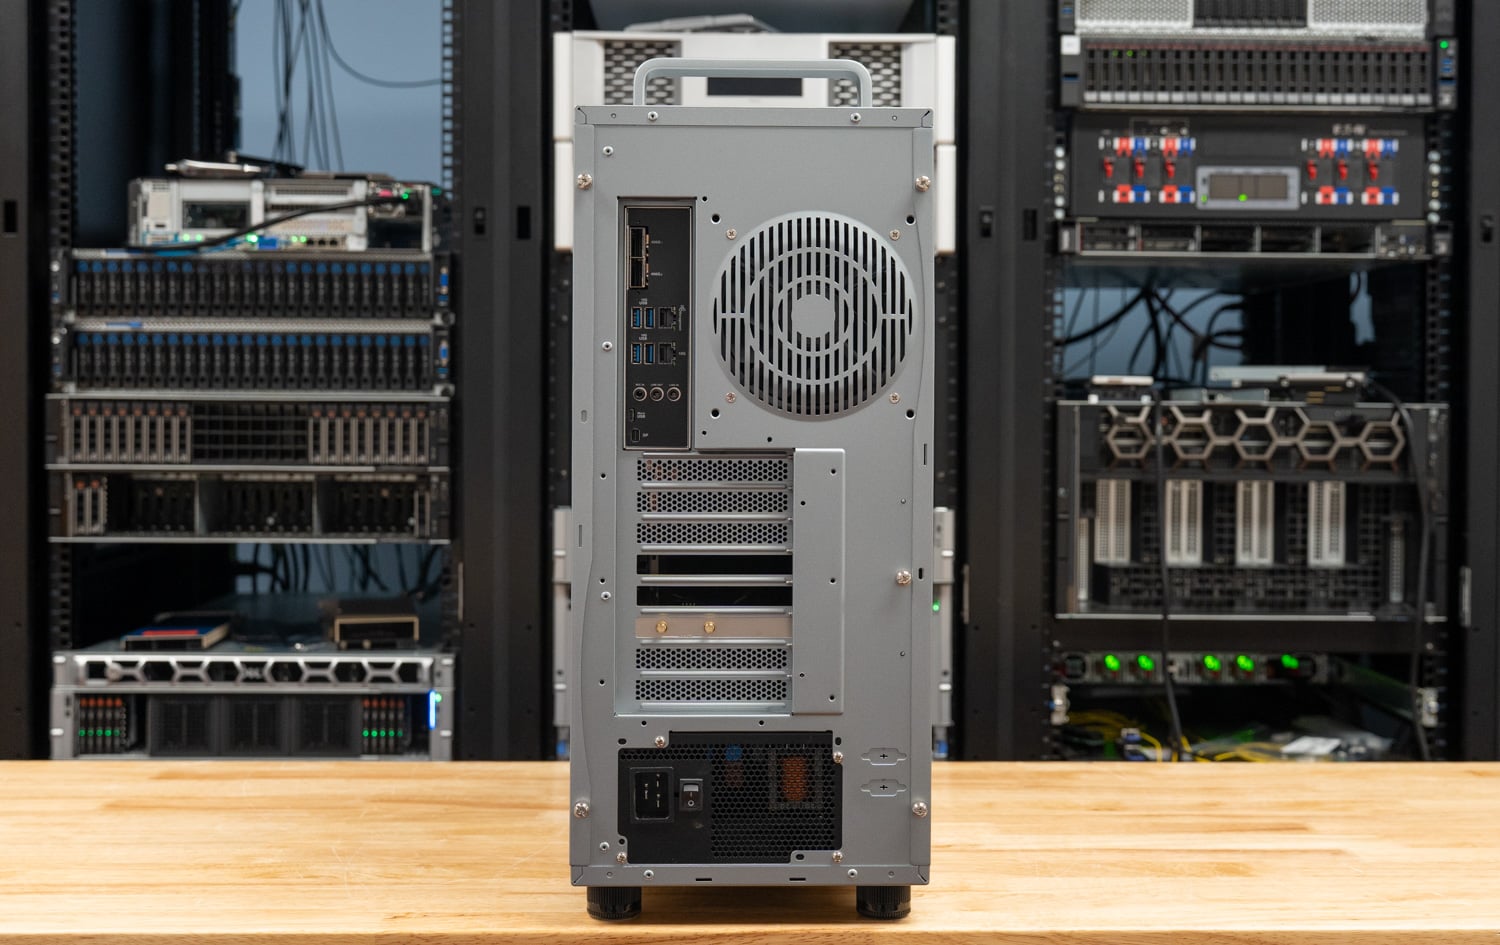
ASUS chính thức công bố máy trạm ExpertCenter Pro ET900N G3, hiện thực hóa kiến trúc NVIDIA DGX Station thế hệ mới nhất về dạng thùng máy đứng đặt cạnh bàn làm việc. Với kích thước 584 x 232 x 565 mm và trọng lượng tịnh 27 kg (tổng trọng lượng đóng gói 32 kg), ASUS trang bị sẵn hai quai xách kim loại dày dặn phía trên nắp thùng máy để kỹ sư có thể di chuyển thiết bị trong phòng lab hoặc văn phòng.
Bộ vỏ ngoài của máy sử dụng chất liệu nhôm phay xước màu xám bạc kết hợp mặt lưới hút gió dạng tổ ong ở phía trước. Khác với các hệ thống máy chủ dạng phiến gắn tủ rack 19 inch đòi hỏi phòng server cách âm chuyên biệt, ET900N G3 được thiết kế để vận hành êm ái hơn ngay trong môi trường làm việc thông thường của các nhóm kỹ sư dữ liệu.
Kiến trúc bộ nhớ hợp nhất 748 GB và liên kết NVLink-C2C 900 GB/s
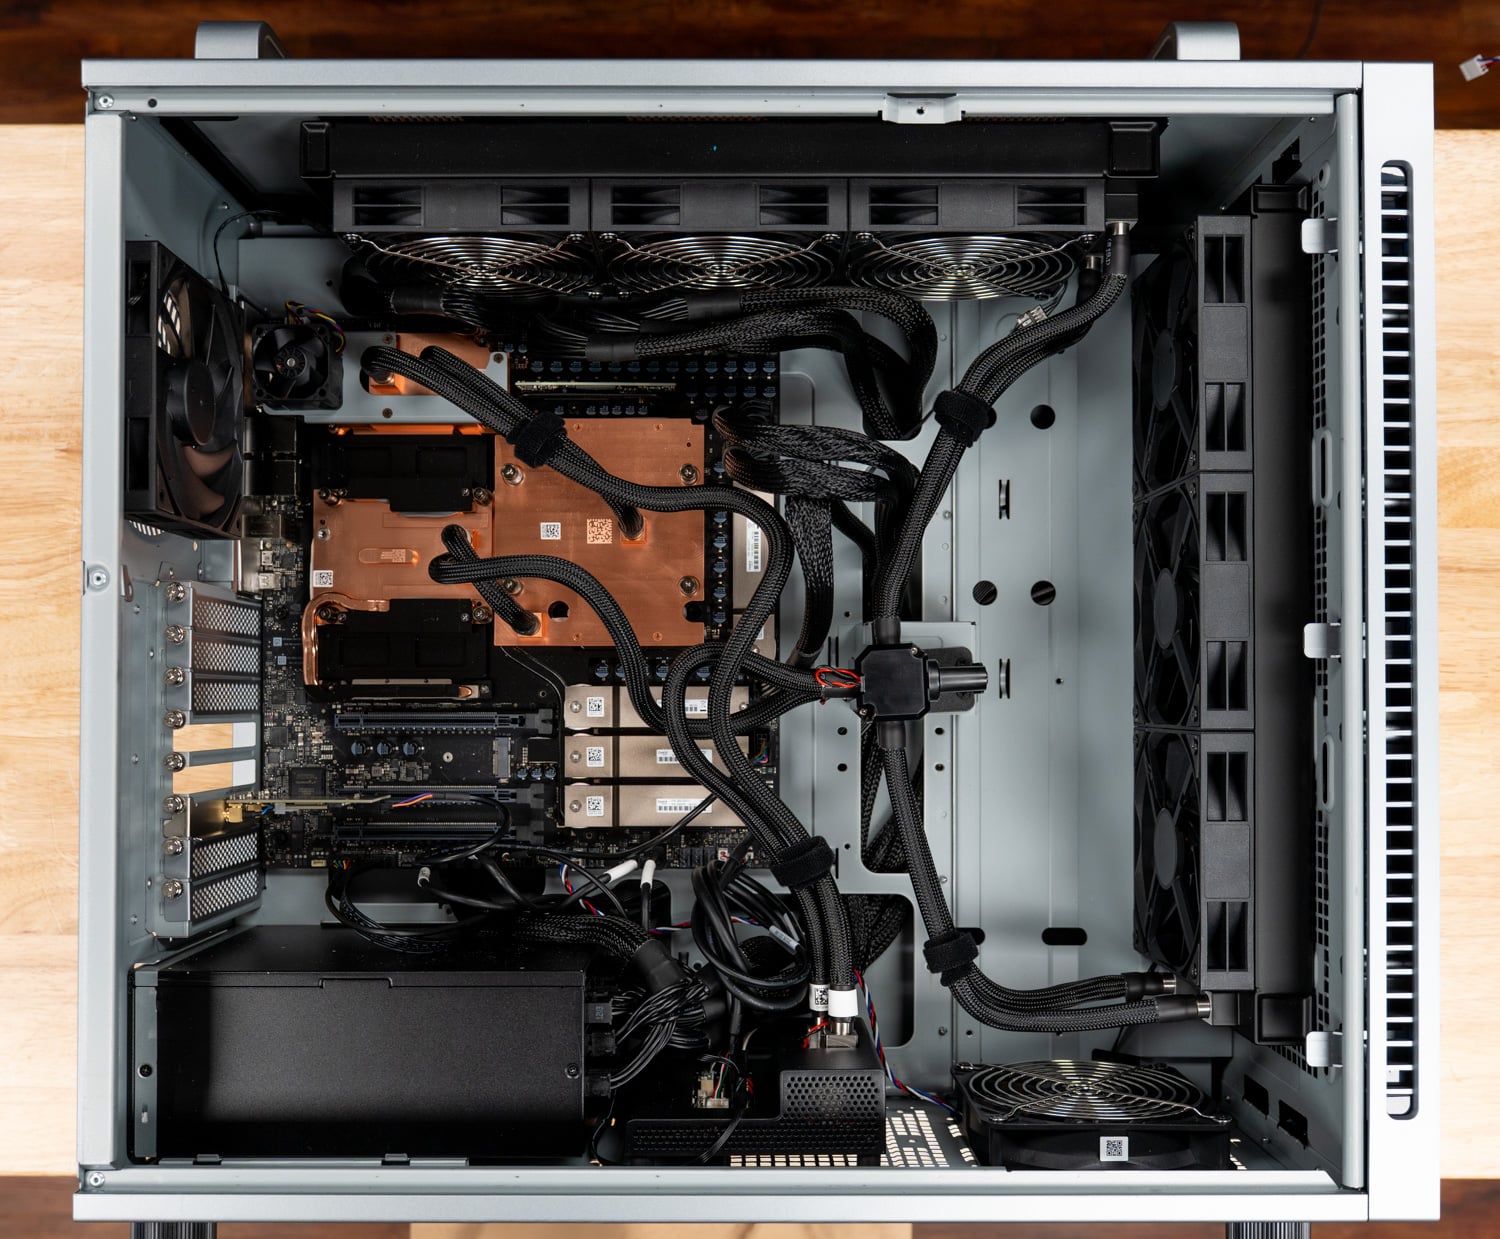
Điểm giá trị nhất trên mẫu máy trạm này nằm ở cấu trúc bộ nhớ khả kiến hợp nhất (coherent memory) giữa CPU và GPU. Siêu chip NVIDIA GB300 tích hợp một CPU Grace 72 nhân Arm Neoverse V2 cùng một GPU Blackwell Ultra B300 trên cùng đế module. Cấu hình này đi kèm 496 GB RAM LPDDR5X (băng thông 396 GB/s) cho vi xử lý trung tâm và 252 GB bộ nhớ đồ họa HBM3e (băng thông 7,1 TB/s) cho vi xử lý đồ họa.
Cả hai khối bộ nhớ liên lạc thông qua giao thức NVLink-C2C với băng thông hai chiều đạt tới 900 GB/s, nhanh gấp khoảng 7 lần so với khe cắm PCIe Gen 5 x16 thông thường. Kiến trúc này giải quyết triệt để bài toán nghẽn cổ chai khi các nhà phát triển chạy suy luận hoặc tinh chỉnh các mô hình ngôn ngữ lớn kiến trúc hỗn hợp chuyên gia (MoE) như GLM-5.2 hay MiniMax M2.7. Khi dung lượng tham số vượt quá 252 GB HBM3e, các chuyên gia tính toán có thể được đẩy (offload) trực tiếp sang vùng nhớ 496 GB LPDDR5X của CPU mà không bị sụt giảm tốc độ nghiêm trọng như khi truyền qua bus PCIe.
Khả năng mở rộng lưu trữ của bo mạch gồm 2 khe M.2 2280 chuẩn PCIe 5.0 x4 được cấu hình sẵn RAID 1 bằng 2 ổ cứng NVMe SSD 2 TB cho hệ điều hành Ubuntu, đi kèm 2 khe M.2 2280 hỗ trợ chuẩn PCIe 6.0 x4 chuyên dùng lưu trữ tập dữ liệu huấn luyện.
Giải pháp làm mát cổng quang 400G và nguồn Titanium 1.600W
Để giải tỏa lượng nhiệt phát sinh từ siêu chip GB300, ASUS trang bị hệ thống tản nhiệt chất lỏng AIO khép kín. Các tấm ốp tản nhiệt bằng đồng nguyên khối bao phủ toàn bộ cụm vi xử lý trung tâm, GPU, mô-đun bộ nhớ SOCAMM và mạch cấp nguồn, sau đó dẫn nhiệt qua cụm radiator gắn các quạt áp suất tĩnh cao.
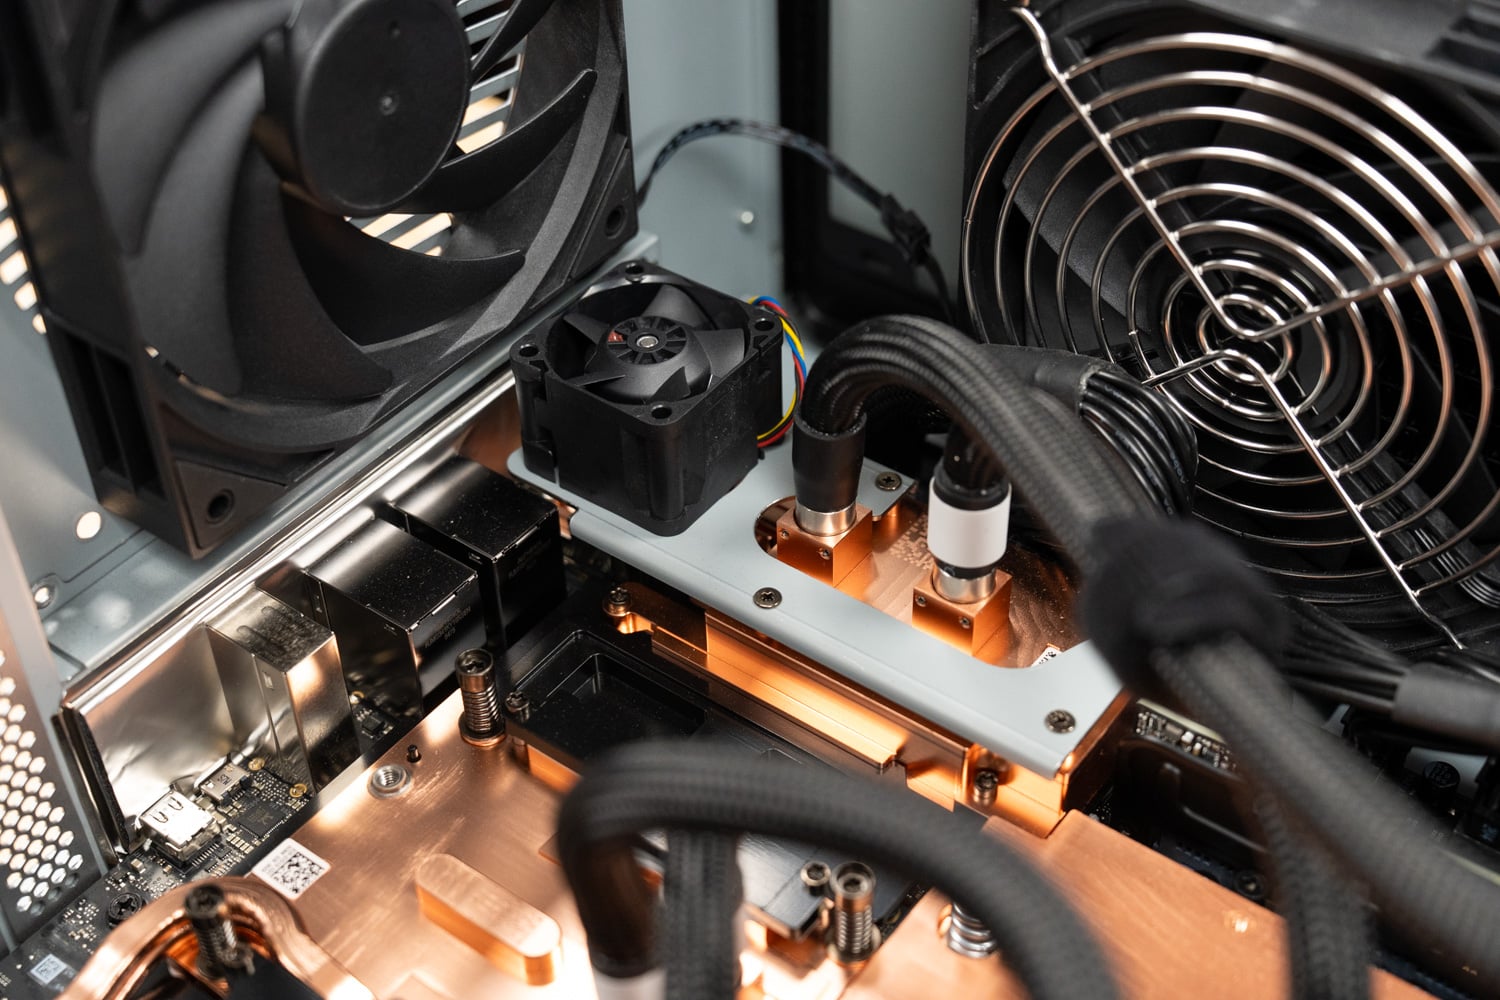
Chi tiết kỹ thuật đáng chú ý được phòng thử nghiệm StorageReview chỉ ra là cụm quạt tản nhiệt mini chuyên dụng đặt ngay phía trên lồng cắm quang QSFP112 của card mạng NVIDIA ConnectX-8. Cổng quang 400 GbE khi hoạt động ở mức tải cao liên tục thường tỏa nhiệt rất lớn làm tăng nguy cơ suy giảm tín hiệu hoặc ngắt kết nối. Việc ASUS thổi luồng khí mát cưỡng bức trực tiếp vào module quang giúp duy trì kết nối mạng ổn định cho các tác vụ tính toán phân tán kéo dài nhiều ngày.
Cung cấp năng lượng cho toàn bộ hệ thống là bộ nguồn công suất 1.600W đạt chứng nhận hiệu suất 80 PLUS Titanium, sử dụng cổng cắm dây nguồn chuẩn C19 chịu dòng cao. Bo mạch cũng tích hợp chip điều khiển ASPEED AST2600 cùng firmware AMI MegaRAC, hỗ trợ đầy đủ giao thức quản trị từ xa IPMI 2.0 và DMTF Redfish API tương tự máy chủ doanh nghiệp.
Hiệu năng suy luận vLLM và khả năng ghép cụm bộ nhớ qua cổng 400G
Trong các bài thử nghiệm thực tế do StorageReview công bố khi chạy framework suy luận vLLM trên 14 mô hình trí tuệ nhân tạo, ExpertCenter Pro ET900N G3 thể hiện sức mạnh vượt trội so với các thế hệ máy trạm dùng card PCIe đơn lẻ. Cụ thể, khi đo lường mô hình GPT-OSS-120B định dạng lượng tử MXFP4 ở 128 luồng xử lý đồng thời, máy trạm đạt tốc độ suy luận 9.280 output tokens/giây. Mức hiệu năng này cao gấp khoảng 3 lần so với cấu hình dùng card đồ họa NVIDIA RTX PRO 6000 và gấp 2,7 lần so với máy chủ gắn GPU NVIDIA H200 NVL.
Đối với mô hình GLM-5.2 định dạng NVFP4 có 215 GB trọng số chuyên gia phải chuyển bớt sang bộ nhớ Grace qua cầu NVLink-C2C, cỗ máy vẫn duy trì tốc độ 139 output tokens/giây ở 32 luồng đồng thời.
Thông qua hai cổng mạng ConnectX-8 QSFP112 tích hợp sẵn, người dùng có thể sử dụng cáp DAC nối thẳng hai trạm làm việc ET900N G3 lại với nhau mà không cần đầu tư bộ chuyển mạch switch quang đắt đỏ. Kết nối này tạo nên một không gian bộ nhớ hợp nhất lên đến 1.496 GB, đủ sức chứa toàn bộ các mô hình AI mã nguồn mở đồ sộ nhất hiện nay.
Chi phí đầu tư và khả năng tiếp cận tại thị trường Việt Nam
Mức giá quốc tế ước tính cho ASUS ExpertCenter Pro ET900N G3 nằm trong khoảng 100.000 đến 120.000 USD (tương đương khoảng 2,5 đến 3 tỷ đồng trước thuế và chi phí nhập khẩu). Tại Việt Nam, sản phẩm này không bán lẻ qua kênh đại lý tiêu dùng phổ thông mà được phân phối theo hợp đồng dự án B2B ủy quyền từ ASUS dành cho các viện nghiên cứu, trường đại học công nghệ và bộ phận R&D của các tập đoàn phần mềm lớn.
So với chi phí thuê máy chủ GPU đám mây dài hạn vốn phụ thuộc vào đường truyền mạng quốc tế và tiềm ẩn rủi ro rò rỉ dữ liệu sở hữu trí tuệ, việc sở hữu cỗ máy trạm deskside 748 GB bộ nhớ cục bộ mang lại quyền kiểm soát dữ liệu tuyệt đối và độ trễ phản hồi thấp cho đội ngũ nghiên cứu.