Tóm tắt nhanh
- Nhà nghiên cứu phần cứng Kate công bố cách can thiệp điện áp để ghi thêm cấu hình eFuse, mở khóa những khối bị tắt trên GPU GA100.
- Trong mẫu thử gồm 10 card CMP 170HX bản 8GB, 9 chiếc dùng được 80GB HBM2e, còn một chiếc chỉ có 64GB hoạt động.
- Phép đo OpenCL FP16 FMA do tác giả công bố cho thấy bản mod đạt khoảng 85,86 TFLOP/s, hơn khoảng 18% so với A100 bán lẻ trong cùng bảng so sánh.
- Kết quả không bảo đảm cho mọi card; sửa mạch và thổi eFuse là can thiệp vật lý không có nút hoàn tác.
Một GPU đào coin chỉ hiện 8GB VRAM có thể chứa sẵn lượng bộ nhớ lớn hơn nhiều so với con số ứng dụng nhìn thấy. Công bố ngày 10/11/2026 về CMP 170HX cho thấy phần bộ nhớ bị khóa ấy có thể được đưa vào sử dụng bằng voltage fault injection, tức gây lỗi có chủ đích bằng xung điện áp.
Điểm đáng quan tâm không nằm ở một bản driver giúp card cũ bỗng nhanh hơn. Phát hiện cho thấy cách phân tầng sản phẩm bằng eFuse có thể bị vượt qua khi người can thiệp kiểm soát được mạch nguồn. Nhưng từ một card mod chạy benchmark đến bộ tăng tốc đủ tin cậy cho công việc vẫn còn khoảng cách, dù cả hai cùng báo 80GB bộ nhớ.
Cùng chip GA100 nhưng phần cứng được phép dùng khác nhau
Khả năng mở khóa đến từ phần cứng vốn có, không phải biến 8GB bộ nhớ vật lý thành 80GB bằng phần mềm. Theo công bố kỹ thuật trên Kate’s blog, thiết kế GA100 có tối đa 128 cụm xử lý dòng, gọi là SM, trong khi CMP 170HX xuất xưởng chỉ bật 70 SM. A100 thương mại dùng 108 SM, còn các mẫu mở khóa được báo cáo thường có khoảng 120–126 SM hoạt động tùy chip.
Nhà sản xuất có thể dùng cùng thiết kế silicon cho nhiều cấu hình, vừa loại bỏ các khối lỗi trong sản xuất, vừa giới hạn tính năng theo phân khúc. Vì thế, một khối bị tắt có thể còn hoạt động, nhưng cũng có thể đã bị loại vì hỏng thực sự. Hai trường hợp ấy không thể đánh đồng khi mua card cũ với kỳ vọng mở khóa.
Sự khác biệt giữa các phiên bản CMP cũng dễ gây hiểu nhầm. Bản 8GB được nghiên cứu có thể chứa lượng HBM phù hợp để mở lên 80GB; còn bản 10GB thường gắn với cấu hình vật lý khoảng 40GB. Dung lượng hiển thị lúc xuất xưởng lớn hơn không có nghĩa tiềm năng sau mod cao hơn. Không thể lấy kết quả của bản 8GB làm cam kết cho bản 10GB.
Khóa bằng phần mềm và khóa ở cấp chip cũng không giống nhau. Công cụ mở khóa phần mềm trước đó đã đưa nhiều card 8GB lên 64GB, nhưng vẫn bị giới hạn bởi các cấu hình eFuse. Can thiệp điện áp nhằm vượt qua lớp hạn chế còn lại, sau đó vẫn cần cấu hình phần mềm thích hợp để ứng dụng sử dụng những khối vừa được bật.
Voltage glitching vượt qua bảo vệ ghi eFuse
Điểm yếu nằm ở cách chip đọc và thực thi cấu hình bảo vệ trong quá trình khởi động. Bài công bố mô tả bộ điều khiển chứa 16.384 eFuse trong mảng 512 hàng, mỗi hàng 32 bit. Những giá trị đọc ra quyết định tính năng nào được bật và có cho phép ghi thêm vào vùng fuse hay không.
Cầu chì đã thổi không thể đơn giản khôi phục về trạng thái ban đầu, nhưng nhóm fuseless fuse, viết tắt FF, hoạt động như một chuỗi bản ghi cấu hình. Khi hai bản ghi cùng chỉ đến một vùng cấu hình, bản đến sau có thể thay thế giá trị hiệu lực của bản trước. Nhờ vậy, ghi thêm fuse có thể nới giới hạn thay vì chỉ làm chip bị khóa chặt hơn.
Điều này không có nghĩa eFuse cũ được sửa lại. Thay đổi vật lý vẫn là ghi thêm các bit, còn giá trị cấu hình mà phần còn lại của chip nhận được mới là thứ bị thay thế. Đây là khác biệt quan trọng để hiểu tại sao một cơ chế không thể hoàn tác vẫn có thể được dùng để bật lại tính năng.
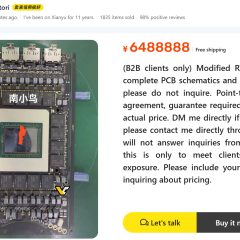
Bình thường, card thương mại chặn ghi vào vùng FF. Một bo mạch dùng vi điều khiển STM32G4 can thiệp tín hiệu điều áp PWMVID để bộ điều áp của chính card tạo ra những xung sụt áp ngắn. Nếu thời điểm phù hợp, bộ điều khiển fuse đi vào trạng thái cho phép thay đổi các thiết lập bảo vệ, từ đó mở đường ghi cấu hình mới.
Không phải cứ làm chip đọc sai là mở khóa được. Có trạng thái lỗi khiến gần như toàn bộ cấu hình thành số không và GPU không sử dụng được; trạng thái hữu ích phải giữ phần lớn chip hoạt động trong khi một nhóm kiểm soát bảo vệ bị tác động. Vì vậy, xung gây lỗi dùng được với chip này không mặc nhiên phù hợp với chip khác.
Thao tác thực tế đòi hỏi hàn dây và tháo một điện trở trên bo mạch, chứ không phải nạp BIOS rồi khởi động lại. Tác giả báo cáo thời gian dò xung từ khoảng một giờ đến 48 giờ tùy card. Sau khi tìm được trạng thái thích hợp, cấu hình ghi thêm còn phải khớp với những khối thực sự không lỗi trên từng die; bật cả phần hỏng chỉ để có con số đẹp sẽ làm mất ý nghĩa của bản mod.
80GB sử dụng được là kết quả thử nghiệm, không phải tỷ lệ bảo đảm
Khả năng truy cập thật vào toàn bộ bộ nhớ quan trọng hơn con số hiện trong công cụ quản lý GPU. Trong mẫu 10 card 8GB mà nhà nghiên cứu kiểm tra, 9 chiếc có 80GB hoạt động, còn một chiếc chỉ có 64GB dùng được. Với chiếc còn lại, mở khóa phần cứng không đem đến lợi thế dung lượng so với phương pháp phần mềm.
Đây là mẫu thử nhỏ, không phải chứng nhận rằng người mua bất kỳ card nào cũng có xác suất thành công tương tự. Lịch sử vận hành và tình trạng bộ nhớ của card cũ cũng không được giải quyết chỉ bằng việc gỡ một giới hạn cấu hình. Giá trị của bản mod nằm ở lượng phần cứng còn tốt có thể dùng, không nằm ở tên gọi mà người bán gắn cho nó.
Công bố có phép thử ghi dữ liệu giả ngẫu nhiên trên toàn vùng nhớ rồi đọc lại sau khi làm mất hiệu lực bộ đệm L2, đồng thời báo cáo chạy được các tải thực tế. Cách kiểm tra này cần thiết vì bộ nhớ báo dung lượng lớn có thể vẫn ánh xạ trùng vào vùng vật lý nhỏ hơn; nhìn màn hình nhận đủ VRAM chưa đủ để kết luận.
Với tải AI cần chứa mô hình trong VRAM, mở thêm dung lượng có thể hữu ích ngay cả khi chưa tăng tốc tính toán tương ứng. Nhưng khả năng chứa mô hình và tốc độ xử lý là hai giới hạn riêng. Một phép đo bộ nhớ thành công không thay thế phép đo ứng dụng mà người dùng định chạy.
Hơn A100 ở FP16 FMA không đồng nghĩa nhanh hơn mọi tác vụ AI
Số SM hoạt động nhiều hơn giúp giải thích vì sao một bản CMP mở khóa có thể vượt A100 bán lẻ ở phép thử tính toán nhất định. Bảng FP16 FMA OpenCL trên Kate’s blog ghi nhận các kết quả sau; đơn vị là nghìn tỷ phép tính dấu phẩy động mỗi giây, số cao hơn tốt hơn.
| Phép thử | CMP 170HX mở phần mềm | NVIDIA A100 bán lẻ | CMP 170HX mở phần cứng |
|---|---|---|---|
| FP16 FMA (TFLOP/s, cao hơn tốt hơn) | 50,129 | 72,488 | 85,861 |
Số liệu: Kate’s blog, bảng so sánh OpenCL FP16 half2 FMA. Phần log đo chi tiết của bản mod ghi 85,858 TFLOP/s, chênh rất nhỏ so với 85,861 trong bảng tổng hợp.
Mức hơn khoảng 18% chỉ áp dụng cho phép thử này. FP16 FMA không phải kết quả huấn luyện mô hình, tốc độ sinh token hay phép đo Tensor Core; nó không cho phép suy ra mọi ứng dụng AI sẽ nhanh hơn A100 tương ứng. Khi tính toán trở thành nút thắt khác với bộ nhớ hoặc giao tiếp giữa các GPU, lợi thế số SM cũng có thể được thể hiện khác đi.
Log OpenCL công bố cho mẫu mod ghi 124 cụm tính toán ở 1.410MHz. Ngoài FP16, kết quả còn bao gồm các kiểu dữ liệu và mẫu truy cập bộ nhớ dưới đây; nguồn không cung cấp số A100 đối chứng cho từng hàng, nên không thể dùng bảng này để xếp hạng toàn diện hai card.
Thông lượng tính toán của bản mod
| Phép thử (cao hơn tốt hơn) | CMP 170HX mở phần cứng |
|---|---|
| FP64 FMA (TFLOP/s) | 11,287 |
| FP32 FMA (TFLOP/s) | 22,781 |
| FP16 half2 FMA (TFLOP/s) | 85,858 |
| INT64 a×b+c (TIOP/s) | 2,759 |
| INT32 a×b+c (TIOP/s) | 22,769 |
| INT16 short2 a×b+c (TIOP/s) | 20,273 |
| INT8 char4 dp4a (TIOP/s) | 81,169 |
Các hàng dùng kiểu dữ liệu khác nhau, không phải những ứng viên cạnh tranh để chọn một kết quả tốt nhất. Không có số đối chứng tương ứng của A100 trong log này.
Băng thông bộ nhớ và PCIe của bản mod
| Phép thử (GB/s, cao hơn tốt hơn) | CMP 170HX mở phần cứng |
|---|---|
| Đọc bộ nhớ đồng bộ truy cập | 1.883,17 |
| Ghi bộ nhớ đồng bộ truy cập | 2.137,93 |
| Đọc bộ nhớ lệch căn chỉnh | 1.460,81 |
| Ghi bộ nhớ lệch căn chỉnh | 250,13 |
| PCIe gửi dữ liệu | 13,10 |
| PCIe nhận dữ liệu | 11,69 |
| PCIe hai chiều, Gen3 x16 trong log | 11,58 |
Số liệu: Kate’s blog, log ProjectPhysX OpenCL-Benchmark; TFLOP/s dùng cho số thực, TIOP/s dùng cho số nguyên.
Chênh lệch giữa ghi bộ nhớ đồng bộ và ghi lệch căn chỉnh cho thấy ngay trong một card, kiểu truy cập cũng ảnh hưởng rất lớn đến kết quả. Do đó, lấy duy nhất thông lượng FP16 hoặc băng thông cao nhất để tính thời gian chạy một mô hình cụ thể sẽ thiếu căn cứ. Bài toán thực tế còn phụ thuộc cách phần mềm khai thác bộ nhớ và luân chuyển dữ liệu.
Chi phí GPU cũ chưa phải chi phí của một hệ thống dùng được
Khôi phục dung lượng chưa tự động khôi phục mọi khả năng của một A100 thương mại. Công bố xác nhận PCIe Gen3 và Gen4 có thể hoạt động sau khi gỡ giới hạn thích hợp; để đạt Gen4 x16 còn có sửa đổi phần cứng bổ sung. Log benchmark phía trên chạy ở Gen3 x16, nên không được gán số băng thông ấy cho cấu hình Gen4.
NVLink cũng cần sửa thêm bo mạch do CMP thiếu một linh kiện liên quan đến cầu nối, đồng thời phải xử lý kiểm tra ở phía firmware. Còn những tính năng như MIG, NVDEC và NVJPG được nêu là có thể mở nhưng chưa được tác giả kiểm thử. Tuyên bố “biến thành A100 đầy đủ” vì vậy đi xa hơn những gì các kết quả đã xác nhận.
Về giá, Tom’s Hardware ghi nhận CMP 170HX bản 8GB ở khoảng 3.000 USD, bản 10GB khoảng 2.500 USD, còn A100 80GB PCIe có thể lên tới 20.000 USD trở lên. Không nên ghép mức 2.500 USD của bản 10GB với khả năng mở 80GB đã được thể hiện trên bản 8GB để tạo cảm giác món hời lớn hơn.
Với người dùng Việt Nam mua qua thị trường card cũ hoặc nhập lại, mức giá quốc tế này chỉ có ý nghĩa tham khảo, không phải báo giá giao đến tay. Điều cần yêu cầu trước khi trả tiền là bằng chứng về đúng biến thể card, dung lượng thực sự đọc ghi được và tải sử dụng chạy ổn định. Một ảnh chụp nhận 80GB hay tên GPU được đổi lại không chứng minh được những điều đó.
Chênh lệch giá mua card vẫn phải bù cho công sửa mạch, thời gian thử nghiệm và nguy cơ hỏng thiết bị. Với phòng thử nghiệm có khả năng chấp nhận gián đoạn, đây là hướng tận dụng phần cứng đáng nghiên cứu. Với công việc cần vận hành liên tục, cấu hình đã được kiểm tra và khả năng hỗ trợ có giá trị hơn một kết quả FP16 cao trên giấy.
Phát hiện đã được thông báo cho đội bảo mật sản phẩm Nvidia trước khi công bố. Giá trị kỹ thuật rõ nhất là chỉ ra một giới hạn của cơ chế khóa bằng eFuse: ghi thêm bit có thể nới quyền khi thiết kế cho phép bản ghi mới thay đổi cấu hình hiệu lực. Còn giá trị mua sắm phải được chứng minh trên từng card, không thể suy ra từ một bản mod thành công.
Nguồn tham khảo: Kate’s blog — công bố kỹ thuật và benchmark; Tom’s Hardware; Techtroduce