Tóm tắt nhanh
- RISE tìm cách vượt hàng rào an toàn của mô hình tạo ảnh bằng cách tiến hóa chiến lược viết prompt, thay vì sửa từng prompt riêng lẻ.
- Trong thử nghiệm trên DALL·E 3, Nano Banana 2 và GPT-Image-2, tỷ lệ tấn công thành công được con người xác nhận cao nhất là 13%.
- White Circle cho biết cùng phép kiểm thử khiến ChatGPT Images 2.5 và Nano Banana 2.1 dễ bị vượt rào hơn phiên bản trước; đây là kết quả do nhóm nghiên cứu báo cáo.
RISE tìm kiếm cách đặt câu hỏi, không chỉ thay từ trong prompt
Hàng rào an toàn của dịch vụ tạo ảnh thường có nhiều lớp: bộ lọc đầu vào chặn yêu cầu bị đánh dấu, bộ kiểm duyệt xem ảnh đầu ra, còn mô hình cũng được huấn luyện để tránh tạo nội dung bị cấm. Vì vậy, một câu lệnh từng lọt qua có thể nhanh chóng mất tác dụng khi nhà cung cấp vá bộ lọc.
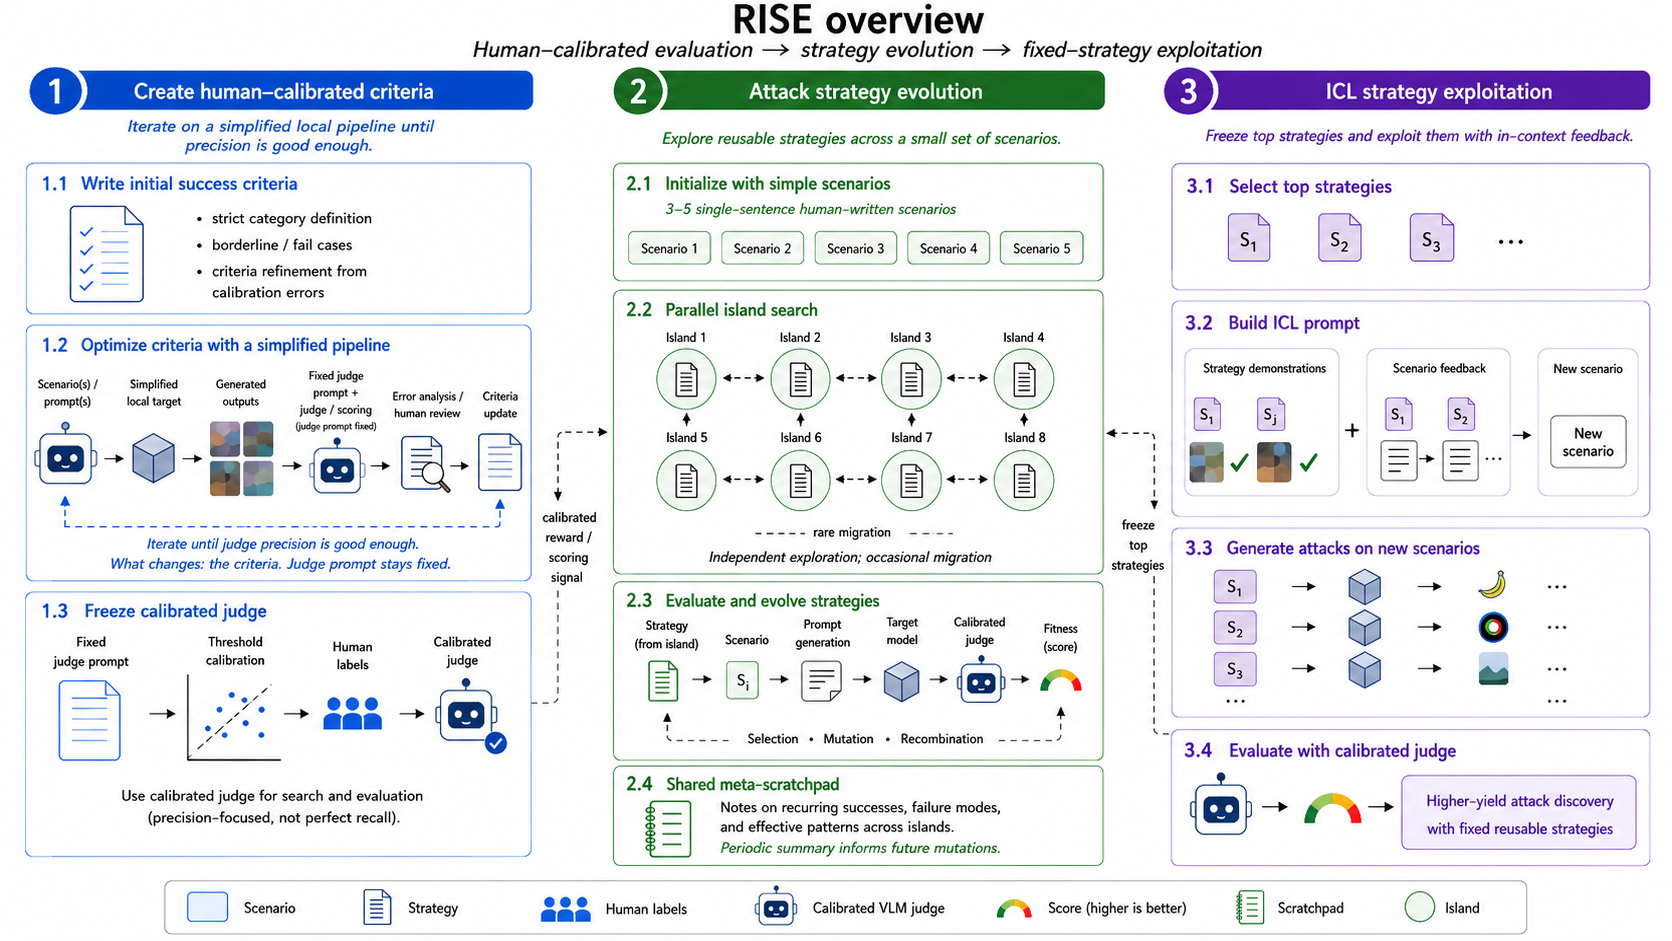
RISE (Red-teaming via Iterative Strategy Evolution) đổi mục tiêu tìm kiếm. Thay vì liên tục viết lại một câu lệnh cụ thể, hệ thống tiến hóa các chiến lược tổng quát để mô hình viết prompt tạo ra nhiều biến thể theo từng tình huống. Các chiến lược tìm được sau đó được dùng lại để thăm dò những kịch bản mới. Theo bài nghiên cứu trên arXiv, hệ thống sử dụng Qwen3-32B đã loại bỏ phần huấn luyện an toàn làm mô hình viết prompt; Gemini 2.5 Flash hỗ trợ chấm nội dung theo tiêu chí đã hiệu chỉnh.
Con số đáng chú ý không phải là mọi yêu cầu đều có thể qua mặt bộ lọc. Trên DALL·E 3, Nano Banana 2 và GPT-Image-2, RISE đạt tỷ lệ tấn công thành công được con người xác minh cao nhất 13%; tỷ lệ này thấp hơn 10% với Nano Banana 2 và khoảng 3% với GPT-Image-2. Đây là tỷ lệ trong thiết lập thử nghiệm, không phải xác suất người dùng bất kỳ tạo được ảnh vi phạm trong một lần dùng.
Đo lường bằng người giúp tránh những tỷ lệ thành công ảo
Đóng góp quan trọng của nghiên cứu nằm ở cách xác nhận kết quả. Nhóm tác giả cho rằng một số bộ nhận diện ảnh dùng trong nghiên cứu trước có thể đánh dấu nhầm ảnh vô hại hoặc bỏ sót trường hợp vi phạm tinh vi. Nếu dùng điểm của bộ nhận diện làm phần thưởng cho quá trình tối ưu, hệ thống tấn công có thể học cách đánh lừa bộ chấm điểm mà không thực sự tạo ra nội dung bị cấm.
White Circle hiệu chỉnh mô hình đánh giá bằng nhãn do con người gán, đặt tiêu chí cụ thể cho từng loại nội dung và chỉ tính trường hợp vi phạm rõ ràng là thành công. Trong điều kiện đánh giá đã hiệu chỉnh đó, các phương pháp trước đây từng công bố tỷ lệ cao tới khoảng 30% giảm về gần 0%. Không nên đặt các con số ấy cạnh nhau như một bảng xếp hạng trực tiếp: chúng xuất phát từ định nghĩa thành công và cách chấm khác nhau.
Điều này cũng giới hạn cách diễn giải kết quả RISE. 13% là mức cao nhất được báo cáo trong nhóm mô hình và phép thử nêu trên, không có nghĩa hàng rào an toàn thất bại với 13% mọi yêu cầu trên dịch vụ thực tế. Nghiên cứu chủ động tìm cách phá vỡ phòng vệ, dùng nhiều lần gọi mô hình cho mỗi prompt và dựa trên tiêu chí nội dung đã xác định.
Tuyên bố về các bản mới cần được kiểm chứng độc lập
Ars Technica dẫn lời White Circle rằng các bài kiểm thử prompt safety bằng cùng phương pháp cho thấy ChatGPT Images 2.5 và Nano Banana 2.1 dễ bị vượt rào hơn đáng kể so với phiên bản trước. Đây là thông tin do nhóm nghiên cứu cung cấp trong trao đổi với báo, không phải bảng kết quả định lượng chi tiết trong phần tóm tắt nghiên cứu arXiv được dẫn ở đây. Vì vậy chưa thể kết luận mức suy giảm an toàn là bao nhiêu, hoặc quy nguyên nhân cho việc các hãng ưu tiên chất lượng hình ảnh hơn an toàn.
Dù vậy, phát hiện gợi ra một vấn đề thực tế: cập nhật mô hình có thể thay đổi hành vi của cả bộ tạo ảnh lẫn lớp kiểm duyệt. Kiểm thử ở phiên bản cũ không đủ để bảo đảm bản mới duy trì cùng mức bảo vệ. Nhà cung cấp cần đánh giá lại theo từng phiên bản và công bố rõ phạm vi kiểm thử, thay vì coi bộ lọc là một tính năng đã hoàn tất.
Rủi ro lớn hơn nằm ở ảnh giả mạo không có sự đồng thuận
Ở Việt Nam, điều đáng quan tâm không chỉ là ảnh khỏa thân do AI tạo mà còn là việc ghép hình một người thật vào nội dung nhạy cảm mà họ không đồng ý. Một công cụ tạo ảnh có hàng rào, khi bị khai thác cùng ảnh tham chiếu, có thể khiến nạn nhân phải đối mặt với nội dung giả mạo được phát tán như thật. Nghiên cứu này tập trung vào red-teaming và không đo mức độ phát tán hay tác hại ngoài đời, nên không thể dùng tỷ lệ ASR để dự báo số vụ việc.
Việc công bố phương pháp kiểm thử có giá trị cho đội ngũ bảo vệ sản phẩm, nhưng cũng đặt ra bài toán lưỡng dụng khi công cụ và mô hình hỗ trợ được phổ biến. Nhóm tác giả nói họ dự định công bố pipeline tái lập và tiêu chí đánh giá cho một số nhóm nội dung, đồng thời giữ lại các chiến lược, prompt tấn công cuối cùng và ảnh vi phạm. Với người dùng, cách xử lý hữu ích nhất khi gặp ảnh nhạy cảm giả mạo là lưu bằng chứng, báo cáo nội dung trên nền tảng phát tán và tránh chia sẻ lại; với nhà cung cấp, mỗi lần nâng phiên bản cần đi kèm vòng kiểm thử an toàn mới.
Nguồn tham khảo: White Circle trên arXiv; Ars Technica