Tóm tắt nhanh
- Meta đang triển khai trò chuyện bằng giọng nói và avatar biểu cảm cho Muse trên ứng dụng di động, web và Mac tại Mỹ.
- Người dùng có thể chọn hàng trăm kiểu giọng; avatar có thể hiển thị toàn màn hình, cạnh cuộc trò chuyện hoặc tắt để chỉ nghe tiếng.
- Meta AI Research công bố độ trễ khoảng 870 ms từ lúc người dùng dứt lời đến byte đầu tiên của phản hồi đồng bộ tiếng và hình, đo trong điều kiện máy chủ GB200.
- Tính năng chưa được triển khai tại Việt Nam; Meta nói hỗ trợ kính AI và Muse Charm sẽ đến sau.
Meta đang đưa Muse từ trợ lý chat sang trò chuyện trực tiếp bằng giọng nói, với avatar cử động theo lời đáp. Phần đáng chú ý không nằm riêng ở hình đại diện biết nói, mà ở cách Meta ghép luồng tạo tiếng và hình để phản hồi gần như tức thời — dù con số độ trễ hãng công bố là phép đo trong hạ tầng máy chủ của mình, không phải cam kết cho mọi người dùng.
Avatar giúp cuộc trò chuyện bớt giống một ô chat phát tiếng
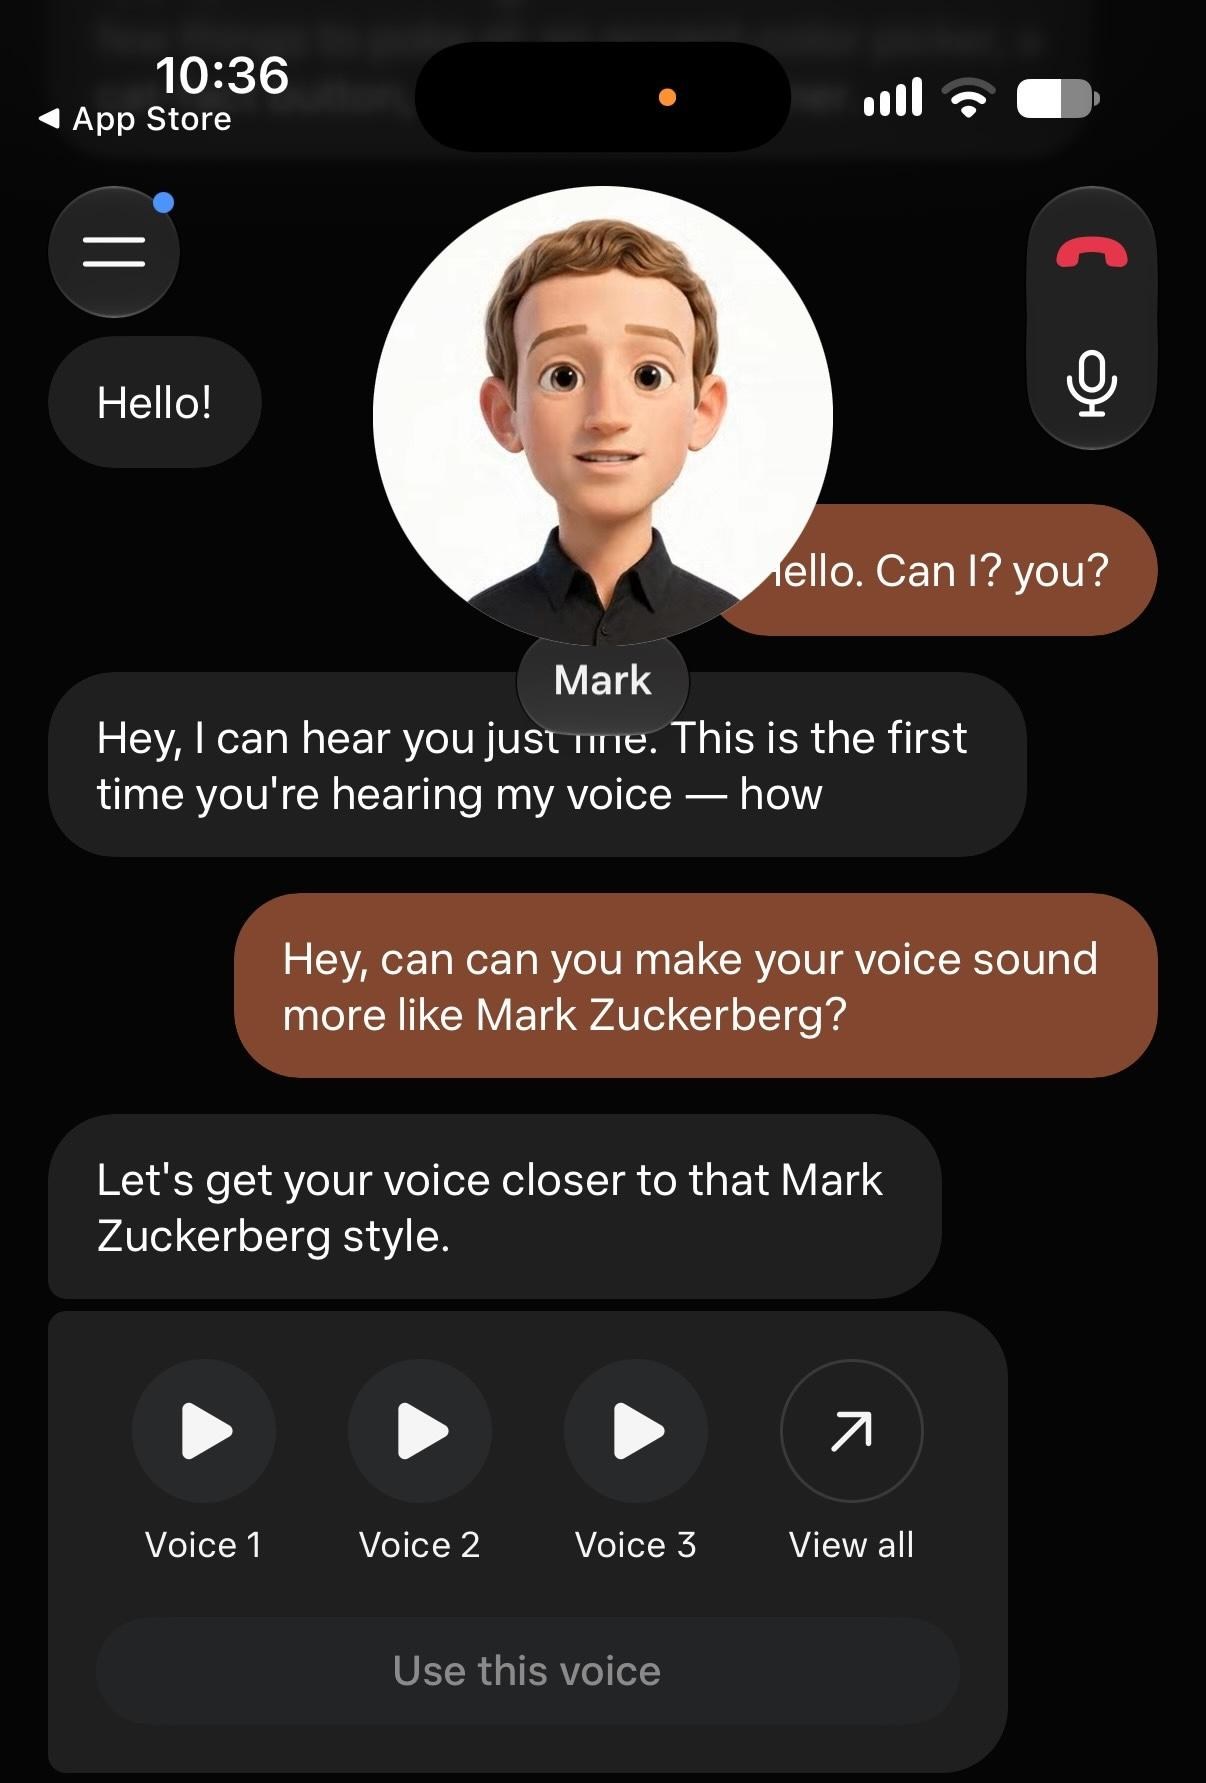
Voice mode cho phép người dùng nói chuyện với Muse thay vì gõ prompt. Meta cho biết người dùng có thể ngắt lời trợ lý, chọn trong hàng trăm phong cách giọng nói, và quyết định avatar hiện cạnh nội dung, chiếm toàn màn hình hay không xuất hiện.
Khác với chế độ giọng nói chỉ phát âm thanh, Muse ghép lời nói với biểu cảm và cử chỉ của avatar. Cách trình bày này có thể khiến việc trao đổi ý tưởng, luyện phỏng vấn hay tập thuyết trình tự nhiên hơn với người thích phản hồi trực quan; nhưng một avatar chuyển động không đồng nghĩa trợ lý hiểu đúng hơn. Chất lượng câu trả lời vẫn phụ thuộc vào mô hình hội thoại và thông tin nó truy xuất.
Phản hồi thường nhanh, song đôi lúc Muse vẫn ngừng lại khi tra cứu. Người viết cũng thấy avatar có phần kỳ lạ khi dùng hình đại diện giống Mark Zuckerberg. Đây là một đánh đổi dễ hình dung: biểu cảm có thể làm tương tác sinh động hơn, nhưng nếu nét mặt hoặc giọng không khớp kỳ vọng, nó cũng khiến cuộc trò chuyện trở nên gượng gạo.
Độ trễ dưới một giây đến từ cả mô hình lẫn hạ tầng
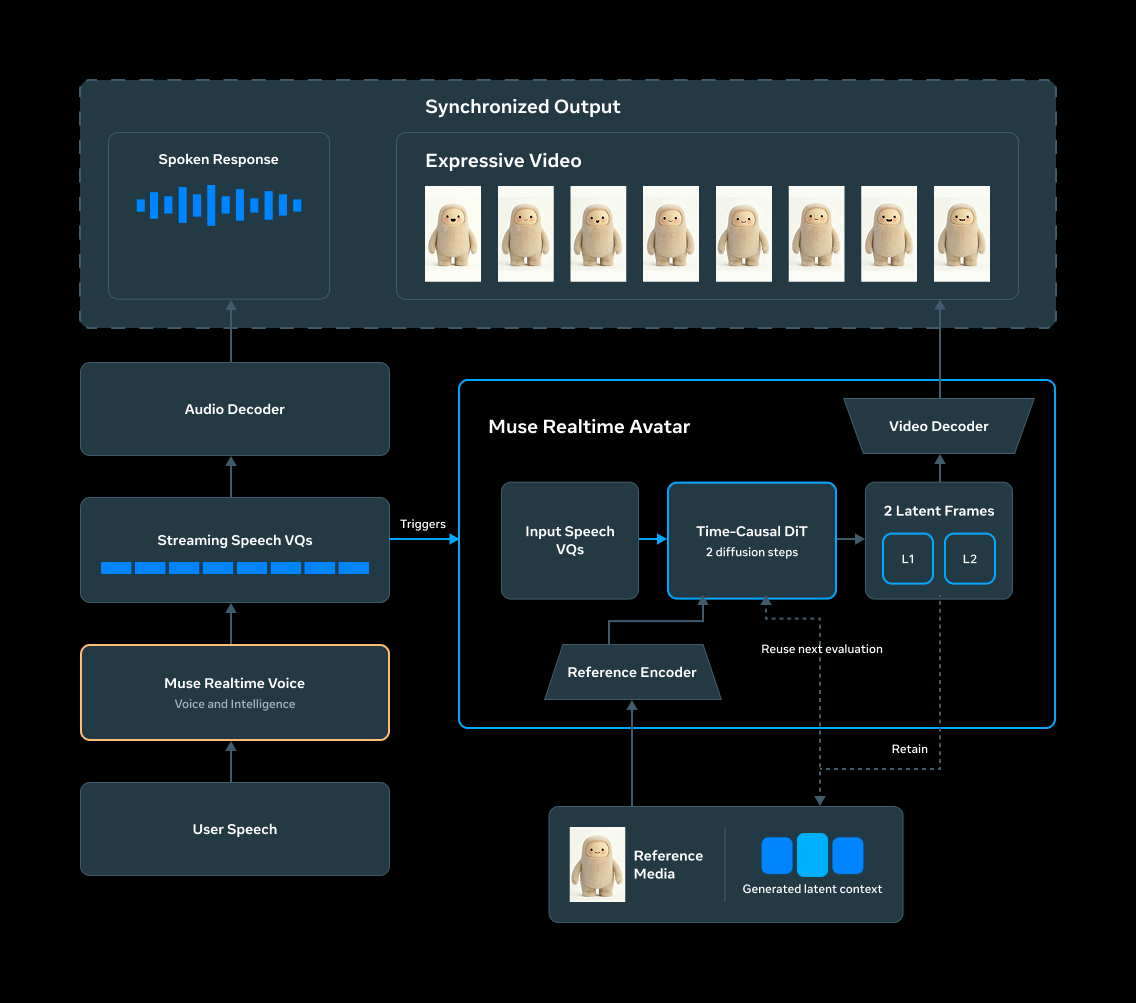
Meta AI Research cho biết Muse Realtime Voice và Muse Realtime Avatar dùng chung luồng token lời nói: hệ thống tạo nội dung và cách thể hiện lời nói, bộ giải mã biến luồng đó thành âm thanh, còn mô hình avatar tạo chuyển động tương ứng. Dùng chung tín hiệu giúp khẩu hình và biểu cảm bám theo giọng thay vì dựng hai phần độc lập rồi ghép lại. Sơ đồ của Meta mô tả lời người dùng đi qua Muse Realtime Voice, sau đó luồng lời nói được chuyển thành âm thanh và đồng thời cấp cho Muse Realtime Avatar. Mô hình avatar dùng hình tham chiếu cùng ngữ cảnh các khung hình trước để tạo video đồng bộ.
Avatar phát video dọc 448 × 768 pixel ở 25 khung hình/giây. Meta đo khoảng 870 ms từ lúc người dùng kết thúc lượt nói đến khi nhận byte đầu tiên của phản hồi tiếng-hình đồng bộ. Đây là độ trễ đầu lượt trong phép đo của Meta, không phải thời gian hoàn tất toàn bộ câu trả lời; mạng của người dùng và độ dài tác vụ vẫn có thể làm trải nghiệm thực tế khác đi.
Để tạo video liên tục, Meta mô tả mô hình sinh theo từng đoạn ngắn và dùng phần video vừa tạo làm ngữ cảnh cho đoạn kế tiếp. Cách này vừa giữ mạch chuyển động, vừa giới hạn lượng tính toán cần giữ trong mỗi lần sinh. Hãng nói mô hình teacher cần 40 bước khuếch tán với ba lượt đánh giá mỗi bước, tổng cộng 120 lượt cho một đoạn; mô hình student hai bước được chưng cất để giảm con số đó xuống còn 2 lượt, tức ít hơn 60 lần trong so sánh nội bộ của Meta. Đây là số lần đánh giá mô hình, không có nghĩa ứng dụng chạy nhanh hơn 60 lần đối với người dùng.
Con số 870 ms cũng dựa trên cấu hình máy chủ NVIDIA GB200 và một hệ thống phục vụ được tối ưu riêng. Meta cho biết mỗi bước sinh tạo 8 khung hình, tương ứng 320 ms video, trong 20 ms xử lý trên một phiên; các tối ưu khác nâng công suất phục vụ lên 8 lần so với baseline BF16 hai bước và cho phép 12 phiên tạo video đồng thời trên một GB200. Những số liệu này giải thích vì sao tính năng có thể chạy ở quy mô dịch vụ, nhưng không thể dùng trực tiếp để dự đoán mức tiêu thụ pin hay độ trễ trên điện thoại.
Đưa avatar lên kính sẽ đặt ra giới hạn khác
Meta cho biết voice mode đang được triển khai tại Mỹ trên ứng dụng Muse cho di động, web và Mac; đàm thoại sẽ sớm có trên kính AI và thiết bị Muse Charm. Hãng chưa nêu ngày phát hành cụ thể cho hai thiết bị trong thông báo này.
Trên điện thoại hoặc máy tính, người dùng chủ động nhìn màn hình khi trò chuyện. Với kính, phản hồi giọng nói cần hữu ích ngay cả khi người đeo không nhìn thấy avatar; vì vậy giá trị chính có thể nằm ở hội thoại rảnh tay, còn phần hình ảnh phải thích ứng với màn hình nhỏ hoặc không gian hiển thị khác. Meta chưa công bố chi tiết cách avatar sẽ xuất hiện trên kính.
Tại Việt Nam, thông báo hiện giới hạn đợt triển khai ở Mỹ, nên người dùng trong nước chưa có quyền truy cập chính thức theo phạm vi được công bố. Muse Charm cũng chưa phải thiết bị đang bán; thời điểm hỗ trợ voice mode trên kính và Charm vẫn được mô tả là sắp tới.
Điểm cần theo dõi tiếp theo không chỉ là khi nào tính năng mở rộng ra ngoài Mỹ, mà còn là cách Meta xử lý quyền riêng tư và sự thoải mái khi avatar mang hình ảnh nhân vật cụ thể tham gia cuộc trò chuyện. Meta nói video tạo ra được gắn dấu mờ vô hình bằng Video Seal để truy xuất nguồn gốc; hiệu quả bảo vệ và cách tính năng vận hành trên từng thiết bị sẽ rõ hơn khi được phát hành rộng rãi.
Nguồn tham khảo: Meta, Meta AI Research, The Verge