Tóm tắt nhanh
- Ngày 9/11/2026, Anthropic ra mắt Claude Fable 5.2 và Mythos 5.2 với giá 8 USD cho một triệu token đầu vào, 40 USD cho một triệu token đầu ra, thấp hơn mức 10/50 USD của Fable 5.1; tốc độ sinh token nhanh hơn tới 30%.
- Trên bảng điểm do Anthropic công bố, Fable 5.2 dẫn Opus 5.5, GPT-6 Astra và Gemini 4 Carbon ở phần lớn bài đo, nhưng thua Gemini 4 Carbon ở AutomationBench và thua Opus 5.5 ở điểm Elo của AA-Briefcase.
- Cùng ngày, Meta bán Muse Ember với giá 0,10 USD đầu vào và 0,50 USD đầu ra; chỉ số Artificial Analysis đạt 36, ngang Claude Haiku 5.5 và hơn GPT-6 Luna (28), với chi phí mỗi tác vụ khoảng 0,14 USD.
- Toàn bộ số liệu đều do chính hãng công bố hoặc dẫn lại; OpenAI chưa có phản hồi nào trong các nguồn này.
Anthropic và Meta công bố mô hình mới trong cùng ngày 9/11/2026, một ở đầu đắt nhất, một ở đầu rẻ nhất của thị trường API, và cả hai đều đặt bảng điểm của mình cạnh sản phẩm của OpenAI. Claude Fable 5.2 bị so với GPT-6 Astra, Muse Ember bị so với GPT-6 Luna. Hai model không cạnh tranh trực tiếp với nhau, nhưng đọc cạnh nhau thì chúng cho thấy cùng một hướng: chi phí chạy tác nhân AI đang trở thành điểm bán hàng ngang với độ thông minh.
Fable 5.2 dẫn ở phần lớn bảng điểm, nhưng không thắng toàn bộ
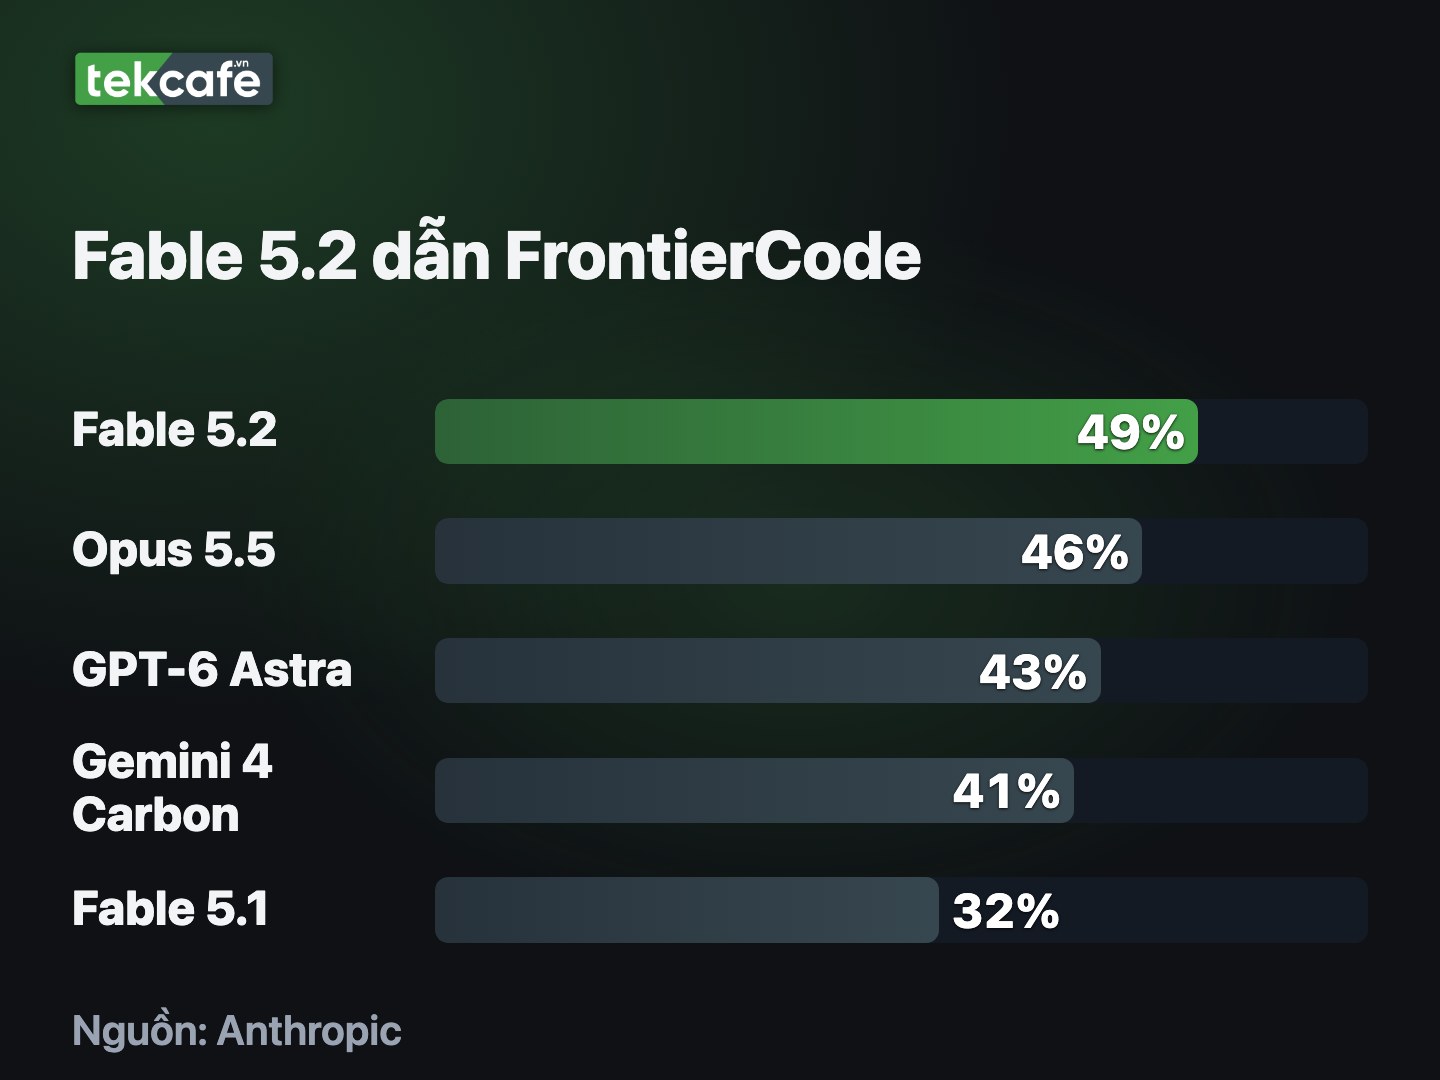
Trên FrontierCode 2.0, bài đo xem thay đổi mã của model có được người bảo trì các dự án mã nguồn mở chấp nhận hay không, Fable 5.2 ở mức effort Xhigh đạt 49,1%. Opus 5.5 đạt 45,5%, GPT-6 Astra 42,8%, Gemini 4 Carbon 41,1% (mức effort Medium) và Fable 5.1 chỉ 32,4%. Ở FrontierSWE v2, Fable 5.2 đạt 69,9% so với 65,5% của GPT-6 Astra và 62,3% của Opus 5.5. Anthropic đo các model ở mức effort cao nhất hiện có của từng bên và bật safeguards, nên đây là điểm do hãng tự chọn điều kiện chứ chưa phải kết quả kiểm định độc lập.
| Bài đo | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| FrontierCode 2.0 | 49,1% (Xhigh) | 32,4% | 45,5% | 42,8% | 41,1% (Medium) |
| FrontierSWE v2 | 69,9% | 56,3% | 62,3% | 65,5% | 61,2% |
| AutomationBench | 51,4% | 31,4% | 42,5% | 41,4% | 53,9% |
| Terminal-Bench-Science 0.1 | 74,6% | 52,6% | 58,7% | 68,1% | 64,8% |
| OSWorld 2.1 (bộ offline, điểm một phần) | 89,3% | 83,5% | 87,2% | 79,5% | 81,5% |
| RoboDojo Sim | 64,9% | 27,6% | 39,4% | 29,8% | — |
| Humanity’s Last Exam (có công cụ) | 74,2% | 65,6% | 67,7% | 57,2% | — |
| Chartography (không công cụ) | 73,4% | 44,8% | 64,4% | 71,0% | 72,5% |
Số liệu: Anthropic. Điểm của từng model ở mức effort cao nhất, safeguards bật.
Khoảng cách với GPT-6 Astra thay đổi rất nhiều theo bài đo. Ở Chartography, Fable 5.2 chỉ hơn Astra 2,4 điểm phần trăm (73,4% so với 71,0%) và hơn Gemini 4 Carbon chưa đầy 1 điểm. Ở RoboDojo Sim thì 64,9% đối với 29,8%, tức hơn gấp đôi. Hai chỗ Fable không đứng đầu cũng đáng ghi lại: AutomationBench, nơi Gemini 4 Carbon đạt 53,9% còn Fable 5.2 đạt 51,4%, và điểm Elo của AA-Briefcase, nơi Opus 5.5 có 1800 so với 1785 của Fable 5.2. Nói gọn, đây là model dẫn đầu về lập trình tác nhân và suy luận, chứ chưa phải model thắng mọi thứ.
Giá giảm 20% và nhanh hơn 30% mới là thay đổi đáng tính với người trả tiền API
Điểm số chỉ có ý nghĩa khi đi kèm giá. Fable 5.1 bán ở mức 10 USD đầu vào và 50 USD đầu ra cho mỗi triệu token; Fable 5.2 giảm xuống 8 và 40 USD, tức bớt 20% ở cả hai chiều, trong khi tốc độ sinh token nhanh hơn tới 30%. Chế độ fast mode tùy chọn tăng tốc tới 2,5 lần với giá 16 USD đầu vào và 80 USD đầu ra. Một model mạnh hơn mà lại rẻ hơn bản trước hiếm khi xảy ra trong ngành này, và nó buộc các đối thủ phải trả lời bằng giá chứ không chỉ bằng điểm.
Anthropic cũng nêu con số về chi phí trên mỗi tác vụ: ở mức effort High, Fable 5.2 đạt 45,3% trên FrontierCode 2.0, gần bằng điểm tốt nhất của Opus 5.5 ở mức Max (45,5%), với chi phí khoảng một nửa. Đây vẫn là phép so do hãng tự thực hiện. Theo Vals AI, một bên độc lập, ở mức reasoning High mỗi bài kiểm tra chạy Fable 5.2 tốn 17,94 USD, thấp hơn cả Opus 5.5 lẫn GPT-6 Astra ở mức tương đương; con số này chỉ phản ánh bộ bài kiểm tra của Vals AI.
Anthropic đồng thời nói Fable không phải lựa chọn mặc định. Với phần lớn việc lập trình và xử lý kiến thức, hãng khuyên bắt đầu bằng Opus 5.5, rồi nâng lên Fable hoặc hạ xuống Sonnet 5.5, Haiku 5.5 tùy độ phức tạp. Fable 5.2 cũng được định vị làm Advisor, tức model nhỏ hơn gọi sang khi gặp bài khó, hoặc Orchestrator, tức model giao việc đơn giản cho model nhỏ hơn.
Định lý Fermat trong 30 giờ cho thấy Anthropic đang bán cả đội tác nhân, không chỉ một model
Ví dụ gây chú ý nhất trong thông cáo là việc hình thức hóa chứng minh Định lý lớn Fermat trong ngôn ngữ lập trình toán học Lean. Một nhóm khoảng 1.000 tác nhân Fable 5.2 hoàn thành việc này trong 30 giờ với sự can thiệp tối thiểu của con người. Lần hình thức hóa đầu tiên của Anthropic, do một bản nghiên cứu chưa phát hành của Claude thực hiện, mất 11 ngày và cần bộ khung điều phối dựng riêng cùng hướng dẫn từ một nhà nghiên cứu. Với cùng thiết lập 1.000 tác nhân, Opus 5.5 chỉ hoàn thành 26% sau 18 giờ và gần như không tiến thêm sau 30 giờ. Anthropic cho biết Fable 5.2 tự dựng cách phối hợp từ lời nhắc tối thiểu, chỉ dùng danh sách phát biểu định lý trung gian để chấm tiến độ, cần khoảng một phần ba số token hành động và cho ra chứng minh ngắn hơn bảy lần.
Cần đọc kỹ điều kiện: đây là một lần chạy duy nhất cho mỗi model, do Anthropic tự thực hiện, trên một bài toán mà lời giải gốc đã tồn tại. Nó chứng minh model làm được việc dài hơi mà ít người giám sát, chưa chứng minh nó giải được bài toán mở. Điều đáng để ý hơn là cách tổ chức: 1.000 tác nhân chạy song song nghĩa là chi phí phụ thuộc vào số token nhân với số tác nhân, và giá mỗi triệu token trở thành biến số quyết định.
Muse Ember ngang Haiku 5.5 trên chỉ số tổng hợp, với chi phí khoảng một phần ba
Meta đặt Muse Ember ở phân khúc ngược lại: model nhỏ nhất và rẻ nhất của hãng, dành cho việc tác nhân lặp đi lặp lại cả ngày như gọi công cụ, làm các tác vụ con khi lập trình, định tuyến, trích xuất và đọc tài liệu dài. Giá niêm yết là 0,10 USD mỗi triệu token đầu vào, 0,50 USD đầu ra và 0,004 USD cho token đầu vào đã cache, với cửa sổ ngữ cảnh 1 triệu token và tối đa 512.000 token đầu ra. Với prompt trên 200.000 token, giá tăng lên 0,30 USD đầu vào và 1,50 USD đầu ra. Model chạy trên Meta Model API và Muse Code dưới tên muse-ember-1.0.
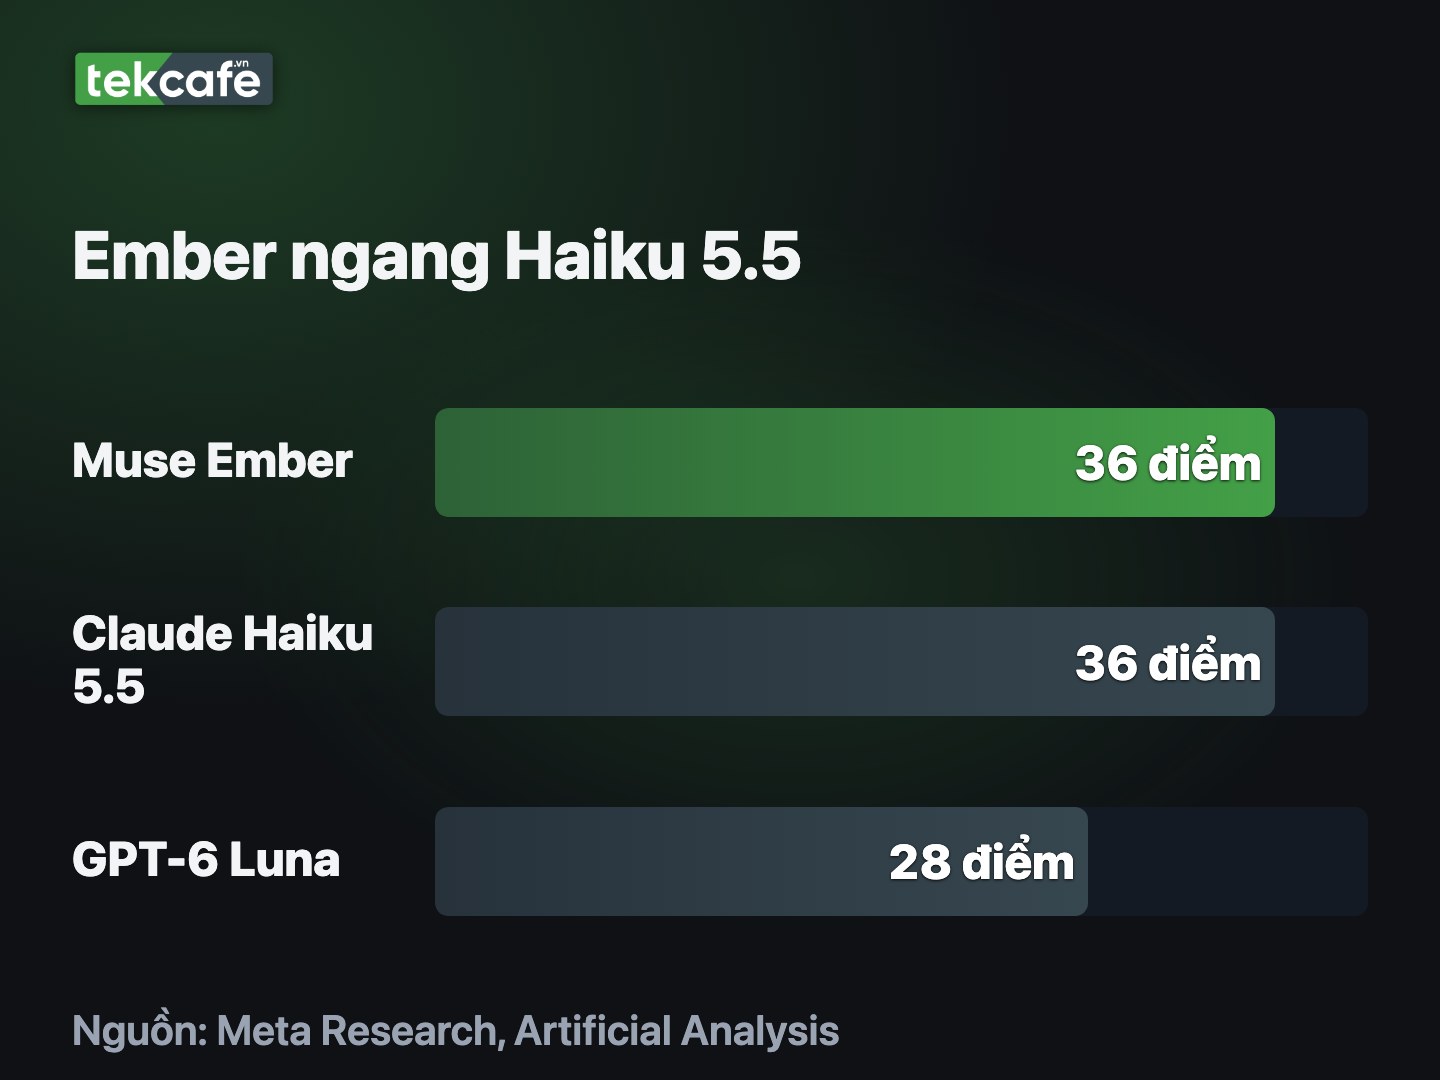
Theo Artificial Analysis, ở mức reasoning max, Muse Ember đạt 36 điểm trên Intelligence Index, bằng Claude Haiku 5.5 (36) và hơn GPT-6 Luna (28). Chi phí mỗi tác vụ của Ember khoảng 0,14 USD, còn Haiku 5.5 ở mức max là 0,41 USD, tức gấp khoảng ba lần. GPT-6 Luna ở mức max tốn 0,15 USD mỗi tác vụ nhưng chỉ được 27,8 điểm. Meta lưu ý chi phí của Ember là ước tính theo giá niêm yết, và so sánh này dùng Intelligence Index v5 do Artificial Analysis công bố cùng ngày.
| Bài đo (mức max) | Muse Ember | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| Artificial Analysis Intelligence Index | 36 | 36 | 28 |
| AutomationBench-AA | 37,8 | 13,9 | 20,2 |
| Agents’ Last Exam | 61,6 | 57,0 | 57,1 |
| Terminal-Bench 4.0 (khung chạy tốt nhất của từng model) | 40,9 | 39,2 | 16,4 |
| Coding Agent Index-AA | 46 | 37 | 31 |
| FrontierCode 2.0-AA | 27,2 | 34,9 | 25,2 |
| GDP.pdf-AA | 22,8 | 20,8 | 22,8 |
| OSWorld 2.1 (điểm một phần) | 69,5 | 68,9 | 50,5 |
| PerceptionBench (có công cụ) | 80,6 | 78,6 | 62,8 |
Số liệu: Meta Research, kết quả Artificial Analysis và đánh giá nội bộ của Meta, công bố 9/11/2026.
Bảng cho thấy lợi thế rõ nhất của Ember nằm ở các việc kiểu tác nhân: AutomationBench-AA, Coding Agent Index-AA và OSWorld 2.1. Nó thua Haiku 5.5 ở FrontierCode 2.0-AA (27,2 so với 34,9), bài đo xem mã có đủ chất lượng để được chấp nhận hay không, và chỉ hòa Luna ở GDP.pdf-AA. Vài bài đo như Agents’ Last Exam, OSWorld 2.1 và PerceptionBench là đánh giá nội bộ của Meta, và Terminal-Bench 4.0 cho mỗi model chạy trong một khung điều phối khác nhau (mini-swe-agent cho Ember, OpenClaw cho Haiku, Codex cho Luna), nên chênh lệch 40,9 so với 16,4 giữa Ember và Luna phản ánh cả khung chạy chứ không chỉ model.
Meta cũng không giấu rằng Ember là tầng dưới: hãng nói muốn kết hợp với Muse Wonder cho bài khó, trong đó Wonder lập kế hoạch còn Ember lo khối lượng. Muse Spark 1.3 đạt 37 điểm trên cùng chỉ số, hơn Ember đúng 1 điểm, nhưng chi phí mỗi tác vụ là 2,39 USD và giá 1,25/4,25 USD. Nếu số liệu của Meta đúng, 1 điểm chênh lệch đó đắt gấp khoảng 17 lần.
OpenAI chưa trả lời bằng số liệu, và mô hình hai tầng đang thành khuôn mẫu
Ghép hai thông báo lại, câu chuyện OpenAI bị kẹp hai đầu đúng ở điểm số tự công bố: Astra thua Fable ở hầu hết bài đo, Luna thua Ember trên chỉ số tổng hợp. Nhưng cả hai bảng đều do đối thủ của OpenAI tự chọn bài đo và điều kiện, còn OpenAI chưa công bố số liệu nào để đối chiếu. Một bảng điểm do chính bên cạnh tranh dựng lên luôn có xu hướng chọn đúng những bài mà mình thắng, như AutomationBench của Fable hay FrontierCode của Ember cho thấy ngay trong hai bảng này.
Điều đáng theo dõi hơn là kiến trúc mà cả hai hãng cùng đẩy. Anthropic gọi Fable là Orchestrator giao việc cho model nhỏ, Meta gọi Ember là model cho tác vụ con lặp lại. Hai mô tả khớp nhau thành một mô hình hai tầng: một model đắt để lập kế hoạch và quyết định, nhiều model rẻ để làm khối lượng. Với cách tính phí theo token, người dùng không còn chọn một model tốt nhất cho cả quy trình mà chọn tỷ lệ giữa hai tầng. Nếu tầng dưới rẻ hơn tầng trên hàng chục lần, như Ember so với Fable 5.2 (0,10 USD so với 8 USD đầu vào, chênh 80 lần), phần lớn hóa đơn sẽ nằm ở số lần tầng trên phải can thiệp.
Với nhà phát triển và doanh nghiệp tại Việt Nam, cả hai đều là dịch vụ API đám mây tính bằng USD, đăng ký và thanh toán qua thẻ quốc tế, chưa có giá bán lẻ bằng đồng. Fable 5.2 có mặt trên Amazon Web Services, Google Cloud và Microsoft Azure với tên claude-fable-5-2 trên Claude Platform; Muse Ember có trên Meta Model API và Muse Code. Người dùng gói Pro của Claude được Anthropic tặng Fable 5.2 tới 50% hạn mức dùng hằng tuần, kèm 1 đến 3 lần reset tùy thời gian đăng ký. Cách thử hợp lý là chạy cùng một quy trình thật qua cả hai tầng và đo tiền trên mỗi tác vụ hoàn thành, thay vì tin điểm số từ bảng của hãng.
Nguồn tham khảo: Anthropic — Introducing Claude Fable 5.2 and Claude Mythos 5.2; Meta Research — Introducing Our Smallest, Most Efficient Model: Muse Ember; Wccftech