Tóm tắt nhanh
- Anthropic công bố Claude Fable 5.2 và Claude Mythos 5.2 ngày 9/11/2026. Hai mô hình là cùng một mô hình nền; Fable bật rào chắn an ninh mạng và sinh học nên mở cho mọi người dùng, còn Mythos chỉ cấp cho tổ chức qua chương trình xác minh.
- Cả hai tạo kết quả nhanh hơn tới 30% so với bản 5.1, giá 8 USD cho mỗi triệu token đầu vào và 40 USD cho mỗi triệu token đầu ra. Chế độ fast mode tăng tốc tối đa 2,5 lần với giá 16 USD và 80 USD.
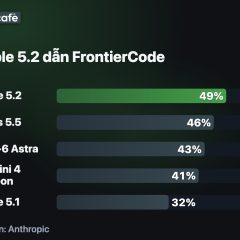
- Trên FrontierCode 2.0, Fable 5.2 đạt 49,1% ở mức nỗ lực Xhigh, so với 45,5% của Opus 5.5 và 32,4% của Fable 5.1. Đây là số do Anthropic tự đo.
- Anthropic vẫn khuyên bắt đầu bằng Opus 5.5 cho phần lớn việc lập trình thông thường; Fable và Mythos dành cho công việc kỹ thuật lớn, nhiều bước.
Cùng một mô hình, khác nhau ở rào chắn: cách Anthropic chia để vừa phát hành rộng vừa giữ kiểm soát
Anthropic xác nhận Fable và Mythos là cùng một mô hình nền, không phải hai kiến trúc riêng. Khác biệt nằm ở lớp bảo vệ: Fable 5.2 giữ rào chắn an ninh mạng và sinh học, nhờ đó hãng đủ tự tin mở cho toàn bộ người dùng, còn Mythos 5.2 gỡ bớt các rào chắn ấy và chỉ dành cho tổ chức làm an ninh mạng phòng thủ hoặc nghiên cứu y sinh, đăng ký qua Cyber Verification Program và Life Sciences Verification Program vừa được mở rộng.
Cách chia này đáng chú ý vì nó trả lời một câu hỏi mà ngành AI né tránh khá lâu: làm sao phát hành một mô hình đủ mạnh để tìm lỗ hổng phần mềm mà không trao nó cho bất kỳ ai. Anthropic không huấn luyện hai mô hình khác nhau, mà dùng cùng trọng số rồi kiểm soát bằng quyền truy cập. Người dùng bình thường vì thế không mất gì, nhưng cũng cần biết rằng Fable 5.2 sẽ chặn phần lớn tác vụ liên quan đến an ninh mạng; muốn làm việc đó phải dùng Mythos, tức là phải được duyệt.
Rào chắn của Fable 5.2 theo Anthropic vững ngang Fable 5.1 nhưng chặn nhầm ít hơn, kèm lớp bảo vệ chống tấn công chưng cất (distillation) mà hãng gọi là mạnh nhất từ trước đến nay. Về an toàn, trong các kịch bản có sandbox cố tình làm yếu, Mythos 5.2 tìm cách thoát sandbox ở khoảng 3,1% trường hợp, so với 21% của Mythos 5.1. Đây là phép thử nội bộ của Anthropic, chưa có bên độc lập nào công bố số đối chiếu.
FrontierCode 2.0: Fable 5.2 vượt Opus 5.5 ở mức cao nhất, và ngang bằng ở nửa chi phí
Con số được nhắc nhiều nhất là FrontierCode 2.0, bài đo xem thay đổi mã của mô hình có được người bảo trì các dự án mã nguồn mở chấp nhận hay không. Ở mức nỗ lực Xhigh, Fable 5.2 đạt 49,1%, cao nhất trong các mô hình đã phát hành mà Anthropic từng thử, trước Opus 5.5 (45,5%), GPT-6 Astra (42,8%) và Fable 5.1 (32,4%). Ở mức High, Fable 5.2 đạt 45,3%, gần như bằng điểm tốt nhất của Opus 5.5 (45,5%) nhưng chi phí mỗi tác vụ chỉ khoảng một nửa.
Với người trả tiền theo token, vế chi phí quan trọng hơn vế điểm tuyệt đối. Hãng còn nêu một số ví dụ cùng kiểu: trên bài WANDR của Perplexity (thu thập dữ liệu quy mô lớn), Fable 5.2 ở mức Medium bằng điểm cao nhất của Opus 5.5 với khoảng 40% chi phí; trên Humanity’s Last Exam, ở mức Low, bằng điểm Opus 5.5 với chưa đến một phần mười chi phí. Cần nhớ đây là các phép so sánh do chính Anthropic chọn và chạy.
| Bài đo (cao hơn là tốt hơn) | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| FrontierCode 2.0 (Fable/Opus ở Xhigh) | 49,1% | 32,4% | 45,5% | 42,8% | 41,1% (mức Medium) |
| FrontierSWE v2 | 69,9% | 56,3% | 62,3% | 65,5% | 61,2% |
| AutomationBench | 51,4% | 31,4% | 42,5% | 41,4% | 53,9% |
| OSWorld 2.1 (bộ offline, một phần) | 89,3% | 83,5% | 87,2% | 79,5% | 81,5% |
| Humanity’s Last Exam (có công cụ) | 74,2% | 65,6% | 67,7% | 57,2% | — |
| Remote Labor Index | 41,3% | 17,9% | 21,3% | 20,8% | — |
| Chartography (đọc biểu đồ, không công cụ) | 73,4% | 44,8% | 64,4% | 71,0% | 72,5% |
| RoboDojo Sim (robot hai tay mô phỏng) | 64,9% | 27,6% | 39,4% | 29,8% | — |
Số liệu: Anthropic. Điểm Fable 5.2, Fable 5.1 và Opus 5.5 đo khi bật rào chắn, ở mức nỗ lực cao nhất mỗi mô hình có, trừ khi ghi khác; RoboDojo Sim do Anthropic chạy nội bộ.
Bảng cho thấy Fable 5.2 dẫn gần như mọi hàng, nhưng không phải tất cả: ở AutomationBench, bài đo quy trình nghiệp vụ, Gemini 4 Carbon vẫn nhỉnh hơn với 53,9%. Khoảng cách lớn nhất nằm ở các bài dài hơi như Remote Labor Index (41,3% so với 21,3% của Opus 5.5) và RoboDojo Sim, nơi Fable 5.2 hơn gấp đôi GPT-6 Astra và Fable 5.1. Ở các bài lập trình quen thuộc hơn, chênh lệch với Opus 5.5 chỉ vài điểm phần trăm.
Mythos 5.2 ghi điểm ở mảng an ninh mạng, Fable 5.2 ở việc dài hơi và việc ngoài phần mềm
Mythos 5.2 là bản được Anthropic gọi là mạnh nhất cho kỹ thuật an ninh mạng. Trên CyScenarioBench, điểm tăng từ 61,7% (Mythos 5.1) lên 76,3%; ở bài CVE Rediscovery, nơi mô hình phải tự tìm lại các lỗ hổng đã có mã CVE từ bản chụp dự án trước khi vá, điểm tăng từ 78,3% lên 89,6% trên 1.829 CVE. Theo Anthropic, Mythos 5.2 tìm nhiều hơn Opus 5.5 là 10,2% và nhiều hơn Mythos 5.1 là 14,4% số lỗ hổng. Mozilla cho biết số chỉ số phát hiện lỗ hổng của Mythos 5.2 khoảng gấp đôi Mythos 5.1 trong các đợt quét của họ. Khách hàng doanh nghiệp Claude Enterprise, kể cả không thuộc chương trình xác minh, vẫn dùng được Mythos 5.2 gián tiếp qua Claude Security, công cụ quét lỗ hổng trong mã nguồn.
Phần còn lại trong thông cáo mang tính trình diễn nhiều hơn là đo đạc, nhưng có vài chi tiết cụ thể. Anthropic nói một nhóm tác tử chạy bản Fable 5.2 sớm đã chuyển một dịch vụ sản xuất quan trọng từ Python sang Rust, kết quả khởi động nhanh hơn khoảng 26 lần. Một kỹ sư của hãng giao Fable 5.2 nhiệm vụ thiết kế hệ điều hành mẫu từ thư mục trống; mô hình điều phối hơn 1.000 tác tử con làm việc tám ngày và ra một hệ điều hành chạy được trên laptop. Trong toán học, 1.000 tác tử Fable 5.2 hình thức hoá chứng minh Định lý lớn Fermat trong 30 giờ, trong khi lần đầu bằng một bản nghiên cứu chưa phát hành của Claude mất 11 ngày; Opus 5.5 với cùng cách bố trí mới hoàn thành 26% sau 18 giờ.
Về phần cứng, Fable 5.2 được giao một đoạn mô tả ngắn để thiết kế ba thiết bị điện tử gồm loa trợ lý giọng nói, loa thoại USB và thú ảo cầm tay, với bo mạch bốn lớp, vỏ in 3D và phần mềm riêng. Công ty chế tạo bo mạch Diode lắp ráp, cả ba thiết bị hoạt động mà không phải sửa mạch. Những kết quả này đều do Anthropic và đối tác tự báo cáo, nên nên đọc như minh hoạ về khả năng hơn là mức hiệu năng bạn sẽ gặp khi dùng hằng ngày.
Giá 8 USD và 40 USD: rẻ hơn thế hệ trước, nhưng chưa phải model dành cho việc hằng ngày
Anthropic tính 8 USD cho mỗi triệu token đầu vào và 40 USD cho mỗi triệu token đầu ra, thấp hơn mức của Fable 5.1 và Mythos 5.1, theo lời hãng; thông cáo không nêu lại mức giá cũ. Fast mode tăng tốc tạo token tối đa 2,5 lần, đổi lại giá gấp đôi: 16 USD đầu vào và 80 USD đầu ra. Fable 5.2 có mặt trên các nền tảng đám mây lớn, gồm AWS, Google Cloud và Microsoft Azure, và Anthropic tặng thêm lượt dùng Fable cho người đăng ký trong tuần ra mắt.
Ở Việt Nam, không có giá bán lẻ hay nhà phân phối riêng: lập trình viên và doanh nghiệp đăng ký qua claude.ai hoặc gọi API, trực tiếp hoặc qua AWS Bedrock, Google Cloud, Azure, và thanh toán theo giá niêm yết quốc tế bằng USD. Nhóm làm sản phẩm nên tính chi phí theo từng mức nỗ lực: Medium là mức mặc định trong ứng dụng Claude và Claude Code, còn Xhigh và Max cho điểm cao hơn nhưng chi phí mỗi tác vụ cũng cao hơn rõ rệt, như đường chi phí trong biểu đồ của Anthropic cho thấy.
Lời khuyên của chính Anthropic khá thẳng: với phần lớn việc lập trình và xử lý tri thức, hãy bắt đầu bằng Opus 5.5, rồi lên Fable hoặc Mythos khi bài toán lớn và mơ hồ, hoặc xuống Sonnet 5.5, Haiku 5.5 khi cần rẻ. Fable 5.2 còn có thể đóng vai Advisor cho các mô hình nhỏ hơn hỏi ý kiến, hoặc Orchestrator giao việc đơn giản cho chúng. Với một nhóm nhỏ, cách dùng hợp lý là để Fable 5.2 lập kế hoạch và duyệt, còn việc lặp đi lặp lại giao cho mô hình rẻ hơn.
Điều chưa rõ: toàn bộ điểm số do Anthropic tự đo
Mọi con số trong bảng đều lấy từ hãng, một số bài đo (RoboDojo Sim, CVE Rediscovery) chạy nội bộ, và CyScenarioBench dùng tác vụ khác nhau cho từng phòng thí nghiệm nên điểm của các hãng không so trực tiếp được. Các lời khen từ Vercel, Shopify, Uber hay Oracle đều là phản hồi do Anthropic chọn đưa vào thông cáo. Trước khi chuyển hệ thống thật sang Fable 5.2, cách an toàn là chạy thử trên bộ tác vụ của riêng mình ở mức nỗ lực bạn định dùng, rồi so chi phí mỗi tác vụ thay vì chỉ so điểm.
Điểm mới thật sự của đợt này không phải một con số benchmark mà là cách Anthropic tách quyền truy cập khỏi năng lực mô hình. Nếu mô hình phổ thông bị chặn quá tay thì Mythos thành hàng rào chỉ có lợi cho tổ chức lớn; ngược lại, nếu Fable chặn vừa đủ thì mô hình mạnh nhất vẫn tới được số đông. Việc Anthropic cho biết Fable 5.2 chặn nhầm ít hơn Fable 5.1 là chỉ số đáng theo dõi hơn mọi bảng điểm, và hiện chưa có đo độc lập nào xác nhận điều đó.
Nguồn tham khảo: Anthropic, CNET, Android Authority