Tóm tắt nhanh
- NVIDIA cập nhật thông số Vera Rubin: mỗi Rubin GPU vẫn có 288 GB HBM4, nhưng băng thông HBM4 hiện ghi 19,2 TB/s và NVLink 6 là 3 TB/s.
- Ở cấu hình NVL72, tổng băng thông HBM4 là 1.400 TB/s; đây là số liệu cấp rack, không phải của một GPU.
- Hãng nói số công bố ban đầu là mục tiêu kiến trúc sơ bộ, còn các benchmark agentic AI bên thứ ba đã dùng thông số sản xuất. Phát biểu về benchmark này hiện chưa được kiểm chứng độc lập đầy đủ.
NVIDIA đã thay các mục tiêu băng thông HBM4 và NVLink từng công bố cho Vera Rubin bằng thông số thấp hơn trên trang sản phẩm. Mỗi Rubin GPU vẫn có 288 GB HBM4, nhưng băng thông bộ nhớ hiện là 19,2 TB/s thay vì 22 TB/s; NVLink 6 giảm từ 3,6 TB/s xuống 3 TB/s. Đại diện NVIDIA giải thích rằng con số cũ là mục tiêu kiến trúc sơ bộ, còn thông số hiện hành phản ánh điều hệ thống duy trì được khi sản xuất hàng loạt đạt chuẩn.
Thông số sửa đổi áp dụng khác nhau theo từng cấp hệ thống
| Cấu hình | HBM4 | Băng thông HBM4 | NVLink | Băng thông mạng |
|---|---|---|---|---|
| Rubin GPU | 288 GB | 19,2 TB/s | 3 TB/s | 0,45 TB/s |
| Vera Rubin Superchip | 576 GB | 38,5 TB/s | 6 TB/s | 0,9 TB/s |
| Vera Rubin NVL72 | 20,7 TB | 1.400 TB/s | 216 TB/s | 32,4 TB/s |
Số liệu: NVIDIA.
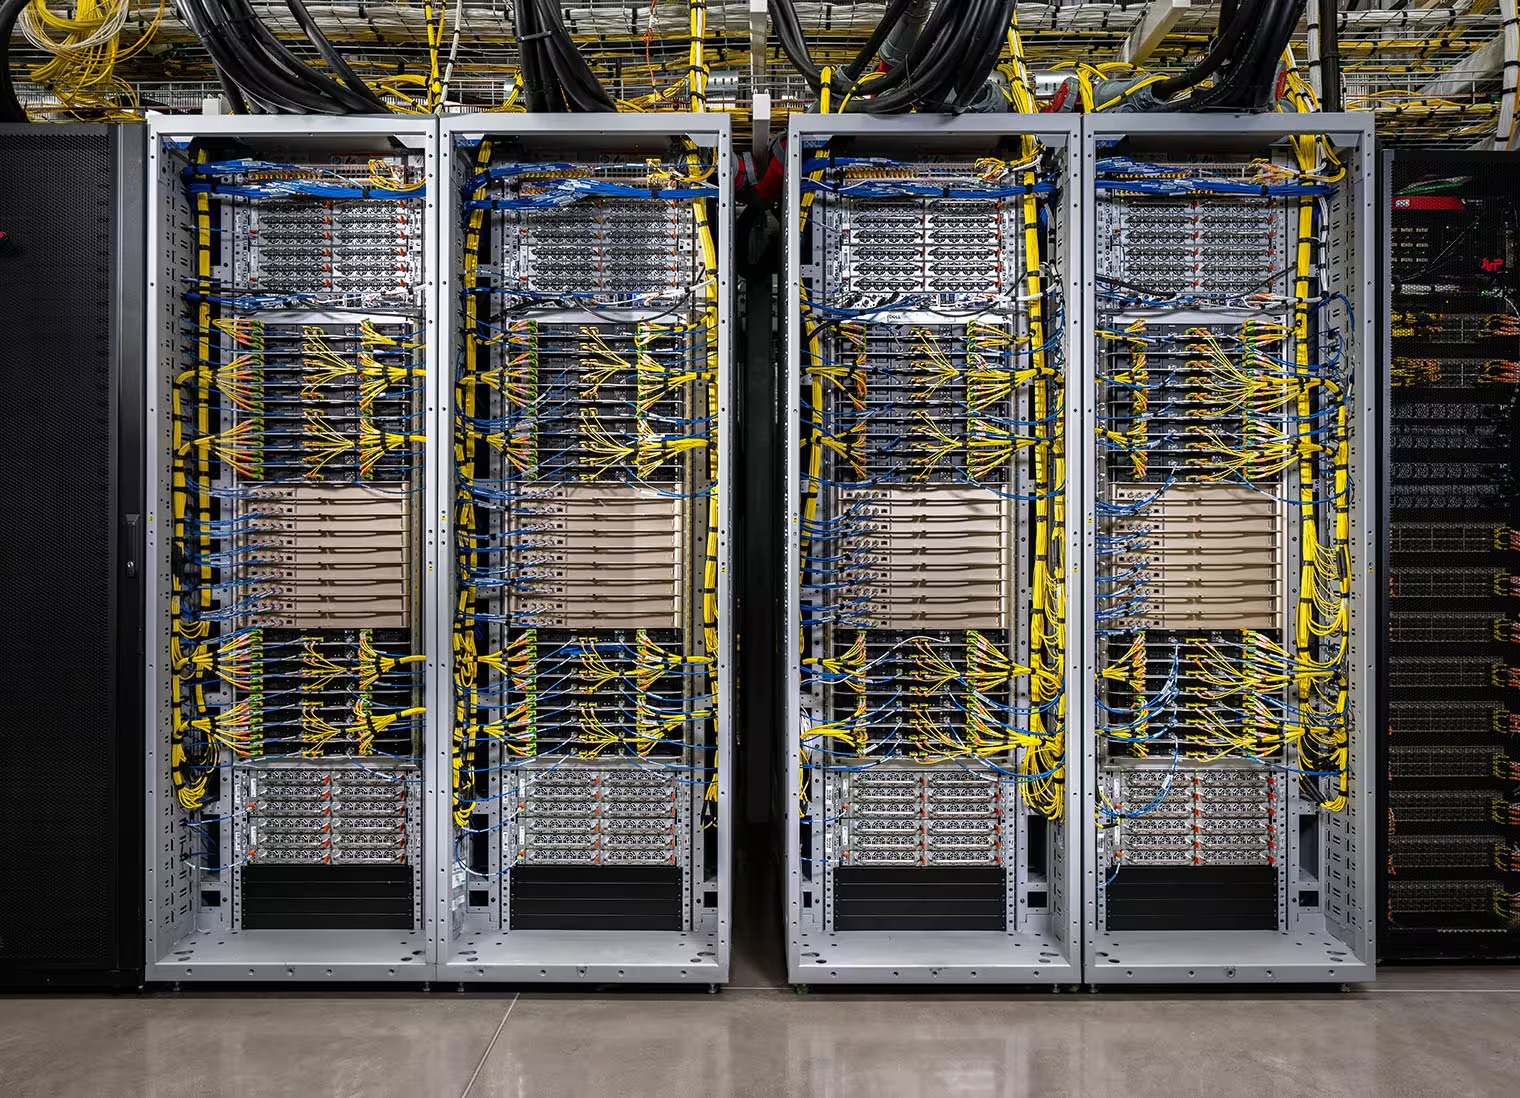
Không nên gom mọi mức giảm thành một con số chung cho cả nền tảng. Trang thông số hiện tại của NVIDIA ghi một GPU Rubin có 288 GB HBM4, băng thông 19,2 TB/s và NVLink 3 TB/s. Vera Rubin Superchip gồm hai GPU có tổng băng thông HBM4 38,5 TB/s và NVLink 6 TB/s. Còn NVL72 là hệ thống rack gồm 72 GPU Rubin, với 20,7 TB HBM4, băng thông HBM4 tổng cộng 1.400 TB/s và NVLink 216 TB/s.
Ở cấp NVL72, NVIDIA đồng thời ghi băng thông mạng 32,4 TB/s, cao hơn mức 28,8 TB/s trong thông số trước đó. Vì vậy, mô tả chính xác hơn là một số thông số bộ nhớ và kết nối giảm, trong khi băng thông mạng tăng; không phải toàn bộ hệ thống đều bị hạ thông số theo cùng một hướng.
TrendForce tường thuật mức giảm băng thông HBM4 mỗi GPU từ 22 xuống 19,2 TB/s, tương đương khoảng 12,7%, và NVLink từ 3,6 xuống 3 TB/s, khoảng 16,7%. Đây là thay đổi ở thông số thành phần. Chưa có phép đo đối chiếu cùng điều kiện chứng minh hiệu năng ứng dụng cũng giảm đúng các tỷ lệ đó.
Băng thông linh kiện không đủ để dự đoán tốc độ workload
Với hệ thống AI quy mô rack, hiệu năng phụ thuộc cách GPU, bộ nhớ, kết nối, mạng, phần mềm và mô hình phối hợp trong một workload cụ thể. Băng thông HBM hay NVLink thấp hơn có thể làm thay đổi một phần giới hạn của hệ thống, nhưng chỉ nhìn hai con số đó không cho biết thông lượng token, độ trễ hoặc chi phí vận hành sẽ đổi ra sao. NVIDIA cũng lập luận rằng thông số của từng linh kiện không tự quyết định hiệu năng ứng dụng.
Điều đó không có nghĩa thay đổi thông số có thể bỏ qua. Người mua hạ tầng cần benchmark trên cấu hình và phần mềm gần với triển khai thực tế, đồng thời xem rõ model, độ dài ngữ cảnh, cách tính token và giới hạn công suất. So sánh một con số băng thông riêng lẻ với kết quả của một workload khác dễ tạo ra kết luận quá mức.
Tuyên bố benchmark sản xuất và kết quả độc lập là hai việc khác nhau
NVIDIA nói các benchmark agentic AI bên thứ ba đã công bố trong nhiều tháng được đo bằng thông số sản xuất hiện nay. Hãng cũng dẫn kết quả AgentX đạt tối đa 30 lần throughput trên mỗi megawatt so với GB300 NVL72, trên model DeepSeek V4 Pro; theo điều kiện NVIDIA công bố, phép đo dùng các quỹ đạo coding agent được ghi lại, là kết quả ban đầu và chưa tính phần xử lý gọi công cụ của Vera CPU. Hãng lưu ý hiệu năng còn có thể thay đổi khi phần mềm được tối ưu.
Mức tối đa 30 lần là tuyên bố do NVIDIA đưa ra dựa trên dữ liệu AgentX, không phải xác nhận độc lập rằng mọi benchmark bên thứ ba trước đây đều chạy đúng cấu hình sản xuất cuối. Bài công khai của SemiAnalysis về AgentX ngày 14/9 mô tả kết quả Rubin tiền phát hành đạt tối đa khoảng 7 lần throughput token trên mỗi megawatt so với Blackwell; nội dung đó không xác nhận trực tiếp cấu hình sản xuất cuối hoặc toàn bộ phát biểu mới của NVIDIA. Hai kết quả gắn với điều kiện và thời điểm khác nhau, nên không thể đặt cạnh nhau như phép đo lặp lại cùng một cấu hình.
Vera Rubin cần được đánh giá bằng cấu hình triển khai, không phải một con số
Với khách hàng đang cân nhắc một hệ thống rack AI, thông số mới giúp xác định cấu hình NVIDIA hiện đưa ra, còn tuyên bố về hiệu quả cần được đọc cùng model, workload và cách đo. Các bảng hiệu năng của hãng cũng ghi một số kết quả là dự kiến hoặc có thể thay đổi. Chưa có cơ sở từ những dữ kiện hiện có để kết luận việc hạ băng thông làm giảm tương ứng tốc độ ứng dụng, cũng chưa đủ căn cứ để coi mọi benchmark đã công bố là xác nhận độc lập cho hiệu năng sản xuất.
Trang NVIDIA hiện ghi Vera Rubin NVL72 ở trạng thái sẵn có và hướng khách hàng liên hệ bộ phận bán hàng; không công bố giá niêm yết. Vì đây là hạ tầng rack-scale dành cho doanh nghiệp, người mua tại Việt Nam cần lấy báo giá và cấu hình triển khai trực tiếp từ kênh bán hàng thay vì suy ra mức đầu tư từ giá GPU đơn lẻ.
Nguồn tham khảo: NVIDIA Vera Rubin NVL72; Wccftech; TrendForce; NVIDIA Blog; SemiAnalysis