Tóm tắt nhanh
- NVIDIA Vera Rubin NVL72 đã vận hành trong trung tâm dữ liệu Azure; quyền truy cập máy ảo liên quan được mở rộng tại Microsoft Ignite.
- Nemotron 3.5 có thêm lựa chọn triển khai qua Microsoft Foundry và Foundry Local, còn Azure Local sẽ hỗ trợ RTX PRO 6000 Blackwell cùng các nền tảng Jetson.
- RTX Spark trình diễn chạy mô hình ngôn ngữ lớn tại chỗ trên Windows; Direct Stream cho Windows 365 Cloud PC đang ở limited preview.
- Các con số hiệu quả do NVIDIA công bố là kết quả theo từng bài toán và điều kiện cụ thể, chưa thể xem như mức cải thiện chung cho mọi doanh nghiệp.
NVIDIA và Microsoft đang nối các điểm triển khai AI từ trung tâm dữ liệu Azure xuống hạ tầng tại chỗ và máy tính Windows. Điểm đáng chú ý không nằm ở một sản phẩm đơn lẻ, mà ở việc doanh nghiệp có thể chọn nơi chạy mô hình theo dữ liệu, tải công việc và yêu cầu kiểm soát của mình.
Tuy vậy, thông báo tại Microsoft Ignite chưa mô tả một hệ thống duy nhất có thể chuyển nguyên một ứng dụng AI giữa cloud, máy chủ tại doanh nghiệp và PC. Các phần được công bố gồm máy ảo Azure dùng Vera Rubin, dịch vụ mô hình trong Foundry, hỗ trợ GPU cho Azure Local và trải nghiệm AI cục bộ trên RTX Spark. Chúng tạo thành nhiều lựa chọn, nhưng vẫn là những tầng sản phẩm khác nhau.
Vera Rubin trên Azure nhắm tới tải AI lớn, không phải máy ảo phổ thông
NVIDIA cho biết hệ thống Vera Rubin NVL72 đang chạy trong các trung tâm dữ liệu Azure, hướng đến tác vụ suy luận, ứng dụng agent và huấn luyện mô hình lớn. Microsoft và NVIDIA cũng đang mở rộng confidential computing tới hạ tầng bare-metal và quy mô rack, để bảo vệ mô hình cùng dữ liệu khi chúng được xử lý. Đây là hướng đi đáng quan tâm với tổ chức làm việc trên dữ liệu nhạy cảm, nhưng thông cáo chưa nêu giá thuê, cấu hình máy ảo cụ thể hay thời điểm cung cấp đại trà.
Hai hãng còn nhắc tới MaxLPS như một phần trong nỗ lực khai thác hiệu quả nguồn điện sẵn có của trung tâm dữ liệu. Điều này phản ánh một giới hạn thực tế của AI quy mô lớn: thêm GPU không tự động giải quyết được bài toán công suất điện và vận hành. Tuy nhiên, NVIDIA chưa đưa ra con số tiết kiệm điện hay mức tăng hiệu năng để người dùng có thể so sánh độc lập.
Trong MLPerf Training v6.1, NVIDIA cho biết Azure chạy DeepSeek-V3 trên cụm 10.240 GPU với hệ thống GB200 NVL72, quy mô lớn nhất của vòng thi đó. Ở MLPerf Inference v6.1, hệ thống GB300 NVL72 của Azure dẫn đầu các bài nộp cloud về thông lượng tương tác DeepSeek-R1 hơn 10% theo phép đo của Signal65. Đây là kết quả trên cấu hình và bài thử xác định, không phải cam kết rằng mọi ứng dụng của khách hàng sẽ nhanh hơn tương ứng.
Nemotron mở thêm lựa chọn tùy biến, còn số liệu EY cần đọc đúng phạm vi
Microsoft Foundry mở rộng hỗ trợ các mô hình Nemotron 3.5 và quy trình tùy biến, triển khai trọng số mô hình riêng. Cách ghép này có ý nghĩa với doanh nghiệp muốn điều chỉnh mô hình mở theo tài liệu nội bộ hoặc quy trình cụ thể, thay vì chỉ gọi một mô hình đóng dùng chung. Foundry Managed Compute giúp nối phần tùy biến với triển khai qua dịch vụ quản lý của Microsoft; Foundry Local đưa một số khả năng reasoning, viết mã và dùng công cụ tới môi trường Azure Local.
NVIDIA nêu trường hợp EY dùng Programmed Training trong Microsoft Foundry để tùy biến Nemotron cho việc phân loại hồ sơ mua sắm doanh nghiệp. Theo kết quả do NVIDIA công bố, độ chính xác trên tập đánh giá của EY tăng 55%, trong khi chi phí thấp hơn 15 lần so với các mô hình frontier độc quyền. Phạm vi ở đây là một tác vụ và bộ đánh giá của EY; thông báo không công bố cách tính chi phí hay kết quả trên nhóm tác vụ khác. Vì vậy, đây là dấu hiệu cho thấy mô hình mở tùy biến có thể phù hợp với một quy trình hẹp, chưa phải bằng chứng rằng doanh nghiệp sẽ luôn đạt hiệu quả tương tự.
Đáng chú ý, Nemotron không chỉ có một lựa chọn duy nhất: Super hướng tới agent chạy công việc kéo dài, Lightning ưu tiên phản hồi nhanh và dùng công cụ; các thành phần Embed, Rerank, Parse và Content Safety xử lý những khâu riêng như truy xuất, trích xuất dữ liệu hay lọc nội dung. Sự phân tách này có thể giúp chọn đúng thành phần, nhưng cũng đặt thêm yêu cầu tích hợp và đánh giá cho đội kỹ thuật triển khai.
Azure Local và RTX Spark đặt AI gần dữ liệu hơn, nhưng khác cách vận hành
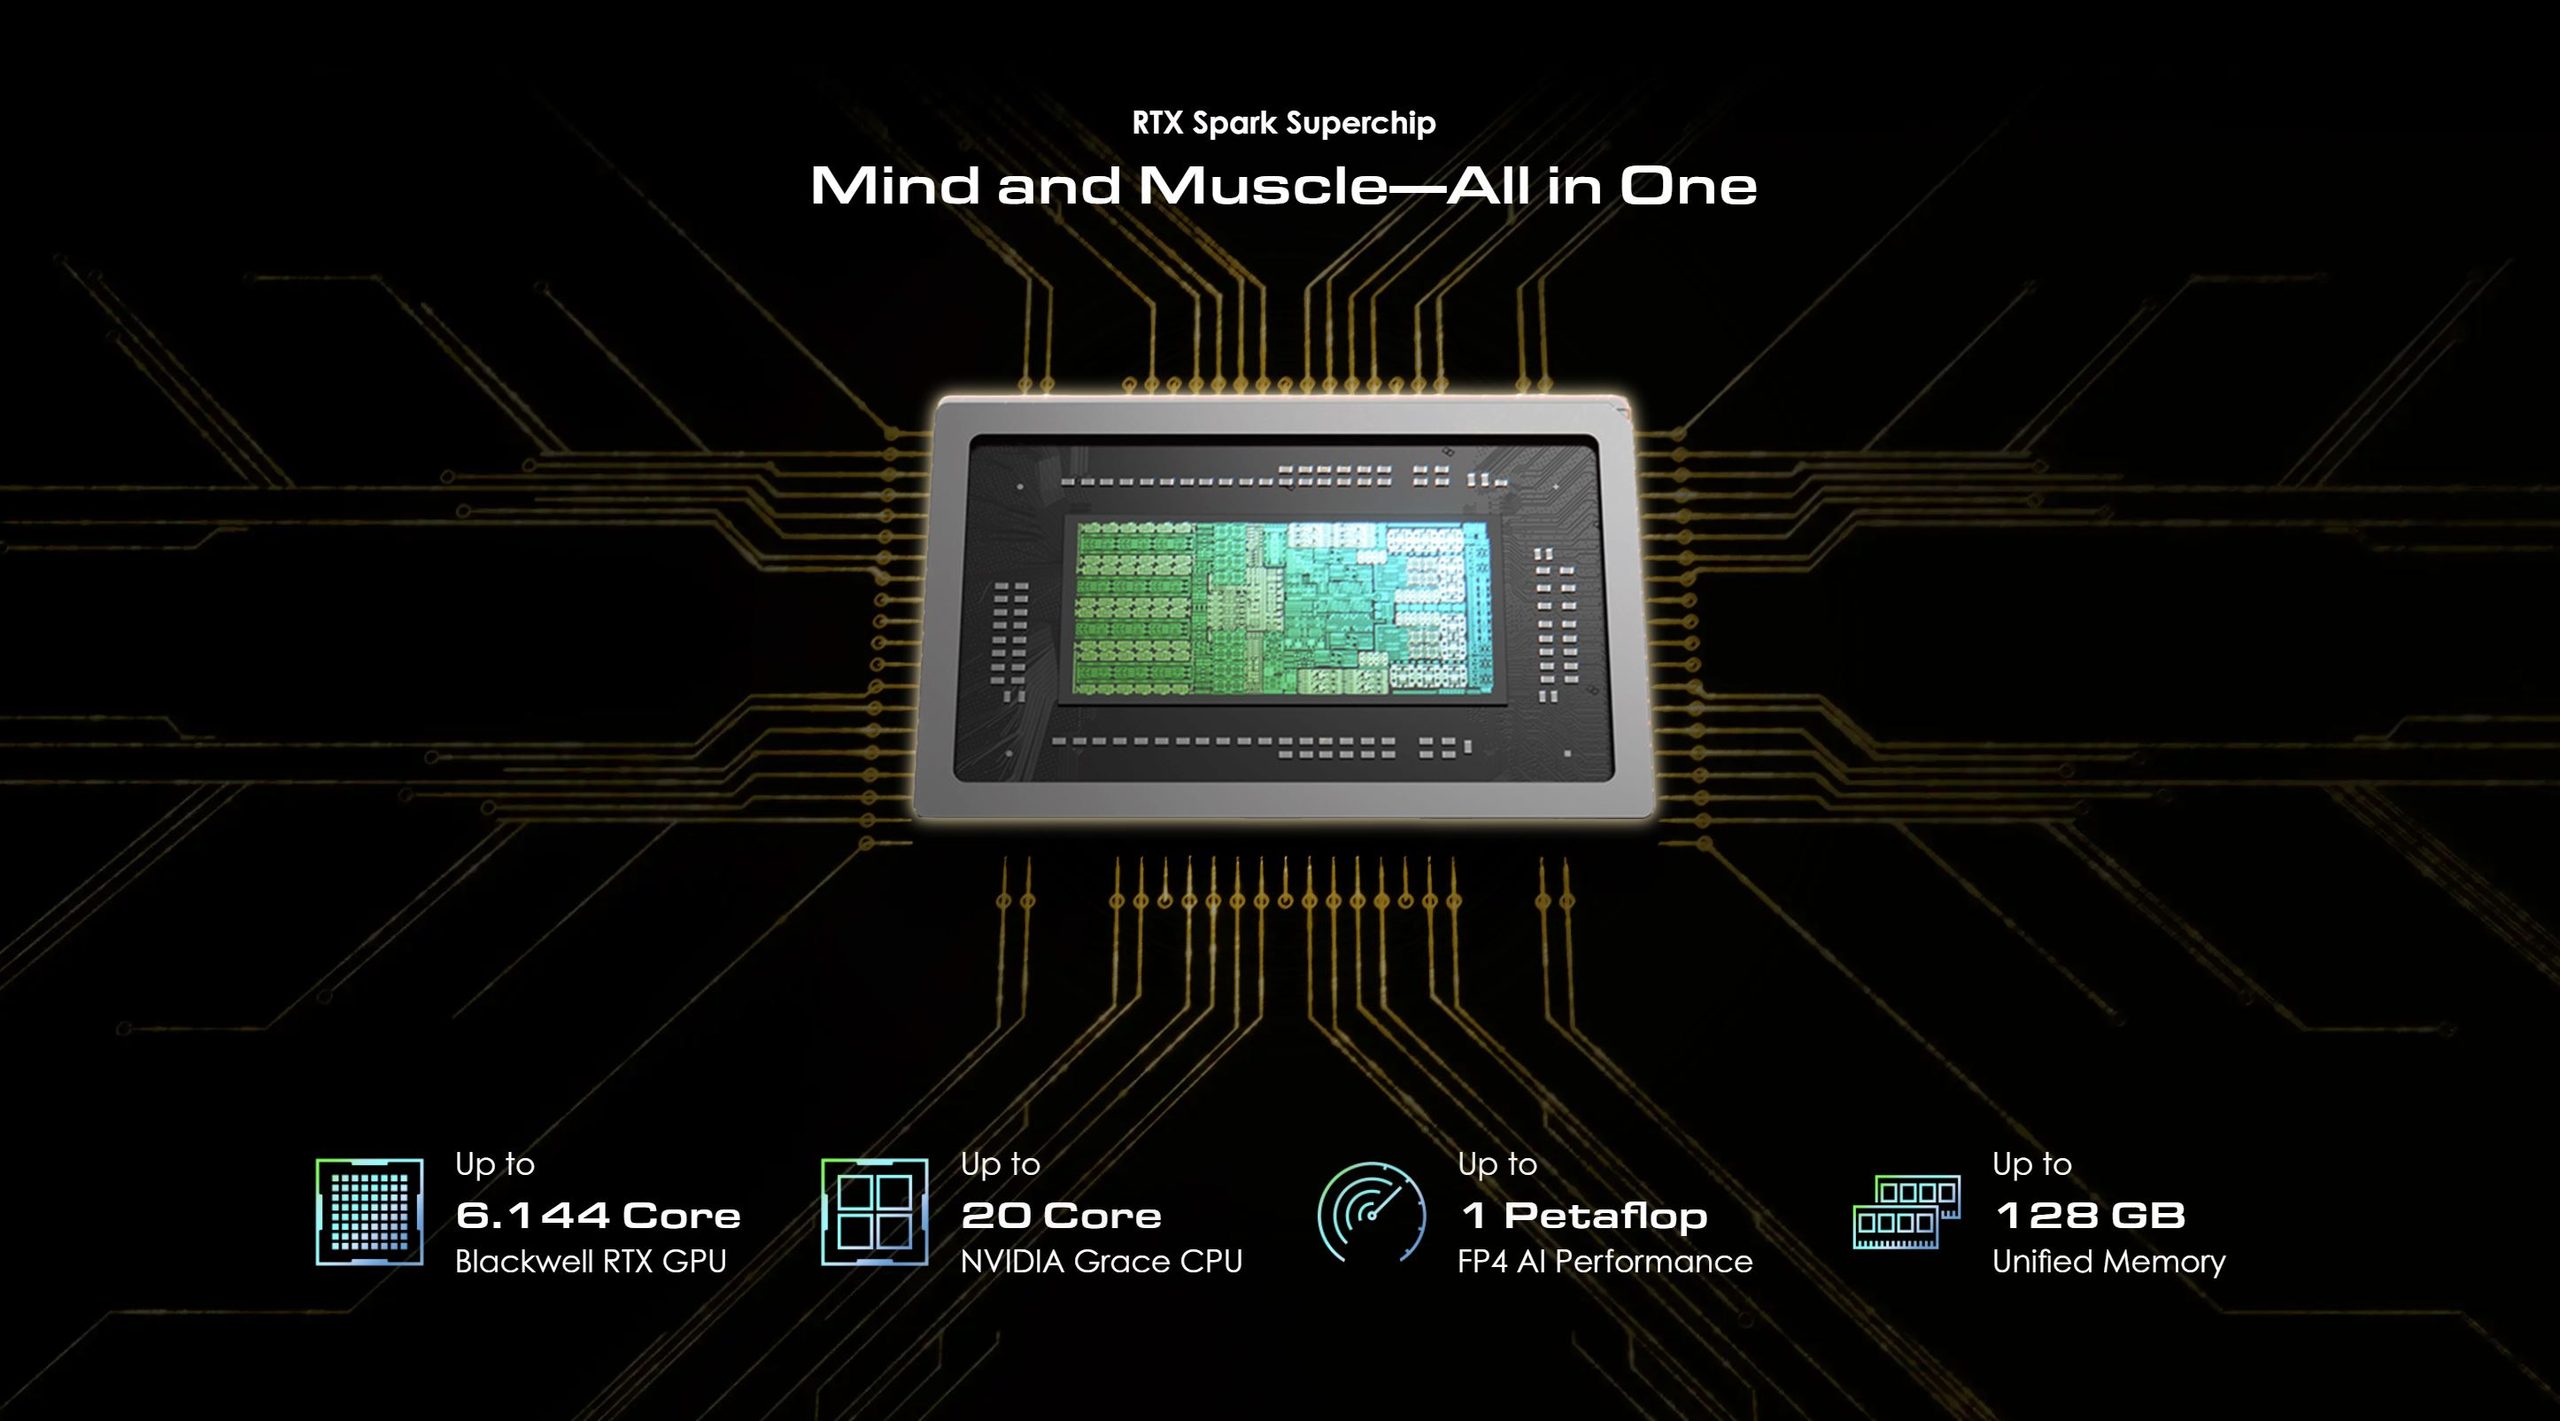
Ở lớp tại chỗ, Azure Local sẽ hỗ trợ GPU NVIDIA RTX PRO 6000 Blackwell từ các đối tác phần cứng, đồng thời mở rộng tới nền tảng Jetson Thor và Jetson Orin cho máy thị giác, robot và vận hành tự động. Với doanh nghiệp không muốn đưa dữ liệu ra cloud hoặc cần xử lý gần thiết bị, lựa chọn này có thể hữu ích. Đổi lại, họ vẫn phải tính tới chi phí máy chủ, điện, làm mát và nhân lực quản trị; thông cáo chưa đưa ra cấu hình tham chiếu hay tổng chi phí sở hữu.
RTX Spark được NVIDIA và Microsoft dùng để trình diễn trải nghiệm chạy mô hình ngôn ngữ lớn trực tiếp trên PC Windows. Điều đó khác với Azure Local: một bên là thiết bị cá nhân có năng lực tính toán tại chỗ, bên kia là hạ tầng doanh nghiệp. Không nên suy ra rằng cùng một mô hình, dung lượng hay tốc độ sẽ hoạt động giống nhau trên cả hai môi trường; bài công bố cũng chưa nêu giới hạn kích thước mô hình hoặc yêu cầu bộ nhớ cho demo trên Spark.
Với Windows 365 Cloud PC, Direct Stream hướng tới các ứng dụng đồ họa nặng được tăng tốc bằng GPU. NVIDIA cho biết tính năng hỗ trợ tối đa hai luồng 4K ở 60 khung hình/giây với độ trễ thấp ngay cả trên mạng khó, hiện có limited preview cho đăng ký và dự kiến public preview vào đầu năm 2027. Đây là truyền phát từ Cloud PC, không phải xử lý AI cục bộ trên máy Windows của người dùng.
Giá trị của hợp tác nằm ở quyền chọn nơi chạy, còn độ mở vẫn cần kiểm chứng
Những công bố tại Ignite tạo ra một bản đồ triển khai rộng hơn: Azure cho tải lớn, Foundry cho tùy biến và quản lý mô hình, Azure Local cùng Jetson cho môi trường doanh nghiệp hoặc công nghiệp, RTX Spark cho thử nghiệm tại PC. Doanh nghiệp có thêm cách đặt tính toán gần dữ liệu hoặc dùng hạ tầng cloud, nhưng vẫn cần kiểm tra khả năng tương thích mô hình, bảo mật, chi phí và công cụ quản lý ở từng tầng.
Điểm còn bỏ ngỏ là mức độ liền mạch giữa các tầng đó. Thông báo xác nhận nhiều lựa chọn đang được mở rộng, chứ chưa cho thấy ứng dụng có thể chuyển đổi tự do giữa Azure, máy chủ tại chỗ và Windows mà không phải điều chỉnh. Với đội triển khai, đó mới là phép thử quan trọng: không phải có bao nhiêu sản phẩm trong danh sách, mà là mỗi lựa chọn có giảm được công việc tích hợp và tổng chi phí cho đúng nhu cầu hay không.
Nguồn tham khảo: NVIDIA Blog · Wccftech