Tóm tắt nhanh
- Qualcomm cho biết đã xác thực ban đầu silicon HBC trong phòng thí nghiệm tại San Diego, hướng đến bộ tăng tốc suy luận Dragonfly AI250.
- Hãng công bố băng thông hiệu dụng cao hơn 18 lần LPDDR5X bên ngoài và băng thông trên mỗi watt cao hơn 5 lần thông số HBM4; đây chưa phải kết quả đo độc lập trên AI250.
- Mẫu xác thực dùng hai lớp DRAM, còn sản phẩm dự kiến dùng bốn lớp; AI250 được lên kế hoạch lấy mẫu trong nửa đầu năm 2027, chưa có ngày mở bán cụ thể.
Qualcomm đã đưa High Bandwidth Compute (HBC) qua bước xác thực silicon ban đầu, thay vì chỉ trình bày một thiết kế bộ nhớ trên giấy. Điểm đáng chú ý nằm ở cách hãng chuyển một phần phép tính đến sát dữ liệu, nhưng khoảng cách từ mẫu hoạt động trong phòng thí nghiệm đến một hệ thống suy luận có chi phí vận hành thấp hơn vẫn còn đáng kể.
Với mô hình ngôn ngữ lớn, khối tính toán cần được cấp dữ liệu để tạo ra các token đầu ra. Nếu đường truyền bộ nhớ trở thành giới hạn, bổ sung năng lực tính toán chưa chắc giúp hệ thống trả lời nhanh tương ứng. HBC nhắm vào phần việc này: giảm lượng dữ liệu phải đi xa trước khi được xử lý, qua đó tìm thêm dư địa về điện năng và băng thông.
Đặt phép tính dưới DRAM có thể giảm gánh nặng kết nối
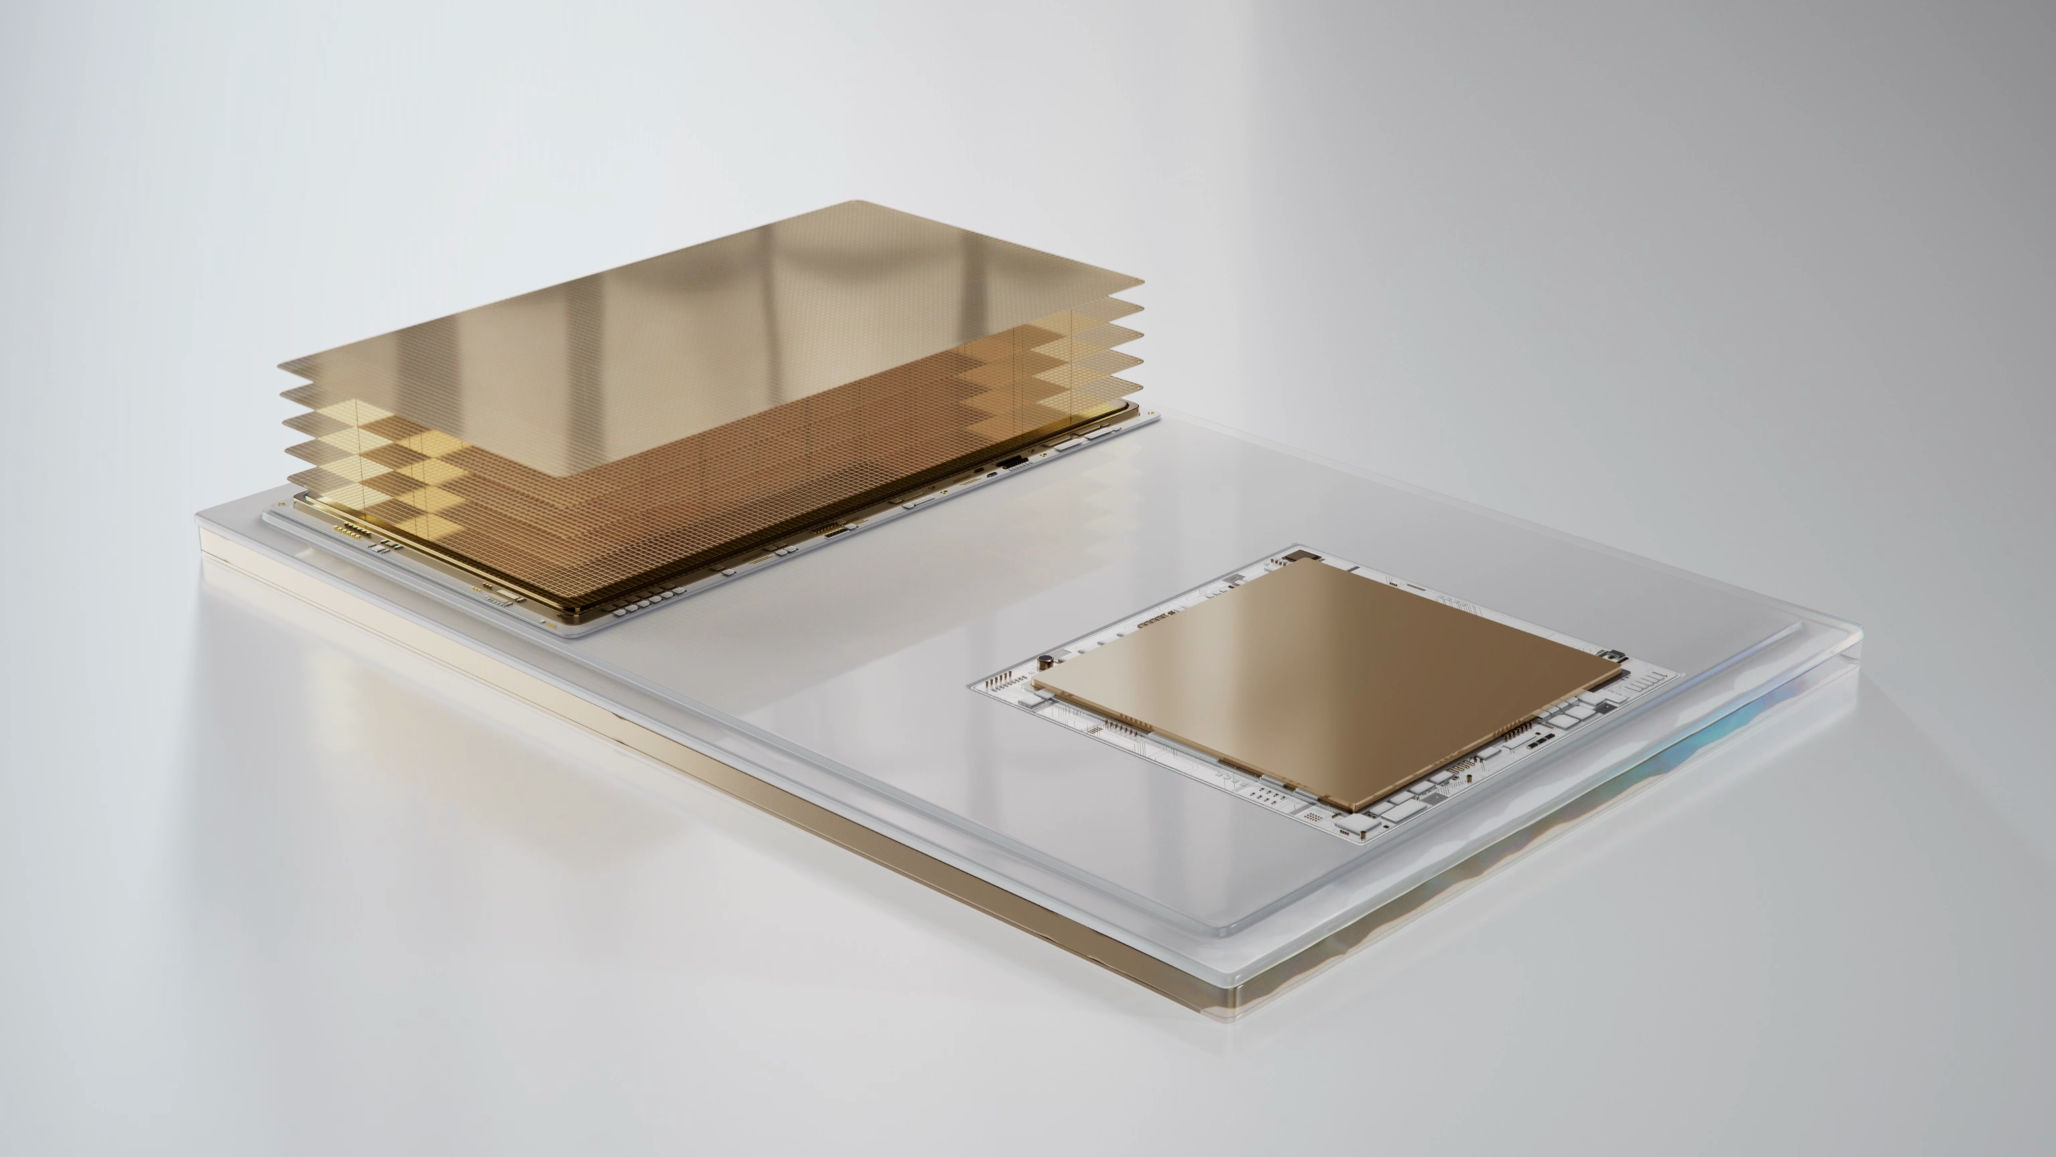
HBC đáng chú ý ở chỗ thay đổi nơi thực hiện phép tính, chứ không đơn thuần thay bộ nhớ cũ bằng loại có tốc độ cao hơn. Qualcomm thiết kế HBC bằng cách xếp các lớp DRAM LPDDR5X lên một đế có khả năng tính toán. Đế này không phải bộ xử lý hoàn chỉnh: nó đảm nhận những phép toán cần nhiều băng thông, rồi chuyển kết quả về khối xử lý lớn hơn.
Ở cách bố trí HBM được dùng để đối chiếu, các lớp DRAM kết nối với bộ xử lý chủ qua một đường truyền rất rộng. HBC đưa phần xử lý cần dữ liệu đến ngay dưới bộ nhớ, nên có cơ hội giảm việc liên tục vận chuyển dữ liệu thô giữa các khối. Lợi ích cần kiểm chứng vì thế gồm cả điện tiêu thụ cho truyền dữ liệu, không chỉ tốc độ đọc bộ nhớ.
Điều này cũng tạo ra một hướng giảm chi phí đóng gói. Khi một phần phép tính được xử lý tại chỗ, kết nối từ cụm bộ nhớ đến bộ xử lý lớn có thể không cần mang lượng dữ liệu như trước. Về nguyên lý, yêu cầu kết nối bớt khắt khe sẽ cho phép cân nhắc phương án đóng gói đơn giản hơn. Nhưng đây mới là lập luận thiết kế, chưa phải bằng chứng rằng sản phẩm HBC đã rẻ hơn một hệ thống HBM tương đương.
Độ phức tạp không biến mất mà chuyển sang phần xếp chồng. Các lớp DRAM vẫn cần được liên kết với nhau và với đế tính toán; chất lượng liên kết và tỷ lệ thành phẩm vẫn ảnh hưởng đến khả năng sản xuất. Đế chủ động nằm dưới bộ nhớ còn tạo thêm bài toán nhiệt: giảm điện cho truyền dữ liệu không tự động có nghĩa toàn bộ cụm sẽ dễ làm mát hơn.
Qualcomm cho biết việc xác thực có xét đến hành vi nhiệt, nhưng chưa công bố chi tiết kết quả. Vì vậy, chưa có cơ sở kết luận hãng đã giải quyết xong vấn đề tản nhiệt của cấu hình thương mại. Việc công nghệ vận hành được và việc nó duy trì hiệu năng ổn định trong một máy chủ là hai yêu cầu khác nhau.
Con số 18 lần chưa trả lời AI250 chạy nhanh đến đâu
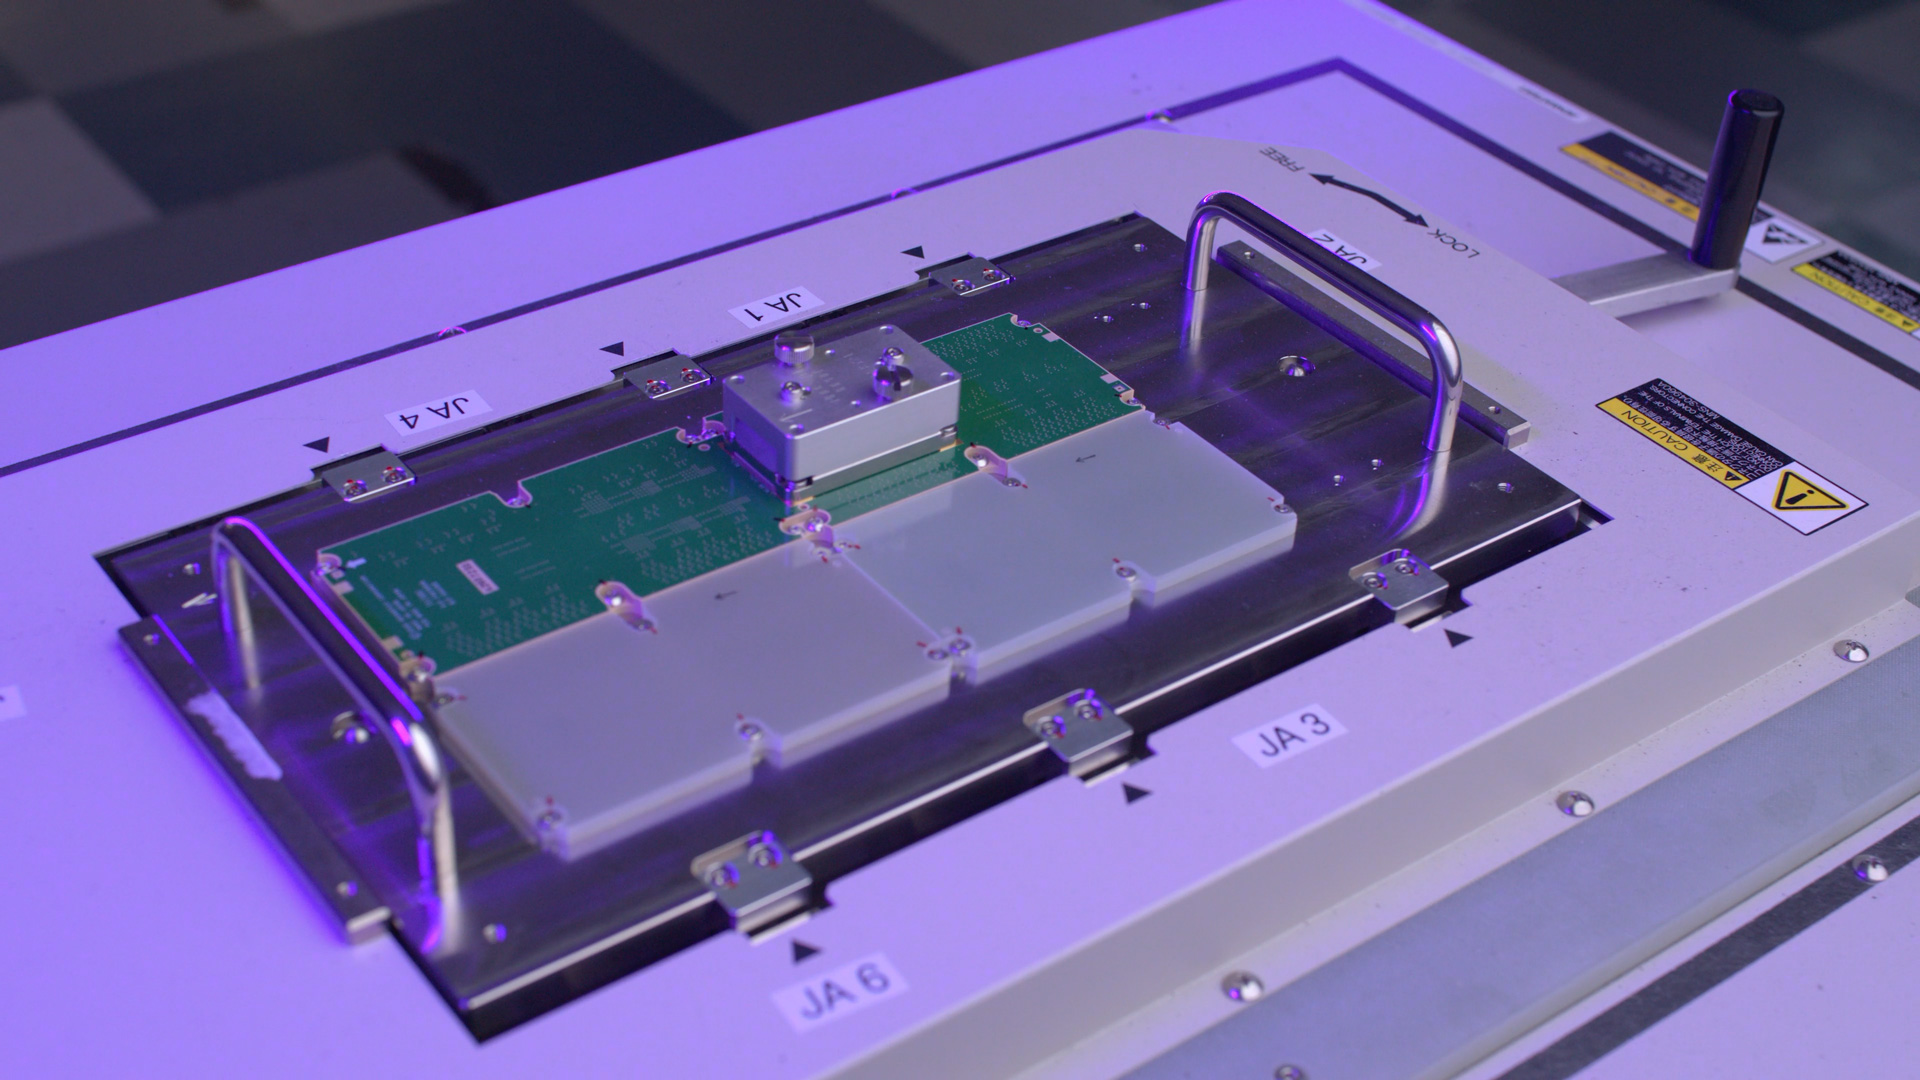
Băng thông hiệu dụng cao hơn là tín hiệu tích cực cho thiết kế bộ nhớ, nhưng không thể dùng trực tiếp làm hệ số tăng tốc mô hình AI. Theo kết quả Qualcomm công bố được ServeTheHome ghi nhận, HBC đạt băng thông hiệu dụng cao hơn 18 lần bộ nhớ LPDDR5X bên ngoài; hãng chưa đưa ra con số băng thông tuyệt đối trong phần xác thực này. Đây là so sánh của nhà sản xuất trên silicon sớm, không phải benchmark suy luận độc lập.
Chỉ số còn lại là băng thông trên mỗi watt, được Qualcomm công bố cao hơn 5 lần so với thông số HBM4, chứ không phải phép đo đối đầu hai hệ thống thương mại chạy cùng mô hình. Mục tiêu ban đầu của hãng là 6 lần. Kết quả công bố thấp hơn mục tiêu đó, còn ý nghĩa thực tế phụ thuộc vào việc lợi thế có được giữ lại khi tích hợp thành sản phẩm hoàn chỉnh hay không.
Điều kiện so sánh cũng quan trọng như tỷ lệ. Wccftech dẫn chú thích của Qualcomm rằng các số liệu là ước tính dựa trên kết quả silicon đo được, được chuẩn hóa về điều kiện vận hành mục tiêu và đối chiếu với thông số công bố của sản phẩm cạnh tranh. Hiệu năng cuối cùng có thể thay đổi theo cách triển khai, tác vụ và cấu hình hệ thống. Bỏ những điều kiện ấy sẽ biến một kết quả xác thực bộ nhớ thành lời hứa hiệu năng mà phép đo chưa chứng minh.
Theo thông số Qualcomm cung cấp, mẫu được dùng trong bước xác thực hiện có 2 lớp DRAM, trong khi sản phẩm dự kiến xuất xưởng dùng 4 lớp. Thiết bị kiểm thử tự động được dùng để đo mẫu ở cả chế độ LPDDR5X lẫn HBC. Cách thử này giúp đối chiếu hoạt động của đường dữ liệu, nhưng chưa đại diện cho toàn bộ bộ tăng tốc chạy một mô hình ngôn ngữ.
Cũng không nên suy ra rằng tăng số lớp sẽ tự động nhân đôi lợi ích đã công bố. Cấu hình nhiều lớp hơn cần được kiểm chứng ở chính điều kiện vận hành của nó, đặc biệt khi nhiệt và đóng gói là những phần còn ít thông tin. Các thông số của mẫu thử và mục tiêu sản phẩm phải được tách biệt khi đánh giá mức độ hoàn thiện.
Với doanh nghiệp triển khai AI tại Việt Nam, thước đo hữu ích hơn sẽ là chi phí để phục vụ một lượng yêu cầu ở chất lượng và độ trễ chấp nhận được. Băng thông bộ nhớ chỉ là một thành phần của bài toán đó. Nếu lợi thế ở cụm bộ nhớ không chuyển thành khả năng phục vụ tác vụ thực với mức điện thấp hơn, tỷ lệ tăng băng thông dù lớn vẫn chưa đủ để quyết định đầu tư.
HBC hiện đáng theo dõi như một hướng thiết kế có silicon hoạt động, chưa phải căn cứ để khẳng định Qualcomm đã vượt các giải pháp suy luận đang bán. Theo lộ trình Qualcomm công bố, Dragonfly AI250 dự kiến bắt đầu lấy mẫu trong nửa đầu năm 2027. Lấy mẫu là bước để khách hàng đánh giá phần cứng, không đồng nghĩa mở bán; mốc tiếp theo cần chờ là cấu hình hoàn chỉnh cùng phép đo tác vụ thực, thay vì thêm một tỷ lệ băng thông đứng riêng.
Nguồn tham khảo: ServeTheHome; Wccftech.