Tóm tắt nhanh
- Hai RTX 5060 Ti 16GB nạp được Qwen3-32B (bản Q4_K_M, 19,8GB) và Llama 3.3 70B IQ3_XXS (27,5GB), hai model mà một card 16GB không nạp nổi.
- Chia theo layer, tốc độ gần như không đổi so với một card; chia tensor (tensor split) mới nhanh hơn, với Qwen3-32B đạt 37,16 token/giây so với 20,82.
- RTX 5090 đơn vẫn nhanh gấp 1,7–1,9 lần trong cùng bộ phép thử, còn trần context của hai bên gần như bằng nhau.
- Khe PCIe thứ hai nối chung chipset bằng một lane có thể làm card rớt khỏi bus giữa lúc nạp model; cần xem sơ đồ lane trong sách hướng dẫn mainboard trước khi mua card thứ hai.
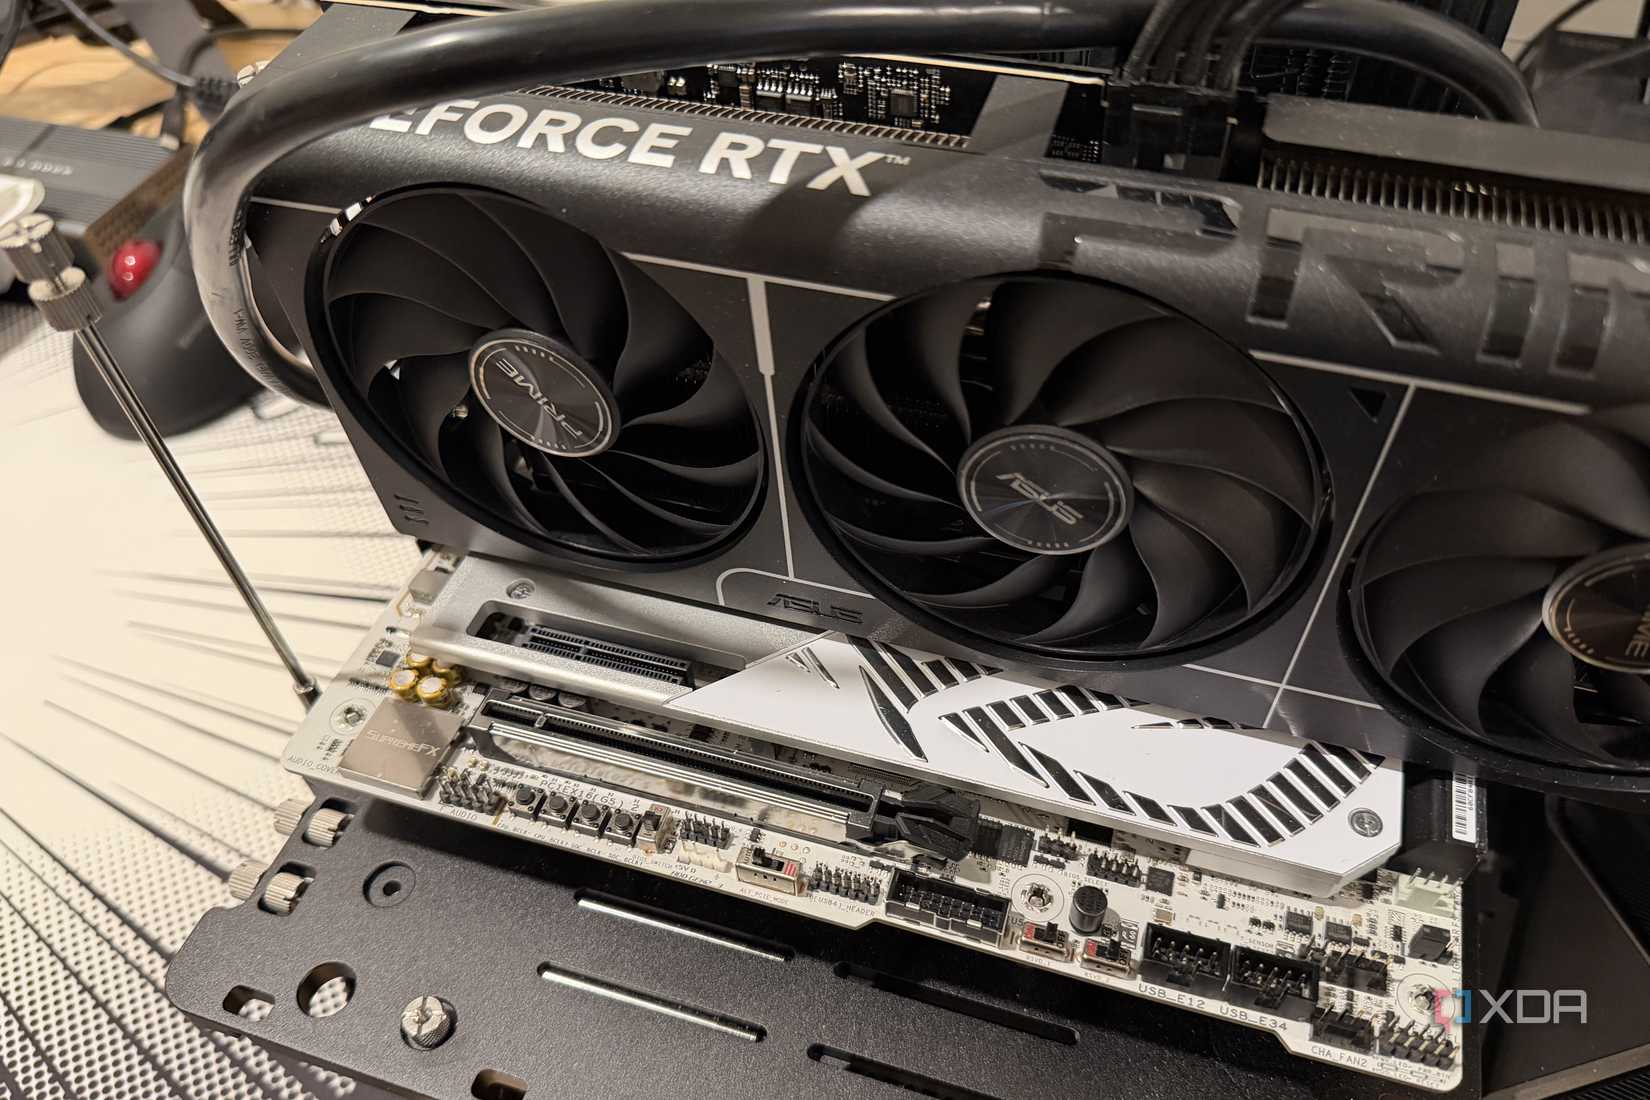
Câu hỏi “chạy được model lớn hơn” và “chạy nhanh hơn” có hai câu trả lời khác nhau khi ghép hai card đồ họa. Trong loạt phép thử XDA công bố ngày 17/11/2026, cặp RTX 5060 Ti 16GB (Asus Prime và PNY OC Dual, tổng 1.680 USD) nạp được những model vượt sức một card, nhưng khi so với RTX 5090 trên cùng bản llama.cpp thì chỉ đạt khoảng một nửa tốc độ. Các con số dưới đây là kết quả trên cấu hình cụ thể của tác giả, không phải cam kết cho mọi bo mạch hay mọi card 24GB.
Hai card 16GB nạp được model 32B và 70B mà một card đơn không nạp nổi
Bàn thử gồm mainboard Asus ROG Maximus Z890 Apex, Core Ultra 7 270K Plus và Ubuntu 26.04, chạy Qwen3-14B, Qwen3-32B ở Q4_K_M cùng Llama 3.3 70B Instruct ở IQ3_XXS trong llama.cpp, với cùng prompt, cùng thiết lập và cùng bản build được ghim. Trên một RTX 5060 Ti, Qwen3-32B cố nạp 18.424MiB trọng số vào card 16GB và dừng với lỗi cudaMalloc hết bộ nhớ; chia sang hai card thì chạy bình thường.
| Model | Dung lượng file | Một card | Hai card, chia layer | Hai card, chia tensor |
|---|---|---|---|---|
| Qwen3-14B Q4_K_M | 9GB | 46,31 token/giây | 46,37 token/giây | 79,64 token/giây |
| Qwen3-32B Q4_K_M | 19,8GB | Hết bộ nhớ | 20,82 token/giây | 37,16 token/giây |
| Llama 3.3 70B IQ3_XXS | 27,5GB | Hết bộ nhớ | 14,95 token/giây | 26,57 token/giây |
Số liệu: XDA, hai RTX 5060 Ti 16GB, llama.cpp.
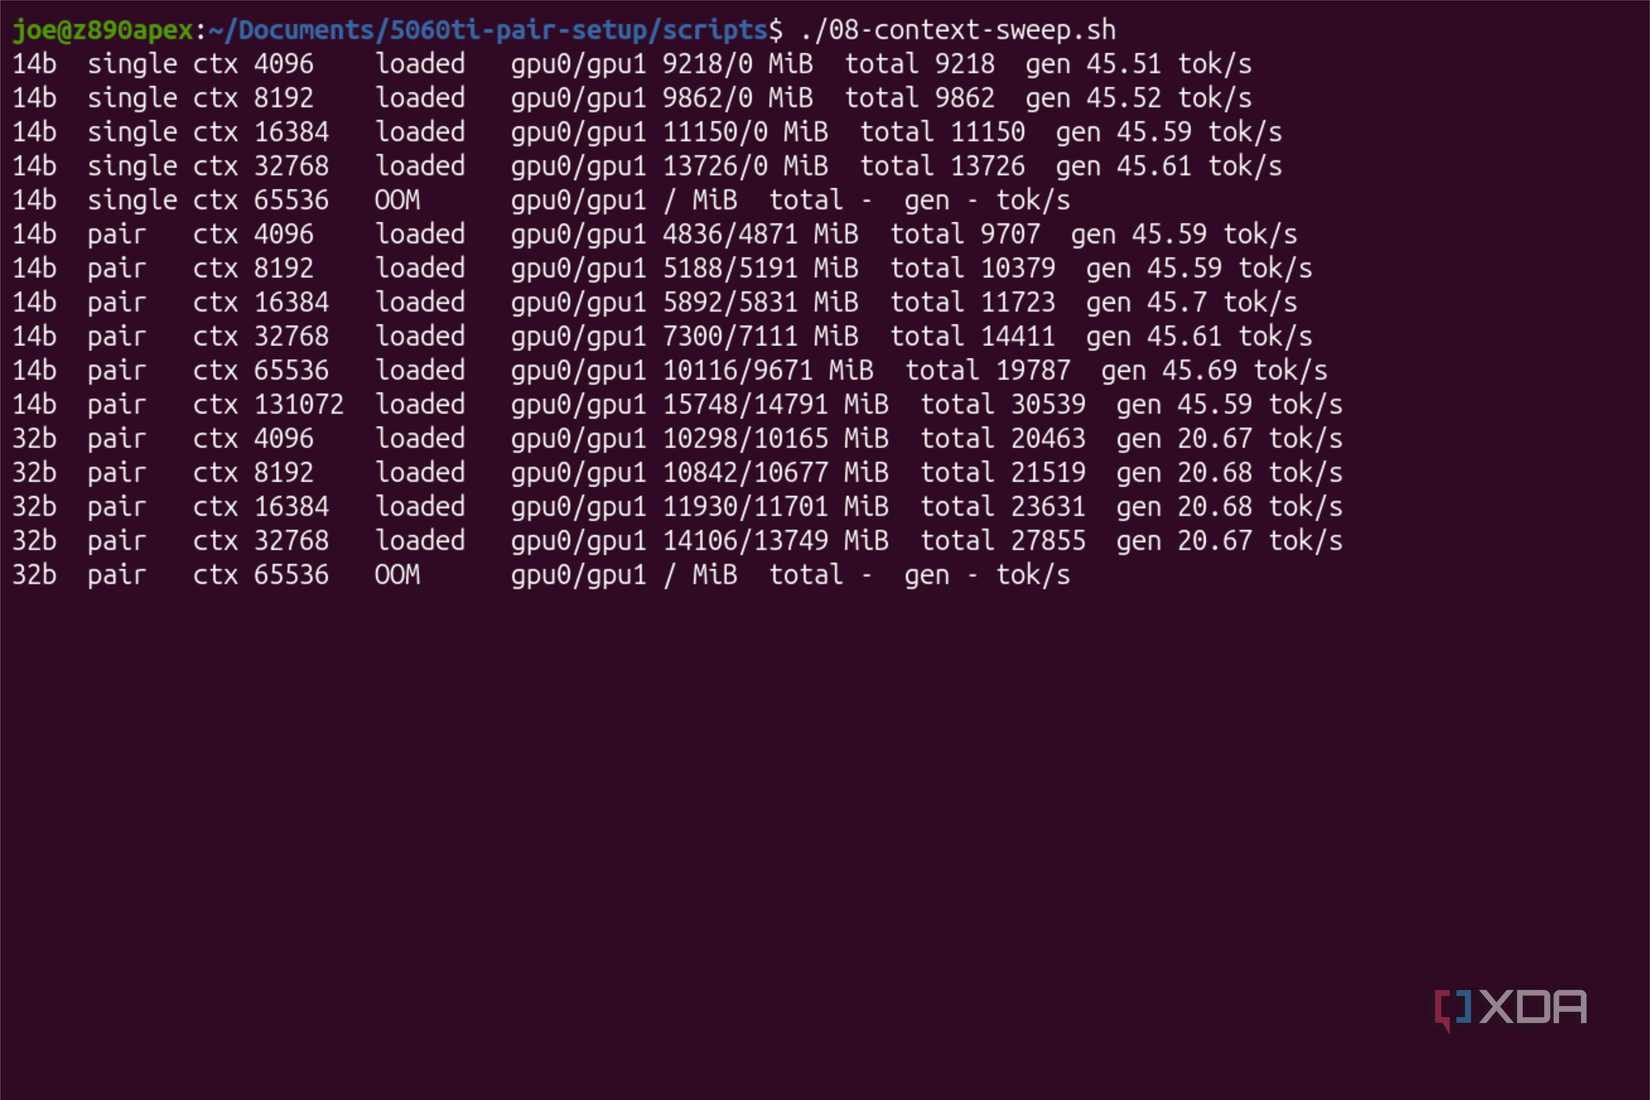
Phép so với card 24GB, vốn được xem là mức đệm an toàn cho model cỡ trung, cũng đáng xem. Tác giả bài thử không có sẵn card 24GB nên chỉ đo mức VRAM tiêu thụ trên cặp khi tăng dần context: Qwen3-32B cần 23.631MiB ở 16.384 token và 27.855MiB ở 32.768 token, còn một card 24GB chỉ có khoảng 24.500MiB, nghĩa là dừng ở quanh 16.000 token. Llama 3.3 70B cần 28.219MiB chỉ ở 4.096 token, nên không card 24GB nào nạp được. Đó là suy luận từ số đo trên cặp card chứ không phải phép thử trực tiếp trên card 24GB, và theo tác giả, mỗi card trong cặp còn gánh thêm một phần overhead mà card đơn không có.
Mở rộng context lại là chuyện khác. Lần quét đầu cho thấy Qwen3-14B nạp được 131.072 token trên cặp, so với 32.768 trên một card, nhưng Qwen3 được huấn luyện với 40.960 token và llama-server lặng lẽ giới hạn phiên ở mức đó. Với model đã vừa một card, card thứ hai chỉ thêm chỗ trống chứ không kéo dài cuộc hội thoại.
Chia theo layer chỉ cộng dung lượng, tensor split mới cộng được tốc độ
Cách chia mặc định của llama.cpp giống một cuộc chạy tiếp sức: card đầu xử lý nửa đầu các lớp, chuyển kết quả sang card thứ hai rồi đứng chờ. Bạn được dung lượng của hai card nhưng tốc độ của một, và Qwen3-14B chứng minh điều đó khi chạy 46,31 token/giây trên một card và 46,37 token/giây trên hai card. Trên bàn thử, tensor split nhanh hơn layer split khoảng 1,7 đến 1,8 lần (79,64 so với 46,37; 37,16 so với 20,82; 26,57 so với 14,95) với mức bộ nhớ gần như tương đương.
Tài liệu multi-GPU của llama.cpp mô tả layer là kiểu song song theo đường ống, mỗi GPU giữ một đoạn liên tiếp các lớp nên ít phải truyền dữ liệu và tương thích rộng nhất, còn tensor là chế độ thử nghiệm, chia cả trọng số lẫn KV cache cho các GPU và bị nút thắt ở tốc độ liên kết giữa card nhiều hơn. Chế độ này đòi hỏi bật flash attention, chưa hỗ trợ quantized KV cache và chưa chạy được trên mọi kiến trúc model, nên không có cơ sở để coi tensor split luôn nhanh hơn. Tác giả bài thử cũng phải mất gần một ngày mới chạy được: tensor split sập trên mọi model với lỗi CUDA cho tới khi đổi sang container CUDA 13 của llama.cpp, vì container tiêu chuẩn mang NCCL dựng cho CUDA 12.8 trong khi driver là CUDA 13.
Kết luận thực tế ở đây là cặp card cho bạn dung lượng ngay khi cắm vào, còn tốc độ thì phải đổi lấy thời gian cấu hình và rủi ro lệch phiên bản driver, thư viện. Người chỉ cần mở khóa model lớn hơn thì layer split là đủ; người muốn tốc độ phải chấp nhận đi trên phần mềm còn đánh dấu thử nghiệm.
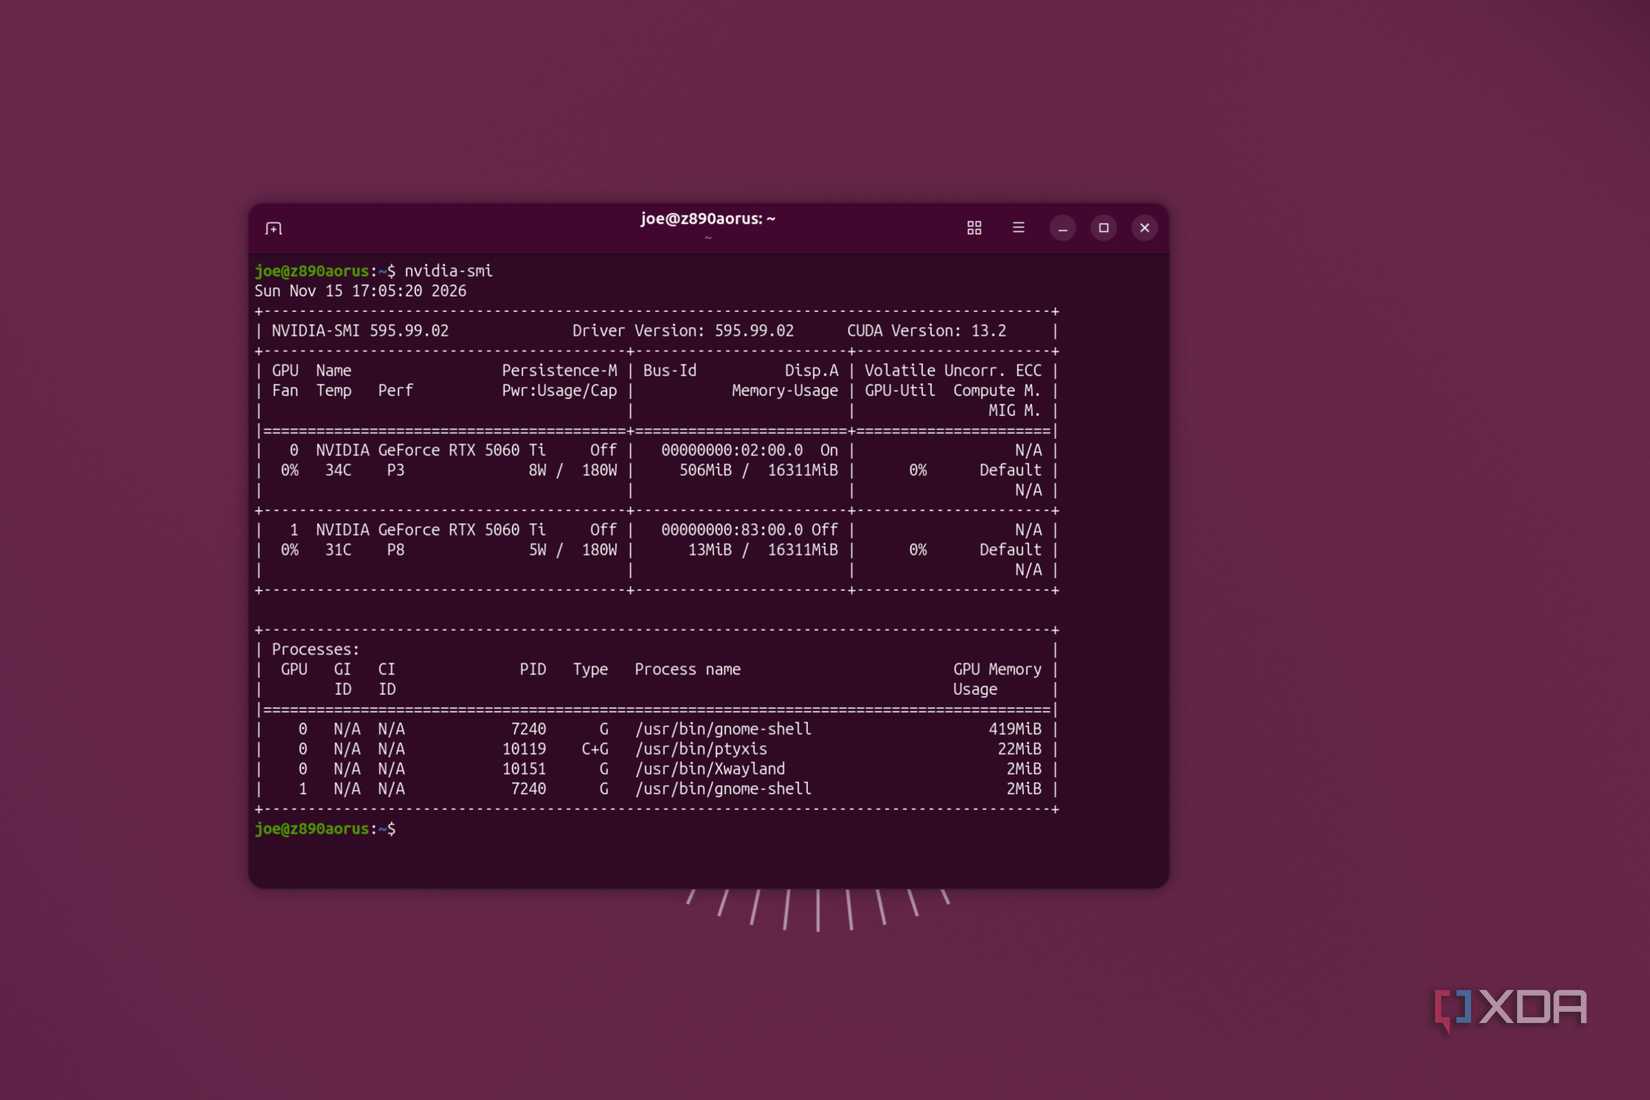
Điều này cũng bác bỏ cách hiểu hai card 16GB thành một GPU 32GB. Hai vùng nhớ vẫn tách riêng, như ảnh nvidia-smi dưới đây cho thấy hai khối 16.311MiB độc lập, và việc card nào đầy trước, model được chia ra sao mới quyết định thứ gì chạy được.
RTX 5090 nhanh gấp 1,7–1,9 lần nhưng trần context gần như ngang cặp 5060 Ti
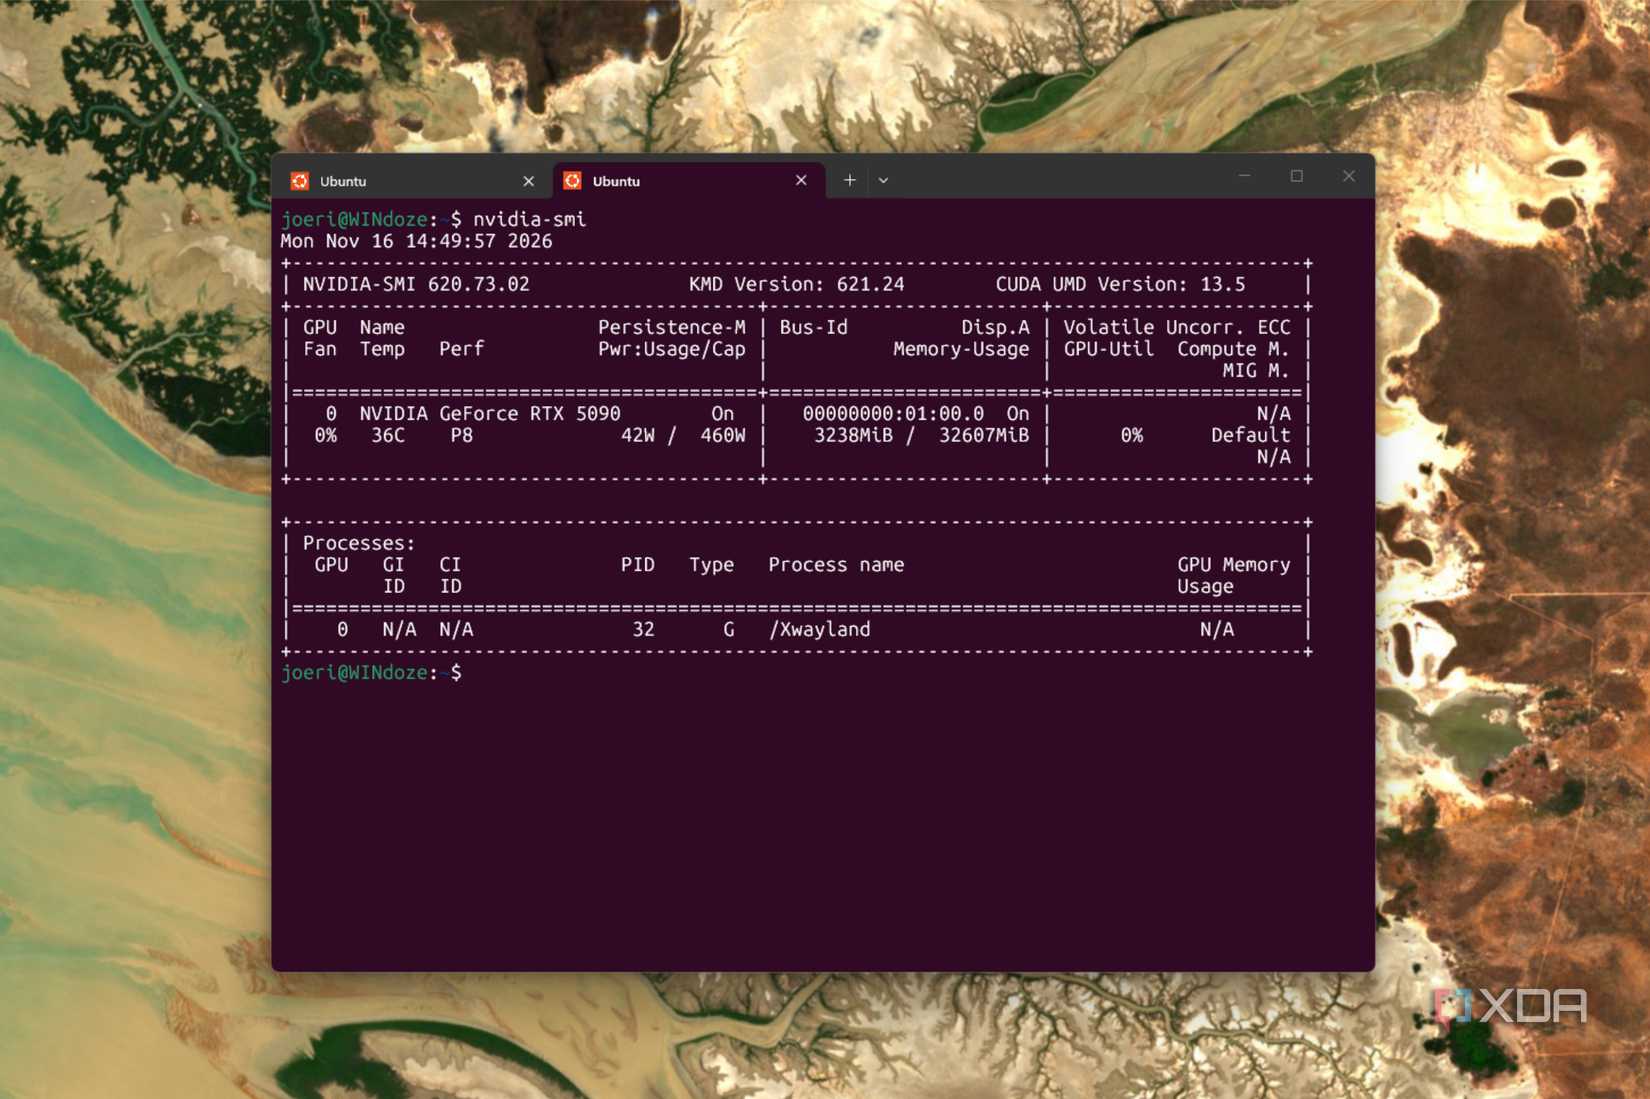
Trong cùng bộ ba model, RTX 5090 (Gigabyte Windforce OC 32G) đứng đầu ở mọi dòng. Card này nằm trong máy chính với 96GB RAM và Ryzen 7 9850X3D, chạy cùng bản llama.cpp nhưng dưới WSL2, nên đây là phép so giữa hai máy khác nền tảng chứ không phải hai card trên cùng một bo.
| Model | Hai RTX 5060 Ti (tensor split) | RTX 5090 |
|---|---|---|
| Qwen3-14B Q4_K_M | 79,64 token/giây | 148,2 token/giây |
| Qwen3-32B Q4_K_M | 37,16 token/giây | 72,0 token/giây |
| Llama 3.3 70B IQ3_XXS | 26,57 token/giây | 45,3 token/giây |
| Giá | 1.680 USD | 3.200 USD lúc mua, 6.760 USD hiện nay |
Số liệu: XDA, giá theo Newegg tại thời điểm viết bài gốc.
Khoảng cách phần lớn đến từ băng thông bộ nhớ, vì sinh token về cơ bản là cuộc đua đọc trọng số: RTX 5090 có 1.792GB/s, mỗi RTX 5060 Ti chỉ 448GB/s. Với mức giá tác giả đã trả, cặp 5060 Ti tốn khoảng 52% và chạy ở 52 đến 59% tốc độ; còn nếu so với mẫu Aorus RTX 5090 Master giá 6.760 USD hiện nay thì chi phí chỉ còn khoảng một phần tư. Vì chiếc 5090 giá 3.200 USD không còn bán nữa, mốc 52% là mốc quá khứ, mốc một phần tư mới phản ánh thị trường.
Điều bất ngờ hơn là trần context. Qwen3-32B vừa 32.768 token trên cả hai bên, Llama 3.3 70B vừa 8.192 token trên cả hai, và mức 16.384 nằm đúng ngưỡng giới hạn của RTX 5090 trong khi cặp 5060 Ti không nạp nổi. Một chi tiết nhỏ nhưng đáng ghi: RTX 5090 còn đảm nhiệm cả màn hình Windows nên chiếm 2GB đến 3,2GB lúc rảnh, còn máy Linux của cặp 5060 Ti chỉ tốn khoảng 110MiB cho giao diện. Trên WSL2, card này còn tràn sang RAM hệ thống thay vì báo lỗi khi model quá lớn, nên tác giả phải đánh giá giới hạn dựa trên mức bộ nhớ và tốc độ.
Nói gọn: nửa giá, nửa tốc độ, gần như cùng trần. Nếu bạn cần chạy model ở tốc độ tương tác cho nhiều người dùng thì băng thông của RTX 5090 là thứ cặp card tầm trung không bù được; còn nếu mục tiêu là nạp model lớn để chạy riêng cho mình thì khoảng cách 1,7–1,9 lần hiếm khi là lý do quyết định.
Khe PCIe thứ hai quyết định cặp card chạy ổn hay rớt khỏi bus
Bàn thử không bắt đầu trên Apex. Bản dựng đầu dùng Gigabyte Z890 Aorus Master, mà khe full-length thứ hai trông giống khe đầu nhưng chỉ đi một lane PCIe từ chipset. Đường liên kết ghi nhận 154 lỗi phía nhận và card thứ hai rớt khỏi bus ngay khi nạp model 70B; kịch bản kiểm tra của chính tác giả vẫn báo đạt vì chỉ đọc độ rộng link của card chứ không phải của khe. Chuyển sang Apex, nơi cả hai khe đều chạy x8 trực tiếp từ CPU, thì không còn lỗi PCIe nào trong mọi phép đo sau đó.
Tốc độ thì chênh rất ít: Qwen3-32B chạy 20,38 token/giây ở khe một lane với layer split so với 20,53 trên Apex, dù CPU cũng đổi theo. Nghĩa là trên bo đó khe hẹp gây ra vấn đề ổn định chứ không phải tốc độ. Tác giả lưu ý bảng chia sẻ lane trong sách hướng dẫn mainboard mới là căn cứ, vì chữ “x16” in trên khe không nói lên nhiều: trên Apex, cả hai khe chỉ chạy x8 khi hai khe M.2 nhất định bỏ trống, còn cắm vào thì khe thứ hai tụt xuống x4 hoặc bị tắt. Sau khi lắp, lệnh nvidia-smi –query-gpu=pcie.link.width.current –format=csv cho biết mỗi card thực sự đàm phán được bao nhiêu lane.
Tài liệu llama.cpp còn cảnh báo thêm rằng truyền P2P có thể tăng tốc nhưng gây treo hoặc sai kết quả trên một số tổ hợp mainboard và BIOS. Vì vậy hai khe dài trên bo không đủ bảo đảm cho việc chạy model hai card; phải kiểm tra cấu trúc lane, và dự trù một khoản thời gian cho chuyện BIOS.
Ở Việt Nam, hai card 16GB đáng cân nhắc nhất với người đã có sẵn một chiếc
GEARVN đang niêm yết Zotac GeForce RTX 5060 Ti 16GB Twin Edge OC giá 19.990.000 đồng (giá gốc 21.990.000 đồng), kiểm tra ngày 17/11/2026. Đây là giá của đúng mẫu Zotac này, không áp được cho cả dòng: các mẫu khác giá khác nhau hoặc ghi liên hệ, và trang danh mục còn lẫn cả phiên bản 8GB. Hai card Zotac sẽ tốn khoảng 39,98 triệu đồng, chưa tính mainboard có hai khe đủ lane, nguồn đủ công suất và vỏ đủ rộng.
Việc phân biệt SKU quan trọng hơn vẻ ngoài: cùng tên RTX 5060 Ti, bản 16GB mới có sức chứa cần cho phép tính ở trên, còn bản 8GB thì không nằm trong phép tính này. Mọi con số về model 32B và 70B ở trên chỉ đúng với bản 16GB.
Từ dữ kiện đó, quyết định hợp lý nhất khác nhau theo hai nhóm. Người đã có một RTX 5060 Ti 16GB và hay gặp lỗi hết bộ nhớ thì card thứ hai là đường nâng cấp kinh tế nhất, miễn khe PCIe thứ hai đủ lane; hướng này cũng khớp kết luận của bài thử gốc. Người lắp máy từ đầu chỉ vì muốn chạy model lớn thì nên tính tổng chi phí cả bộ máy, vì phần tiết kiệm so với một card đầu bảng bị mainboard, nguồn và thời gian chỉnh phần mềm ăn bớt, và nếu ưu tiên tốc độ thì việc cộng dung lượng không bù được phần băng thông còn thiếu.
Nguồn tham khảo: XDA; tài liệu multi-GPU llama.cpp; Qwen3-32B model card; GEARVN; RepoChad (YouTube)