Tóm tắt nhanh
- Ollama dùng llama.cpp để chạy mô hình GGUF; đổi sang llama-server chủ yếu thay cách cấu hình và quản lý suy luận.
- llama-server cho chỉnh riêng luồng CPU xử lý prompt và luồng sinh token, bên cạnh batch và độ dài ngữ cảnh.
- Chưa có số đo đối chiếu đủ để kết luận llama.cpp luôn nhanh hơn Ollama; cần so trên cùng mô hình và tải thực tế.
- Với máy chủ chạy nhiều dịch vụ, phần tài nguyên còn lại cho các tác vụ khác quan trọng không kém tốc độ trả lời của AI.
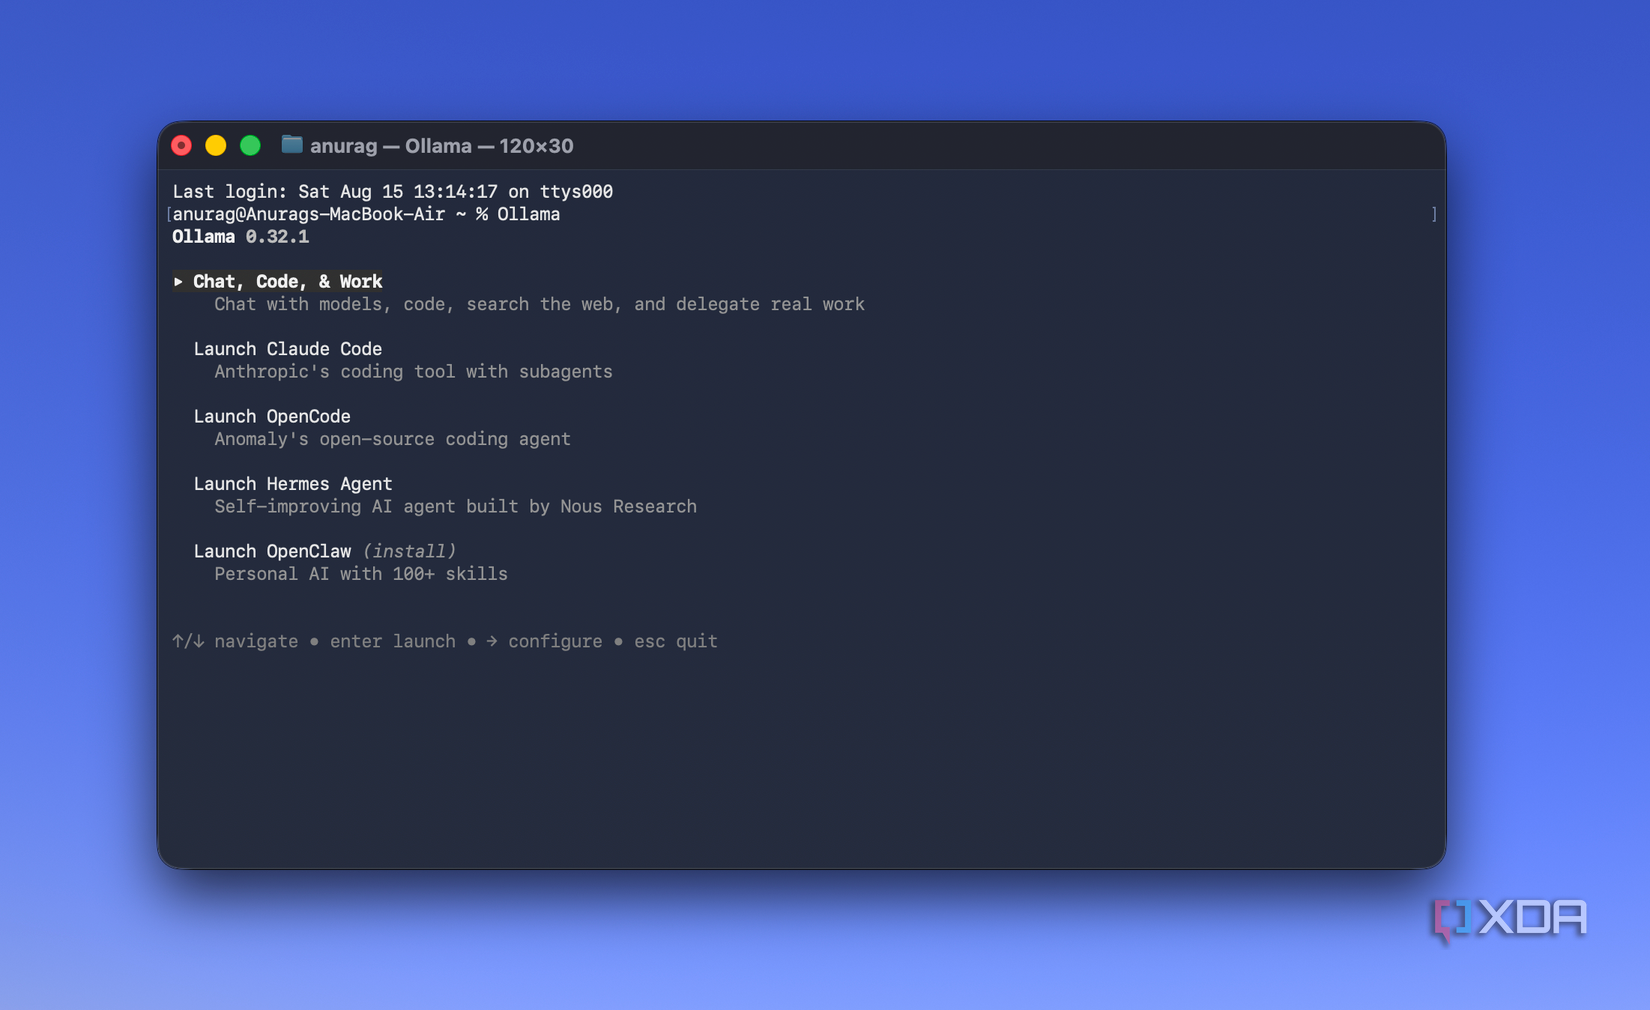
Chuyển từ Ollama sang llama.cpp có thể giúp tận dụng phần cứng sẵn có, nhưng lý do đáng quan tâm nằm ở khả năng chỉnh cách chạy mô hình, chứ không phải thay một công cụ bằng cái tên khác. Ollama vốn đã dùng llama.cpp bên dưới để chạy GGUF. Vì vậy, câu hỏi hữu ích hơn với người dựng máy chủ tại nhà là: cấu hình tự động đang đáp ứng tốt nhu cầu, hay đã đến lúc tự quyết định tài nguyên dành cho AI?
Trên máy không có GPU đủ khỏe, khác biệt giữa chờ AI đọc xong một đoạn tài liệu và chờ từng chữ xuất hiện rất dễ ảnh hưởng đến việc sử dụng hằng ngày. Chạy trực tiếp llama-server mở thêm chỗ để tinh chỉnh hai giai đoạn ấy, đổi lại người dùng phải chịu trách nhiệm nhiều hơn với tệp mô hình và cấu hình dịch vụ.
llama-server đáng thử khi cần kiểm soát tài nguyên, không phải vì lời hứa luôn nhanh hơn
Điểm đáng giá của llama-server là có thể điều chỉnh sát công việc mà máy đang làm. Ollama quản lý việc nạp, giải phóng mô hình và điều phối yêu cầu; cách làm này giảm đáng kể công sức vận hành. Người dùng vẫn chỉnh được những yếu tố như độ dài ngữ cảnh, số yêu cầu song song hay đưa tính toán lên GPU, nên xem Ollama là công cụ hoàn toàn không thể tinh chỉnh sẽ sai ngay từ đầu.
Khác biệt khi chạy llama-server trực tiếp nằm ở mức độ chủ động với các tham số khởi động. Tài liệu llama.cpp xác định -t, hay --threads, là số luồng CPU dùng trong giai đoạn sinh token; còn -tb, hay --threads-batch, dành cho xử lý batch và prompt. Nếu không đặt riêng, tham số xử lý prompt mặc định dùng cùng giá trị với tham số sinh token.
Đọc prompt và viết câu trả lời là hai việc khác nhau. Ở giai đoạn đầu, mô hình xử lý phần văn bản được đưa vào; ở giai đoạn sau, nó tiếp tục sinh các token của câu trả lời. Từ cách chia tham số của llama.cpp, hướng tối ưu hợp lý là đo từng giai đoạn thay vì chỉ nhìn thời gian hoàn thành cả cuộc hội thoại. Một thay đổi có lợi cho đoạn prompt dài chưa chắc đã giúp câu trả lời xuất hiện đều hơn.
Số luồng cao nhất cũng không mặc nhiên là cấu hình tốt nhất. Với máy chủ còn phục vụ những việc khác, cấp thêm CPU cho AI có thể làm thay đổi phần tài nguyên còn lại của cả hệ thống. Cách thử có ích là thay số luồng sinh token trong khi giữ cấu hình đọc prompt ổn định, rồi làm ngược lại, thay vì đổi hàng loạt tham số và không biết yếu tố nào tạo khác biệt.
Batch cần được hiểu riêng, không gộp với số luồng hay số người cùng chat. Tài liệu llama.cpp phân biệt --batch-size, giới hạn batch logic, với --ubatch-size, giới hạn batch vật lý. Đây là các tham số liên quan đến cách xử lý dữ liệu trong suy luận, còn số yêu cầu phục vụ đồng thời thuộc một khía cạnh khác. Tăng tất cả chỉ vì máy còn RAM là cách khó xác định nguyên nhân nếu hiệu năng đi xuống.
Độ dài ngữ cảnh cũng là một lựa chọn vận hành, không chỉ là con số để khoe khả năng nhớ hội thoại. llama-server có --ctx-size để đặt kích thước ngữ cảnh. Lịch sử chat dài hơn đòi hỏi thêm bộ nhớ; khi máy còn chạy các dịch vụ khác, dành quá nhiều tài nguyên cho một phiên AI có thể khiến tổng thể kém dễ chịu hơn, dù riêng phiên đó chứa được nhiều nội dung hơn.
Vì thế, nên đặt giới hạn theo công việc thực tế. Chat ngắn và trao đổi về tài liệu dài không gây ra cùng một kiểu tải. Nếu chỉ đo bằng một câu chào, người dùng khó biết cấu hình mới có chịu được cuộc hội thoại thường ngày hay không; ngược lại, lấy tác vụ dài nhất làm mặc định cho mọi lần gọi cũng có thể dành nhiều tài nguyên hơn mức cần thiết.
Khả năng truy cập từ ứng dụng khác không biến mất khi rời Ollama. Theo tài liệu chính thức, llama-server có các tuyến API tương thích OpenAI cho chat completions, responses và embeddings, đồng thời có giao diện Llama Chat tích hợp. Đây là cơ sở để giữ ứng dụng phía trước trong khi thay dịch vụ chạy mô hình, nhưng vẫn cần kiểm tra tính năng mà ứng dụng thực sự gọi, thay vì coi chữ “tương thích” là bảo đảm mọi cách tích hợp đều giống nhau.
Cũng cần tách khả năng tinh chỉnh khỏi bằng chứng tăng tốc. Bài trải nghiệm trên XDA không đưa bảng đo đối chiếu tốc độ sinh token, thời gian chờ token đầu tiên và cấu hình thử đủ chi tiết để suy ra mức cải thiện chung. Chưa thể biết riêng việc tách luồng đóng góp bao nhiêu, hay khác biệt phiên bản và cách cấu hình đã ảnh hưởng đến kết quả đến mức nào. Khẳng định đổi sang llama.cpp chắc chắn nhanh hơn sẽ đi xa hơn dữ kiện hiện có.
Phép so có ý nghĩa phải giữ nguyên tệp mô hình, mức lượng tử hóa và nội dung prompt, đồng thời kiểm soát độ dài ngữ cảnh cùng tải nền. Sau đó mới so thời gian bắt đầu phản hồi và tốc độ sinh phần trả lời. Nếu một bên dùng mô hình khác hoặc đã có sẵn lịch sử trong bộ nhớ, kết quả có thể phản ánh điều kiện thử thay vì ưu thế của công cụ.
Với người đang dùng Ollama ổn định, chưa có lý do phải gỡ bỏ ngay. Chạy thử một cấu hình llama-server riêng, ghi lại kết quả và giữ đường quay lại sẽ hợp lý hơn thay toàn bộ dịch vụ chỉ dựa trên trải nghiệm của một máy khác. Giá trị của quyền kiểm soát chỉ rõ khi nó giải quyết được điểm nghẽn cụ thể.
Máy chủ dùng chung cần một cấu hình bền, không chỉ một lần trả lời nhanh
Với người chơi home lab tại Việt Nam muốn tận dụng máy sẵn có, tiêu chí chọn công cụ nên bắt đầu từ khả năng vận hành lâu dài. Một dịch vụ AI nhanh hơn trong lần thử riêng lẻ nhưng cần chỉnh lại liên tục, hoặc chiếm tài nguyên của các dịch vụ đang dùng, chưa chắc là lựa chọn tiết kiệm công sức. Trước khi mua thêm phần cứng, thử điều chỉnh trên cùng máy là hợp lý; lấy đó làm lời bảo đảm không cần nâng cấp thì không.
Ollama hợp với trường hợp muốn tải mô hình bằng lệnh đơn giản, chuyển qua lại thuận tiện và để công cụ lo việc nạp, giải phóng bộ nhớ. Khi mục tiêu chính là có AI cục bộ dùng được mỗi ngày, sự tiện lợi ấy là lợi ích thật. Phần thời gian không phải quản lý dịch vụ cũng cần được tính vào quyết định, nhất là khi người dùng không muốn biến mỗi đợt cập nhật thành một buổi chỉnh máy.
llama-server phù hợp hơn khi người quản trị đã xác định được chỗ cần can thiệp và sẵn sàng giữ cấu hình khởi động rõ ràng. Tệp GGUF, tham số xử lý và cách duy trì dịch vụ phải được quản lý có chủ đích. Đổi lại, khi thử số luồng hay batch khác nhau, người dùng có cơ sở biết mình đã thay điều gì và có thể trở về cấu hình trước nếu kết quả xấu hơn.
Ngoài hai lựa chọn này, giao diện và cách triển khai cũng có thể quyết định công cụ phù hợp. LM Studio có giao diện đồ họa để tải, quản lý và thử mô hình; phiên bản headless llmster hướng đến chạy nền mà không cần mở ứng dụng desktop. Docker Model Runner lại đáng cân nhắc với người đã tổ chức dịch vụ bằng Docker, thay vì bổ sung một cách quản lý riêng chỉ cho AI. Sự thuận tiện khi tích hợp không đồng nghĩa các lựa chọn đó tự động cho tốc độ cao hơn.
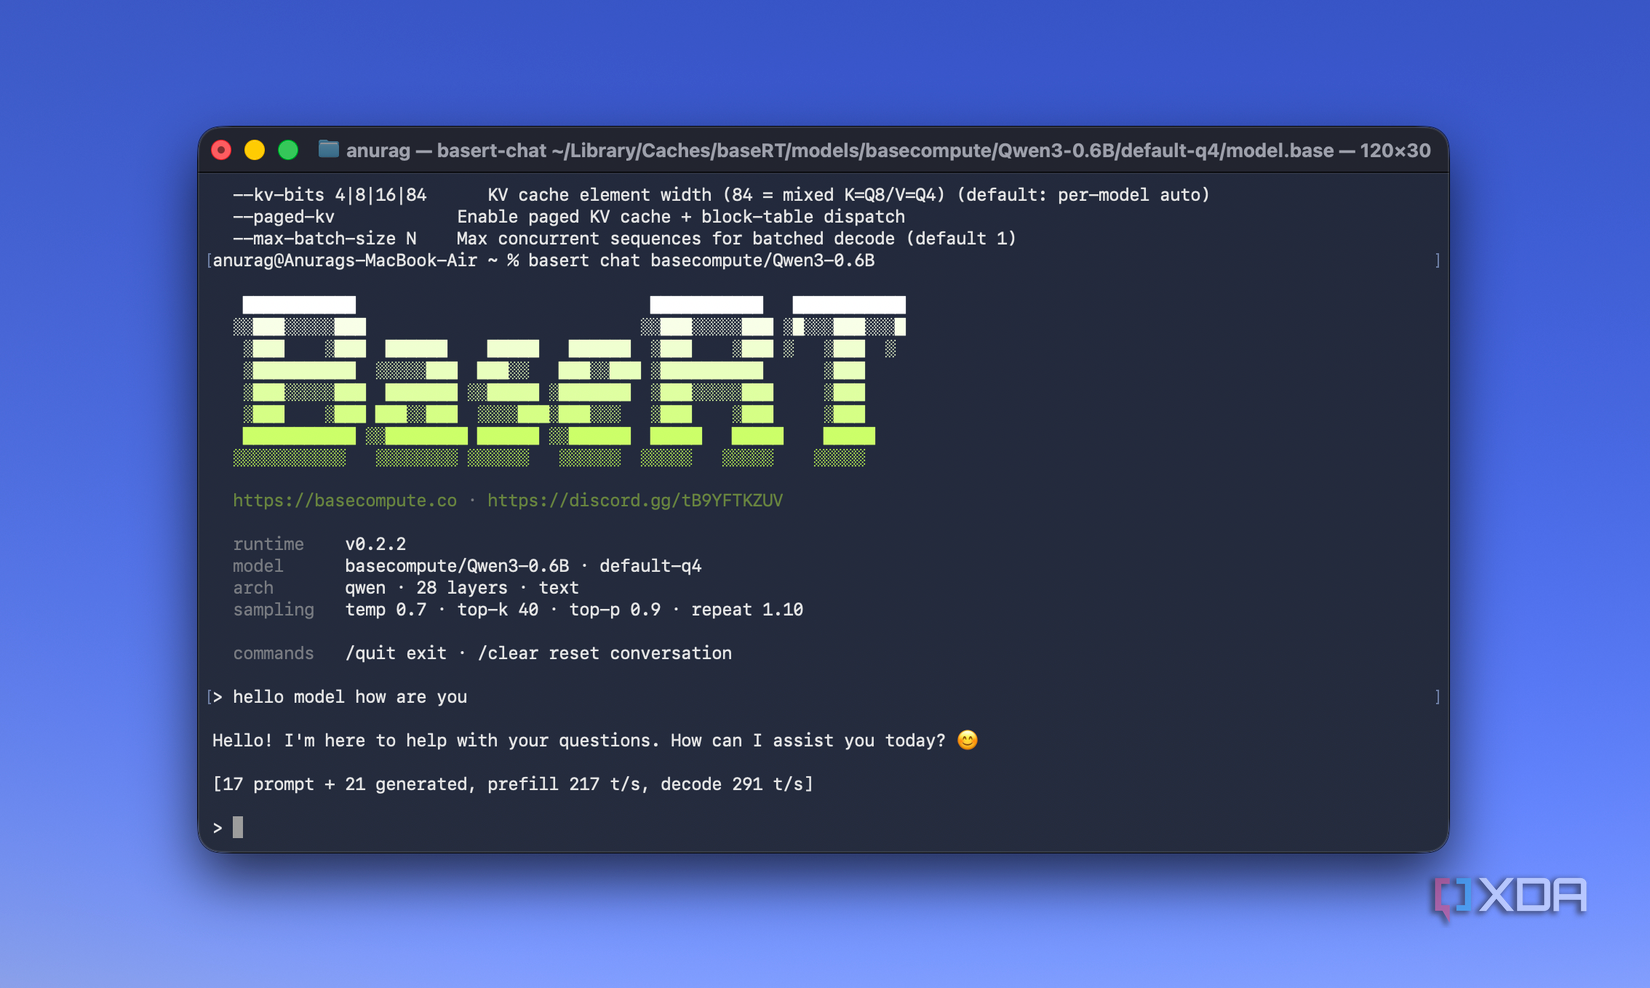
Trên Apple Silicon, BaseRT là một hướng thử khác, nhưng không nên đặt chung mọi kết quả thành cuộc đua giữa các tên phần mềm. Bài XDA nêu mức sinh văn bản nhanh hơn 15% đến 56% so với llama.cpp trong benchmark do nhà phát triển BaseRT công bố, trên các mô hình thử nghiệm chạy bằng M4 Pro và sử dụng định dạng mô hình riêng của BaseRT. Điều kiện ấy không đại diện cho mọi máy Mac, càng không thể áp sang máy chủ CPU khác nền tảng.
Ảnh giao diện BaseRT có hiển thị riêng chỉ số prefill và decode, cũng gợi đúng câu hỏi cần đặt khi đo AI cục bộ: máy chậm lúc đọc đầu vào hay lúc tạo đầu ra? Một tốc độ hiển thị trên màn hình chưa đủ để so hai công cụ nếu không có cùng điều kiện. Đổi cả engine lẫn định dạng mô hình khiến việc xác định nguyên nhân chênh lệch khó hơn so với thử cùng một GGUF trên hai cách chạy.
Vì vậy, hướng ưu tiên nên là tìm giới hạn của cấu hình hiện tại trước, rồi mới đổi công cụ. Nếu Ollama đã đáp ứng được thời gian phản hồi và không gây khó cho các dịch vụ còn lại, giữ lại là quyết định hợp lý. Nếu cần kiểm soát riêng xử lý prompt với sinh token và có thời gian đo, llama-server là lựa chọn đáng thử trực tiếp. Cấu hình tốt nhất cho máy chủ tại nhà là cấu hình đạt mức phản hồi cần thiết mà vẫn để phần còn lại của máy hoạt động ổn định.
Nguồn tham khảo: Tài liệu llama-server của llama.cpp; XDA Developers.