Tóm tắt nhanh
- LLM xử lý prompt ở pha prefill rồi mới sinh câu trả lời từng token ở pha decode; hai giai đoạn tạo ra hai kiểu độ trễ khác nhau.
- KV cache giữ lại trạng thái Key và Value của token cũ để không phải tính lại, đổi lại nó chiếm bộ nhớ tăng theo độ dài chuỗi và số request.
- PagedAttention tổ chức cache thành block để giảm lãng phí do phân mảnh; speculative decoding thử sinh trước rồi để mô hình đích xác minh.
- Các mức tăng tốc trong nghiên cứu là kết quả theo cấu hình và workload cụ thể, không phải lời hứa rằng mọi chatbot sẽ phản hồi nhanh hơn cùng một tỷ lệ.
Khi gửi một câu hỏi cho chatbot, thời gian chờ trước ký tự đầu tiên và nhịp câu trả lời tiếp tục hiện ra thường không giống nhau. Phía sau trải nghiệm đó là hai công đoạn: prefill đọc toàn bộ prompt để chuẩn bị trạng thái cho mô hình, còn decode lần lượt sinh token tiếp theo. Chúng cùng chạy trên một yêu cầu nhưng tạo áp lực khác nhau lên phần cứng.
Token đầu tiên phải chờ prompt được xử lý
LLM dạng decoder tạo văn bản theo kiểu tự hồi quy: token kế tiếp được dự đoán dựa trên prompt và những token đã sinh trước đó. Trước khi có thể trả token đầu tiên, hệ thống phải đưa prompt qua mô hình. Vì nội dung đầu vào đã biết đầy đủ, phép tính ở pha prefill có thể xử lý nhiều vị trí song song bằng các phép toán ma trận.
Độ dài prompt vì thế ảnh hưởng đáng kể đến thời gian tới token đầu tiên. Một câu hỏi ngắn cần ít đầu vào hơn một yêu cầu kèm lịch sử trò chuyện dài, tài liệu được dán vào hoặc phần ngữ cảnh truy xuất từ hệ thống RAG. Không thể suy ra mức chậm cụ thể chỉ từ số chữ: tokenizer, mô hình, batch và phần cứng đều góp phần quyết định.
Đây cũng là lý do câu trả lời có thể bắt đầu chậm rồi chạy đều hơn, hoặc ngược lại. Tốc độ token đầu tiên không đại diện đầy đủ cho tốc độ sinh phần còn lại; chúng phản ánh những đoạn việc khác nhau trong cùng một lượt suy luận.
Decode sinh từng token và phải mang theo ngữ cảnh cũ
Sau prefill, mô hình bước vào decode. Mỗi vòng tính toán tạo ra token mới, rồi token đó trở thành một phần ngữ cảnh để tính token kế tiếp. Các vòng phụ thuộc nối tiếp nhau nên không thể đơn giản tính đồng thời tất cả token của một câu trả lời như khi xử lý prompt đã có sẵn.
Trong mô tả của NVIDIA, decode thường bị giới hạn bởi việc chuyển trọng số và các trạng thái Key/Value từ bộ nhớ tới GPU hơn là năng lực tính toán thuần túy. Đây là xu hướng, không phải quy luật bất biến: kích thước batch, độ dài chuỗi, kiến trúc mô hình và cách phục vụ request có thể đổi điểm nghẽn. Với người dùng, hiện tượng dễ thấy là nhịp xuất token sau câu mở đầu có thể dao động khi máy chủ đang phục vụ nhiều yêu cầu.
Máy chủ thường gom nhiều request cùng chạy để dùng phần cứng hiệu quả hơn. Nhưng mỗi cuộc hội thoại có độ dài prompt và câu trả lời khác nhau; nếu chờ request dài nhất mới giải phóng cả batch, tài nguyên có thể bị giữ lại không cần thiết. Các cách lập lịch theo từng vòng sinh cho phép loại request đã xong và đưa request mới vào sớm hơn, dù lợi ích phụ thuộc tải thực tế.
KV cache tiết kiệm phép tính nhưng chiếm chỗ trong bộ nhớ
Ở mỗi bước decode, token mới cần dựa vào trạng thái của những token trước. Nếu tính lại toàn bộ Key và Value cũ ở mọi vòng, công việc sẽ lặp đi lặp lại. KV cache lưu các trạng thái đó để mô hình dùng tiếp, giảm phần tính toán trùng lặp nhưng khiến dung lượng bộ nhớ tăng khi chuỗi dài ra và khi có nhiều request đồng thời.
Một ví dụ NVIDIA đưa ra là Llama 2 7B ở độ chính xác 16-bit, batch một và chuỗi 4.096 token cần khoảng 2 GB cho KV cache theo công thức và giả định của tài liệu. Đây không phải con số áp dụng cho mọi mô hình: số lớp, kích thước ẩn, độ chính xác và cấu hình attention như GQA hoặc MQA làm thay đổi dung lượng. Bởi vậy, chỉ nhìn số tham số của mô hình chưa đủ để biết một máy chủ có thể phục vụ bao nhiêu cuộc trò chuyện cùng lúc.
Vấn đề vận hành nằm ở chỗ độ dài đầu ra không biết trước. Cấp sẵn vùng nhớ cho mức tối đa giúp hệ thống tránh thiếu chỗ giữa chừng nhưng có thể bỏ phí phần chưa dùng; các request có độ dài khác nhau còn tạo ra phân mảnh. Nếu KV cache chiếm quá nhiều bộ nhớ, máy chủ phải giảm số request chạy song song hoặc chuyển sang cơ chế xử lý khác, ảnh hưởng thông lượng và độ trễ.
PagedAttention chia cache thành block thay vì giữ một vùng liền mạch
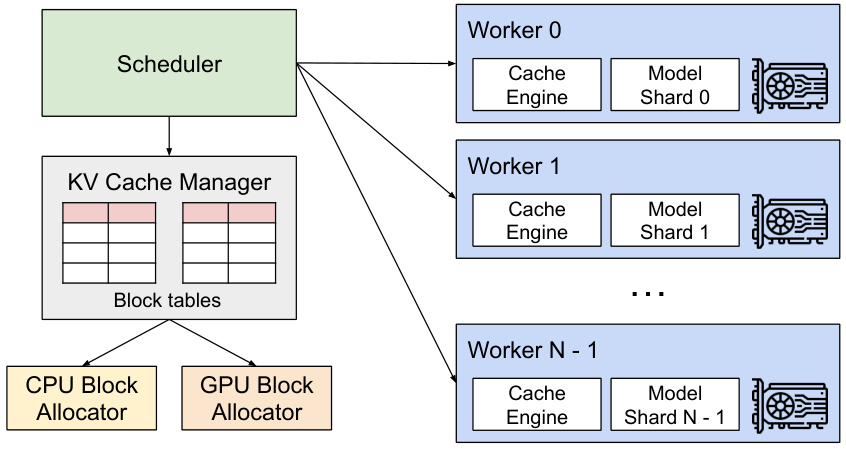
PagedAttention xử lý bài toán cấp phát bằng cách chia KV cache thành các block kích thước cố định, rồi ánh xạ block logic sang những vị trí vật lý có thể không liền nhau. Hệ thống cấp thêm block khi chuỗi dài ra thay vì dành trước một vùng lớn cho toàn bộ độ dài tối đa. Cách này cũng giúp chia sẻ một số block giữa các nhánh sinh có chung tiền tố, với cơ chế copy-on-write khi nhánh cần ghi dữ liệu riêng.
Trong nghiên cứu SOSP ’23, nhóm phát triển vLLM ghi nhận chỉ 20,4–38,2% bộ nhớ KV cache ở các hệ thống đối chiếu được dùng để lưu trạng thái token thực tế trong thí nghiệm profiling của họ. Trên các mô hình, baseline và workload được đánh giá, vLLM đạt thông lượng cao hơn 2–4 lần so với FasterTransformer và Orca ở cùng mức độ trễ. Đây là kết quả của cấu hình nghiên cứu, không phải mức cải thiện bảo đảm cho dịch vụ khác; PagedAttention cũng có thêm chi phí truy cập bảng ánh xạ và xử lý block.
Điểm đáng chú ý là tối ưu này nhắm vào khả năng giữ nhiều request trong bộ nhớ, chứ không làm cho một phép tính riêng lẻ tự nhiên nhanh gấp nhiều lần. Khi phần cứng trước đó bị giới hạn bởi dung lượng cache và phân mảnh, tận dụng bộ nhớ tốt hơn có thể cải thiện thông lượng. Nếu workload ngắn hoặc nghẽn ở nơi khác, mức lợi ích sẽ khác.
Speculative decoding dùng một tiến trình rẻ hơn, thường là mô hình nhỏ, để đề xuất trước vài token. Mô hình đích sau đó kiểm tra một đoạn đề xuất song song; những token phù hợp được giữ lại, còn phần bắt đầu lệch bị loại để tiếp tục sinh theo cách bình thường. Thuật toán xác minh chính xác trong nghiên cứu gốc được thiết kế để giữ nguyên phân phối đầu ra của mô hình lớn.
Paper gốc báo cáo mức tăng tốc 2–3 lần trên T5-XXL so với triển khai T5X chuẩn, với đầu ra giống nhau trong thử nghiệm đó. Con số này phụ thuộc mô hình nháp, tỷ lệ token được chấp nhận, chi phí xác minh và phần cứng. Nếu bản nháp thường xuyên sai hoặc bản thân mô hình phụ tốn nhiều tài nguyên, lợi ích có thể giảm mạnh; đây không phải nút tăng tốc phổ quát.
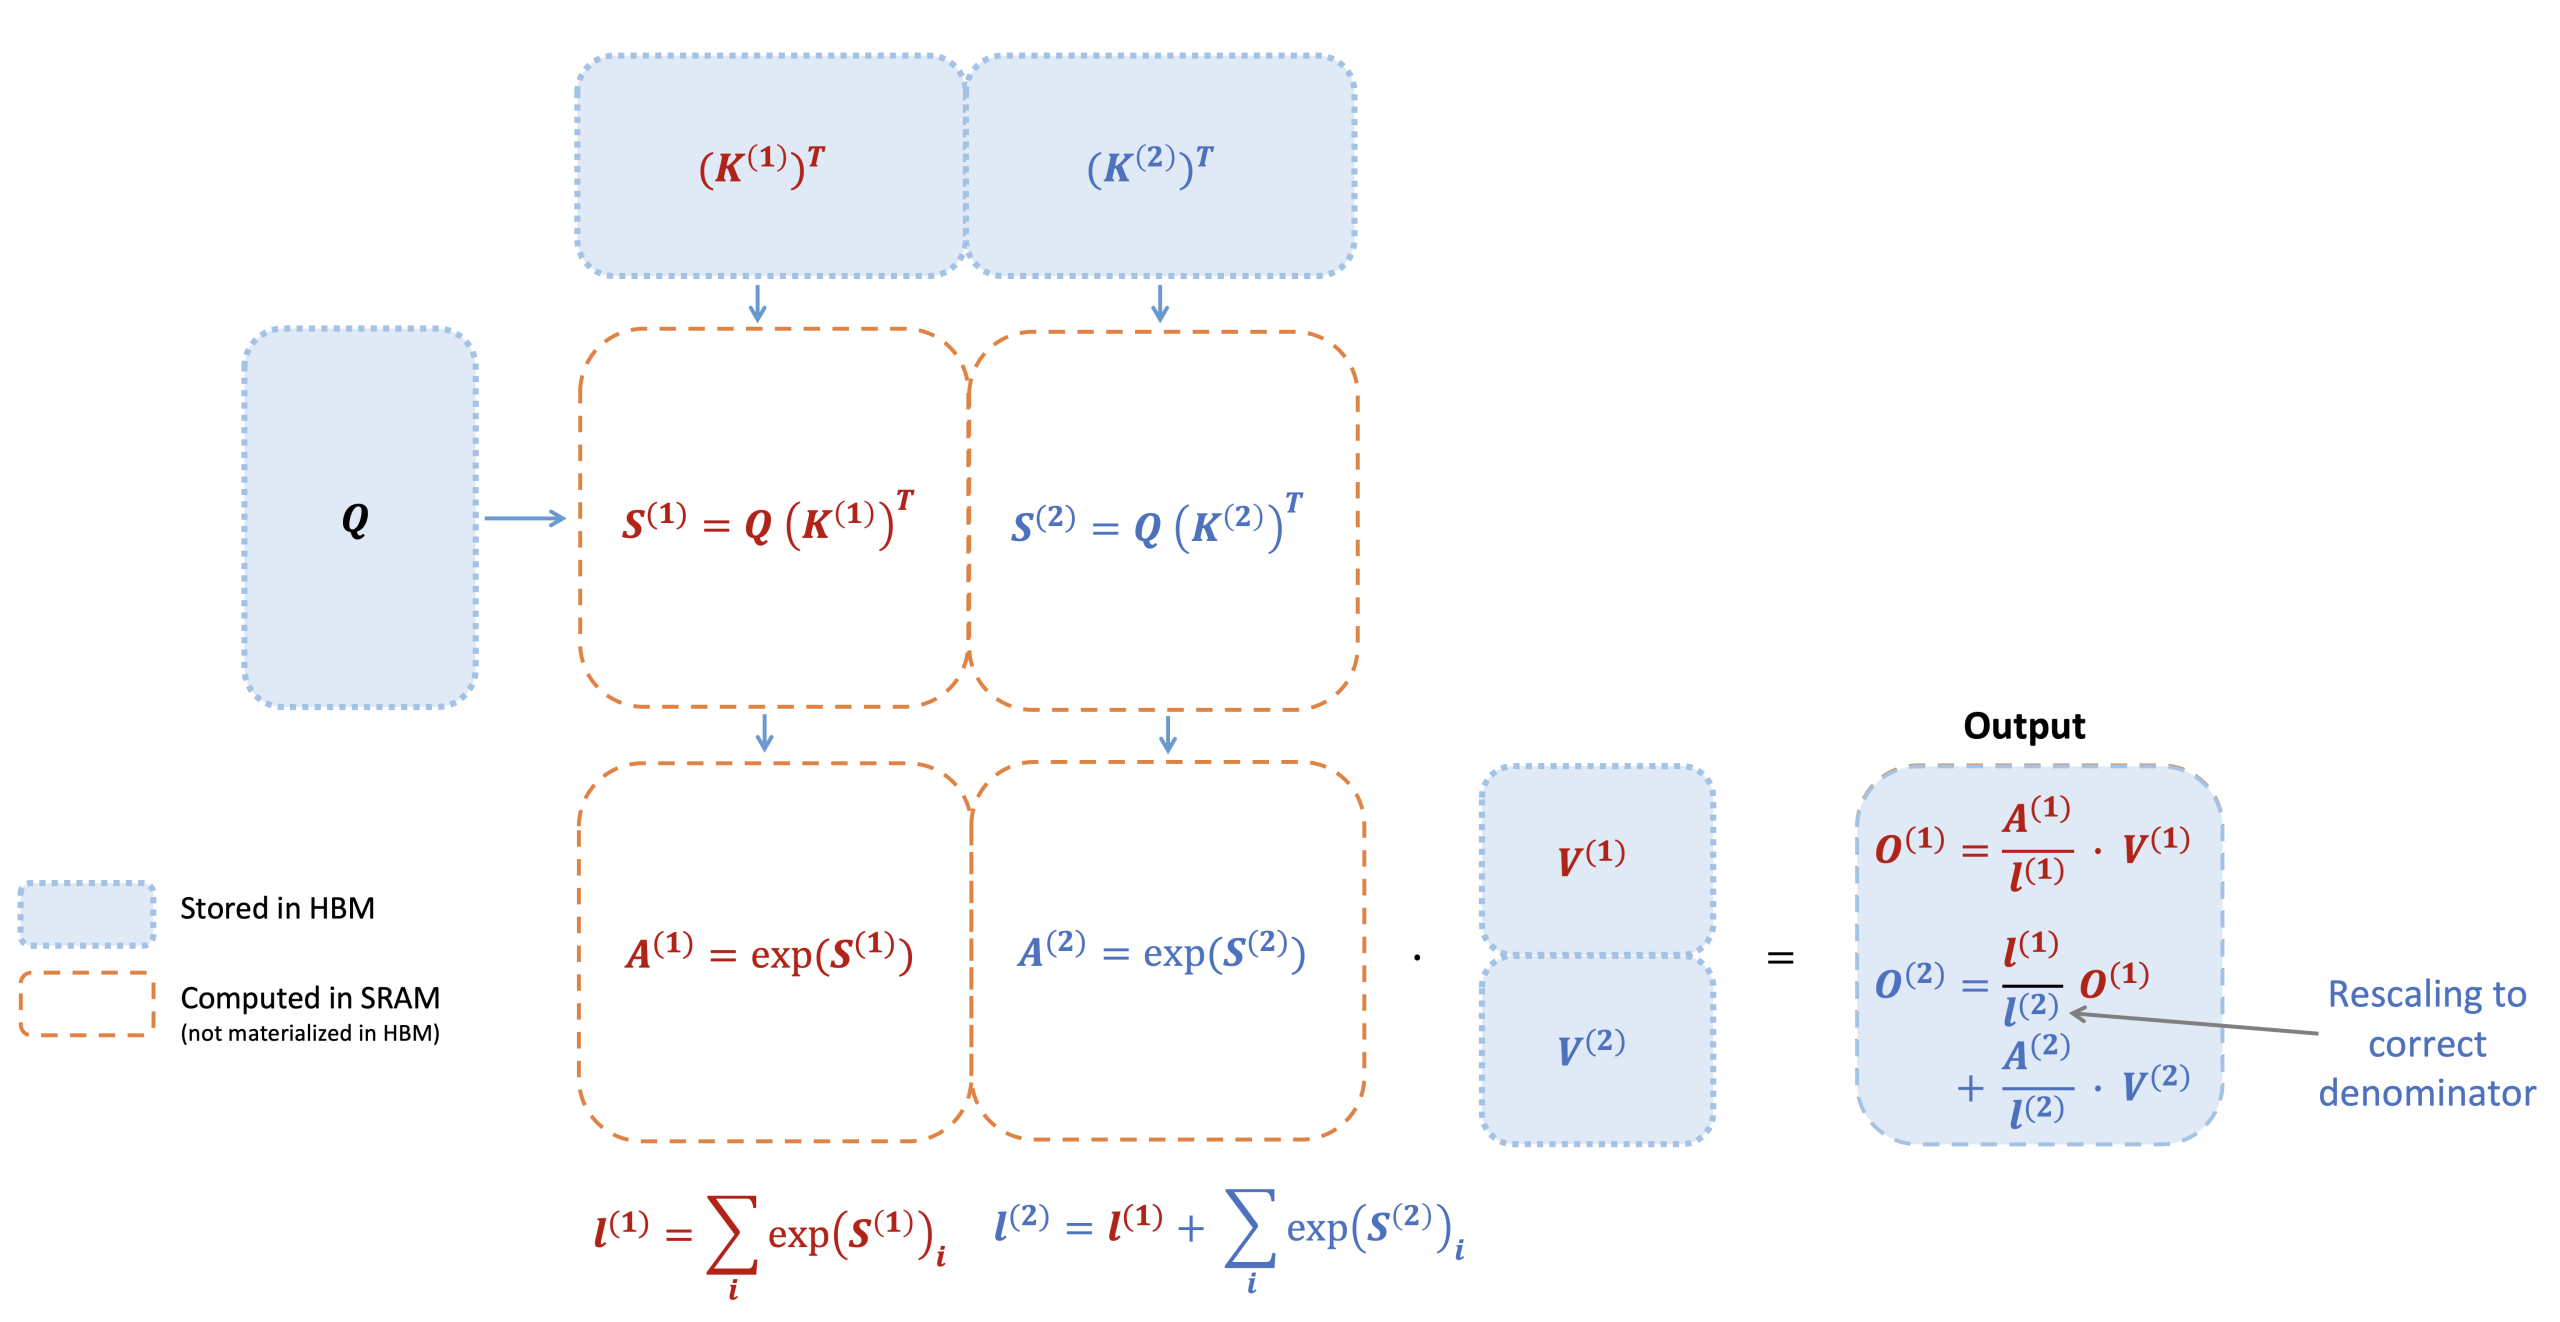
Kỹ thuật này khác với FlashAttention. FlashAttention tối ưu cách tính attention và di chuyển dữ liệu qua các tầng bộ nhớ, trong khi speculative decoding thay đổi cách đề xuất và xác minh token theo chuỗi. Hai hướng có thể nằm trong cùng một hệ thống nhưng giải quyết những nút thắt khác nhau.
Tách prefill và decode là bài toán phân bổ máy chủ, không phải mẹo cho mọi chatbot
Do prefill và decode có đặc tính tải khác nhau, một hướng nghiên cứu là đặt chúng trên những nhóm máy riêng. Splitwise đề xuất tách phần tính prompt khỏi phần sinh token để mỗi nhóm phần cứng được chọn theo kiểu công việc phù hợp. Đổi lại, hệ thống phải chuyển trạng thái giữa hai nhóm và điều phối tài nguyên; lợi ích phụ thuộc mạng kết nối, lưu lượng và cách triển khai.
Trong các trace, GPU và baseline được đánh giá, paper Splitwise báo cáo cụm thử nghiệm có thể đạt tới 1,4 lần throughput cao hơn với chi phí thấp hơn 20%, hoặc 2,35 lần throughput trong cùng ngân sách công suất và chi phí. Đây là các mức tối đa từ đánh giá của nghiên cứu, không phải dự báo cho mọi dịch vụ thương mại. Với chatbot sử dụng hàng ngày, tốc độ còn phụ thuộc độ dài prompt, mức tải đồng thời, giới hạn đầu ra và chính sách lập lịch mà nhà cung cấp lựa chọn.
Vì vậy, khi một chatbot trả lời chậm, chỉ nhìn tốc độ GPU hay số tham số mô hình sẽ bỏ sót phần còn lại của hệ thống. Thời gian chờ đầu tiên gắn nhiều với việc xử lý prompt; nhịp sinh tiếp theo chịu ảnh hưởng của decode, bộ nhớ và cách ghép request. Các tối ưu như cache theo block hay sinh dự đoán chỉ phát huy khi chúng trúng đúng nút thắt của workload.
Nguồn tham khảo: NVIDIA Developer Blog; Nghiên cứu PagedAttention và vLLM (SOSP ’23); Fast Inference from Transformers via Speculative Decoding; Splitwise; FlashAttention-2.