Tóm tắt nhanh
- Laptop agentic AI là máy chạy được phần lớn vòng lặp của agent, tức phần mềm tự lập kế hoạch, gọi công cụ và làm tiếp từng bước, ngay trên thiết bị thay vì gửi mọi lượt xử lý lên cloud.
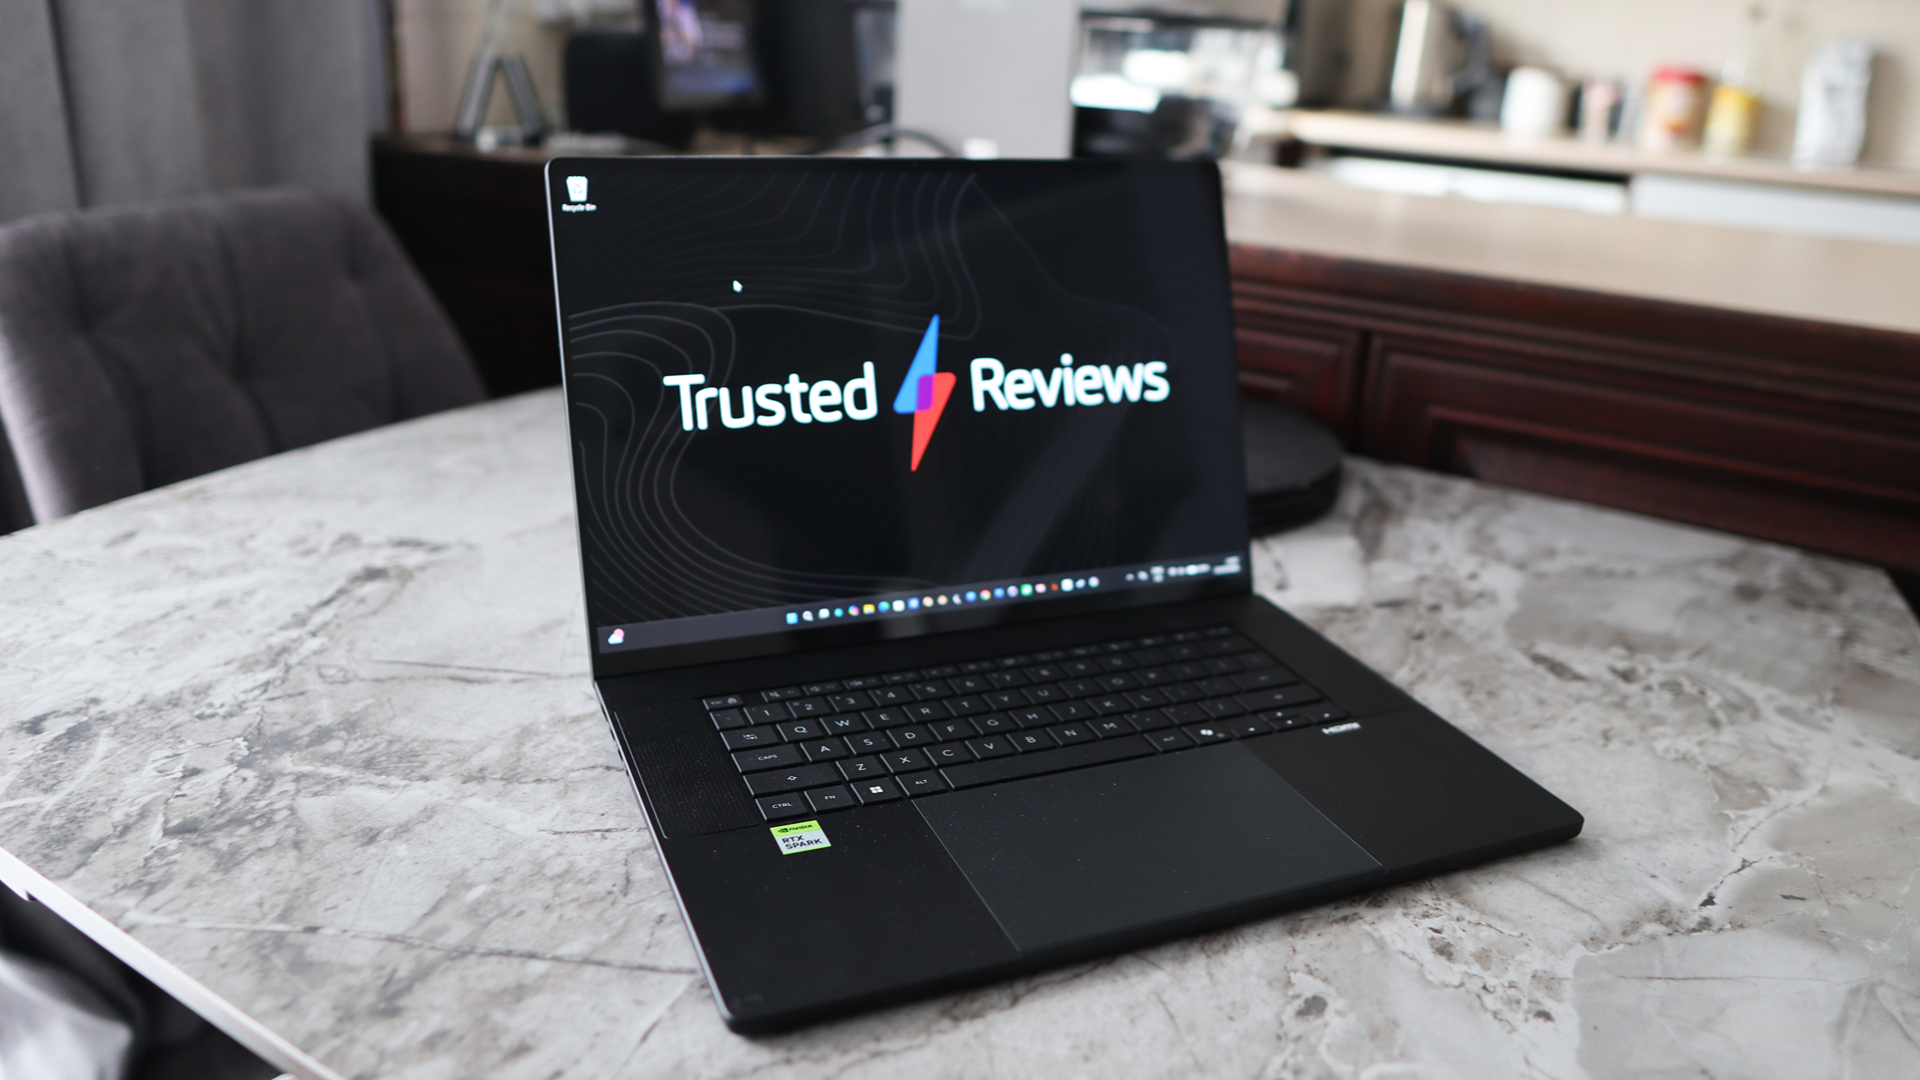
- ASUS ProArt P16 H7607 dùng SoC NVIDIA RTX Spark N1X, gộp CPU Grace 20 nhân và GPU Blackwell 6.144 nhân CUDA trong một vùng bộ nhớ hợp nhất tối đa 128GB.
- Trên bản 64GB, Trusted Reviews đo được 3.085 điểm đơn nhân và 19.313 điểm đa nhân trong Geekbench 6, cùng khoảng 54 token mỗi giây với Llama 3.1 8B.
- Giá ASUS Việt Nam được ghi nhận cho bản 128GB là 194,99 triệu đồng. Khoản đầu tư này chỉ hợp lý khi máy chạy AI đều đặn và có việc cụ thể cần mô hình lớn.
Cụm “agentic AI” xuất hiện dày đặc trong thông báo sản phẩm gần đây, nhưng ít khi được giải thích rõ nó khác chatbot ở chỗ nào. Chatbot nhận một câu hỏi và trả một câu trả lời. Agent nhận một mục tiêu, tự chia việc thành các bước, gọi công cụ như tìm kiếm tệp hoặc chạy một ứng dụng, rồi xem kết quả để quyết định bước tiếp theo. Nếu thiếu dữ kiện, agent có thể tiếp tục truy vấn; nếu công cụ trả lỗi, nó có thể thử cách khác. Vì vậy một yêu cầu tưởng như đơn giản đôi khi tạo ra nhiều lượt suy luận và thao tác, làm chi phí dịch vụ cloud tính theo token tăng theo số bước.
Laptop agentic AI không phải một loại máy được định nghĩa bằng việc gắn thêm NPU hay một nhãn mới. Điểm quan trọng là máy có đủ bộ nhớ và năng lực tính toán để giữ mô hình chạy được tại chỗ, đồng thời phần mềm có thể nối mô hình với các công cụ và dữ liệu mà người dùng cho phép. Mô hình tạo kế hoạch và quyết định hành động; agent runtime thực thi từng bước, còn quyền truy cập cần được giới hạn để nó không tự ý sửa hoặc gửi dữ liệu. Khi toàn bộ vòng lặp chạy cục bộ, tệp và prompt có thể ở lại trên máy, nhưng tốc độ và chất lượng vẫn phụ thuộc kích thước mô hình, lượng bộ nhớ còn trống, ứng dụng tương thích và cách cấp quyền.
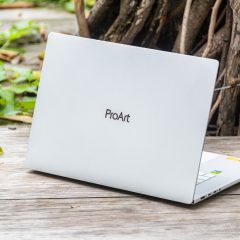
ProArt P16 H7607 của ASUS là một ví dụ hướng tới cách dùng đó: nền tảng NVIDIA RTX Spark kết hợp bộ nhớ hợp nhất dung lượng lớn với phần mềm agent như Hermes. Cấu hình phần cứng giúp chạy mô hình tại máy; nó không tự động biến mọi tác vụ thành agentic AI, cũng không loại bỏ nhu cầu kiểm tra kết quả do agent tạo ra.
ProArt P16 đổi GPU rời lấy SoC, bộ nhớ dùng chung
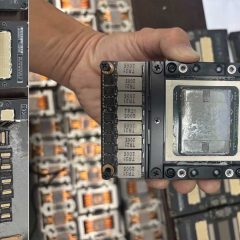
Laptop creator truyền thống đặt CPU và GPU rời nhau, mỗi bên có vùng bộ nhớ riêng. RTX Spark N1X làm khác: CPU Grace và GPU Blackwell nằm trong cùng một gói chip, kết nối bằng NVLink-C2C và dùng chung một vùng bộ nhớ hợp nhất. Cấu hình này có CPU 20 nhân gồm 10 nhân Cortex-X925 hiệu năng cao và 10 nhân Cortex-A725 tiết kiệm điện, còn TDP có thể điều chỉnh từ 45W đến 80W tùy thiết bị.
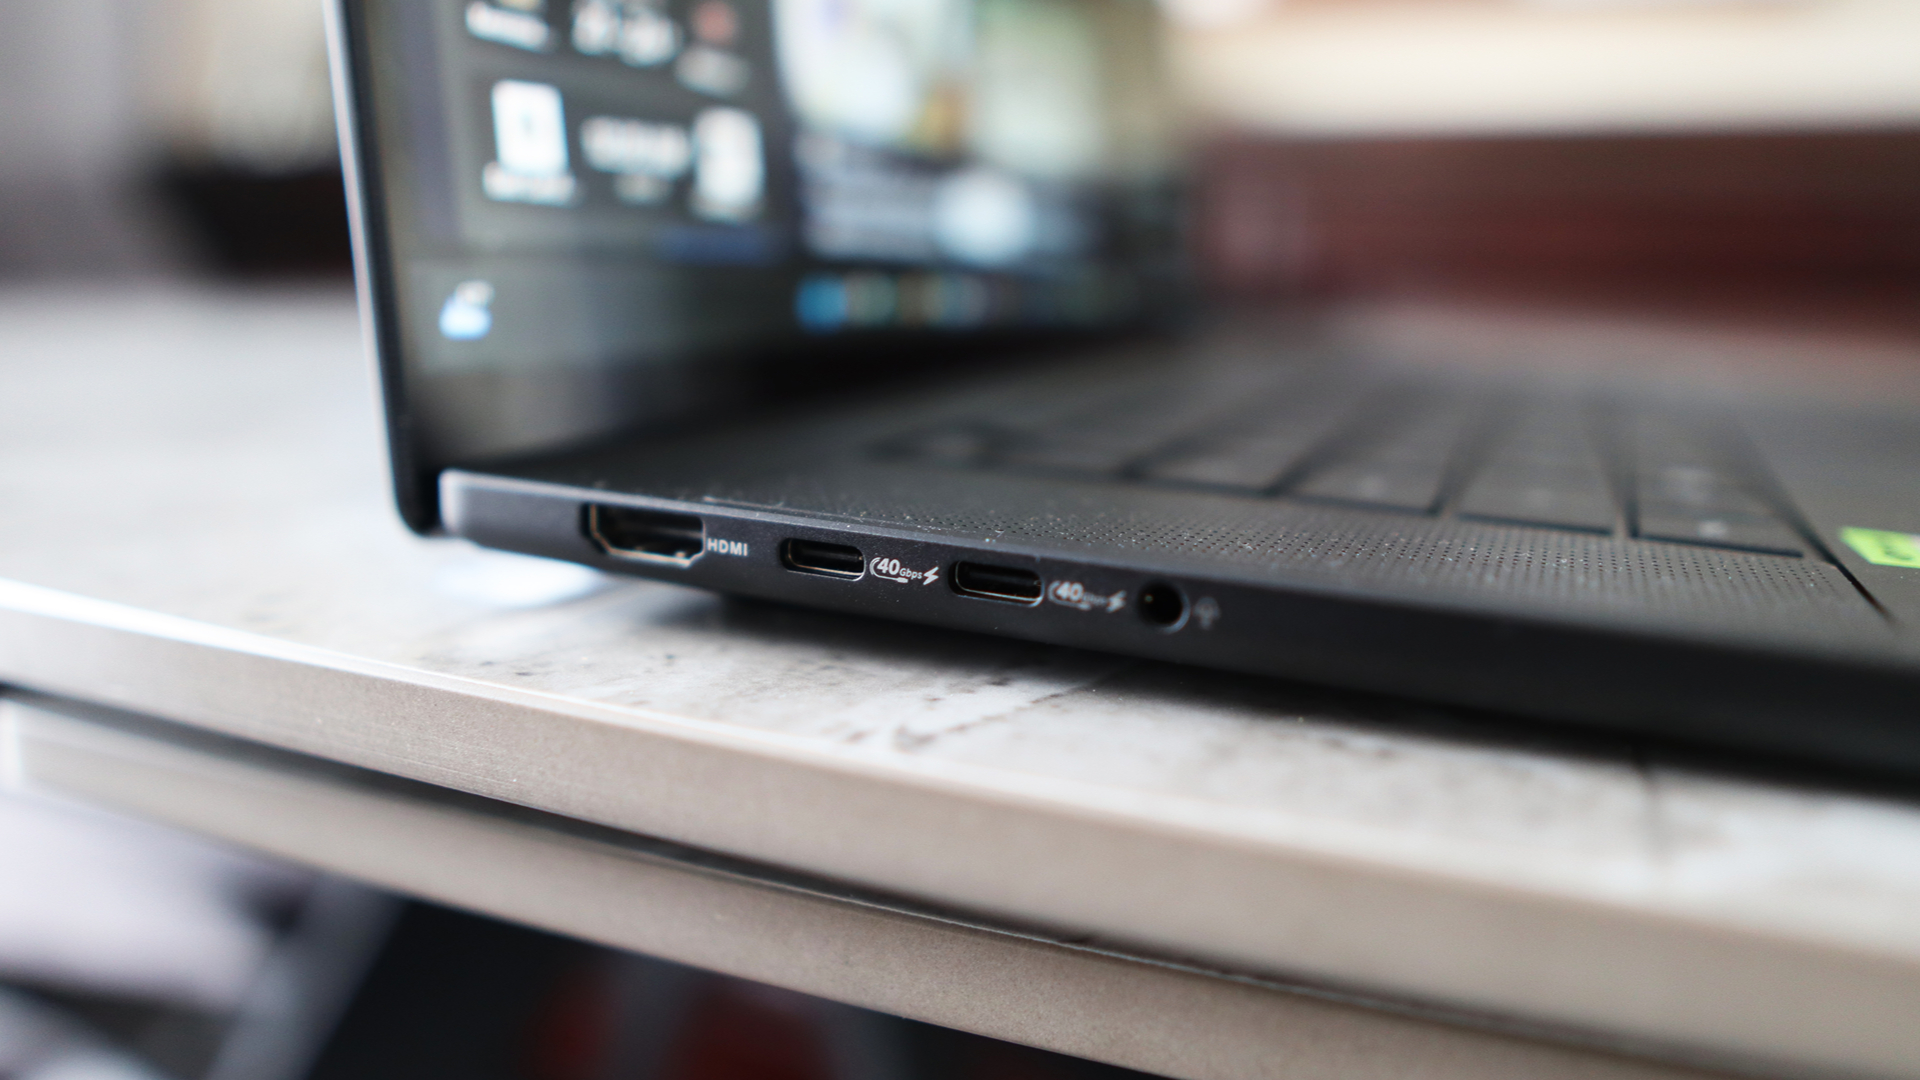
Lợi ích của cách làm này là dung lượng không bị tách thành “RAM cho hệ thống” và “VRAM cho GPU” như máy có card rời. Nhưng 128GB không có nghĩa là toàn bộ dung lượng dành riêng cho mô hình. Vùng nhớ vẫn được chia với hệ điều hành, ứng dụng và các tiến trình khác. Con số 128GB vì vậy mở ra nhóm mô hình lớn hơn, chứ không tự bảo đảm mọi mô hình đều chạy nhanh.
ASUS đưa ra hướng dẫn theo nhóm bộ nhớ: mô hình 7B đến 14B tham số cho cấu hình 24/32GB, 24B đến 35B cho 48/64GB, còn 70B đến 120B cần 128GB. Hãng cũng nêu ngữ cảnh 1 triệu token cho cấu hình cao nhất. Đây là con số của nhà sản xuất, và kết quả thực tế còn phụ thuộc kiến trúc mô hình, cách lượng tử hóa và độ dài ngữ cảnh.
Benchmark: con số nào nói được điều gì?
Trusted Reviews thử bản 64GB RAM với SSD 1TB. Ở chế độ Balanced, máy đạt 3.085 điểm đơn nhân và 19.313 điểm đa nhân trong Geekbench 6. Trong 3DMark Time Spy, máy đạt 11.763 điểm, trong khi ProArt PX13 GoPro Edition dùng Ryzen AI Max+ 395 đạt 9.569 điểm trong cùng bài thử. Đồ họa tích hợp của N1X vì vậy đủ mạnh để vượt nhiều laptop mỏng, nhưng vẫn chưa thay được GPU rời mạnh trong mọi trường hợp.
| Phép thử | Kết quả ProArt P16 | Ghi chú |
|---|---|---|
| Geekbench 6, đơn nhân (cao hơn tốt hơn) | 3.085 | Chế độ Balanced |
| Geekbench 6, đa nhân (cao hơn tốt hơn) | 19.313 | Chế độ Balanced |
| 3DMark Time Spy (cao hơn tốt hơn) | 11.763 | ProArt PX13 GoPro Edition: 9.569 |
| Cyberpunk 2077, 1080p (cao hơn tốt hơn) | 69,73 fps | Trung bình |
| Returnal, 1080p (cao hơn tốt hơn) | 62 fps | Trung bình |
| Cyberpunk 2077, ray tracing Ultra, độ phân giải gốc 2880×1800 (cao hơn tốt hơn) | 15,31 fps | Trung bình |
| Llama 3.1 8B, Windows ML / llama.cpp (cao hơn tốt hơn) | 54,3 / 53,7 token/giây | Chạy trên GPU |
| Phi 4 Mini, Windows ML / llama.cpp (cao hơn tốt hơn) | 99,2 / 86,3 token/giây | Mô hình nhỏ hơn |
| SWE Agent với Llama, Windows ML / llama.cpp (thấp hơn tốt hơn) | 58,6 giây / 47,7 giây | Thời gian hoàn thành tác vụ |
| Pin, video 1080p ở 150 nit (cao hơn tốt hơn) | 13 giờ 55 phút | Pin 99,9Wh, một lần đo |
Số liệu: Trusted Reviews, bản đánh giá đăng ngày 16/10/2026.
Phép đo đáng chú ý nhất với người chạy agent là chạy mô hình. Llama 3.1 8B cho tốc độ gần như ngang nhau trên Windows ML và llama.cpp, nên người dùng không bị buộc phải chọn một bộ chạy chỉ vì tốc độ. Tuy vậy, đây là mô hình 8B trên cấu hình 64GB. Không nên lấy con số đó để suy ra tốc độ của mô hình 70B hay 120B, vì mô hình càng lớn thì mỗi token càng phải đọc nhiều dữ liệu từ bộ nhớ.
Phần chơi game thì cho thấy giới hạn. Cùng bài thử, máy hơi chậm hơn một laptop có RTX 5070 rời. Với ray tracing ở độ phân giải gốc, tốc độ khung hình rơi xuống dưới 16 fps, nên người mua cần GPU rời mạnh cho game và render nặng vẫn nên so trực tiếp với các máy đó.
Agent chạy cục bộ giảm phí biến đổi, không xóa chi phí vận hành
NVIDIA đưa ra một phép so sánh chi phí, và bài đánh giá có nhắc lại: chạy 61 triệu token đầu ra mỗi tháng bằng Claude Sonnet 5.5 Medium tốn khoảng 1.200 USD phí API, còn cùng khối lượng với Qwen 3.8 Flash Next trên RTX Spark chỉ tốn khoảng 20 USD tiền điện. Đây là phép tính cho một model, một khối lượng và một bộ giả định cụ thể. Nó giải thích vì sao người chạy agent liên tục quan tâm đến chi phí cố định, nhưng chưa phải bằng chứng cho mọi trường hợp.
Chi phí thường bị bỏ quên ở hai chỗ. Thứ nhất là giá máy, vốn lớn hơn nhiều so với laptop văn phòng. Thứ hai là chất lượng đầu ra: mô hình chạy tại máy có thể kém mô hình cloud ở tác vụ khó, và người dùng vẫn phải kiểm tra kết quả. Một agent rẻ về tiền điện nhưng sai ở bước quan trọng vẫn tốn chi phí thật.
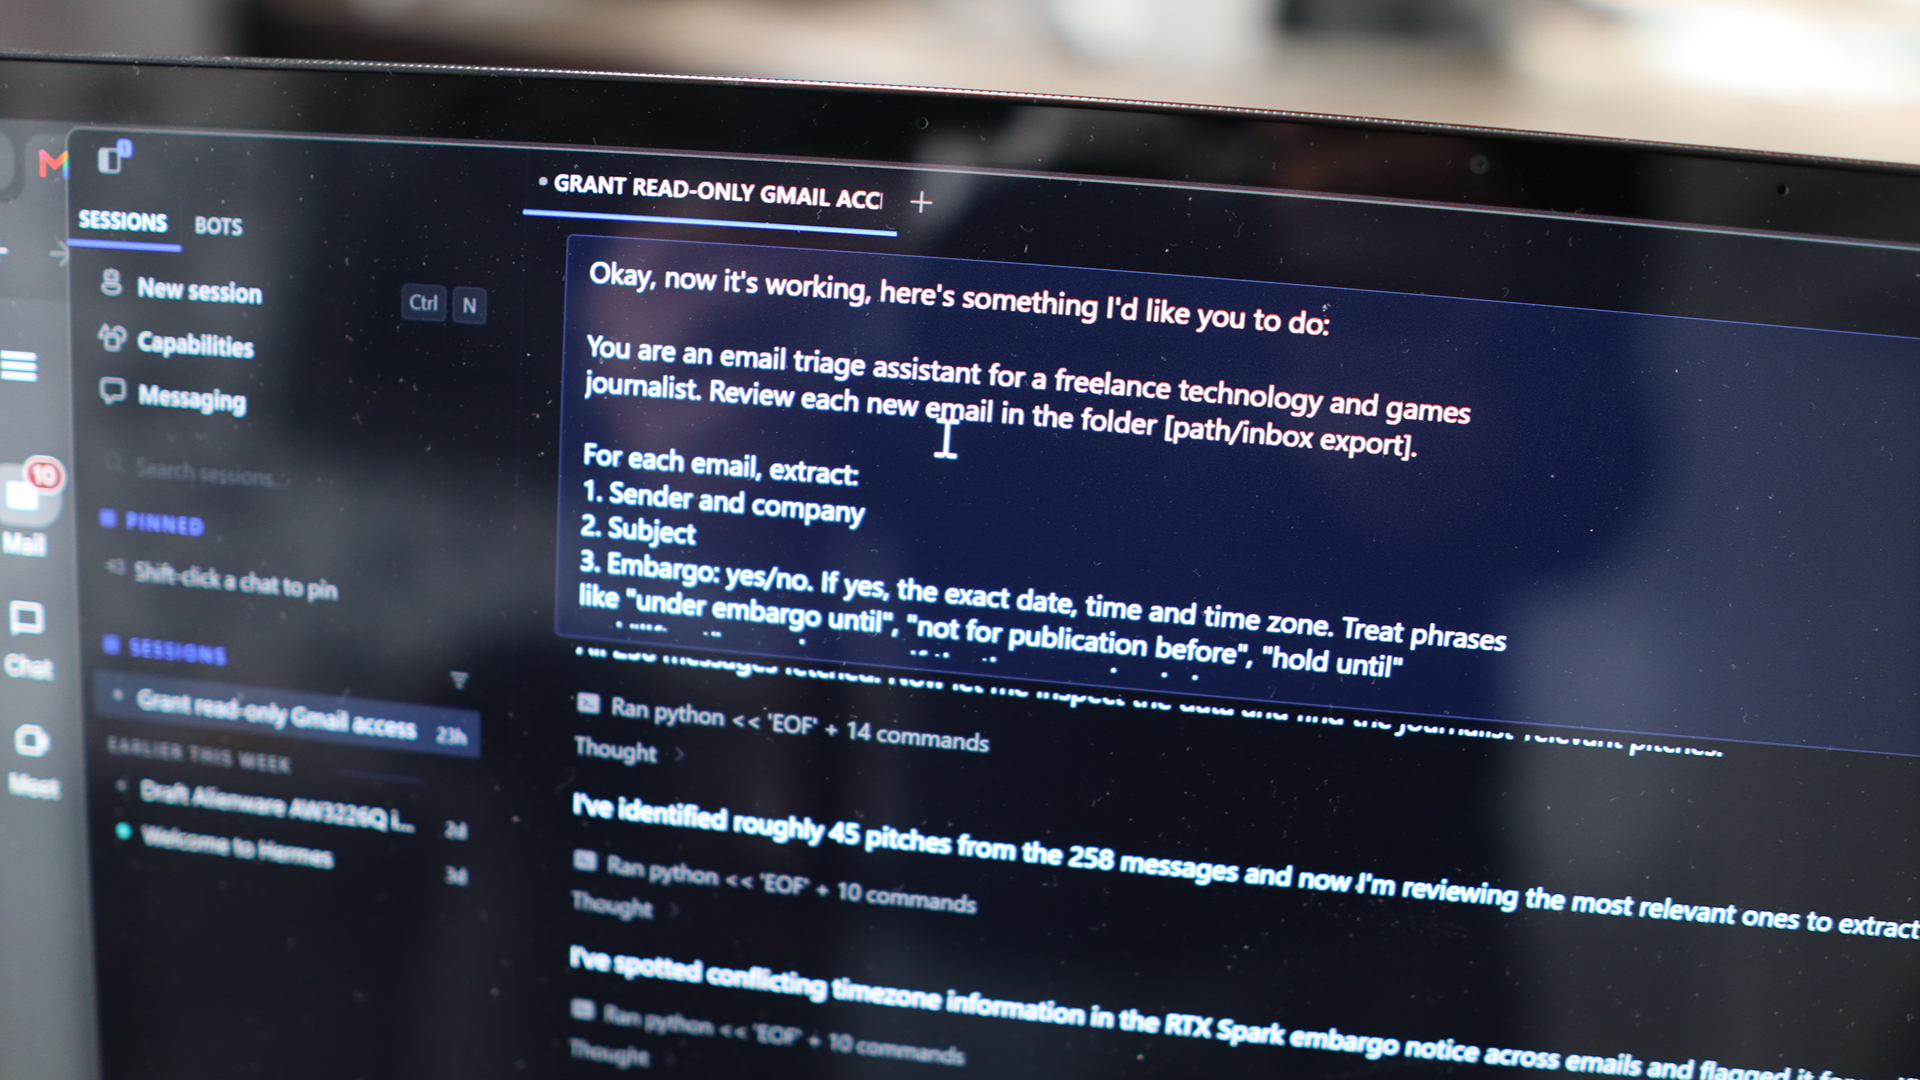
Một thử nghiệm agent được ghi lại trong bài đánh giá cho thấy rõ điều này. Agent Hermes được cấp quyền chỉ đọc hộp thư Gmail để phân loại thư chào hàng và đánh dấu những thư đáng chú ý. Ví dụ này minh họa loại việc agent có thể tự xử lý, nhưng tốc độ còn phụ thuộc mô hình, cách tích hợp và số bước cần làm.
Dữ liệu ở máy vẫn cần quyền truy cập được kiểm soát
Lợi thế về quyền riêng tư của máy cục bộ là có thật. Tệp, prompt và dữ liệu dự án có thể nằm trên thiết bị nếu quy trình không gọi dịch vụ bên ngoài. Nhưng cần tách hai ý. Chạy mô hình tại máy giảm việc gửi dữ liệu đi, còn an toàn của cả hệ thống phụ thuộc vào quyền mà agent được cấp. Một agent đọc được hộp thư, chạy lệnh hoặc kết nối API vẫn có thể làm lộ dữ liệu nếu cấu hình sai hoặc tích hợp bị khai thác.
Cơ chế Microsoft Execution Containers được mô tả là cấp cho mỗi agent một vùng chạy riêng, với giới hạn do hệ điều hành áp đặt. Đây là hướng đi đáng theo dõi. Tuy vậy, việc chọn công cụ nào được kết nối và quyền nào được cấp vẫn thuộc về người dùng.
Giá gần 195 triệu đồng: 128GB chỉ đáng khi có việc cần nó
Theo ghi nhận giá từ ASUS Việt Nam vào ngày 19/10/2026, ProArt P16 H7607 có mức giá từ 119,9 triệu đồng cho cấu hình thấp hơn và 194,99 triệu đồng cho bản 128GB. Mức giá chênh lệch lớn giữa các cấu hình khiến dung lượng bộ nhớ trở thành yếu tố cần cân nhắc theo đúng công việc, thay vì chọn bản cao nhất chỉ để có thông số tối đa.
Ai nên cân nhắc? Người chủ yếu hỏi đáp, thỉnh thoảng tóm tắt tài liệu hoặc cần card rời mạnh cho dựng video và game sẽ thấy dịch vụ cloud trả theo mức dùng dễ chịu hơn ở thời điểm đầu. Ngược lại, người chạy agent nhiều giờ mỗi ngày, cần giữ dữ liệu trên máy và đã có quy trình tương thích sẽ thấy khoản đầu tư có lý hơn. Chọn bản 128GB chỉ vì con số “120 tỷ tham số” trên trang quảng cáo là quyết định thiếu căn cứ khi chưa có tác vụ cụ thể cần chạy.
Những điểm còn chưa rõ
- Con số 1 petaflop AI là của NVIDIA, đo ở độ chính xác FP4 trên Tensor Core thế hệ thứ năm. Không phải thước đo chung cho mọi tác vụ.
- Các phép thử của Trusted Reviews chạy trên một mẫu 64GB. Chưa có số đo độc lập cho bản 128GB, và chưa rõ tốc độ mô hình 70B đến 120B trên máy.
- Giá niêm yết tại Việt Nam có thể thay đổi theo cấu hình và thời điểm, nên cần kiểm lại trước khi mua.
Kết luận
Laptop agentic AI không phải một nhãn chứng nhận mới cho mọi máy có NPU. Nó mô tả cách ghép mô hình, bộ nhớ, quyền truy cập và phần mềm để agent tự chia việc rồi thao tác qua công cụ. ProArt P16 cho thấy cách làm này khả thi trên một laptop mỏng, nhưng câu hỏi với từng người mua vẫn là khối lượng việc thực tế có đủ lớn để biện minh cho chi phí hay không.
Nguồn tham khảo: ASUS Pressroom, ASUS ProArt RTX Spark, Trusted Reviews, ASUS Việt Nam