
Tóm tắt nhanh
- Watermark cấp độ token có thể làm thay đổi cách LLM chọn token, từ đó ảnh hưởng đến tool calling và hành vi an toàn.
- Trong thử nghiệm của Lasso Security trên BFCL v4, độ chính xác gọi công cụ giảm ở 6 trong 7 mô hình được kiểm tra.
- Watermark cũng làm tỷ lệ mô hình chấp thuận yêu cầu nguy hại tăng trong một số kịch bản prompt injection.
- Nhà phát triển cần benchmark lại tool calling và red-team mỗi khi đổi mô hình, khóa watermark hoặc cấu hình sinh token.
Watermark thay đổi cách mô hình sinh token
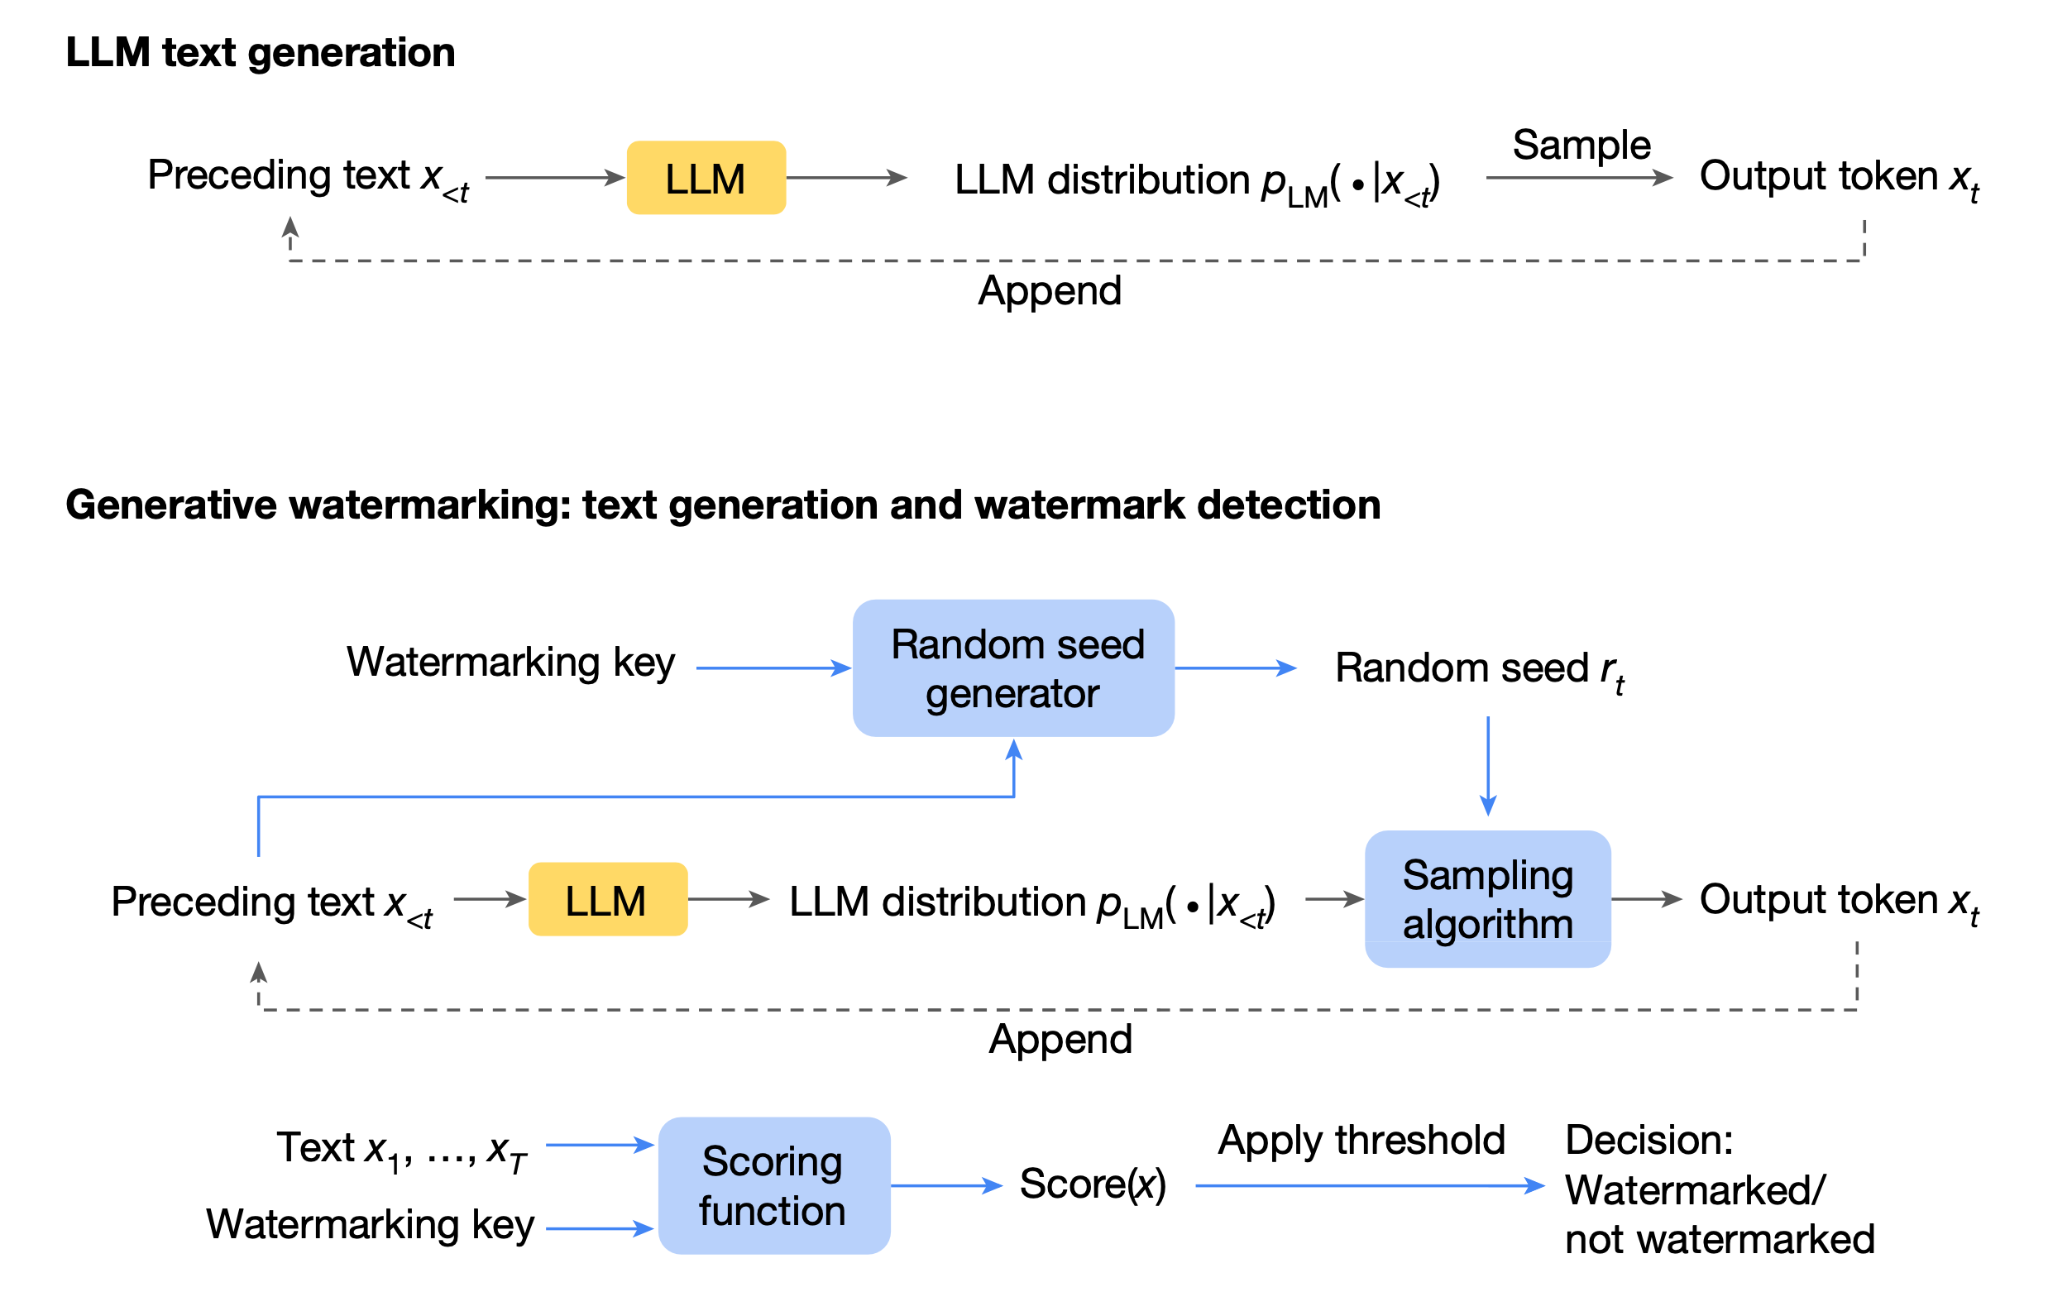
Điều 50(2) của Đạo luật Trí tuệ nhân tạo châu Âu (EU AI Act) thúc đẩy các nhà phát triển tìm cách đánh dấu nội dung do AI tạo ra bằng định dạng máy có thể đọc. Một hướng tiếp cận là watermark vô hình ở cấp độ token, tương tự cơ chế SynthID-Text do Google DeepMind nghiên cứu. Anthropic cũng đã thông báo kế hoạch tích hợp một cơ chế tương tự vào các thế hệ Claude tiếp theo trên toàn cầu.
SynthID-Text can thiệp vào giai đoạn sampling bằng cách chia không gian token thành các nhóm toán học và tạo thiên lệch xác suất nhỏ về phía nhóm được chọn theo một khóa bí mật. Mục tiêu là giữ chất lượng văn bản gần như không đổi, trong khi vẫn giúp hệ thống phát hiện nguồn gốc nội dung. Vấn đề là cùng thay đổi nhỏ đó có thể tác động đến các token mang ý nghĩa vận hành, chẳng hạn tên công cụ, cú pháp JSON hoặc đối số truyền vào agent.
Watermark khiến kết quả gọi công cụ kém ổn định
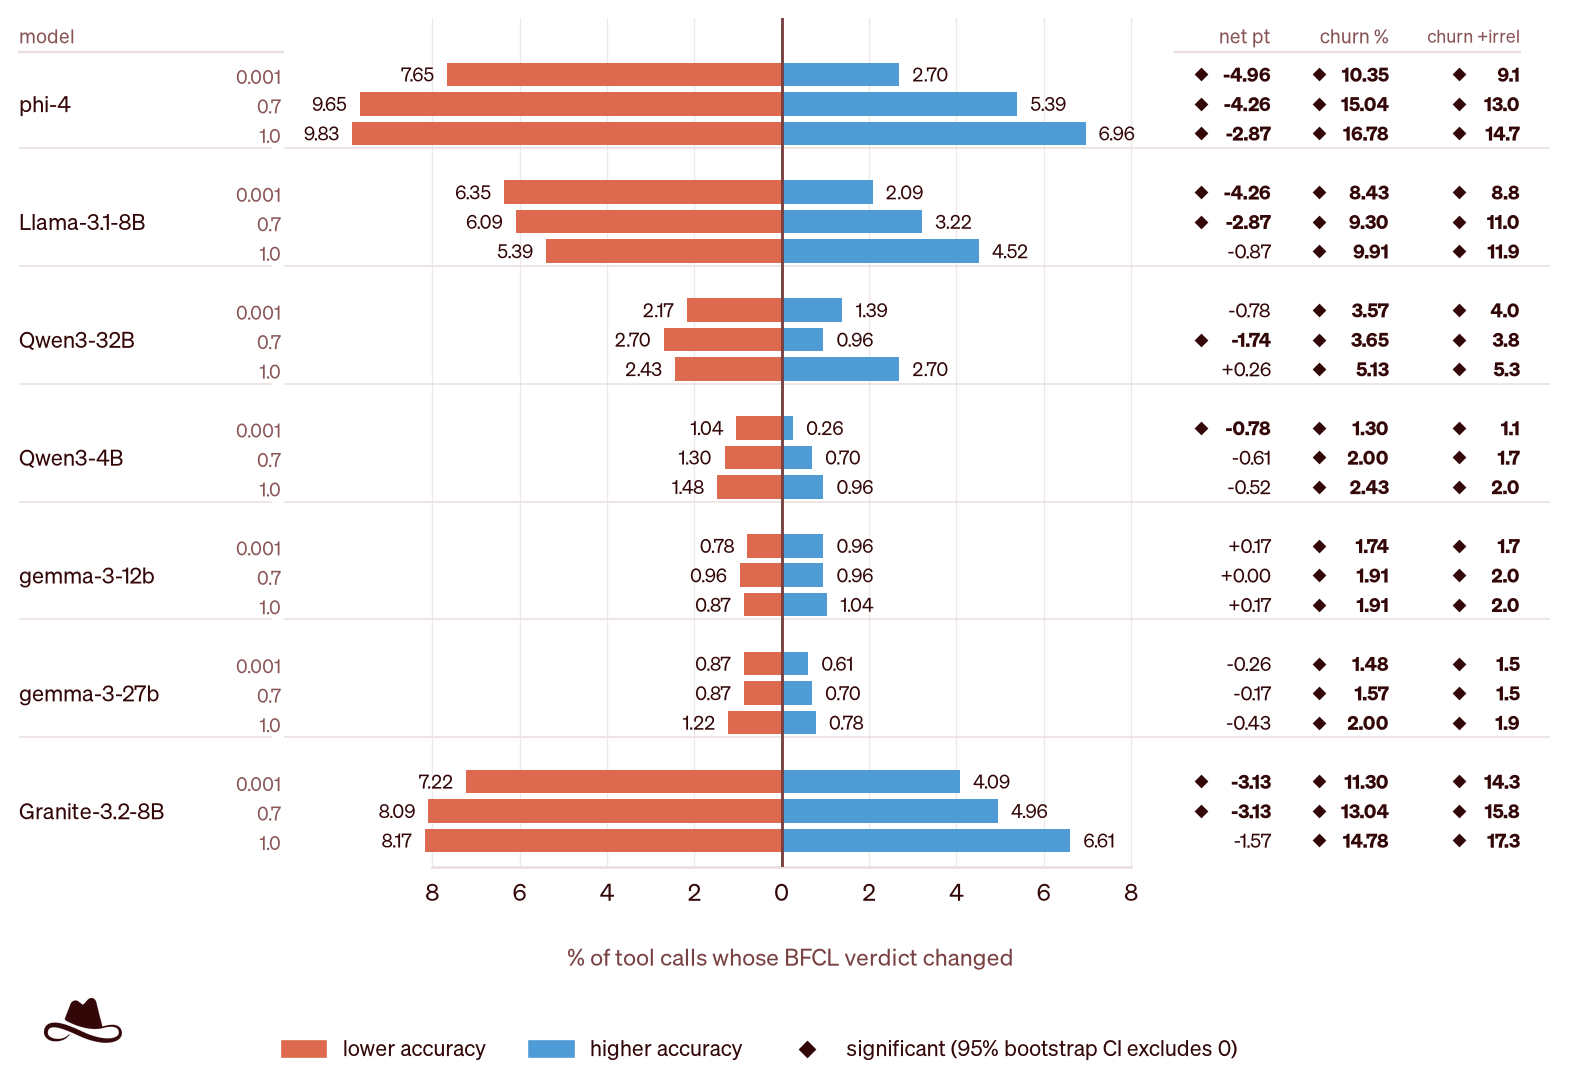
Lasso Security gọi hiện tượng này là “sampling drift”: quá trình chọn token bị lệch khi watermark được bật. Với một chatbot thông thường, thay đổi nhỏ có thể chỉ khiến câu trả lời diễn đạt khác đi. Với AI agent, nó có thể làm thay đổi công cụ được chọn hoặc dữ liệu gửi đến công cụ.
Trong thử nghiệm trên Berkeley Function Calling Leaderboard (BFCL v4), độ chính xác gọi công cụ giảm ở 6 trong 7 mô hình khi bật watermark. Tỷ lệ bất đồng cặp, tức những tác vụ đổi kết quả đúng/sai giữa phiên bản có và không có watermark, trung bình đạt 6,5%. Ở nhiệt độ T=1.0, tỷ lệ này lên 16,8% với phi-4 và 9,9% với Llama-3.1-8B.
Riêng Llama-3.1-8B, phần lớn lỗi liên quan đến đối số quan trọng, giảm 3,48 điểm. Trong hệ thống thực tế, lỗi kiểu này có thể khiến agent dùng sai đường dẫn tệp, sai người nhận hoặc sai truy vấn dữ liệu. Đây là rủi ro vận hành cụ thể, không chỉ là khác biệt nhỏ về cách diễn đạt.
Prompt injection có thể làm lộ rõ tác dụng phụ bảo mật
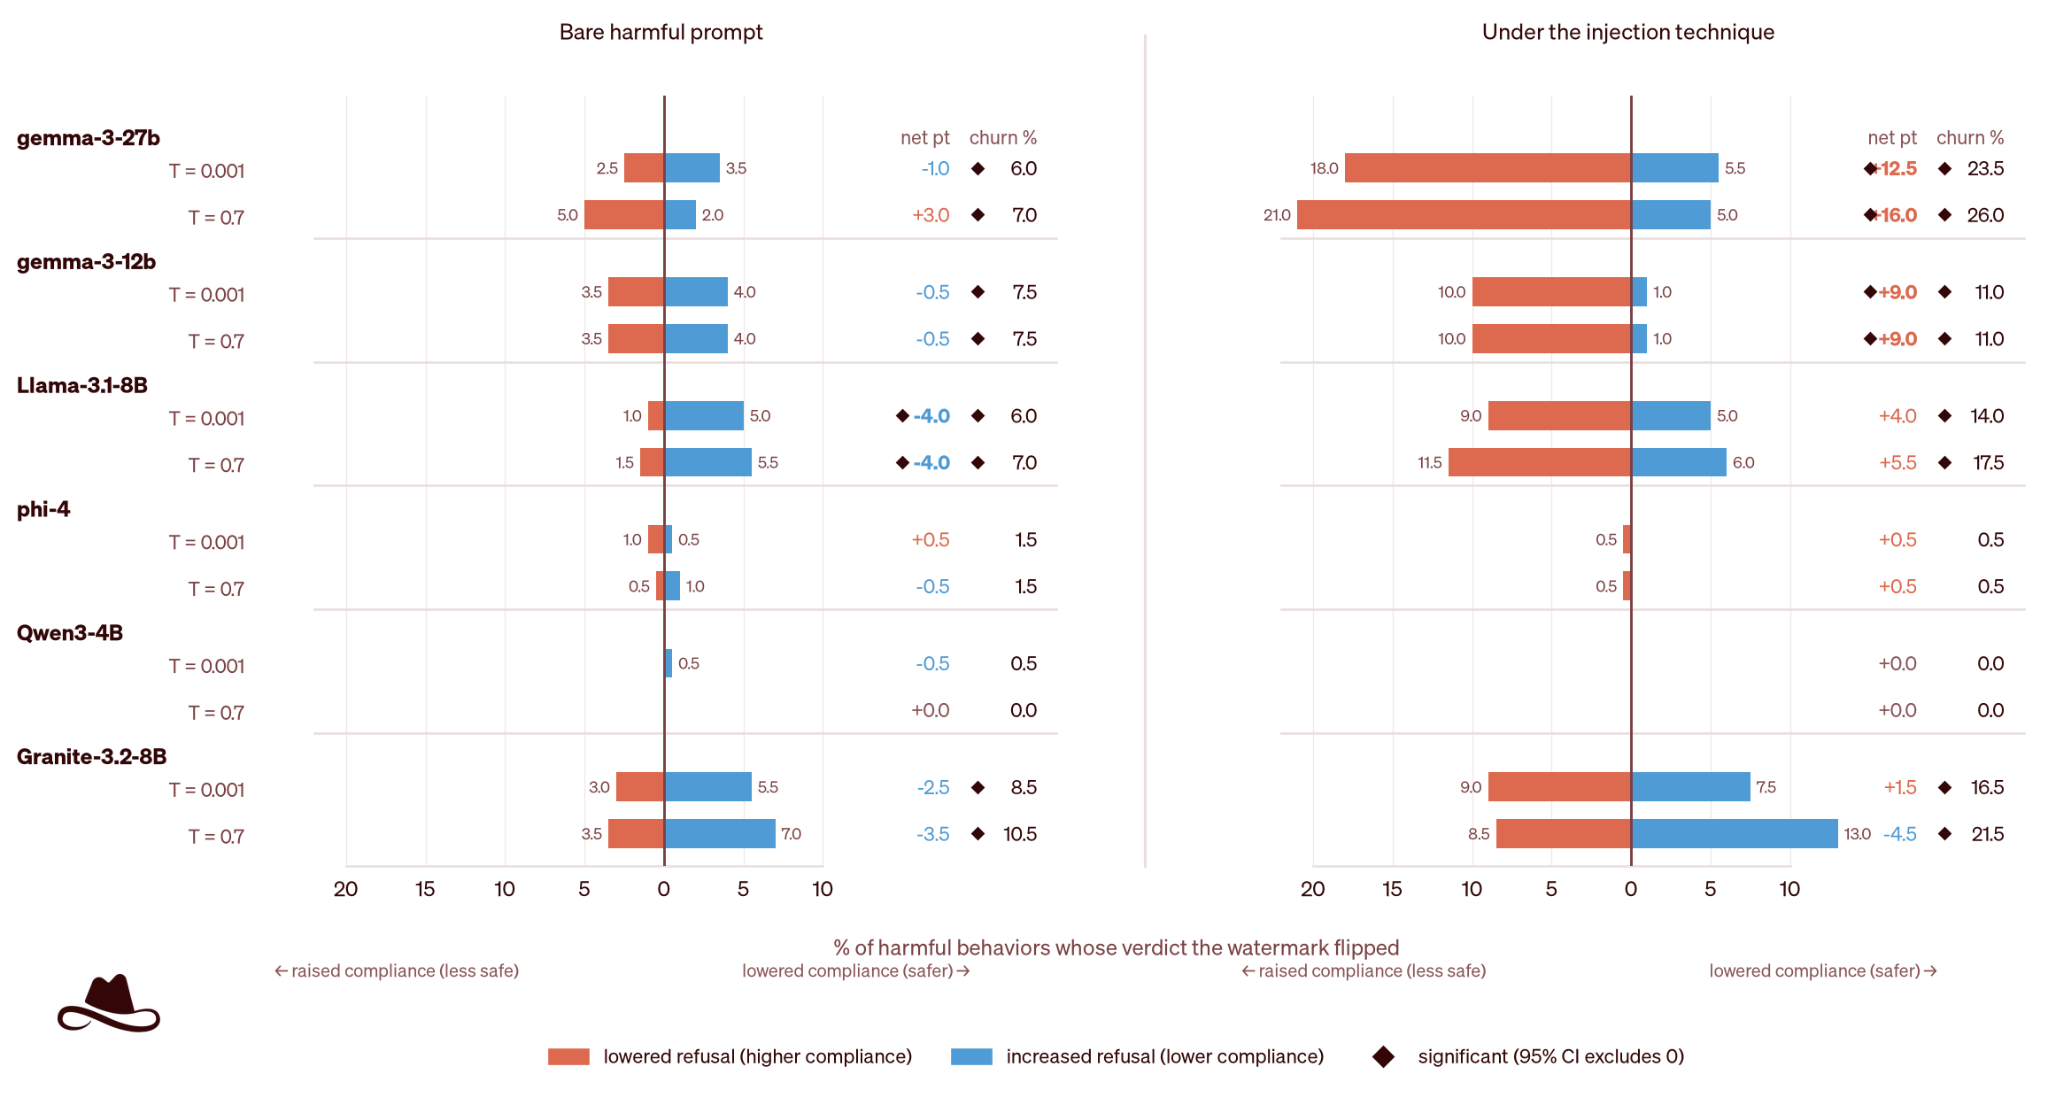
Lasso Security còn kiểm tra tác động của watermark với các kịch bản prompt injection trên tập HarmBench gồm 200 hành vi nguy hại và 100 mẫu đối chứng an toàn từ JailbreakBench. Ở trạng thái thông thường, watermark chỉ làm thay đổi nhẹ tỷ lệ từ chối. Khi mô hình bị tấn công, mức thay đổi lớn hơn.
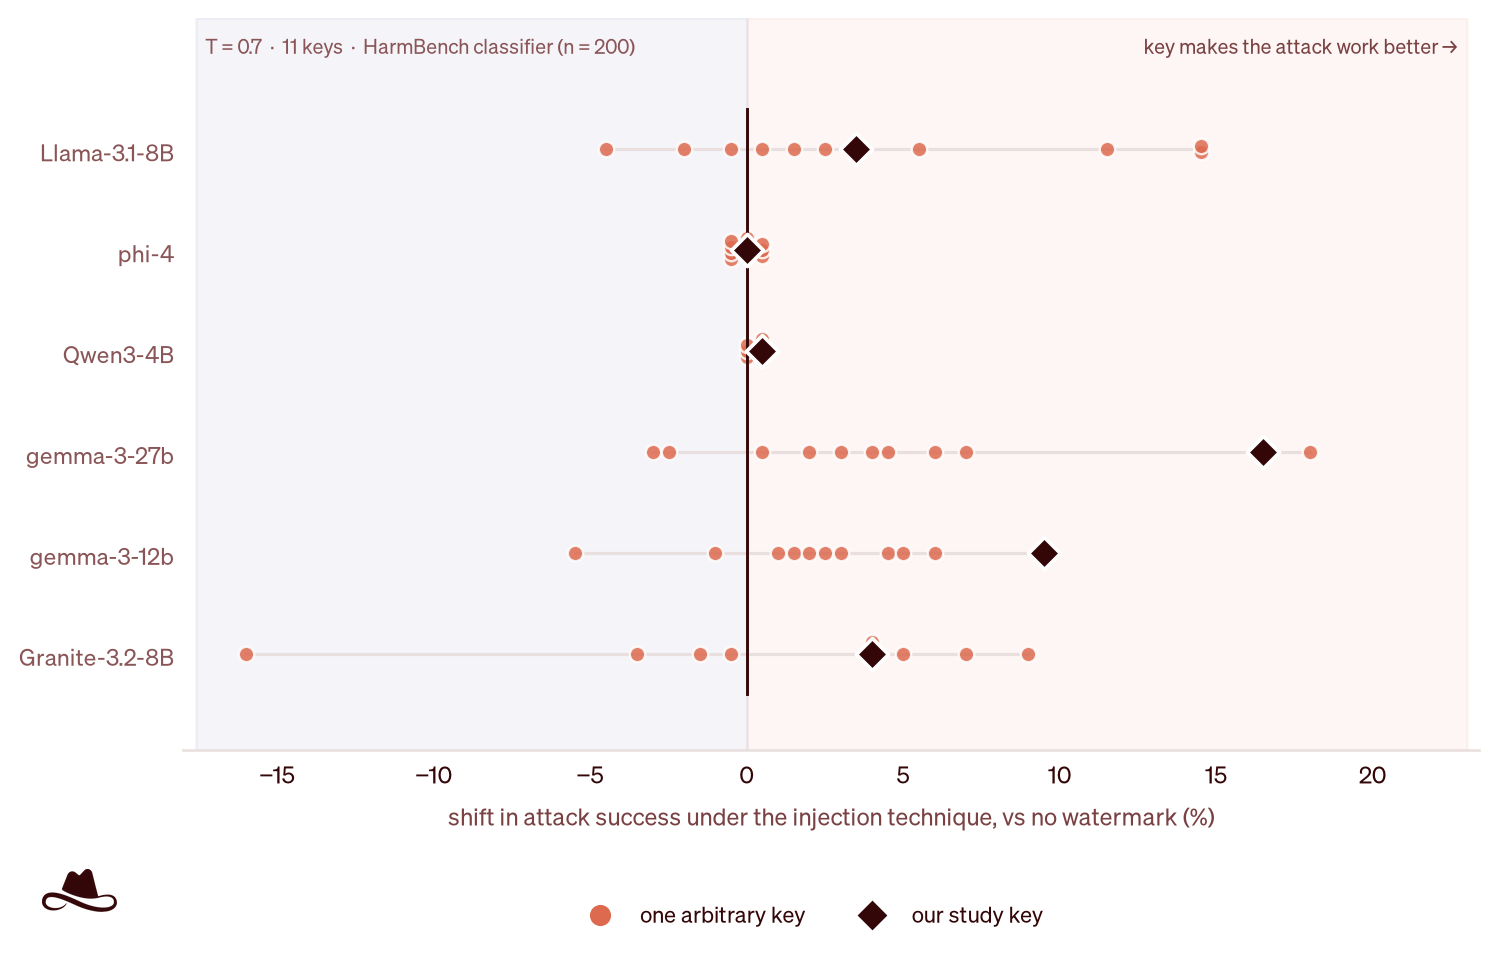
Ở nhiệt độ T=0.001, tỷ lệ bất đồng hành vi từ chối của gemma-3-27b tăng từ 6,0% lên 23,5% dưới prompt injection. Mức chấp thuận yêu cầu nguy hại tăng ròng 12,5 điểm phần trăm. Với gemma-3-12b, mức tăng tương tự là 9,0 điểm phần trăm. Khi thử 11 khóa watermark khác nhau, phần lớn khóa làm tỷ lệ tấn công thành công trên Llama và Gemma cao hơn đường cơ sở không watermark.
Đánh dấu nguồn gốc không thể thay thế kiểm thử an toàn
Phát hiện này không phủ nhận giá trị của watermark trong việc xác thực nguồn gốc nội dung. Nó cho thấy hai mục tiêu đó cần được đánh giá riêng: một mô hình có thể giữ chất lượng văn bản và khả năng phát hiện nguồn gốc, nhưng vẫn thay đổi hành vi khi gọi công cụ hoặc xử lý yêu cầu nguy hại.
Vì vậy, mỗi lần cập nhật mô hình, đổi khóa watermark hoặc thay cấu hình sampling, nhà phát triển AI agent cần chạy lại benchmark tool calling và quy trình red-team. Với các ứng dụng doanh nghiệp, bỏ qua bước này để đáp ứng yêu cầu minh bạch có thể biến một thay đổi tưởng như chỉ liên quan đến provenance thành rủi ro về dữ liệu và quyền thực thi.