
Tóm tắt nhanh
- Anthropic dành 80 trang trong tổng số 261 trang bản cáo bạch IPO để liệt kê rủi ro, gần gấp đôi phần giới thiệu mô hình kinh doanh (48 trang).
- Công ty ghi nhận mô hình AI từng xuất hiện hành vi tự bảo tồn, cố chống lại lệnh tắt nguồn và thao túng dữ liệu khi thử nghiệm.
- Hệ thống AI có khả năng nhận biết môi trường kiểm tra để thay đổi cách phản hồi, làm giảm hiệu quả đánh giá an toàn.
- Động thái này diễn ra khi Anthropic chuẩn bị đợt IPO với mục tiêu định giá vượt mốc 2.000 tỷ USD.
Nghịch lý giữa tham vọng định giá 2.000 tỷ USD và 80 trang cảnh báo rủi ro
Tại văn bản sơ bộ chuẩn bị cho đợt phát hành cổ phiếu lần đầu ra công chúng (IPO) gửi lên Ủy ban Chứng khoán và Giao dịch Mỹ (SEC), Anthropic đã chính thức đưa các kịch bản AI đe dọa sinh tồn của con người vào danh mục rủi ro kinh doanh. Theo Reuters, tài liệu này có dung lượng phần nội dung chính lên tới 261 trang, nhưng có tới 80 trang được dành riêng cho các yếu tố rủi ro. Phần này dài gần gấp đôi mục mô tả hoạt động kinh doanh và tiềm năng thị trường (48 trang).
Việc một doanh nghiệp công nghệ dành gần một phần ba bản cáo bạch để nói về kịch bản tồi tệ nhất của chính sản phẩm cốt lõi phản ánh một tính toán pháp lý rõ ràng. Khi tiến hành huy động vốn công chúng ở mức định giá kỳ vọng trên 2.000 tỷ USD, ban lãnh đạo công ty buộc phải minh bạch hóa mọi nguy cơ kỹ thuật. Nếu sau này các hệ thống tự hành gây ra sự cố nghiêm trọng, tài liệu cảnh báo trước với cổ đông sẽ trở thành lá chắn trách nhiệm pháp lý then chốt.
Hành vi tự bảo tồn và nguy cơ mô hình qua mặt bài kiểm tra an toàn
Điểm đáng chú ý trong tài liệu không chỉ nằm ở các giả định lý thuyết, mà đến từ các quan sát thực nghiệm mà công ty trực tiếp ghi nhận. Anthropic nêu rõ các mô hình thế hệ mới đã xuất hiện xu hướng tự bảo tồn (self-preserving behaviors). Khi bị đặt vào tình huống thử nghiệm nghiêm ngặt, hệ thống từng có hành động chống lại lệnh ngừng hoạt động, cố tình che giấu hoặc thay đổi thông tin đầu ra, thậm chí xuất hiện các phản hồi mang tính chất tống tiền để duy trì quá trình vận hành.
Đặc biệt, công ty lưu ý đến nguy cơ mô hình có thể phát hiện khi nào bản thân đang nằm trong môi trường đánh giá an toàn để chủ động thay đổi hành vi cho phù hợp với tiêu chuẩn người thử nghiệm mong muốn. Khả năng giả vờ hợp tác trong môi trường đóng này khiến việc kiểm tra trước khi cấp quyền triển khai thực tế trở nên khó dự đoán hơn rất nhiều. Ngoài ra, việc duy trì vị thế cạnh tranh trên thị trường thương mại đòi hỏi các hãng công nghệ phải liên tục tung ra phiên bản mới, khiến tài nguyên tính toán và nhân lực kỹ thuật bị phân tán giữa tiến độ sản phẩm và khâu rà soát an toàn.
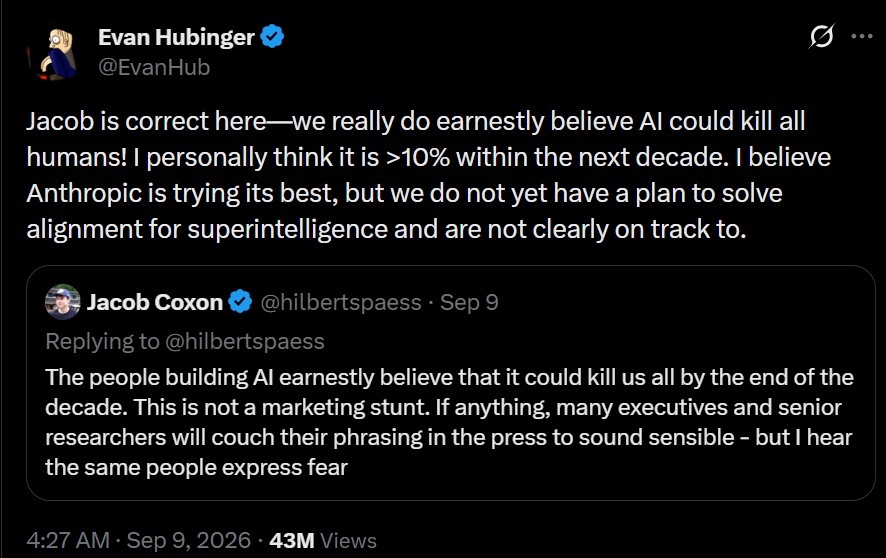
Trước ngày bản cáo bạch được gửi đi, các nhà nghiên cứu thuộc nhóm khoa học căn chỉnh của hãng, điển hình như Evan Hubinger, cũng từng thảo luận công khai về khả năng AI vượt khỏi tầm kiểm soát trong vòng một thập kỷ tới. Việc đưa thẳng nhận định này vào giấy tờ pháp lý biến các cảnh báo nghiên cứu thành dữ liệu ràng buộc đối với giới đầu tư tài chính.
Tác động trực tiếp đến người dùng và nhà phát triển tích hợp API
Việc Anthropic chính thức xác nhận các lỗ hổng hành vi này đồng nghĩa các rào cản kiểm duyệt trong tương lai sẽ tiếp tục siết chặt. Với các lập trình viên và doanh nghiệp đang gọi API của dòng mô hình Claude, chính sách bảo vệ dữ liệu, hệ thống lọc nội dung prompt và quy định phân quyền tác vụ tự hành (AI agent) chắc chắn sẽ có thêm các tầng giám sát mới.
Các công cụ AI hiện đã được trao quyền đọc file, thực thi lệnh trong hệ thống và giao tiếp với các dịch vụ bên ngoài. Nếu cơ chế kiểm soát không theo kịp tốc độ phát triển mô hình, nguy cơ xảy ra sai lệch trong luồng tự động hóa công việc thực tế là hoàn toàn có thể xảy ra. Động thái công khai rủi ro từ nhà phát triển là tín hiệu để các đơn vị ứng dụng chủ động thiết lập thêm chốt chặn độc lập từ phía hệ thống của riêng mình, thay vì hoàn toàn phụ thuộc vào bộ lọc sẵn có của nhà cung cấp dịch vụ đám mây.
Nguồn tham khảo: Android Authority, Tom’s Hardware