Tóm tắt nhanh
- Voicebox là phòng thu giọng nói AI mã nguồn mở, chạy trên máy tính cá nhân; mô hình cần được tải trước khi sử dụng ngoại tuyến.
- Ứng dụng ghép công cụ chuyển văn bản thành giọng nói, chép lời và biên tập âm thanh, thay vì chỉ cung cấp một nút nhân bản giọng.
- Thời lượng mẫu ngắn không bảo đảm mọi bản sao đều giống thật; chất lượng còn phụ thuộc bản ghi, mô hình và ngôn ngữ.
- Giọng nghe giống người quen không chứng minh người đó đang nói. Yêu cầu chuyển tiền cần được xác nhận qua một kênh độc lập.
Đưa AI giọng nói về máy tính cá nhân giải quyết một nỗi lo rất cụ thể: bản ghi âm không nhất thiết phải gửi cho dịch vụ trực tuyến. Nhưng chính cách vận hành đó cũng khiến việc kiểm soát ai được phép dùng giọng của ai khó hơn. Voicebox cho thấy hai vấn đề này cần được tách ra, thay vì coi phần mềm chạy cục bộ là mặc nhiên an toàn.
Giá trị đáng bàn nằm ở việc người dùng có thể quản lý cả hồ sơ giọng nói lẫn quá trình tạo âm thanh trên thiết bị của mình. Với người làm nội dung, đó là cơ hội giảm phụ thuộc dịch vụ thuê bao. Với người nhận cuộc gọi, hệ quả lại khác: cảm giác nhận ra một giọng nói không còn đủ để xác nhận danh tính.
Voicebox là lớp điều khiển, mô hình mới tạo ra giọng nói
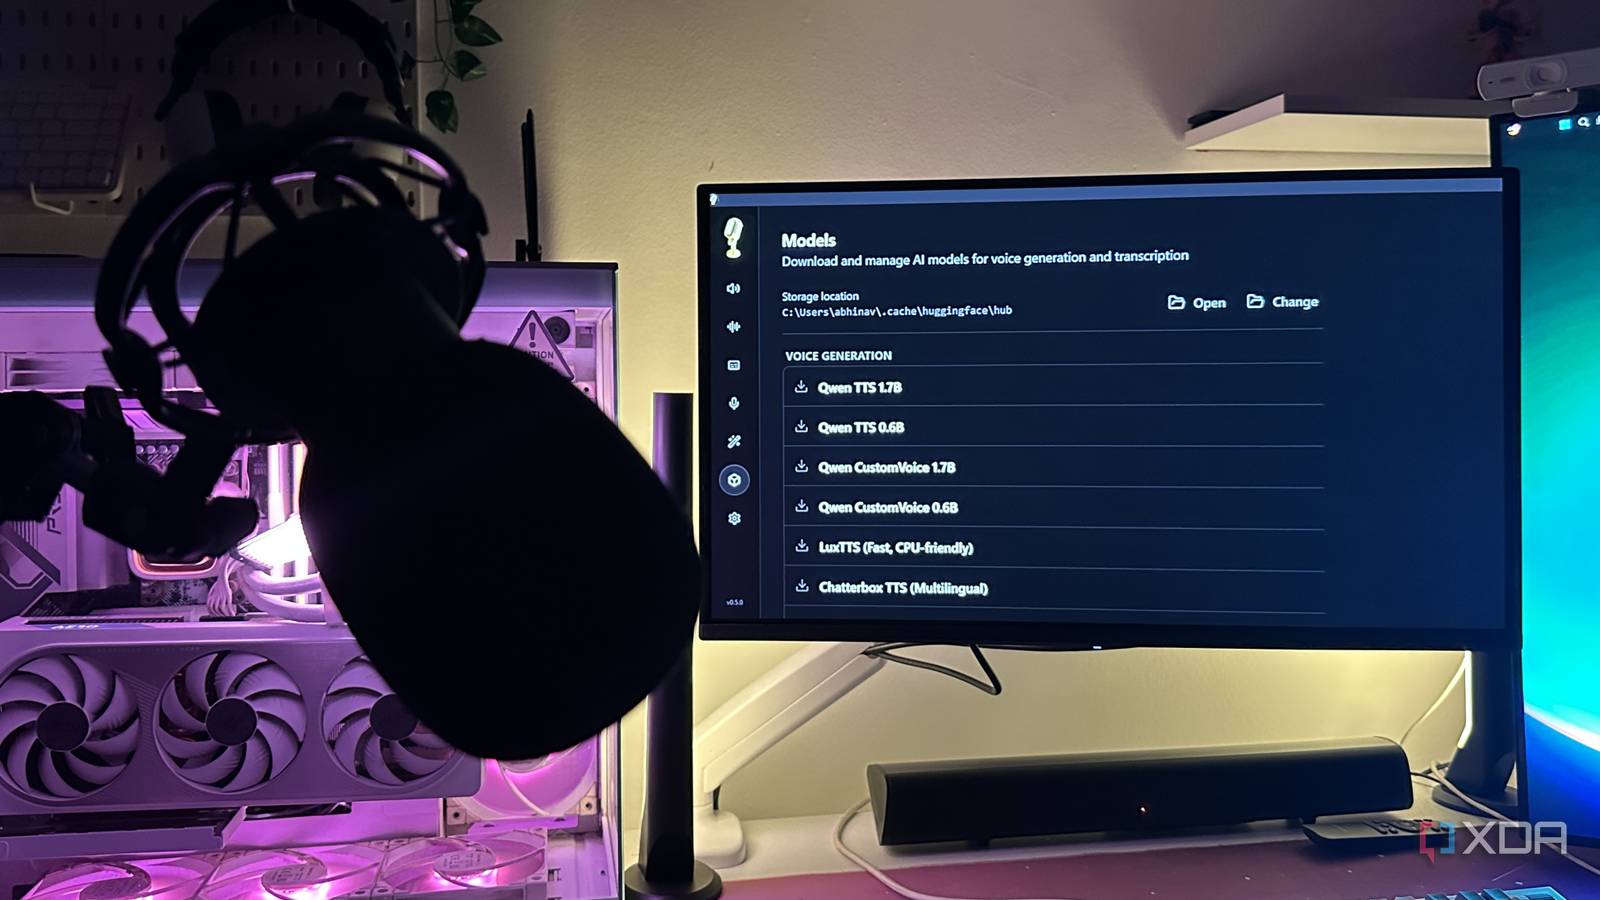
Voicebox nên được hiểu là một phòng thu phần mềm cho nhiều mô hình AI, không phải một mô hình nhân bản giọng do ứng dụng tự phát minh. Jamie Pine phát triển dự án dưới giấy phép MIT. Giao diện desktop dùng Tauri với Rust, còn phần xử lý phía sau dùng Python và FastAPI. Cách chia này giúp người dùng thao tác qua một ứng dụng thay vì tự nối các công cụ bằng dòng lệnh.
Ở mức khái niệm, mô hình nhận âm thanh tham chiếu cùng lời chép tương ứng để tạo câu nói mới mang đặc điểm của giọng mẫu. Whisper phụ trách nhận dạng lời nói trong các chức năng chép lời; engine chuyển văn bản thành giọng nói đảm nhiệm đầu ra. Nhân bản giọng vì thế khác với cắt ghép những từ đã thu: hệ thống có thể tạo một câu mà người có giọng gốc chưa từng nói.
Kho mã chính thức liệt kê 8 engine TTS, với phạm vi tối đa 23 ngôn ngữ trên toàn bộ ứng dụng. Con số này không có nghĩa từng engine đều nhân bản được giọng trong mọi ngôn ngữ. Qwen CustomVoice dùng giọng có sẵn; Qwen VoiceDesign tạo giọng từ mô tả. Chọn đúng engine quan trọng hơn việc nhìn thấy nhiều tên mô hình trong danh sách.
| Thành phần | Vai trò | Điểm cần phân biệt |
|---|---|---|
| Qwen3-TTS | Chuyển văn bản thành giọng nói, hỗ trợ nhân bản đa ngôn ngữ | Dùng mẫu tham chiếu; chất lượng phụ thuộc dữ liệu và thiết lập |
| Qwen CustomVoice / VoiceDesign | Dùng giọng có sẵn hoặc thiết kế giọng từ mô tả | Không đồng nghĩa với sao chép giọng của một người cụ thể |
| Chatterbox | Các lựa chọn tổng hợp giọng nói với phạm vi ngôn ngữ và biểu cảm khác nhau | Tính năng của bản Multilingual và Turbo không giống nhau |
| Whisper | Chép âm thanh thành văn bản | Nhận dạng lời nói, không phải engine tạo giọng |
| Stories và hiệu ứng | Sắp xếp nhiều đoạn âm thanh, chỉnh đầu ra | Là lớp biên tập sau hoặc quanh bước tổng hợp |
Số liệu và chức năng: tài liệu Voicebox trên GitHub.
Phân biệt các lớp này giúp tránh một hiểu lầm dễ gặp: lỗi đọc tên riêng không nhất thiết do giao diện Voicebox, còn một giọng mẫu tốt không bảo đảm mọi engine sẽ giữ đúng cách phát âm. Cần đánh giá cả chuỗi xử lý thay vì gộp mọi kết quả dưới tên ứng dụng.
Chạy cục bộ đổi phí thuê bao thành chi phí phần cứng
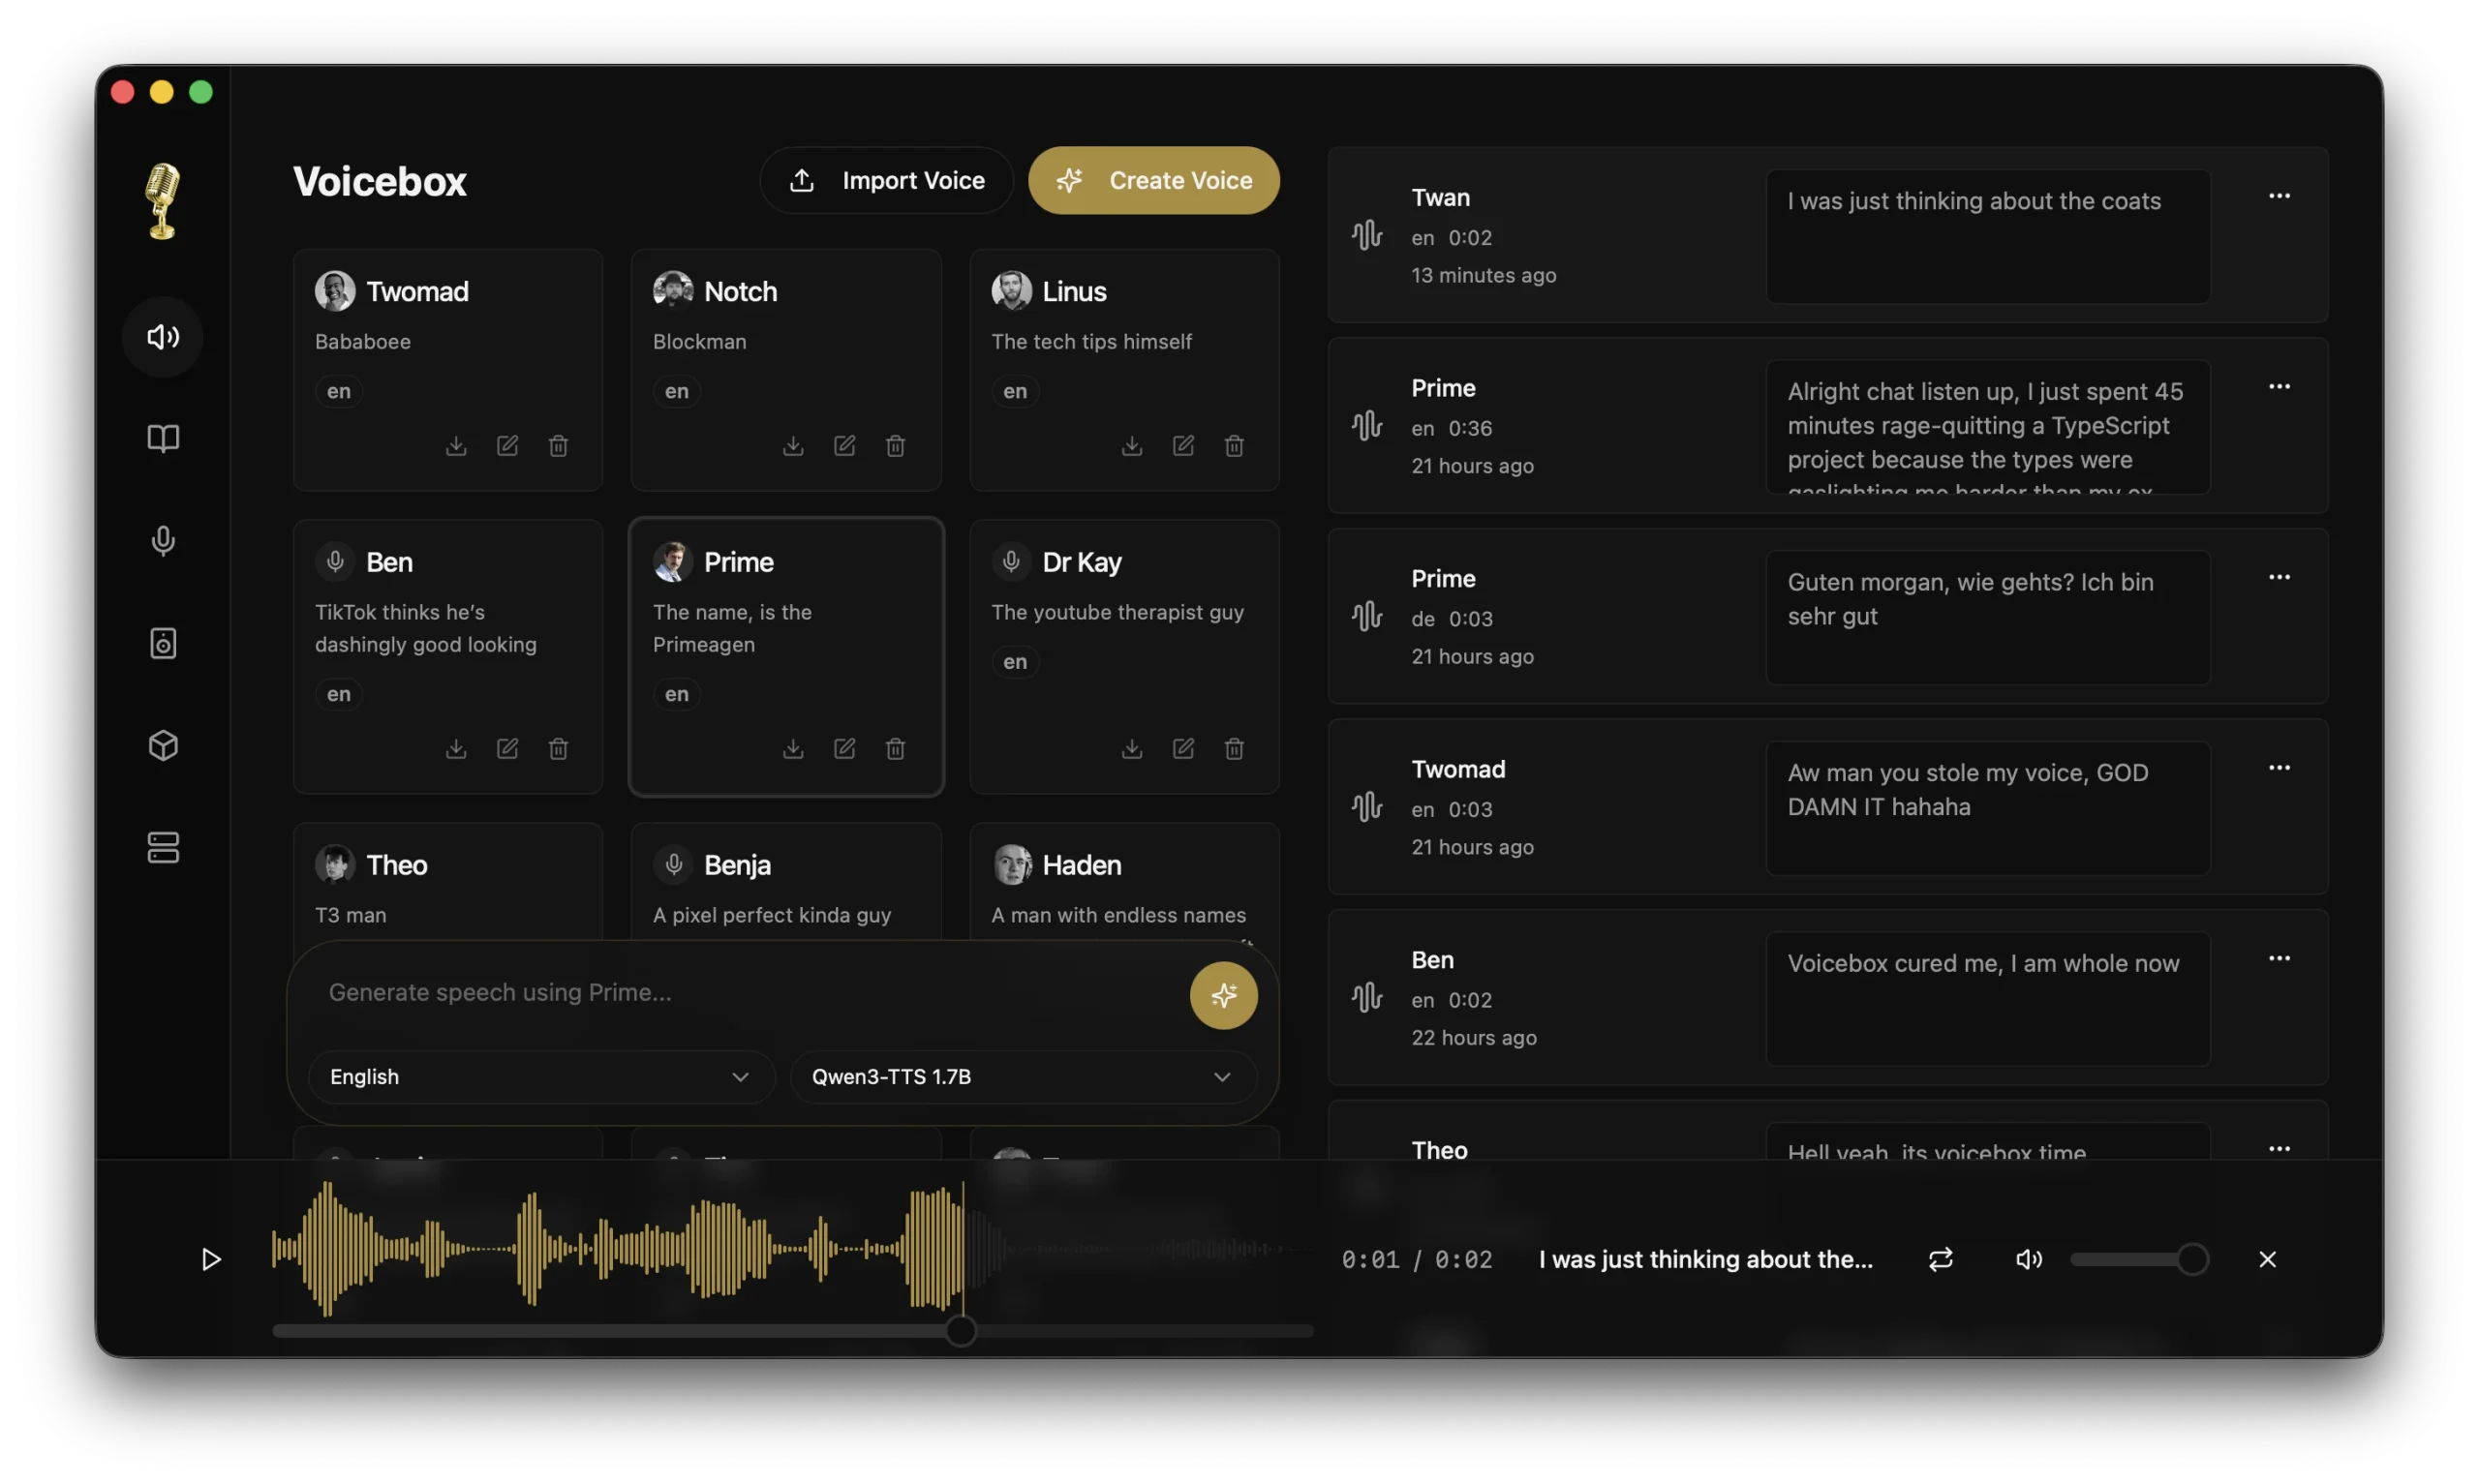
Miễn phí sử dụng phần mềm không đồng nghĩa việc tạo âm thanh không tốn tài nguyên. Voicebox đặt mô hình lên ổ lưu trữ và dùng CPU hoặc GPU của máy để suy luận. Người dùng không chịu hạn mức ký tự từ dịch vụ cloud trong cách vận hành cục bộ, nhưng phải dành bộ nhớ, thời gian xử lý và công sức thiết lập.
XDA nêu cấu hình tối thiểu gồm 8GB RAM, 5GB dung lượng trống và CPU đa nhân; mức khuyến nghị là 16GB RAM cùng GPU Nvidia. Đây là mốc để tham khảo khả năng chạy ứng dụng, không phải cam kết mọi mô hình đều phản hồi nhanh. Không nên biến chúng thành lời hứa rằng máy văn phòng bất kỳ cũng sẽ tạo giọng tức thì.
| Yêu cầu / nền tảng | Thông tin được công bố | Ý nghĩa thực tế |
|---|---|---|
| RAM tối thiểu | 8GB | Cần tính thêm bộ nhớ cho hệ điều hành và ứng dụng khác |
| RAM khuyến nghị | 16GB | Không thay thế việc kiểm tra nhu cầu của từng mô hình |
| Lưu trữ tối thiểu | 5GB | Tải thêm mô hình và giữ bản ghi sẽ làm tăng dung lượng sử dụng |
| Windows với GPU Nvidia | CUDA | Cần backend tương thích để tận dụng tăng tốc GPU |
| Mac dùng Apple Silicon | MLX / Metal | Dùng backend dành cho phần cứng Apple |
| CPU | Có thể chạy | Thời gian chờ có thể dài hơn so với GPU phù hợp |
XDA Developers nêu mức 8GB RAM tối thiểu, 16GB RAM khuyến nghị và 5GB lưu trữ; thông tin backend được mô tả trong tài liệu Voicebox trên GitHub.
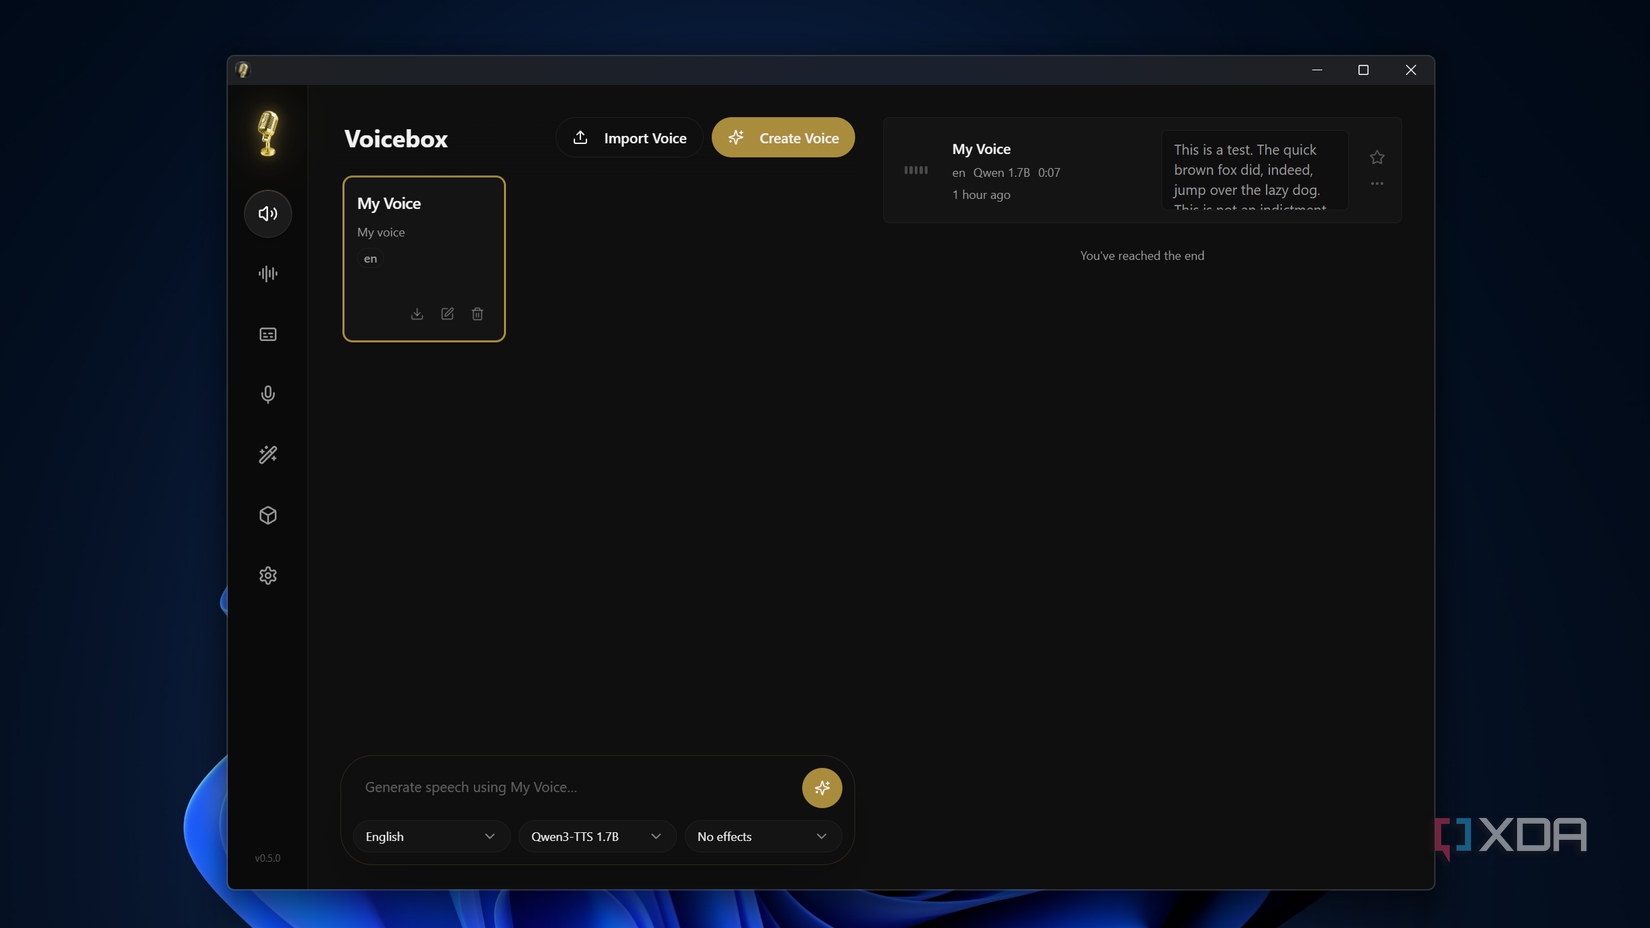
Trong cấu hình thử của XDA, Qwen3-TTS 1.7B cần tải khoảng 3,6GB và có thêm backend CUDA cho RTX 3070. Sau khi cài các thành phần đó, quá trình ghi mẫu đến tạo giọng mất dưới 5 phút. Đây là thời gian của một lần thiết lập và sử dụng cụ thể, không phải benchmark tốc độ tổng hợp hay bảo đảm cho mọi PC.
Cách tính chi phí hợp lý là dựa vào nhu cầu đã có. Nếu đang sở hữu máy phù hợp và thường xuyên làm thuyết minh, chạy cục bộ đáng để cân nhắc. Nếu chỉ cần một đoạn âm thanh thỉnh thoảng, mua thêm GPU chỉ để tránh thuê bao có thể không kinh tế. Không có cơ sở để khẳng định mọi người đều tiết kiệm một số tiền cố định.
Mẫu vài giây hạ rào cản, không bảo đảm bản sao hoàn hảo
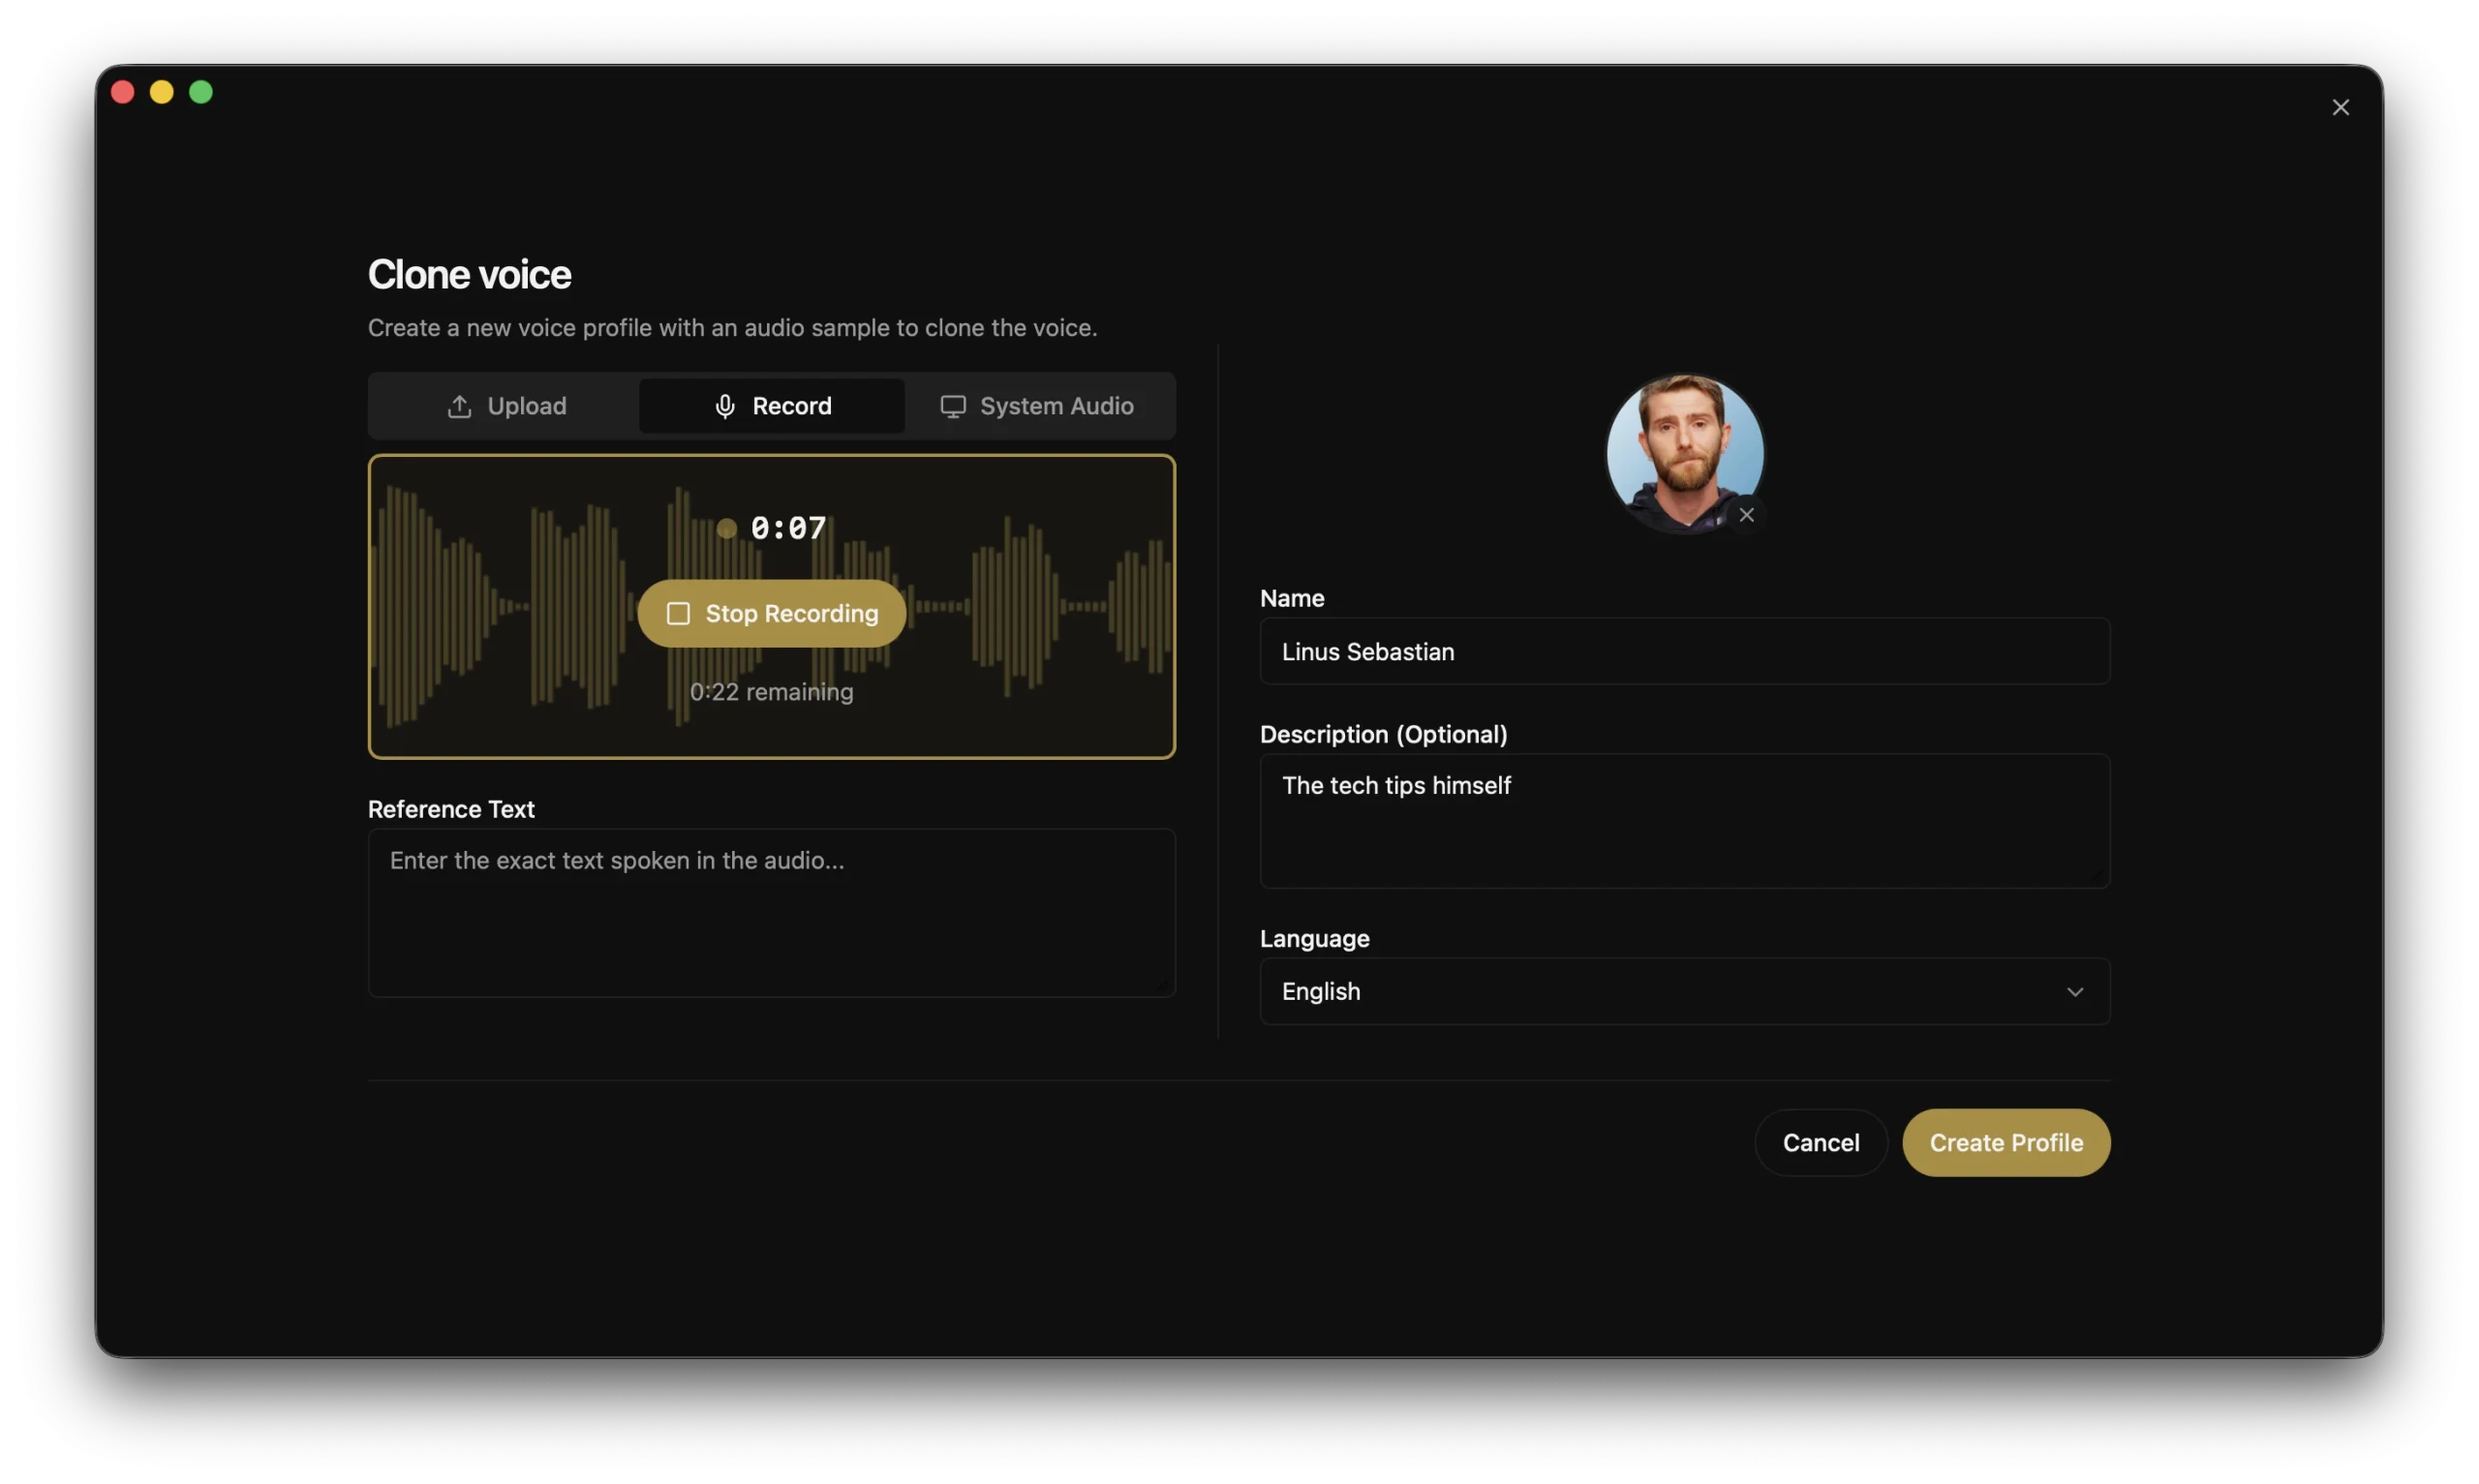
Thời lượng âm thanh tối thiểu là thông số đầu vào, không phải thước đo độ giống. XDA dẫn thông tin từ website Voicebox rằng mẫu có thể ngắn tới 3 giây, trong khi tài liệu khuyến nghị 10–30 giây lời nói sạch để có kết quả tốt hơn. Khoảng cách giữa hai mốc này rất đáng chú ý: chạy được và dùng được cho sản phẩm hoàn thiện là hai yêu cầu khác nhau.
Tiếng nền, âm lượng không đều hoặc lời chép sai có thể khiến mẫu kém hữu ích. Nhịp điệu và âm sắc giống giọng gốc cũng chưa bảo đảm tên riêng hay câu dài được đọc đúng. Với nội dung tiếng Việt, không nên lấy tổng số ngôn ngữ của ứng dụng để suy ra chất lượng phát âm tiếng Việt; cần kiểm tra khả năng của engine được chọn và nghe lại đầu ra thực tế.
Âm thanh tổng hợp có thể giữ được nhiều nét dễ nhận ra của một người, nhưng vẫn có dấu hiệu khác biệt. Sự thiếu tự nhiên ở một số đoạn, cách ngắt câu hoặc nền âm quá sạch có thể khiến người quen nghi ngờ. Tuy vậy, phát hiện bằng tai phụ thuộc tình huống. Đoạn nghe ngắn, chất lượng cuộc gọi thấp và áp lực phải trả lời ngay đều làm việc đánh giá khó hơn.
Vì thế, không nên xem bản sao giọng là hoàn toàn không thể phân biệt; cũng không nên trông chờ vào việc luôn nghe ra lỗi. Một công cụ phát hiện âm thanh AI, nếu có, cần được kiểm chứng trong điều kiện phù hợp. Cảm giác nghe quen vẫn chỉ là một dấu hiệu, không phải bằng chứng xác thực người nói.
Giữ dữ liệu trên máy không xác nhận quyền dùng giọng
Quyền riêng tư của người tạo âm thanh và quyền của người bị sao chép là hai chuyện khác nhau. Dữ liệu nằm trên máy giúp giảm việc phải giao bản ghi cho bên thứ ba. Nhưng một máy tính cục bộ vẫn có thể chứa giọng được thu mà người nói không đồng ý sử dụng cho mục đích nhân bản.
Voicebox công bố mô hình, dữ liệu giọng và bản ghi được giữ trên thiết bị trong cách vận hành local-first. Lợi ích này rõ nhất khi dùng giọng của chính mình hoặc mẫu đã được cho phép. Nó không chứng minh rằng mọi ứng dụng kết nối, mọi bản âm thanh xuất ra và mọi quy trình chia sẻ phía sau đều giữ dữ liệu trong cùng ranh giới.
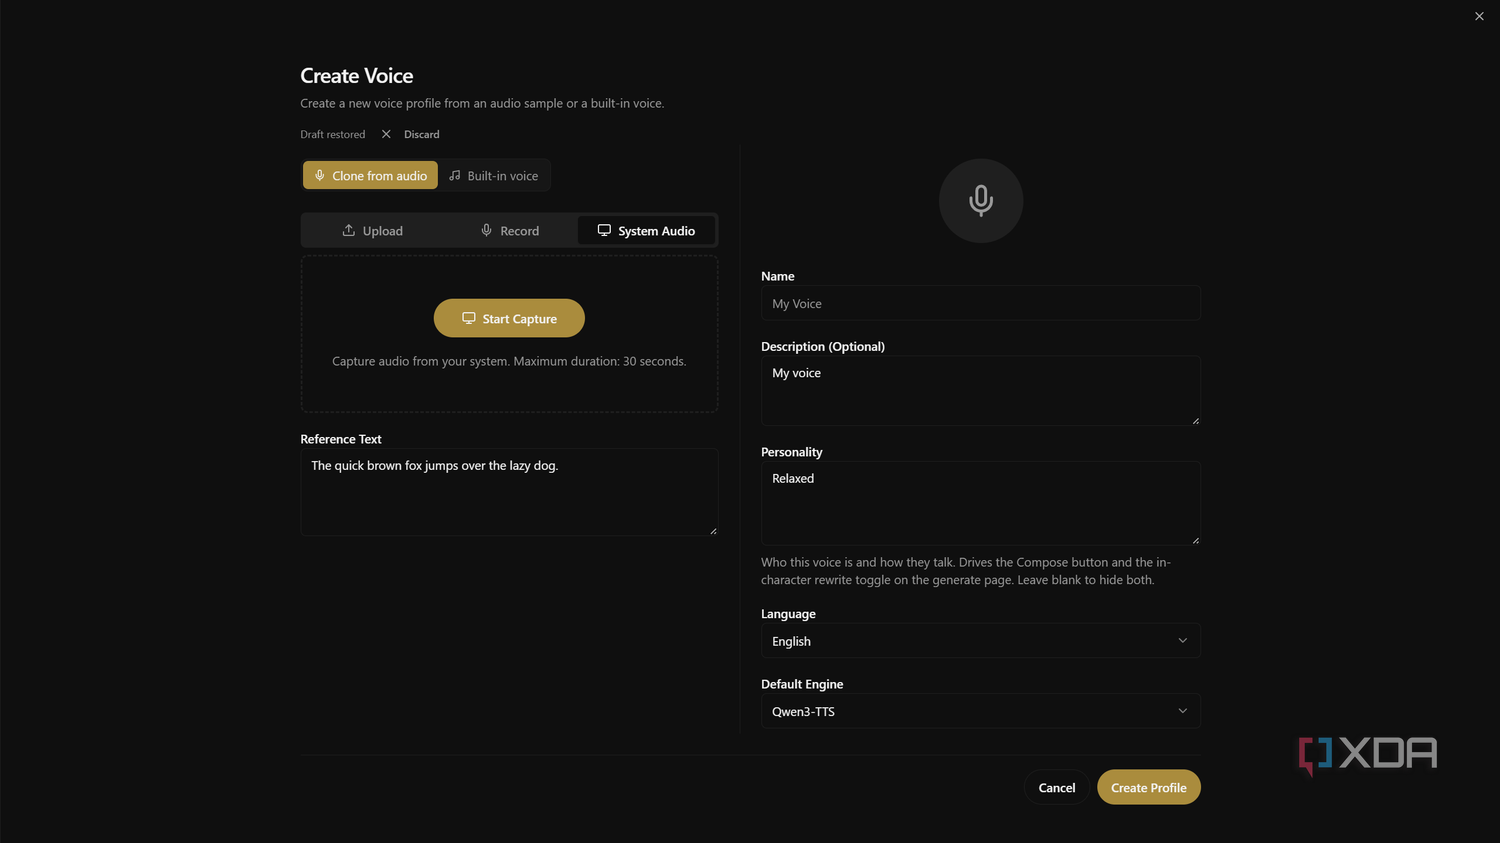
Ở bản desktop được mô tả trong trải nghiệm sử dụng, việc tạo hồ sơ giọng không đi kèm bước xác minh danh tính hay quyền sở hữu giọng. Không nên suy diễn điều đó thành kết luận ứng dụng có thể vượt qua mọi hệ thống bảo mật. Một hệ thống xác thực có thể dùng thêm tín hiệu khác và cơ chế chống giả mạo; bài thử tạo âm thanh không kiểm chứng khả năng vượt qua những cơ chế ấy.
Rủi ro thực dụng hơn là mạo danh trong giao tiếp. Người nghe có thể tin một yêu cầu vì giọng giống người nhà hoặc đồng nghiệp, dù phần mềm chưa vượt qua bất kỳ cổng bảo mật kỹ thuật nào. Việc không cần máy chủ dịch vụ để tạo đầu ra khiến nhà cung cấp khó áp một bước xác minh từ xa cho từng lần sử dụng.
Với người làm nội dung, nguyên tắc nên đặt từ trước khi tạo hồ sơ: chỉ dùng giọng của mình hoặc có sự đồng ý rõ ràng; thống nhất mục đích và phạm vi sử dụng. Giấy phép mã nguồn MIT cho phép sử dụng phần mềm không thay thế sự đồng ý của người có giọng nói.
Phòng thu và agent hữu ích khi quyền truy cập được giới hạn
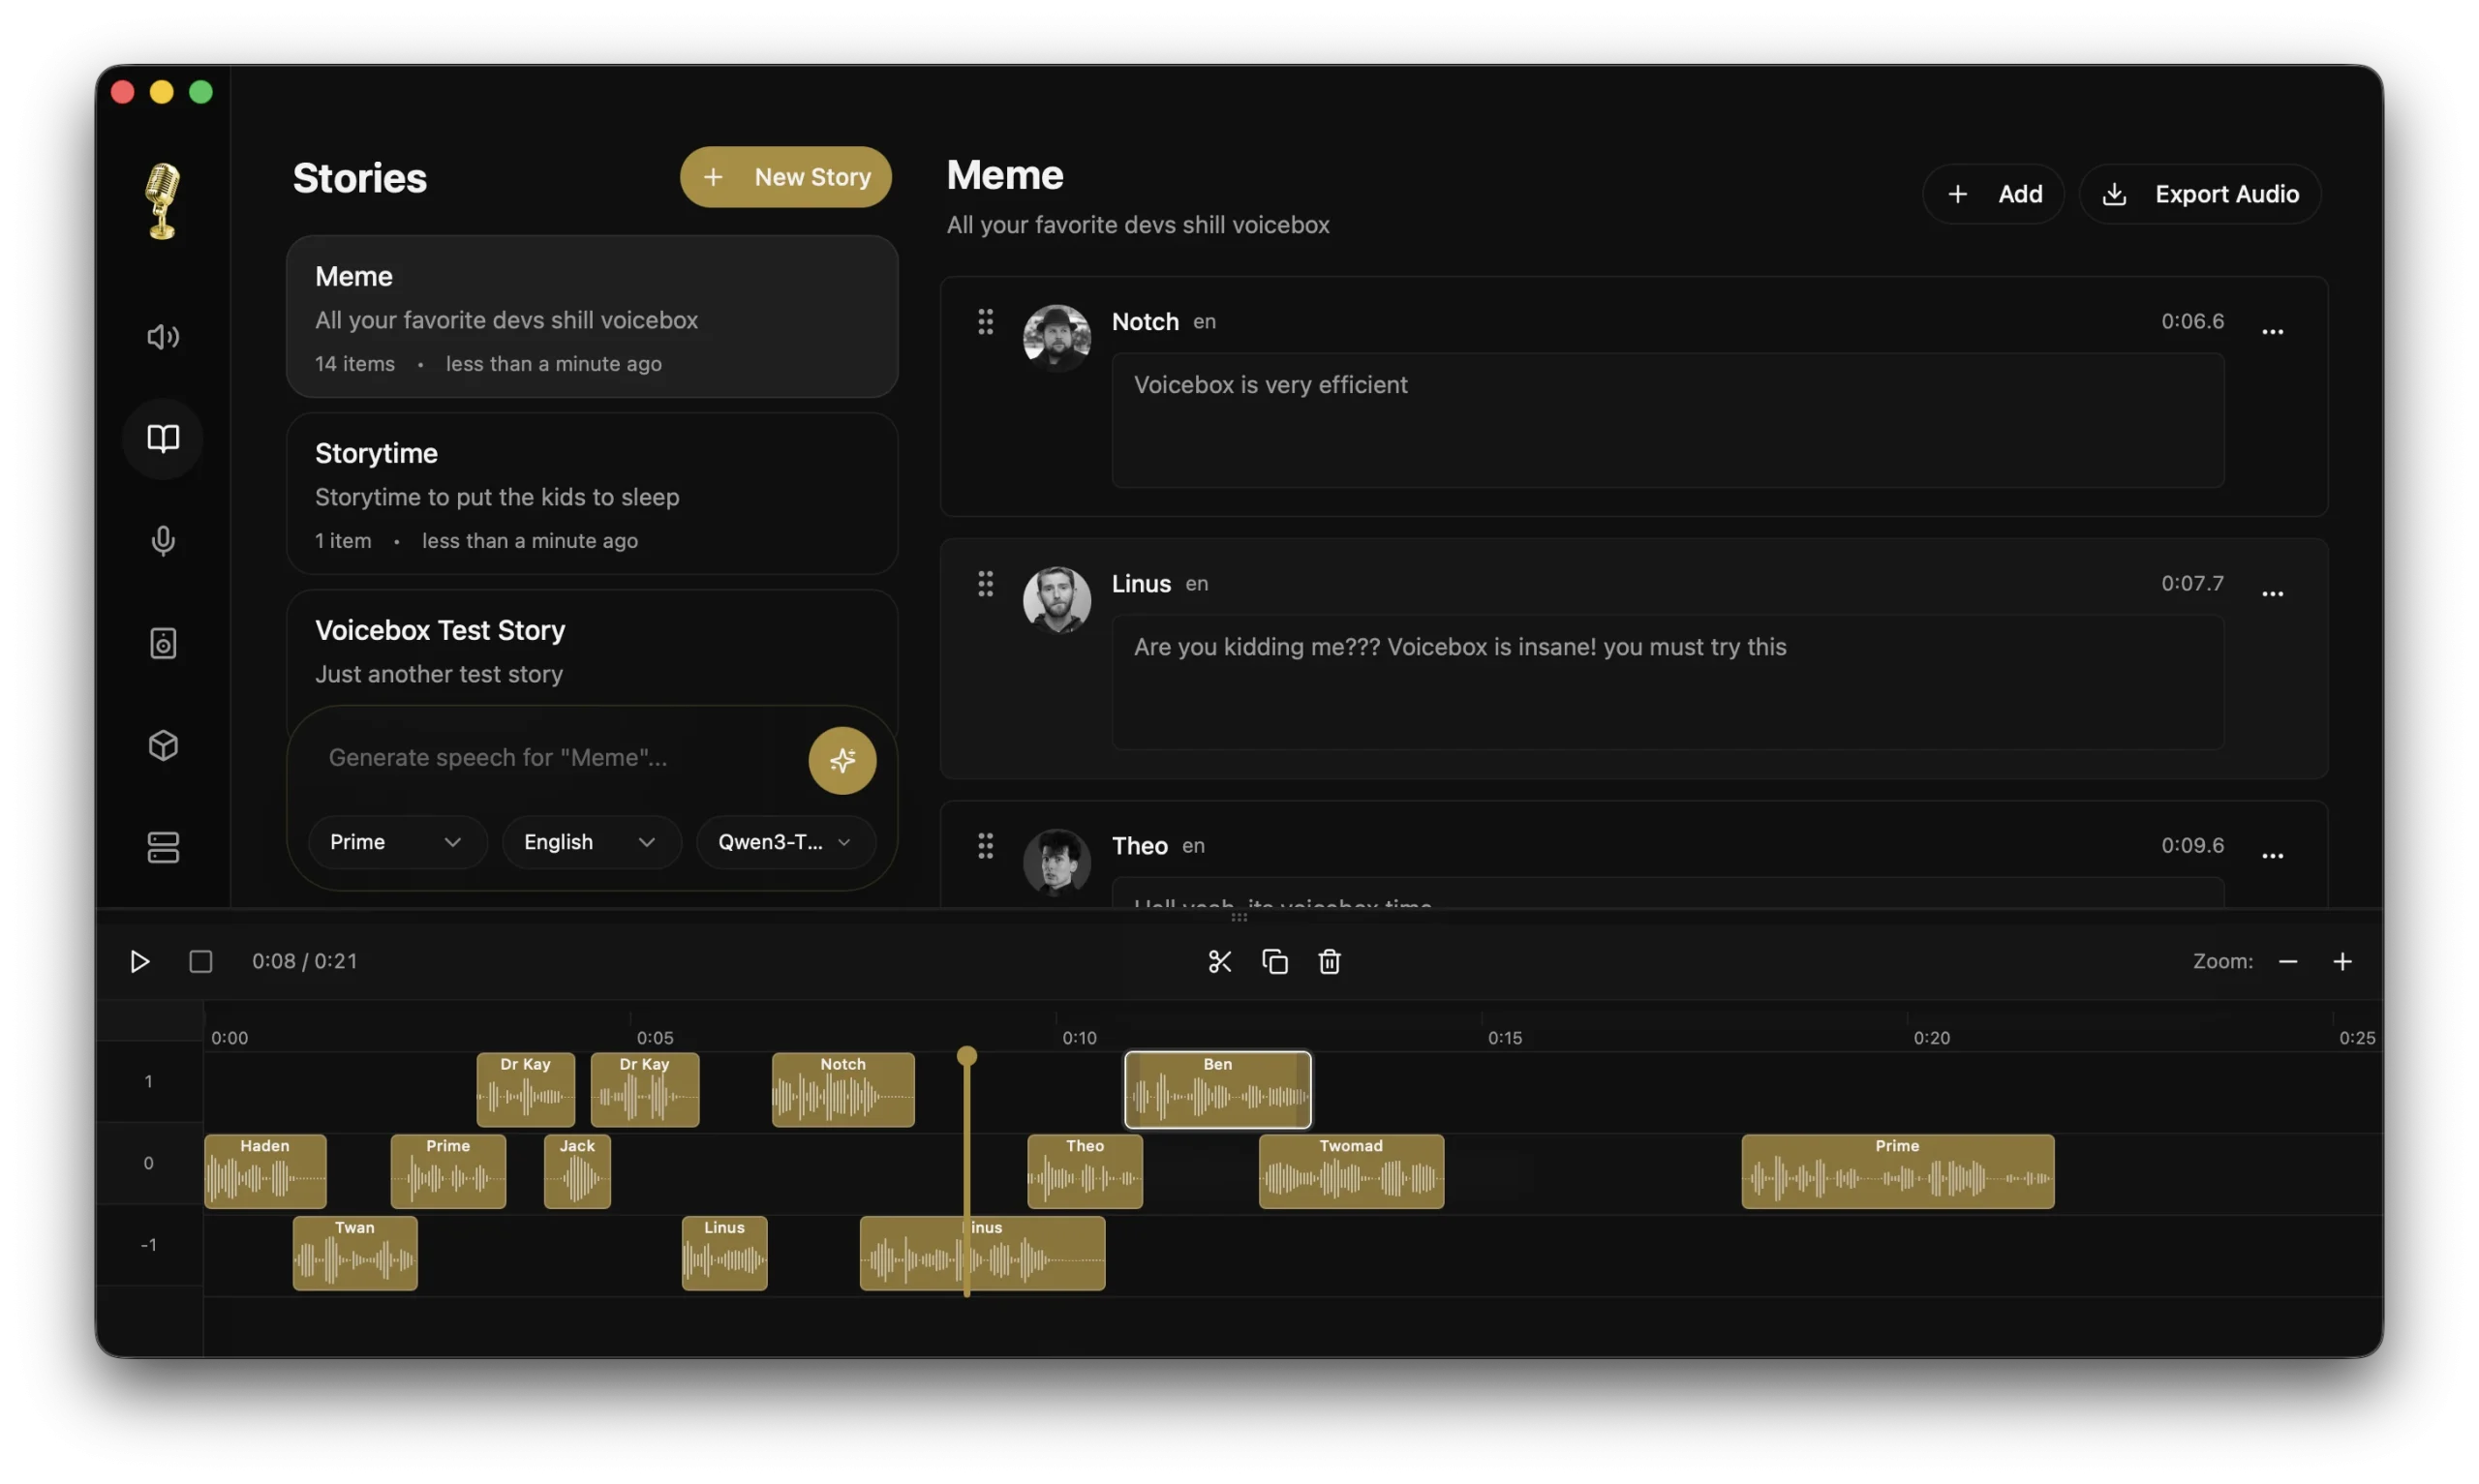
Nhân bản giọng chỉ là một phần của giá trị sử dụng. Voicebox có trình biên tập timeline nhiều track, quản lý các lần tạo âm thanh và hiệu ứng hậu kỳ. Những công cụ này giúp biến các câu rời thành một sản phẩm có thể chỉnh sửa, thay vì phải xuất từng file rồi chuyển sang phần mềm khác cho mọi thao tác.
Khả năng kết nối REST API và Model Context Protocol (MCP) đưa đầu ra giọng nói vào quy trình của ứng dụng hoặc AI agent. Tài liệu dự án mô tả agent tương thích MCP có thể đọc phản hồi bằng hồ sơ giọng đã chọn. Đây là lớp tích hợp, không phải bằng chứng agent được quyền sử dụng bất kỳ giọng nào nó truy cập được.
Một quy trình tốt cần giới hạn cả hồ sơ giọng lẫn nội dung được đưa đi tổng hợp. Agent phục vụ công việc nội bộ có thể dùng giọng preset hoặc giọng được cho phép mà không cần mượn danh tính của người khác. Khi chuyển sang nội dung gửi khách hàng hay công bố rộng rãi, nên có bước kiểm tra văn bản và nghe lại trước khi xuất bản.
Chạy trên máy cũng không có nghĩa nên mở API cho toàn mạng. Cần giữ ranh giới truy cập phù hợp với nhu cầu sử dụng và xem kỹ ứng dụng nào được kết nối. Hồ sơ giọng, âm thanh mẫu và bản chép lời đều là dữ liệu cần quản lý; việc lưu lâu dài thuận tiện cho sản xuất nhưng cũng làm tăng số dữ liệu phải bảo vệ.
Người dùng Việt Nam cần xác nhận yêu cầu, không chỉ nhận ra giọng
Với người nhận cuộc gọi, biện pháp hữu ích nhất là tách giọng nói khỏi quyết định chuyển tiền. Khi có yêu cầu bất thường, hãy dừng cuộc gọi và liên hệ lại qua số đã lưu hoặc một kênh độc lập đã biết. Không dùng số hay đường dẫn do chính người đang yêu cầu cung cấp làm bước xác minh duy nhất.
Trong gia đình, có thể thống nhất cách kiểm tra khi xuất hiện tình huống khẩn cấp, nhưng không nên chỉ dựa vào một câu hỏi cá nhân dễ tìm trên mạng. Ở nơi làm việc, yêu cầu thay đổi tài khoản nhận tiền hoặc phê duyệt thanh toán cần tuân thủ quy trình xác nhận sẵn có, dù giọng nghe rất giống người quản lý. Lớp bảo vệ nằm ở cách ra quyết định, không phải ở khả năng đoán giọng bằng tai.
Với người muốn sử dụng Voicebox tại Việt Nam, đây là phần mềm mã nguồn mở miễn phí, tải từ kênh chính thức của dự án; không phải thiết bị cần tìm giá ở chuỗi bán lẻ. Điều cần kiểm tra trước là backend, dung lượng mô hình và tính phù hợp của đầu ra với ngôn ngữ công việc. Không nên coi việc tải miễn phí là lý do bỏ qua quyền sử dụng giọng mẫu.
Voicebox đáng chú ý vì đưa công cụ sản xuất âm thanh về gần người dùng hơn. Lựa chọn hợp lý là tận dụng quyền kiểm soát dữ liệu cho công việc được cho phép, đồng thời bỏ thói quen coi giọng quen là đủ tin. Hai thay đổi đó phải đi cùng nhau.
Nguồn tham khảo: Voicebox — kho mã và tài liệu chính thức, XDA Developers