Tóm tắt nhanh
- Tesla V100 32GB có HBM2 băng thông 900 GB/s; một phép thử Qwen 3.6 ghi nhận 98,8 token/giây với mô hình MoE 35B-A3B lượng tử hóa 4-bit.
- Card PCIe V100 32GB được niêm yết 22 triệu đồng tại Việt Nam, chưa gồm VAT; đây là hàng cũ và giá cần cân cùng chi phí hệ thống.
- V100 không phải card đồ họa phổ thông: bản SXM2 không cắm trực tiếp vào khe PCIe, còn card chuẩn không có cổng xuất hình và cần luồng gió mạnh.
- Binary llama.cpp dựng sẵn trong thử nghiệm không chạy trên kiến trúc Volta sm_70; muốn dùng phải tự biên dịch, trong khi khả năng hỗ trợ tương lai có rủi ro.
Một GPU máy chủ ra mắt năm 2017 đang được chú ý trở lại vì 32GB bộ nhớ HBM2 và băng thông 900 GB/s vẫn hữu ích khi chạy mô hình ngôn ngữ lớn tại chỗ. Nhưng con số tốc độ ấn tượng không biến Tesla V100 thành món nâng cấp cắm-là-chạy: chi phí làm mát, tương thích phần cứng và tình trạng hỗ trợ phần mềm mới là phần quyết định nó có đáng mua hay không.
Băng thông HBM2 giúp V100 giữ tốc độ sinh token đáng kể
Trong lúc GPU mới dung lượng bộ nhớ lớn có giá cao, V100 có một lợi thế khác thường: bộ nhớ HBM2 32GB với băng thông 900 GB/s. Khi sinh từng token, hệ thống phải liên tục đọc trọng số mô hình từ bộ nhớ; vì vậy dung lượng và băng thông có thể quan trọng hơn sức mạnh tính toán đỉnh trong một số cấu hình suy luận.
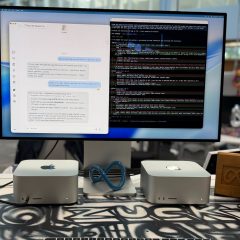
Ở phép thử Qwen 3.6 trên V100-SXM2-32GB, Miyagadget đo được 98,8 token/giây với mô hình MoE 35B-A3B lượng tử hóa 4-bit; mô hình dense 27B Q4_K_M đạt 32,9 token/giây, còn bản 27B Q8_0 đạt 23,4 token/giây. Đây là kết quả của một cấu hình cụ thể, chạy llama.cpp tự biên dịch nhắm tới sm_70, không phải mức có thể mặc định áp cho mọi V100.
Phép đo dùng card SXM2 có xung boost cao hơn biến thể PCIe; tác giả thử nghiệm ước tính bản PCIe có thể chậm hơn khoảng 10%. Vì thế, mức gần 100 token/giây nên được xem là minh chứng cho khả năng của chip trong điều kiện phù hợp, không phải cam kết cho chiếc card cũ bất kỳ trên thị trường.
Vấn đề lớn nhất là phần mềm đã bắt đầu bỏ qua kiến trúc Volta
V100 có thể chạy mô hình cục bộ, nhưng phần mềm mới không còn mặc nhiên hỗ trợ nó. Trong thử nghiệm của Miyagadget, binary llama.cpp dựng sẵn báo lỗi CUDA vì không có kernel tương thích với sm_70; người thử phải biên dịch lại từ mã nguồn và chỉ rõ kiến trúc mục tiêu.
Đây là khác biệt quan trọng giữa “đủ nhanh” và “dễ dùng”. Người mua cần quen với CUDA, trình biên dịch và quy trình tự dựng ứng dụng; một bản cập nhật thư viện hoặc toolkit trong tương lai cũng có thể khiến việc duy trì cấu hình khó hơn. Cảnh báo của nvcc về việc ngừng biên dịch offline cho kiến trúc trước sm_75 không đồng nghĩa V100 lập tức ngừng hoạt động, nhưng cho thấy rủi ro tương thích không còn mang tính giả định.
Giá 22 triệu đồng chưa phản ánh toàn bộ chi phí để chạy
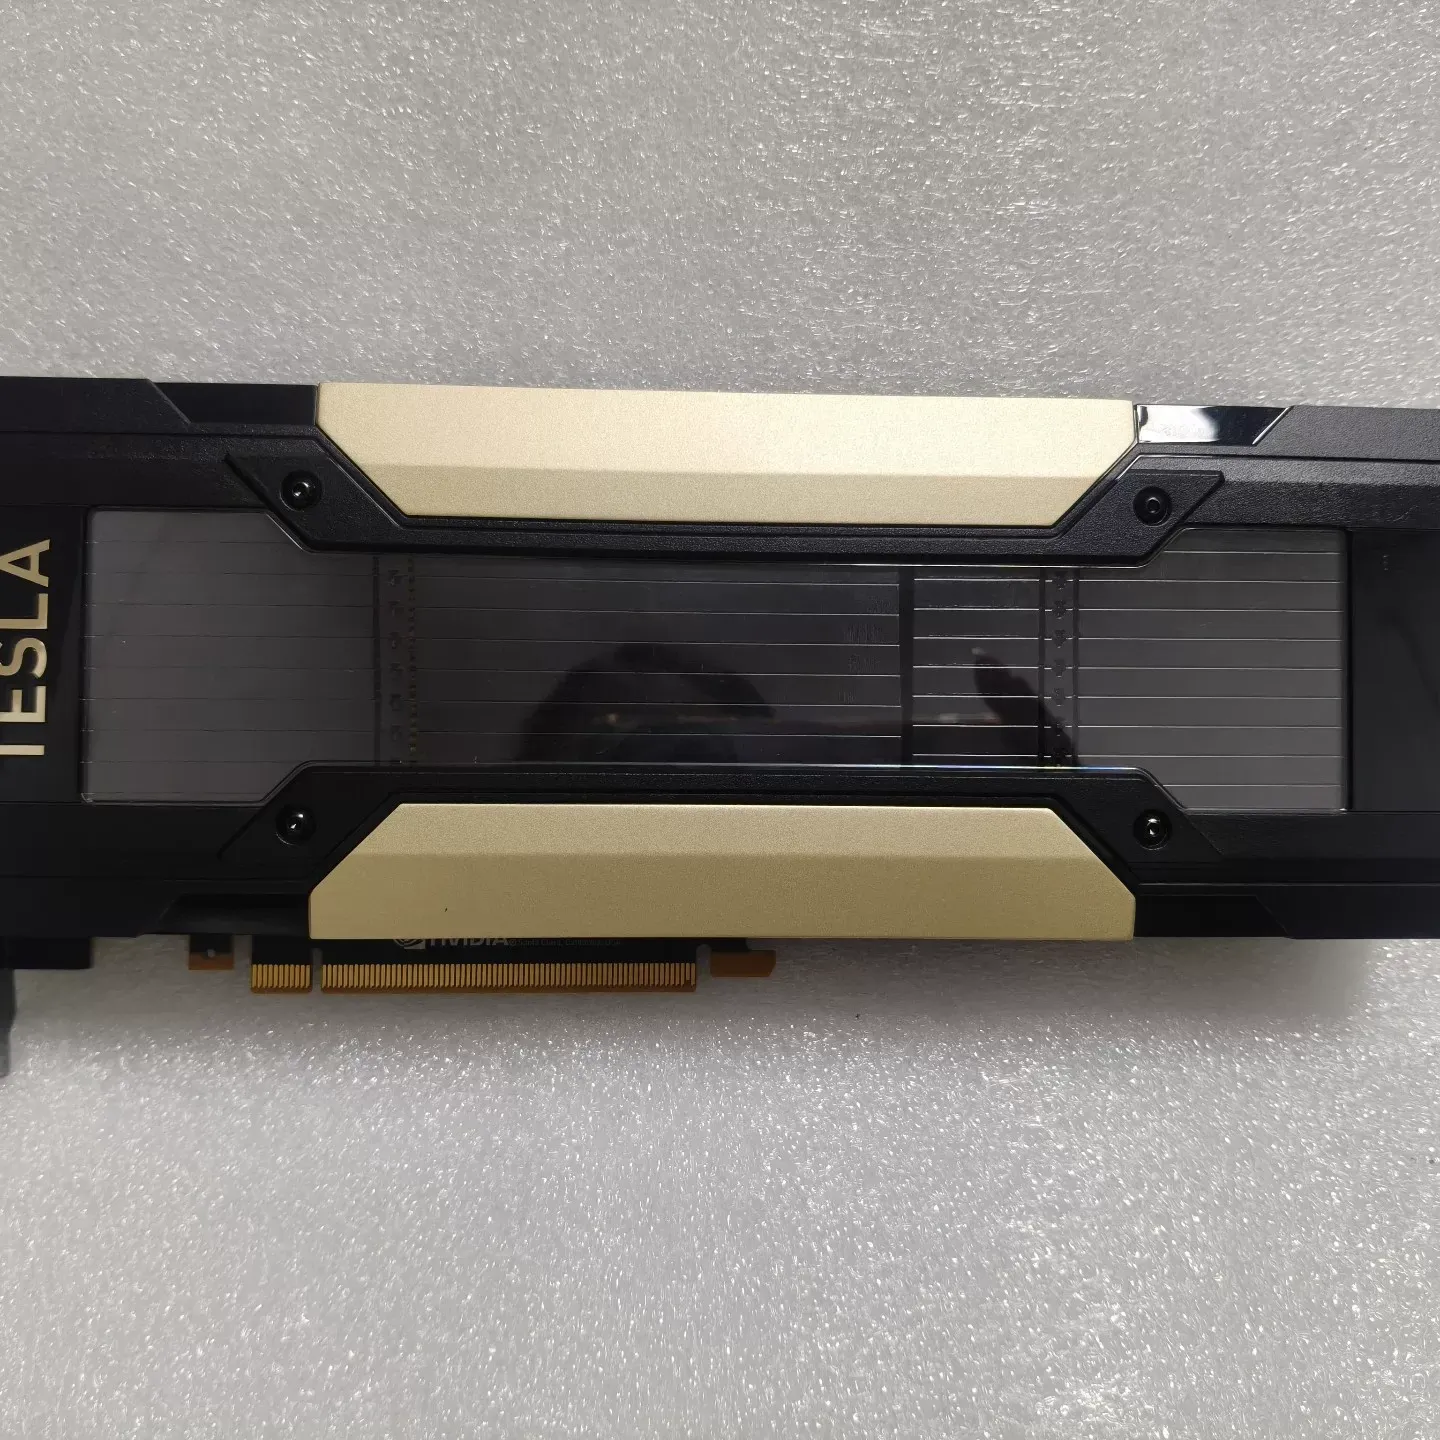
Một cửa hàng linh kiện máy chủ tại Việt Nam niêm yết V100 32GB PCIe cũ ở mức 22 triệu đồng, chưa gồm 8% VAT. Đây là giá một card cụ thể, không thể so trực tiếp với giá dàn máy khoảng 2.000 USD được nhắc trong tin thị trường quốc tế.
V100 PCIe có mức tiêu thụ tối đa 250 W theo thông số NVIDIA. Bản chuẩn dùng tản nhiệt thụ động, dựa vào luồng gió cưỡng bức trong máy chủ; lắp vào thùng PC thông thường mà không tính giải pháp làm mát phù hợp có thể dẫn tới nhiệt độ và độ ổn định không mong muốn. Card cũng không có cổng xuất hình, nên máy cần GPU khác hoặc đồ họa tích hợp để xuất màn hình.
Với một người đã có sẵn máy chủ, luồng gió và kinh nghiệm tự biên dịch CUDA, giá trị 32GB HBM2 có thể đáng cân nhắc. Còn nếu phải mua thêm bộ nguồn, giải pháp quạt/ống gió, adapter và linh kiện nền tảng, lợi thế giá ban đầu sẽ mỏng đi nhanh chóng.
Chọn đúng PCIe quan trọng hơn săn mức giá rẻ
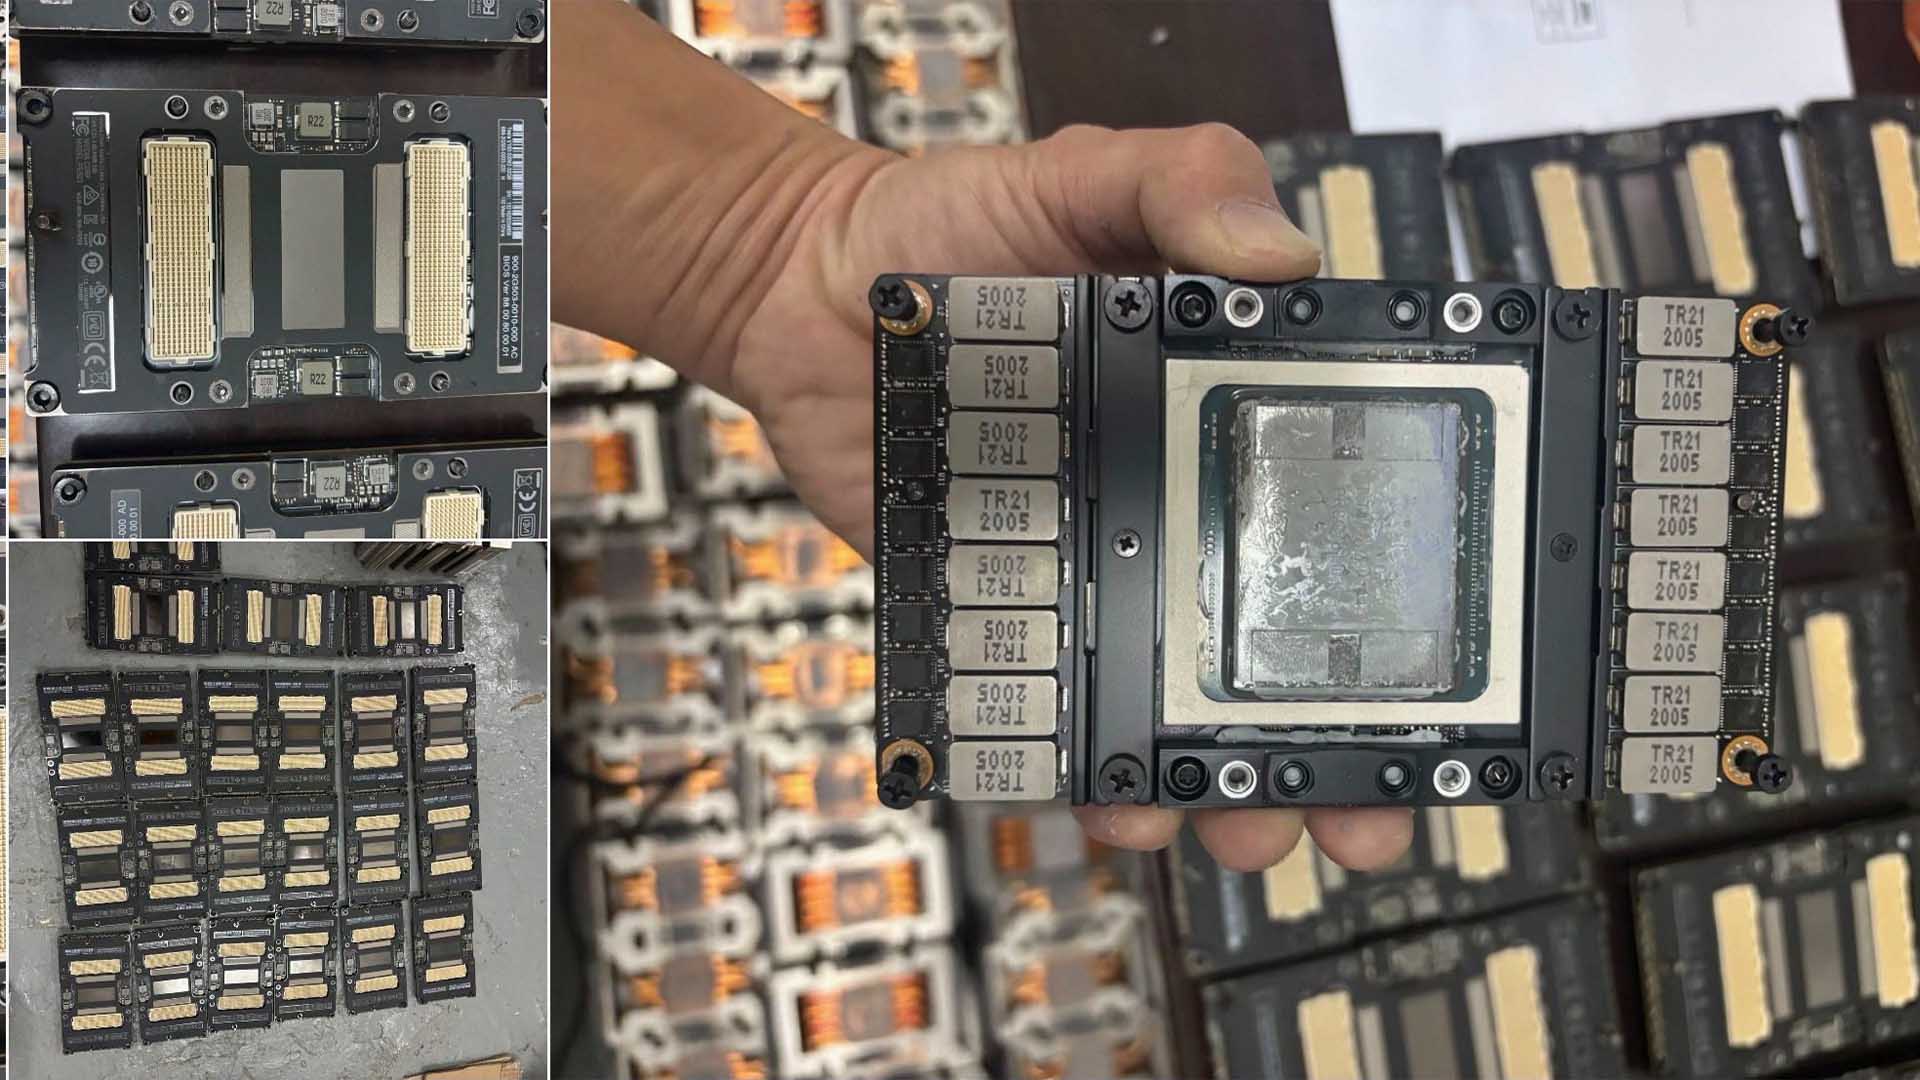
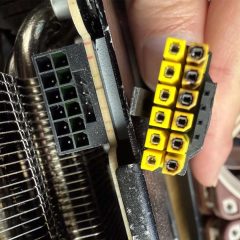
V100 có các biến thể PCIe và SXM2, nhưng chúng không thể thay thế lẫn nhau chỉ bằng cách đổi đầu nối. Bản PCIe dùng khe PCIe 3.0 x16; SXM2 được thiết kế cho bo mạch chủ máy chủ có socket tương ứng, và việc dùng adapter không biến nó thành lựa chọn cắm trực tiếp đơn giản. Người mua cần xác minh chính xác phiên bản, cách cấp nguồn và tản nhiệt trước khi giao dịch.
V100 cũng là card tính toán, không phải lựa chọn để chơi game hay xuất hình. Với người muốn một máy LLM gia đình dễ cài đặt, một GPU phổ thông có hỗ trợ phần mềm hiện hành có thể hợp lý hơn dù ít bộ nhớ hơn. V100 chỉ hấp dẫn khi người mua chấp nhận đổi sự tiện lợi lấy dung lượng bộ nhớ lớn và sẵn sàng tự xử lý các vấn đề tương thích.
Nguồn tham khảo: NVIDIA; Miyagadget; Wccftech; Máy Chủ Zin