Tóm tắt nhanh
--n-cpu-moe Ngiữ expert của N lớp MoE đầu tiên trong RAM hệ thống thay vì VRAM.- Cách này chỉ hữu ích với mô hình Mixture-of-Experts, không phải mô hình Dense thông thường.
- Benchmark trên laptop RTX 3070 Mobile 8GB ghi nhận Qwen3.6-35B-A3B tăng từ 4,02 lên 32,82 token/giây khi offload 28 lớp, với đúng cấu hình thử nghiệm.
- Hãy tìm mức N thấp nhất đủ tránh tràn VRAM; N cao hơn giảm áp lực VRAM nhưng có thể làm chậm suy luận.
Một GPU 8GB không nhất thiết phải loại bỏ mọi mô hình MoE lớn khỏi danh sách có thể chạy. Trong llama.cpp, cờ --n-cpu-moe cho phép chuyển một phần trọng số expert sang RAM, dành VRAM cho các phần được dùng thường xuyên hơn. Kết quả phụ thuộc cấu hình cụ thể, nhưng benchmark trên laptop RTX 3070 Mobile cho thấy cách phân bổ này có thể thay đổi đáng kể tốc độ của Qwen3.6-35B-A3B.
MoE cho phép tách expert khỏi phần chạy ở mọi token
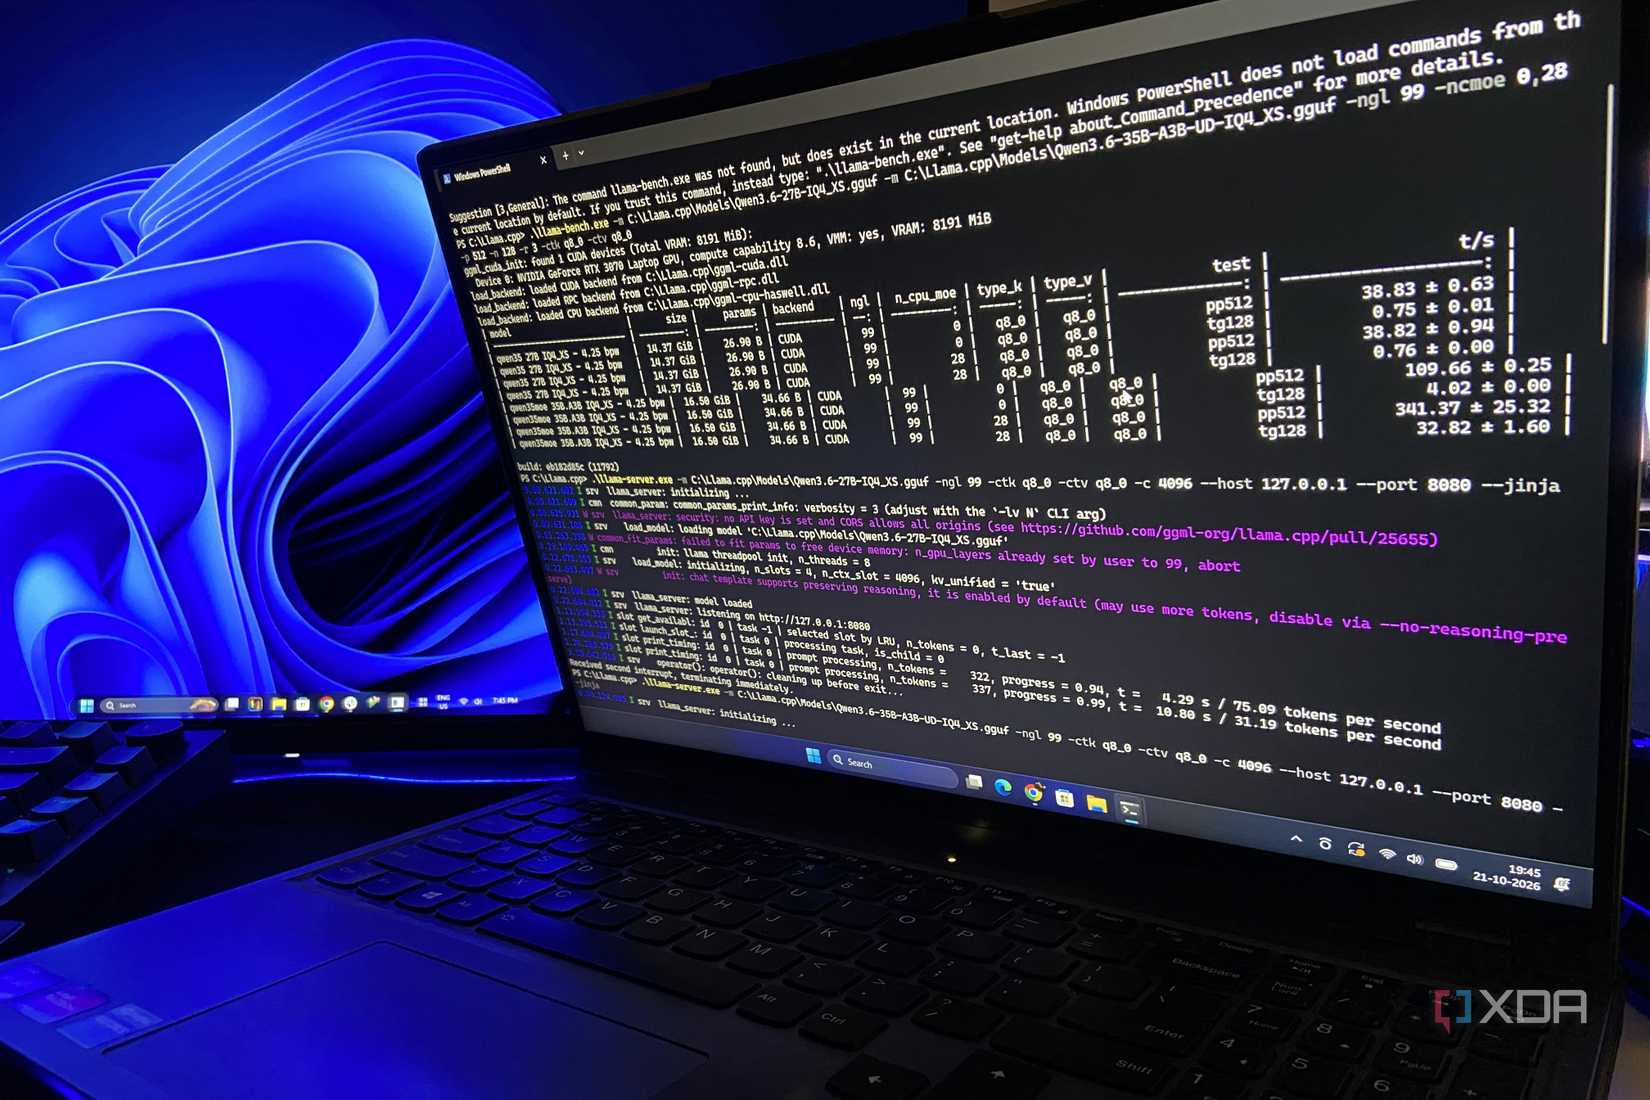
Mô hình Mixture-of-Experts (MoE) gồm nhiều expert, nhưng bộ định tuyến chỉ kích hoạt một nhóm trong mỗi lượt suy luận. Với Qwen3.6-35B-A3B, khoảng 3 tỷ trong tổng số 35 tỷ tham số được kích hoạt theo mô tả của XDA Developers. Do đó, việc đặt toàn bộ trọng số expert trên GPU không phải lúc nào cũng là cách sử dụng VRAM hiệu quả nhất.
Ngược lại, attention, embedding, trọng số dùng chung và KV cache liên quan trực tiếp đến quá trình sinh token. Giữ những phần này trên GPU trong khi chuyển một phần expert sang RAM là điểm khác biệt của cách làm này. Lợi ích là giảm lượng trọng số phải giữ trong VRAM, còn đánh đổi là hiệu năng phụ thuộc thêm vào bộ nhớ hệ thống. Việc chỉ kích hoạt một phần tham số không làm phần trọng số còn lại biến mất: máy vẫn cần đủ bộ nhớ để chứa mô hình.
Cờ –n-cpu-moe điều chỉnh số lớp expert chuyển sang RAM
Tài liệu CLI chính thức của llama.cpp mô tả -ncmoe hoặc --n-cpu-moe N là tùy chọn giữ trọng số MoE của N lớp đầu tiên trên CPU. Có thể kết hợp với -ngl 99 để yêu cầu nạp các lớp lên GPU trước; tùy chọn CPU-MoE sau đó giữ expert thuộc các lớp được chỉ định trong bộ nhớ hệ thống.
Giá trị N không phải thang tăng tốc. Đẩy nhiều lớp hơn sang RAM thường giải phóng thêm VRAM, nhưng cũng khiến nhiều expert phải lấy dữ liệu từ bộ nhớ hệ thống. Vì vậy, nên bắt đầu ở mức vừa đủ để mô hình khởi chạy rồi giảm N từng bước, theo dõi VRAM và tốc độ thay vì mặc định rằng con số lớn hơn sẽ tốt hơn.
Benchmark cho thấy MoE và Dense phản ứng khác nhau
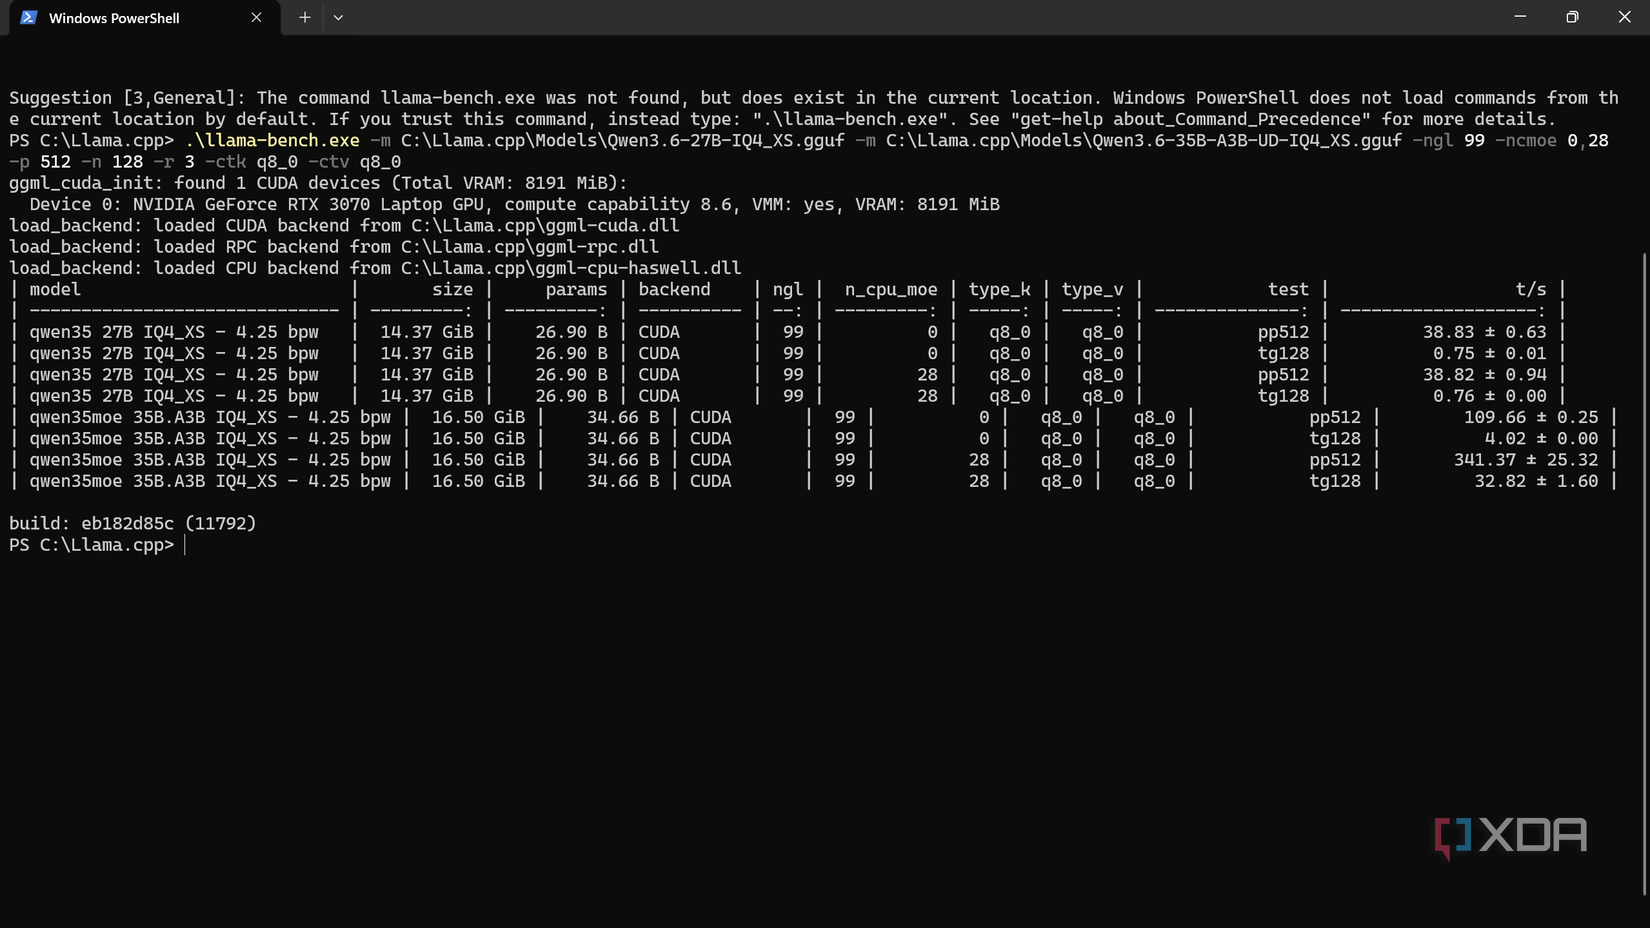
Trong thử nghiệm được XDA Developers mô tả, Lenovo Legion 5 dùng RTX 3070 Mobile 8GB chạy llama-bench với prompt 512 token, sinh 128 token, lặp ba lần và KV cache q8_0. Qwen3.6-35B-A3B ở định dạng UD-IQ4_XS có dung lượng 16,50 GiB đạt 4,02 token/giây khi không chuyển lớp MoE sang RAM; ở mức 28 lớp, kết quả là 32,82 token/giây. Đây là số đo của cấu hình cụ thể, không phải cam kết cho mọi GPU 8GB hay mọi bản lượng tử hóa.
| Mô hình và cấu hình | Lớp MoE trong RAM | Xử lý prompt (token/giây) | Sinh token (token/giây) |
|---|---|---|---|
| Qwen3.6-27B Dense, IQ4_XS, 14,37 GiB | Không áp dụng | 38,83 | 0,75 |
| Qwen3.6-35B-A3B MoE, UD-IQ4_XS, 16,50 GiB | 0 | 109,66 | 4,02 |
| Qwen3.6-35B-A3B MoE, UD-IQ4_XS, 16,50 GiB | 28 | 341,37 | 32,82 |
Số liệu: XDA Developers, đo bằng llama-bench trên Lenovo Legion 5 với RTX 3070 Mobile 8GB.
Kết quả của mô hình Dense không thể so trực tiếp như một phép thử offload tương đương: Dense không có nhóm expert riêng để chuyển theo cờ này. Đây là khác biệt kiến trúc quan trọng, không phải một thiết lập bị bỏ sót. Nếu đang dùng mô hình Dense, cần tìm cách giảm dung lượng bộ nhớ khác; --n-cpu-moe không phải giải pháp chung cho mọi LLM.
Thử cấu hình theo VRAM và ngữ cảnh thay vì sao chép một con số
Trước tiên, xác nhận mô hình là MoE và bản GGUF, mức lượng tử hóa cùng độ dài context có phù hợp với RAM máy hay không. Thử với số lớp chuyển sang CPU thấp, sau đó tăng dần nếu gặp lỗi hết VRAM. Khi mô hình chạy ổn định, giảm N từng nấc để xem có thể giữ thêm expert trên GPU mà không gây lỗi hay không.
Nếu khởi chạy thất bại vì hết bộ nhớ, giảm context cũng là một hướng cần thử: KV cache tăng theo lượng ngữ cảnh và có thể chiếm phần VRAM mà trọng số chưa dùng. Sau đó mới điều chỉnh số lớp MoE. Mỗi lần chỉ thay một tham số, ghi lại việc mô hình có khởi chạy hay không và tốc độ sinh token để tránh nhầm nguyên nhân.
llama-cli -m /duong-dan/toi-model.gguf -ngl 99 --n-cpu-moe 28 -c 4096Lệnh trên chỉ là khung minh họa; thay đường dẫn, tên executable và giá trị N theo bản llama.cpp cùng mô hình đang dùng. Giá trị 28 là mức trong phép thử nói trên, không phải thiết lập mặc định được bảo đảm phù hợp với GPU 6GB, 8GB hay mọi biến thể MoE. Máy cũng cần đủ RAM hệ thống để chứa phần trọng số được chuyển khỏi GPU.
Thủ thuật này mở rộng khả năng chạy mô hình chứ không biến RAM thành VRAM
Với người dùng GPU phổ thông, lợi ích thực tế là có thêm lựa chọn chạy MoE cục bộ khi toàn bộ trọng số không vừa VRAM. Đổi lại, tốc độ sẽ tùy thuộc vào lượng expert phải chuyển, băng thông bộ nhớ và cấu hình máy. Con số 32,82 token/giây trong benchmark là đáng chú ý, nhưng chỉ có ý nghĩa khi gắn với RTX 3070 Mobile, Qwen3.6-35B-A3B, UD-IQ4_XS và các tham số thử đã nêu.
Người dùng nên ưu tiên tìm điểm cân bằng: đủ lớp chuyển để tránh OOM, nhưng không chuyển nhiều hơn cần thiết. Với mô hình Dense, hoặc khi RAM hệ thống không đủ, cờ này không giải quyết được nút thắt. Tài liệu và cách đặt tham số có thể thay đổi theo phiên bản llama.cpp, vì vậy hãy kiểm tra phần trợ giúp của đúng bản đang cài.
Nguồn tham khảo: Tài liệu CLI llama.cpp; XDA Developers; Aliteq