Tóm tắt nhanh
--n-cpu-moechuyển trọng số chuyên gia của mô hình MoE sang RAM hệ thống; nó không làm mọi mô hình nhanh hơn.- Thiết lập này có ích khi GPU bị quá tải VRAM và driver phải chuyển dữ liệu qua PCIe; nếu mô hình đã vừa VRAM, offload thêm thường làm chậm.
- Với mô hình Dense, speculative decoding dùng mô hình phụ tạo trước token để mô hình chính xác thực theo lô.
- Ưu tiên để
--fittự bố trí trên bản llama.cpp hiện hành, rồi đo lại trên máy của bạn.
Trên laptop RTX 3070 di động với 8GB VRAM, tác giả XDA Abhinav Raj ghi nhận tốc độ Qwen3.6-35B-A3B tăng từ 4,02 lên 32,82 token/giây sau khi đặt --n-cpu-moe ở mức 28. Con số này không chứng minh CPU nhanh hơn GPU: nó cho thấy cấu hình ban đầu có thể đang mắc nghẽn do thiếu chỗ trong VRAM.
Offload MoE chỉ có ích khi GPU đang quá tải
Mô hình Mixture-of-Experts (MoE) chứa nhiều nhóm trọng số chuyên gia, nhưng bộ định tuyến chỉ chọn một phần trong số đó để xử lý mỗi token. Vì vậy, với MoE, có thể chuyển một phần trọng số chuyên gia ít được truy cập sang RAM hệ thống mà vẫn giữ các thành phần nóng hơn trên GPU.
Trong llama.cpp, --n-cpu-moe N đặt trọng số chuyên gia của N tầng đầu tiên trong RAM. Cờ này không chuyển toàn bộ mô hình: attention, KV cache, bộ định tuyến và các chuyên gia dùng chung không thuộc nhóm tensor được xử lý bởi thiết lập đó. Đây là điểm quan trọng khi chẩn đoán thiếu bộ nhớ; giảm VRAM dành cho chuyên gia không đồng nghĩa mọi phần còn lại cũng rời GPU.
Kết quả trên chiếc Legion 5 Pro với 32GB DDR4-3200 là một ví dụ có điều kiện: cùng mô hình Qwen3.6-35B-A3B ở định dạng UD-IQ4_XS, tác giả đo được 4,02 token/giây khi không offload và 32,82 token/giây với --n-cpu-moe 28. Đây là phép đo trên cấu hình cụ thể, không phải mức tăng có thể áp dụng cho mọi GPU, RAM hay bản lượng tử hóa.
Lý do có thể nằm ở trạng thái quá tải bộ nhớ. Trên Windows, NVIDIA System Memory Fallback có thể để một phần cấp phát CUDA dựa vào RAM máy chủ rồi chuyển dữ liệu qua PCIe. Khi việc này diễn ra âm thầm, mô hình vẫn chạy nhưng tốc độ có thể tụt mạnh. Chỉ định rõ các trọng số MoE cần ở RAM giúp tránh để driver xử lý tình trạng quá tải theo cách thiếu kiểm soát. Trên máy đã đủ VRAM, chiều ngược lại mới là điều thường thấy: đẩy thêm trọng số qua PCIe làm giảm tốc độ.
Vì thế, đừng tăng N theo kiểu “càng nhiều càng tốt”. Tìm mức offload thấp nhất giúp mô hình vừa bộ nhớ mà vẫn còn khoảng trống cho ngữ cảnh và KV cache; nếu đang dùng bản llama.cpp có --fit bật mặc định, hãy thử cơ chế tự căn chỉnh trước. Việc đặt thủ công các cờ offload có thể khiến cơ chế tự động không còn tự quyết định vị trí trọng số.
Chọn MoE thay vì Dense khi cần tận dụng RAM hệ thống
--n-cpu-moe nhắm vào trọng số chuyên gia, nên không áp dụng cho mô hình Dense như Gemma 4 12B. Mô hình Dense dùng toàn bộ trọng số trong mỗi lượt suy luận; không có nhóm chuyên gia “nhàn rỗi” để chuyển sang RAM theo cách tương tự. Nếu VRAM hạn chế nhưng RAM dư dả, một mô hình MoE có thể phù hợp hơn, miễn là tốc độ RAM và kết nối PCIe không trở thành nút thắt.
Phần mềm chạy mô hình cũng quyết định bạn can thiệp được đến đâu. llama.cpp cung cấp cờ dòng lệnh cho việc tinh chỉnh; LM Studio có thanh trượt điều chỉnh mức offload theo tầng. XDA ghi nhận Ollama không cung cấp một điều khiển riêng tương đương trong giao diện tại thời điểm bài viết được đăng. Tuy nhiên, khác biệt ở giao diện không thay thế việc đo thực tế: các bản runtime và thiết lập mặc định có thể thay đổi, nên cần kiểm tra phiên bản mình đang dùng.
Speculative decoding tăng tốc Dense bằng cách dự đoán trước
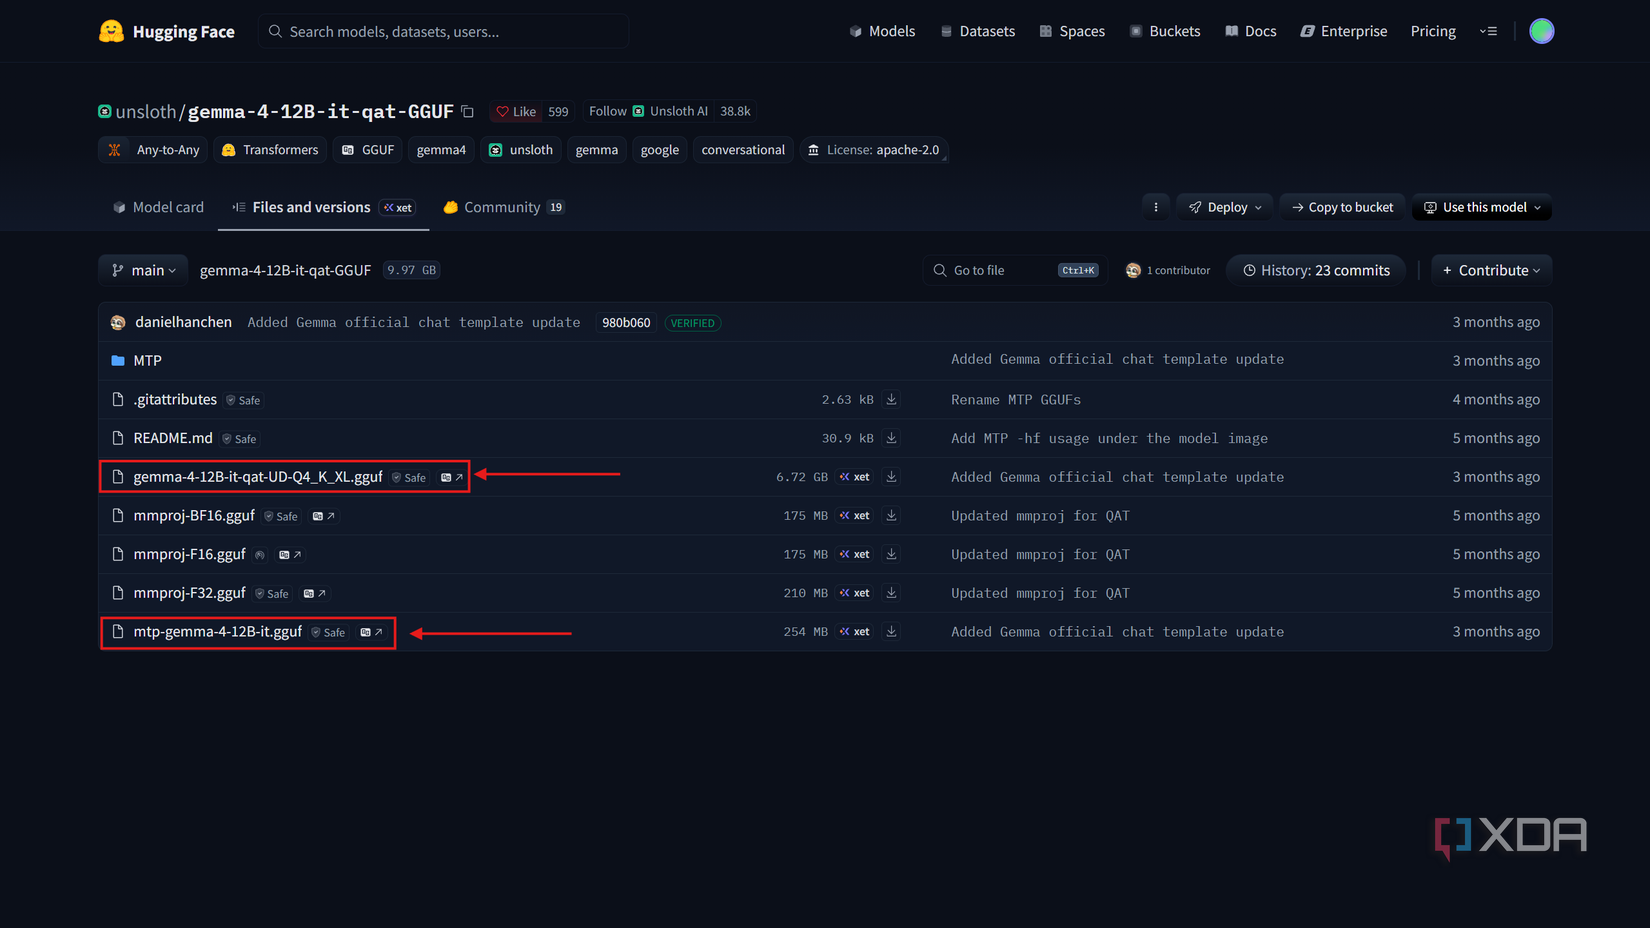
Với mô hình Dense, một hướng khác là speculative decoding. Mô hình phụ nhỏ hơn tạo một nhóm token dự đoán trước; mô hình chính kiểm tra cả nhóm rồi chấp nhận phần khớp, thay vì tự sinh tuần tự từng token. Tài liệu llama.cpp mô tả cách làm này tận dụng hiệu quả tính toán theo lô, nhưng mức tăng phụ thuộc vào việc các dự đoán được chấp nhận thường xuyên đến đâu.
Trong thử nghiệm cá nhân được XDA mô tả, Unsloth Gemma 4 12B QAT kết hợp drafter MTP 242MB ở ngữ cảnh 32K đạt trung bình 179 token/giây, so với 75 token/giây khi không dùng drafter, với cùng thiết lập sampler. Drafter vẫn chiếm một phần VRAM, nên lợi ích tốc độ phải cân cùng bộ nhớ còn lại. Đây không phải cam kết hiệu năng cho mọi cấu hình.
Hai cách tối ưu giải quyết hai vấn đề khác nhau: offload MoE có thể giúp mô hình vượt giới hạn dung lượng GPU khi phân bổ bộ nhớ đang gây nghẽn; speculative decoding giảm số lượt sinh tuần tự của mô hình chính khi drafter dự đoán tốt. Chúng không biến RAM hệ thống thành VRAM và cũng không làm mọi mô hình lớn chạy nhanh hơn tự động.
Nên đo từ cấu hình mặc định trước khi chỉnh tay
Với llama.cpp mới, hãy chạy thử cấu hình mặc định và theo dõi log, dung lượng VRAM, tốc độ token cùng mức sử dụng RAM. Nếu mô hình không vừa, thử điều chỉnh từng biến một rồi so bằng cùng một prompt và cùng thiết lập lấy mẫu. Khi dùng MoE, tăng dần mức offload đến khi vừa bộ nhớ; sau đó dừng và so tốc độ. Nếu hiệu năng giảm khi tăng N, quay lại mức thấp hơn.
Người dùng Ollama hoặc LM Studio nên kiểm tra các tùy chọn phiên bản hiện tại trước khi chuyển runtime chỉ vì thiếu một cờ. Còn nếu mô hình vốn đã vừa VRAM, giữ trọng số trên GPU thường hợp lý hơn. Việc mua thêm VRAM chỉ nên là một phương án sau khi đã xác định đâu đang chiếm bộ nhớ—trọng số, ngữ cảnh hay KV cache—và đo được rằng cấu hình phần mềm không giải quyết được giới hạn đó.
Nguồn tham khảo: XDA Developers; Aliteq; Tài liệu llama.cpp về speculative decoding