Tóm tắt nhanh
- Whisper chuyển giọng nói thành văn bản; Qwen phân loại câu nói thành các việc và thời điểm dự kiến.
- Mã chương trình thông thường nên tự tính ngày cụ thể, thay vì giao phép cộng ngày cho mô hình ngôn ngữ.
- Trong cấu hình được mô tả, Qwen 3.5-9B Q4_K_M chạy cùng quy trình dùng khoảng 7GB VRAM trên RTX 4070 Ti 12GB.
- Đây là ví dụ tự xây dựng trên PC, không phải ứng dụng cài xong là dùng ngay; phần ghép giao diện, ghi âm và xử lý vẫn cần công sức kỹ thuật.
Một ghi chú thoại có thể chứa vài việc và mốc thời gian, nhưng công cụ đọc chính tả thường chỉ trả lại nguyên văn. Một cách làm khác là tách quy trình thành ba phần: Whisper nghe và chép lời, mô hình ngôn ngữ rút ra việc cần làm, còn mã Python xử lý ngày tháng theo quy tắc cố định.
Chia việc giữa hai mô hình giúp đầu ra dễ kiểm soát hơn
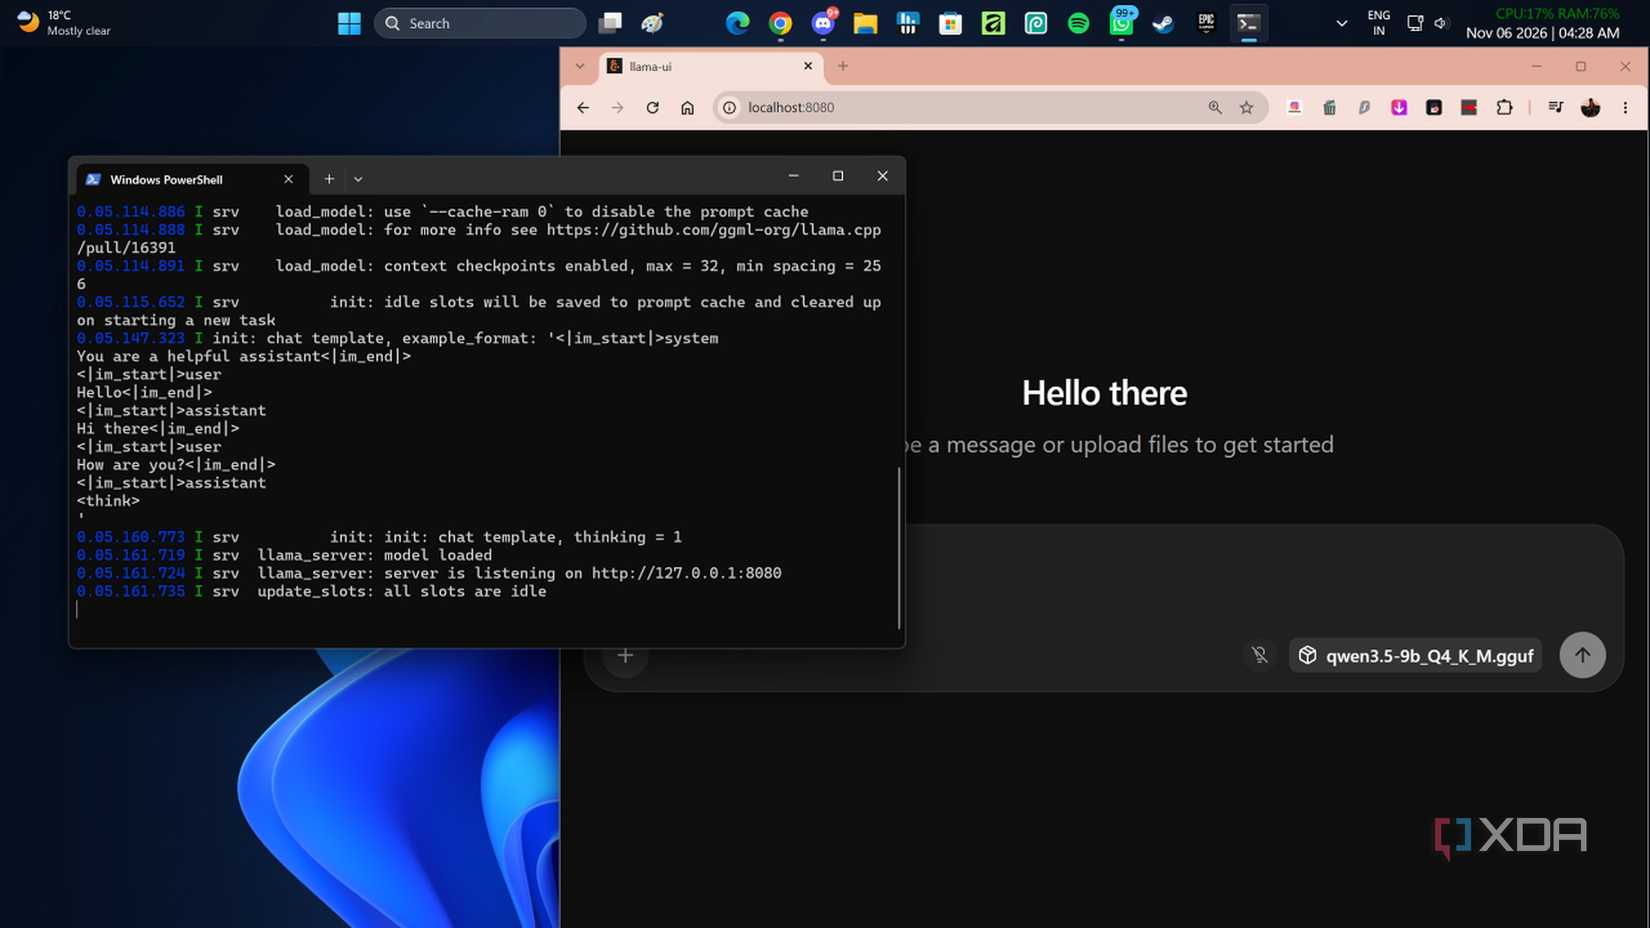
Whisper và Qwen giải hai bài toán khác nhau. Whisper nhận âm thanh và tạo bản chép; Qwen nhận phần chữ đó rồi chuyển câu nói tự nhiên thành dữ liệu có cấu trúc, chẳng hạn tên việc và ý định thời gian. Dùng một mô hình cho cả nhận dạng tiếng nói lẫn diễn giải khiến mỗi lỗi khó truy ra nằm ở khâu nghe hay khâu hiểu.
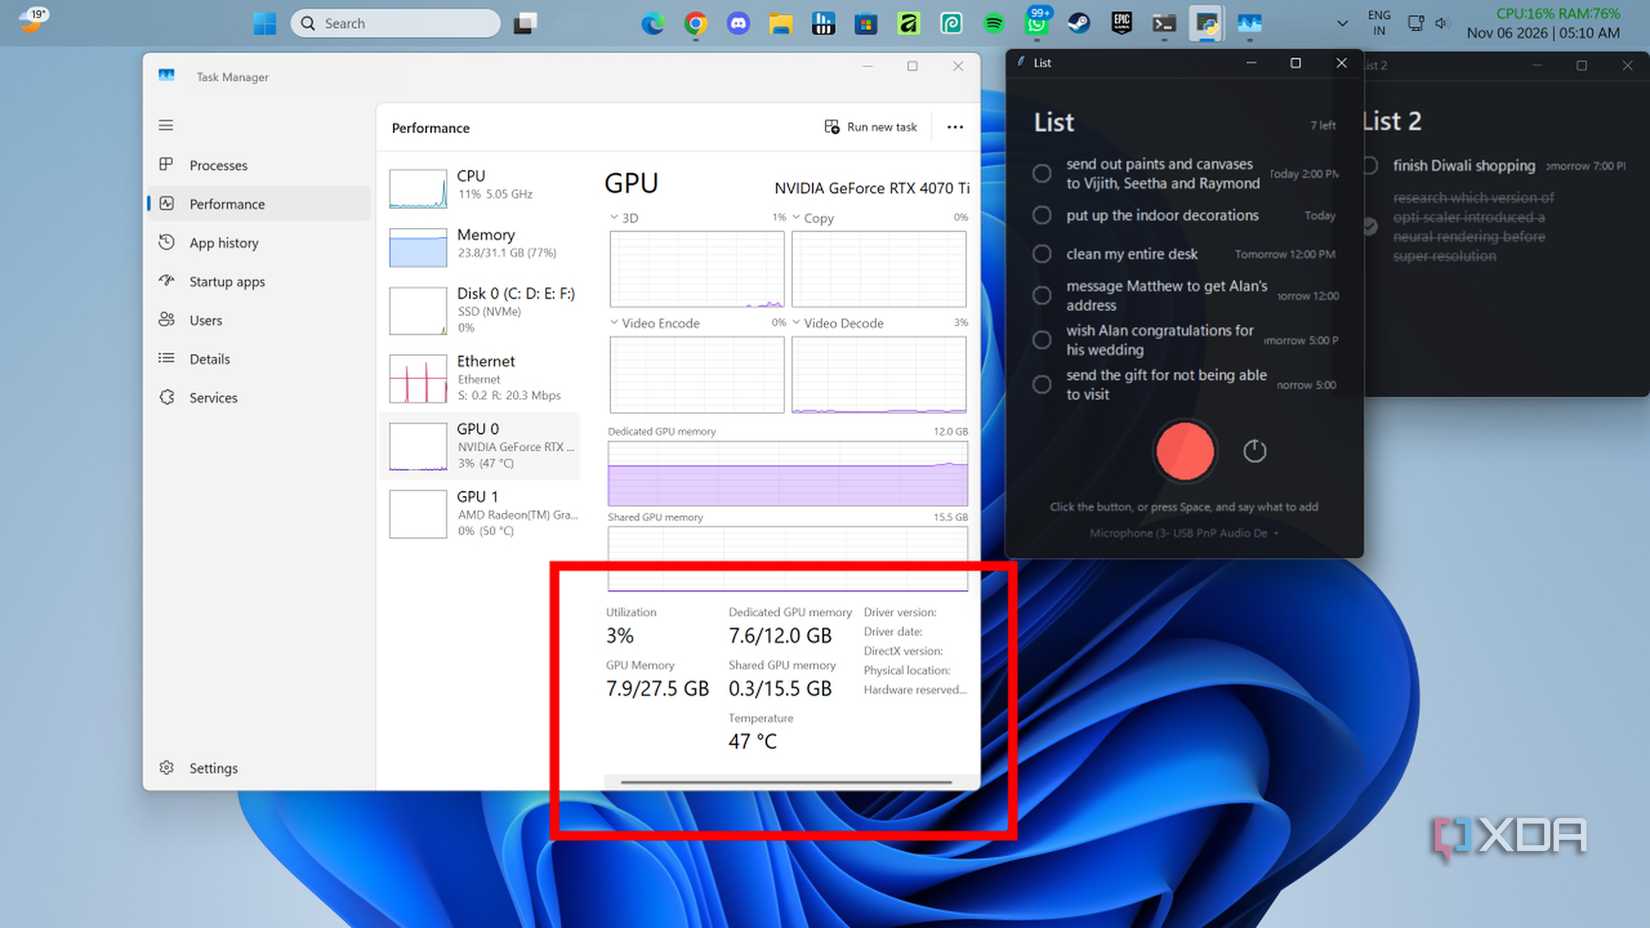
Trong ví dụ của Samarveer Singh trên XDA Developers, cấu hình là Qwen 3.5-9B lượng tử hóa Q4_K_M qua llama.cpp. Tác giả cho biết toàn bộ quy trình chiếm khoảng 7GB VRAM trên RTX 4070 Ti 12GB. Con số này là kết quả trên bộ máy và cách thiết lập của tác giả, không phải mức bảo đảm cho mọi PC; lượng bộ nhớ còn tùy mô hình, thiết lập và ứng dụng chạy đồng thời.
llama.cpp hỗ trợ chạy suy luận trên nhiều loại phần cứng, có các mức lượng tử hóa và chế độ kết hợp CPU với GPU. Điều đó cho phép người tự dựng thử nghiệm chọn cách phân bổ phù hợp, nhưng không xóa yêu cầu kiểm tra bộ nhớ thực tế trước khi chọn mô hình.
Để mã tính ngày thay vì yêu cầu LLM tự đặt lịch
Câu “mai mua đồ cho buổi tiệc cuối tuần” có hai lớp thông tin: việc cần làm và cách hiểu thời gian. LLM có thể trích xuất nội dung công việc cùng cụm thời gian như “ngày mai”, rồi trả dữ liệu có cấu trúc; đoạn mã thông thường mới đổi cụm đó thành ngày cụ thể dựa trên ngày hiện tại.
Đây là ranh giới đáng giữ. Mô hình có thể diễn giải ngôn ngữ linh hoạt, nhưng phép tính lịch nên có quy tắc xác định để cùng một đầu vào cho cùng một kết quả. Nếu giao cả hai việc cho LLM, sai lệch về ngày có thể lọt vào danh sách mà người dùng không nhận ra. Ứng dụng cũng cần xử lý rõ múi giờ, thời điểm ghi âm và các cụm mơ hồ như “cuối tuần này”; nếu không, phần mã chỉ biến một cách hiểu chưa chắc chắn thành ngày cụ thể.
Chạy phiên âm trên CPU có thể hợp lý với ghi chú ngắn
Whisper không nhất thiết phải chiếm GPU trong mọi cấu hình. Tác giả XDA cho biết các đoạn ghi âm dài 20–30 giây được CPU xử lý trong vài giây trên máy của họ, nên họ để GPU dành cho Qwen. Đây là kết quả sử dụng cá nhân, không phải mốc tốc độ áp dụng cho mọi bộ xử lý hay mô hình phiên âm.
Cách phân bổ ấy còn giúp tránh một nhóm lỗi cài đặt GPU. Tài liệu faster-whisper nêu các thư viện NVIDIA cần có khi chạy trên GPU với CUDA 12, gồm cuBLAS và cuDNN 9. Nếu máy chưa cấu hình đúng các thành phần này, chạy phiên âm trên CPU là một phương án giảm phụ thuộc; đổi lại, thời gian xử lý sẽ khác theo CPU, mô hình và độ dài âm thanh.
Giao diện gọn mới quyết định quy trình có được dùng thường xuyên
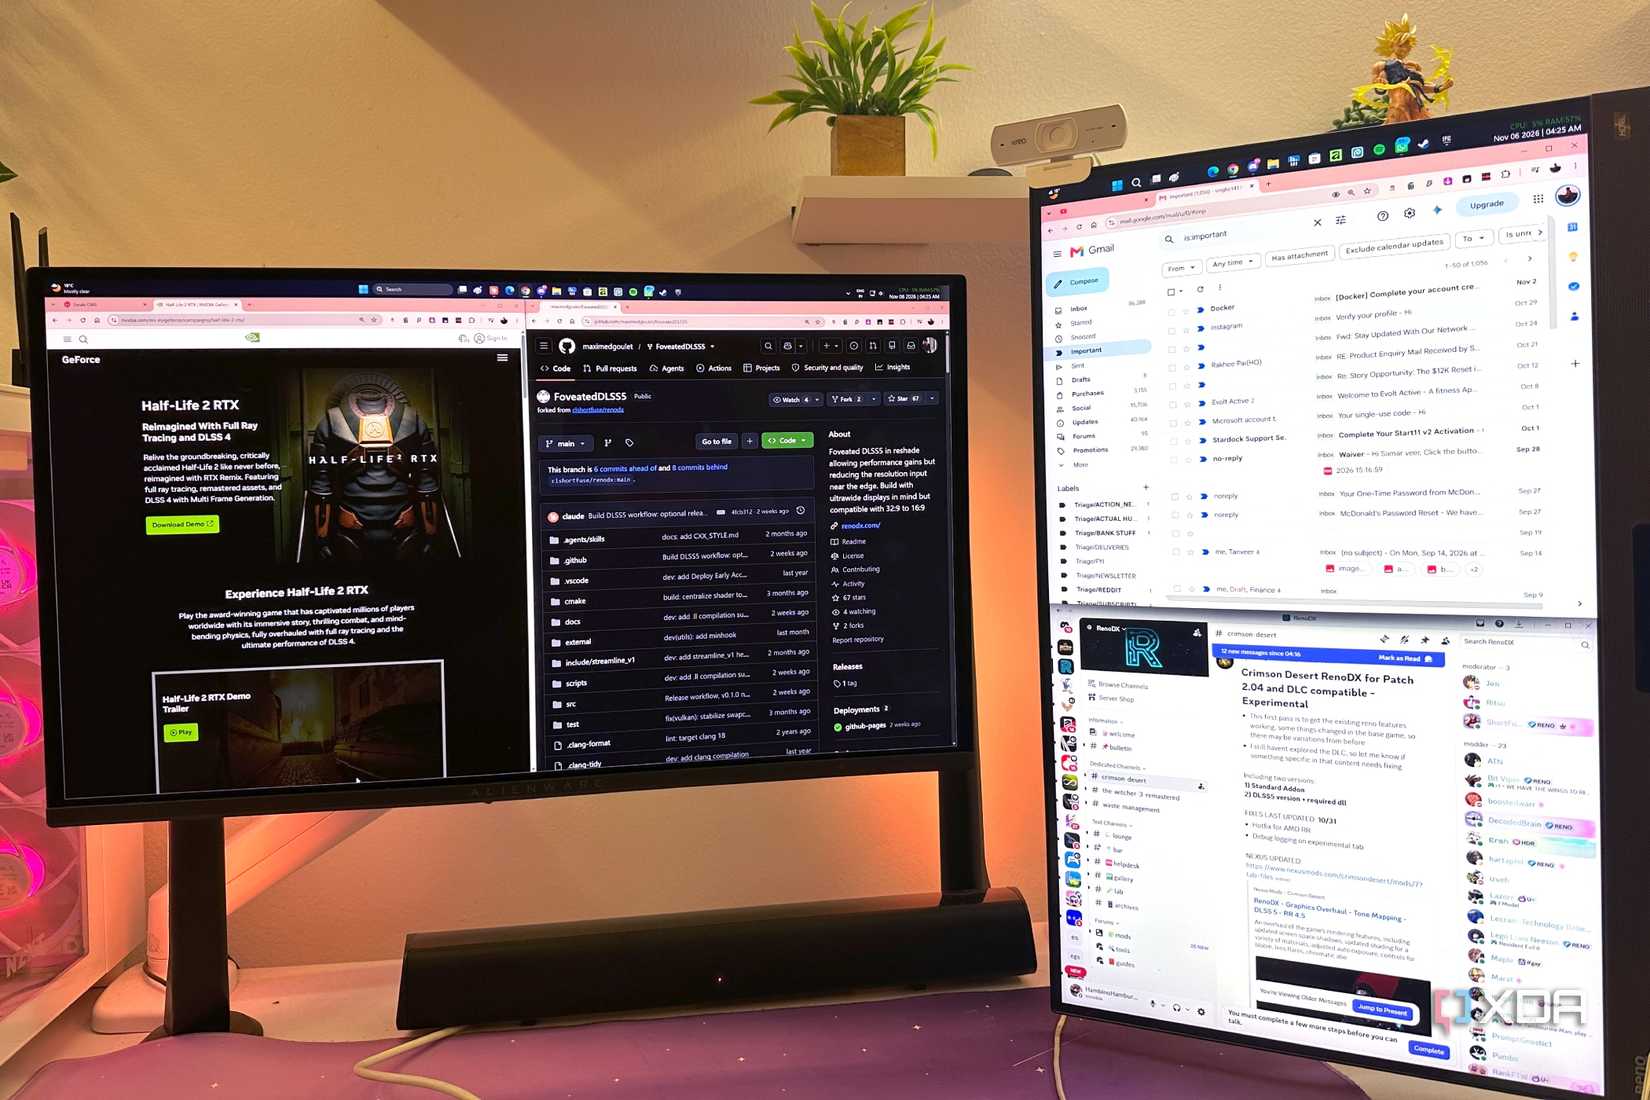
Một pipeline có thể chạy đúng nhưng vẫn bất tiện nếu người dùng phải mở ứng dụng ghi âm, khởi động máy chủ mô hình rồi tự chuyển tệp sang script. Tác giả đã gói các bước vào một chương trình Python có giao diện, nơi có thể ghi âm, chuyển lời nói thành văn bản và xem các mục việc theo lô sáu mục. Bài viết mô tả một dự án cá nhân; không có mã nguồn hay hướng dẫn cài đặt hoàn chỉnh được cung cấp trong phần tư liệu công khai ở đây.
Với người muốn tự làm, nên kiểm tra từng khâu riêng trước khi ghép: âm thanh có được ghi và đọc đúng không, bản chép có đủ chính xác không, đầu ra của Qwen có đúng cấu trúc mong muốn không, rồi phép tính ngày có xử lý được cụm mơ hồ không. Một giao diện duy nhất chỉ hữu ích khi các bước phía sau có thể phục hồi khi lỗi, thay vì âm thầm bỏ mất ghi chú.
Xử lý nội bộ giảm việc gửi ghi chú riêng tư lên dịch vụ đám mây
Giữ nhận dạng và xử lý trên PC giúp tránh phải gửi nội dung ghi chú tới một API đám mây trong quy trình này. Điều đó phù hợp với các lời nhắc chứa lịch cá nhân hoặc việc riêng, nhưng “chạy cục bộ” không tự động đồng nghĩa dữ liệu được bảo vệ tuyệt đối: ứng dụng vẫn có thể lưu tệp âm thanh, bản chép hoặc danh sách việc trên ổ đĩa, và cách sao lưu hay phân quyền của máy vẫn quan trọng.
Đổi lại, người dùng phải tự cài mô hình, quản lý tài nguyên và sửa lỗi phụ thuộc. Với ghi chú ngắn, dùng CPU cho phiên âm có thể giảm bớt cấu hình GPU; còn phần đáng đầu tư nhất là đặt ranh giới rõ giữa nhận dạng, trích xuất ý định và tính lịch. Quy trình này chưa loại bỏ lỗi nghe nhầm tên riêng hay độ trễ khởi động mô hình, nhưng cách chia vai khiến lỗi dễ khoanh vùng hơn.
Nguồn tham khảo: XDA Developers; llama.cpp trên GitHub; faster-whisper trên GitHub