Tóm tắt nhanh
- Sam Altman nói tại Stanford GSB rằng vá từng lỗ hổng sẽ không còn đủ khi năng lực AI tiếp tục tăng.
- Ông đề xuất chuyển mô hình phòng thủ sang dùng chính AI để tìm và xử lý rủi ro.
- Đây là cảnh báo chiến lược, không phải thông báo ra mắt sản phẩm bảo mật của OpenAI.
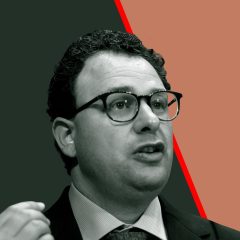
Sam Altman cho rằng các tổ chức sẽ không thể dựa mãi vào việc vá từng lỗ hổng khi AI ngày càng giỏi tìm lỗi bảo mật, đồng thời kêu gọi chuyển sang một mô hình phòng thủ có AI tham gia. CEO OpenAI phát biểu như vậy trong buổi tọa đàm View From The Top tại Stanford Graduate School of Business.
Vá những lỗi đã biết không giải quyết được tốc độ phát hiện mới
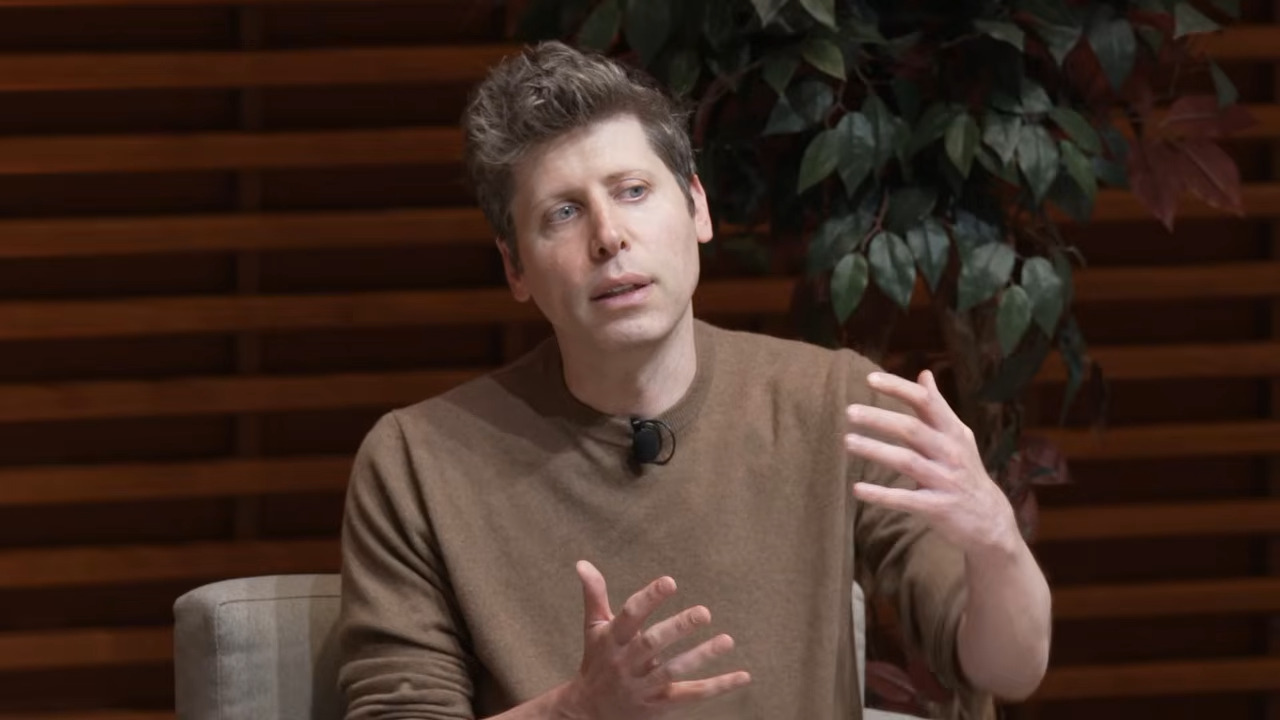
Altman nhìn lại phản ứng sau khi các mô hình AI bắt đầu tìm được nhiều lỗ hổng: một số tổ chức đã sửa những lỗi được phát hiện, rồi phần lớn chuyển sự chú ý sang việc khác. Theo ông, cách phản ứng đó bỏ qua khả năng các mô hình sẽ tiếp tục tiến bộ và tìm ra những lỗi mới, kể cả lỗi nằm ngoài cách hình dung thông thường về năng lực của kẻ tấn công.
Ông nói các mô hình có thể tìm ra lỗi ở mức bất thường, thậm chí liên quan đến phần cứng. Đây là nhận định của Altman về hướng phát triển và rủi ro, không phải bằng chứng cho thấy mọi mô hình hiện nay đều có thể khai thác mọi hệ thống. Khác biệt quan trọng nằm ở tốc độ: nếu công cụ tự động rà soát được nhiều mã hơn, quy trình chỉ dựa vào đội ngũ con người phát hiện, phân loại rồi vá từng lỗi có nguy cơ bị quá tải.
Vì vậy, câu “không thể vá tất cả lỗi” không có nghĩa là ngừng cập nhật phần mềm. Bản vá vẫn cần thiết để xử lý lỗ hổng đã xác nhận; điều Altman đặt vấn đề là xem vá lỗi như lớp phòng thủ duy nhất, trong khi khả năng dò tìm đang mở rộng.
Phòng thủ bằng AI không thể chỉ là một lớp quét tự động
Altman đề xuất chuyển mô hình phòng thủ sang sử dụng cùng loại công nghệ để dựng một “lá chắn” mới. Ý tưởng này có thể bao gồm rà soát mã liên tục, phát hiện hành vi đáng ngờ và ưu tiên xử lý lỗ hổng trước khi chúng bị khai thác. Nhưng phát biểu tại Stanford không mô tả một sản phẩm cụ thể hay quy trình triển khai đã được kiểm chứng; “defense shield” ở đây là cách nói về hướng phòng thủ, không phải tên một dịch vụ OpenAI vừa công bố.
AI phòng thủ cũng không tự động triệt tiêu rủi ro. Hệ thống phải được cấp quyền truy cập đủ rộng để quan sát và phản ứng, trong khi quyền quá lớn có thể khiến một lỗi của chính công cụ hoặc một cảnh báo sai gây gián đoạn hoạt động. Do đó, doanh nghiệp vẫn cần người chịu trách nhiệm, giới hạn quyền của tác nhân tự động, lưu dấu quyết định và có cách khôi phục khi biện pháp phản ứng gây ảnh hưởng ngoài dự kiến.
Cuộc đua AI an ninh mạng đặt ra câu hỏi về quyền mở mô hình
Cảnh báo của Altman có một mâu thuẫn đáng chú ý: OpenAI là một trong những công ty đang phát triển các mô hình ngày càng có năng lực, nhưng người đứng đầu công ty lại nói năng lực AI có thể làm suy yếu cách phòng thủ hiện tại. Điều đó khiến bảo mật không còn chỉ là câu chuyện mua thêm công cụ quét lỗi; nó còn liên quan đến cách các hãng phát hành mô hình và cách tổ chức kiểm soát việc sử dụng chúng.
Trong cùng cuộc trò chuyện, Altman nói ông không nghĩ OpenAI có thể sớm phát hành mở trọng số mô hình nội bộ mạnh nhất một cách có trách nhiệm, nếu hệ thống phòng thủ mạng chưa thay đổi tương xứng. Đây là quan điểm của ông về điều kiện an toàn, không phải chính sách đã được công bố dưới dạng cam kết hay lịch phát hành. Với doanh nghiệp, điều thực tế hơn lúc này là duy trì bản vá, kiểm kê tài sản và quyền truy cập, đồng thời đánh giá công cụ AI theo khả năng phát hiện lẫn rủi ro khi trao quyền tự động.
Chuyển sang phòng thủ có AI không làm mất nhu cầu vá lỗ hổng; nó cho thấy quy trình bảo mật cần phát hiện sớm hơn và xử lý theo mức độ rủi ro, thay vì chờ danh sách lỗi dài thêm. Câu hỏi còn bỏ ngỏ là liệu các tổ chức có thể triển khai lớp tự động đó với đủ kiểm soát trước khi năng lực tìm lỗi tiến xa hơn hay không.
Nguồn tham khảo: Stanford Graduate School of Business