Tóm tắt nhanh
- DFRobot niêm yết DX-M1 ở mức 139 USD, với hiệu năng công bố 25 TOPS INT8 và công suất mô-đun 2–5 W.
- Card dùng chuẩn M.2 2280 M-Key, giao tiếp PCIe Gen3 x4, có 4 GB LPDDR5 riêng; không phải ổ SSD.
- Phù hợp để triển khai suy luận AI tại thiết bị, nhưng cần kiểm tra mô hình với bộ công cụ DXNN thay vì chỉ nhìn TOPS.
- Không phù hợp với LLM lớn; tuy vậy, DEEPX đã công bố hỗ trợ một số mô hình ngôn ngữ nhỏ trên nền tảng DX-M1.
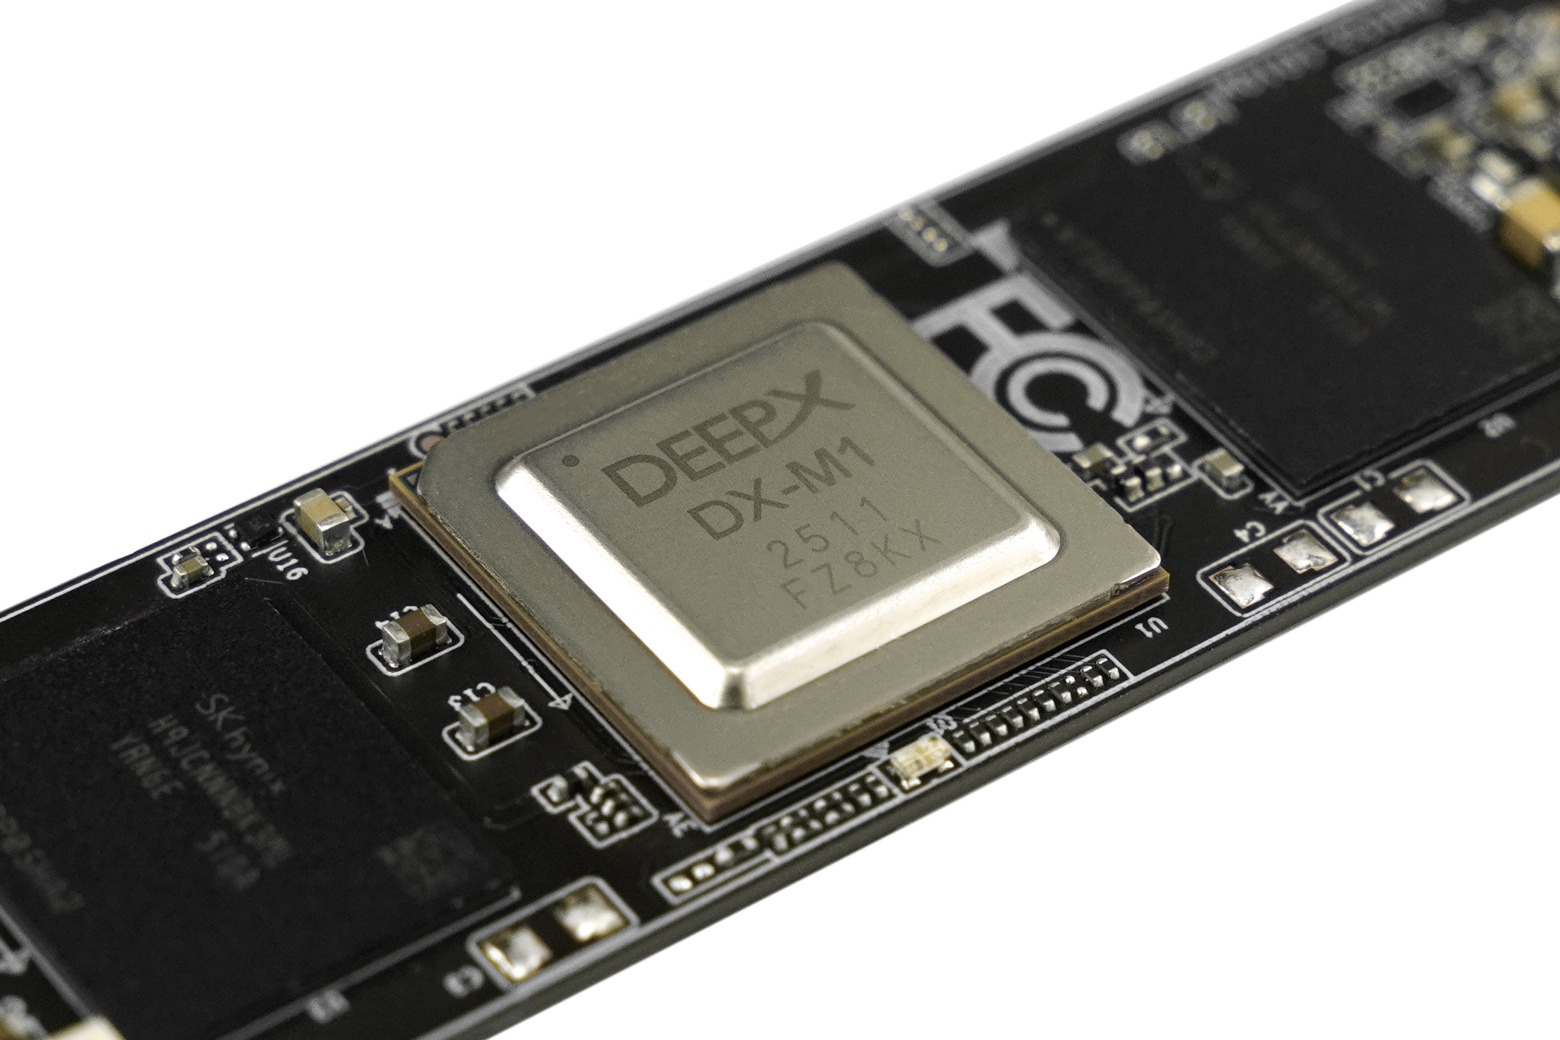
DFRobot đang bán mô-đun tăng tốc AI DX-M1 giá 139 USD trên cửa hàng quốc tế, đưa NPU của DEEPX vào một thanh M.2 có bộ nhớ riêng thay vì yêu cầu lắp card đồ họa rời. Điểm đáng quan tâm là khả năng bổ sung khối xử lý suy luận cho máy sẵn có, đặc biệt khi hệ thống cần chạy nhận diện hình ảnh liên tục mà bị giới hạn điện năng và không gian.
Nhưng mua một NPU rời khác với nâng cấp RAM hay SSD: ứng dụng phải sử dụng được phần cứng đó. Với DX-M1, bài toán đáng giải trước khi đặt hàng là mô hình có biên dịch được hay không, vừa bộ nhớ hay không và còn khe PCIe phù hợp để lắp hay không.
25 TOPS chỉ hữu ích khi mô hình chạy đúng trên NPU
DX-M1 đáng chú ý ở mức điện năng công bố thấp, nhưng 25 TOPS không tự cho biết hệ thống camera sẽ xử lý được bao nhiêu luồng hình. DFRobot công bố thông số INT8 và công suất 2–5 W cho mô-đun; đây không phải điện năng của cả máy chủ, camera hay thiết bị lưu trữ đi kèm.
| Thông số | DFRobot DX-M1 M.2 |
|---|---|
| Hiệu năng suy luận công bố | 25 TOPS INT8 |
| Công suất mô-đun công bố | 2–5 W |
| Bộ nhớ làm việc riêng | 4 GB LPDDR5 |
| Kích thước | 22 × 80 × 4,1 mm |
| Kết nối | M.2 M-Key, PCIe Gen3 x4, hỗ trợ chế độ x1 |
| Giá cửa hàng quốc tế | 139 USD |
Số liệu: DFRobot.
Với camera nhận diện vật thể, NPU chỉ đảm nhiệm một phần trong chuỗi xử lý. Máy chủ vẫn cần nhận dữ liệu, chuẩn bị ảnh và xử lý kết quả; nếu các bước này chậm, tăng năng lực tính toán của NPU chưa chắc cải thiện tương ứng tốc độ ứng dụng. Cũng vì vậy, không nên lấy TOPS chia cho giá bán rồi coi đó là thước đo duy nhất khi chọn phần cứng.
Để thấy mức độ phụ thuộc vào mô hình, bảng thử nghiệm do DEEPX công bố cho thấy kết quả rất khác nhau giữa các mạng. Đây là số đo của hãng trên nền tảng tham chiếu, không phải cam kết tốc độ cho mọi máy lắp mô-đun DFRobot.
| Mô hình, fps (cao hơn tốt hơn) | DEEPX DX-M1 | Company A, không nêu tên | NVIDIA Jetson AGX Xavier |
|---|---|---|---|
| LeViT_128 | 963 | 213 | 199 |
| ViT_tiny | 394 | 204 | 142 |
| YOLOv5m-seg | 138 | 60 | 39 |
| YOLOv7_tiny | 281 | 79 | 145 |
| YOLOv8l | 60 | 31 | 30 |
Số liệu: DEEPX. Các phép thử dùng INT8, batch=1, ở nhiệt độ phòng; DX-M1 và Company A kết nối PCIe với máy x86 dùng Core i7-14700K, còn Xavier chạy trên bộ phát triển Jetson AGX Xavier. DX-M1 dùng SDK tháng 9/2025, DX-Compiler 2.0.0 và DX-RT 3.0.0; Company A dùng tùy chọn random-calib-set với giá trị mặc định cho parser và compiler.
Khoảng cách lớn giữa các mô hình ngay trên DX-M1 cho thấy cần chọn phép thử gần ứng dụng thực tế. Bảng này không đo điện năng từng hệ thống, nên cũng không đủ để kết luận tiết kiệm bao nhiêu tiền điện so với GPU, càng không phải so sánh với mọi card đồ họa hiện nay.
4 GB RAM giới hạn mô hình, không loại trừ AI ngôn ngữ
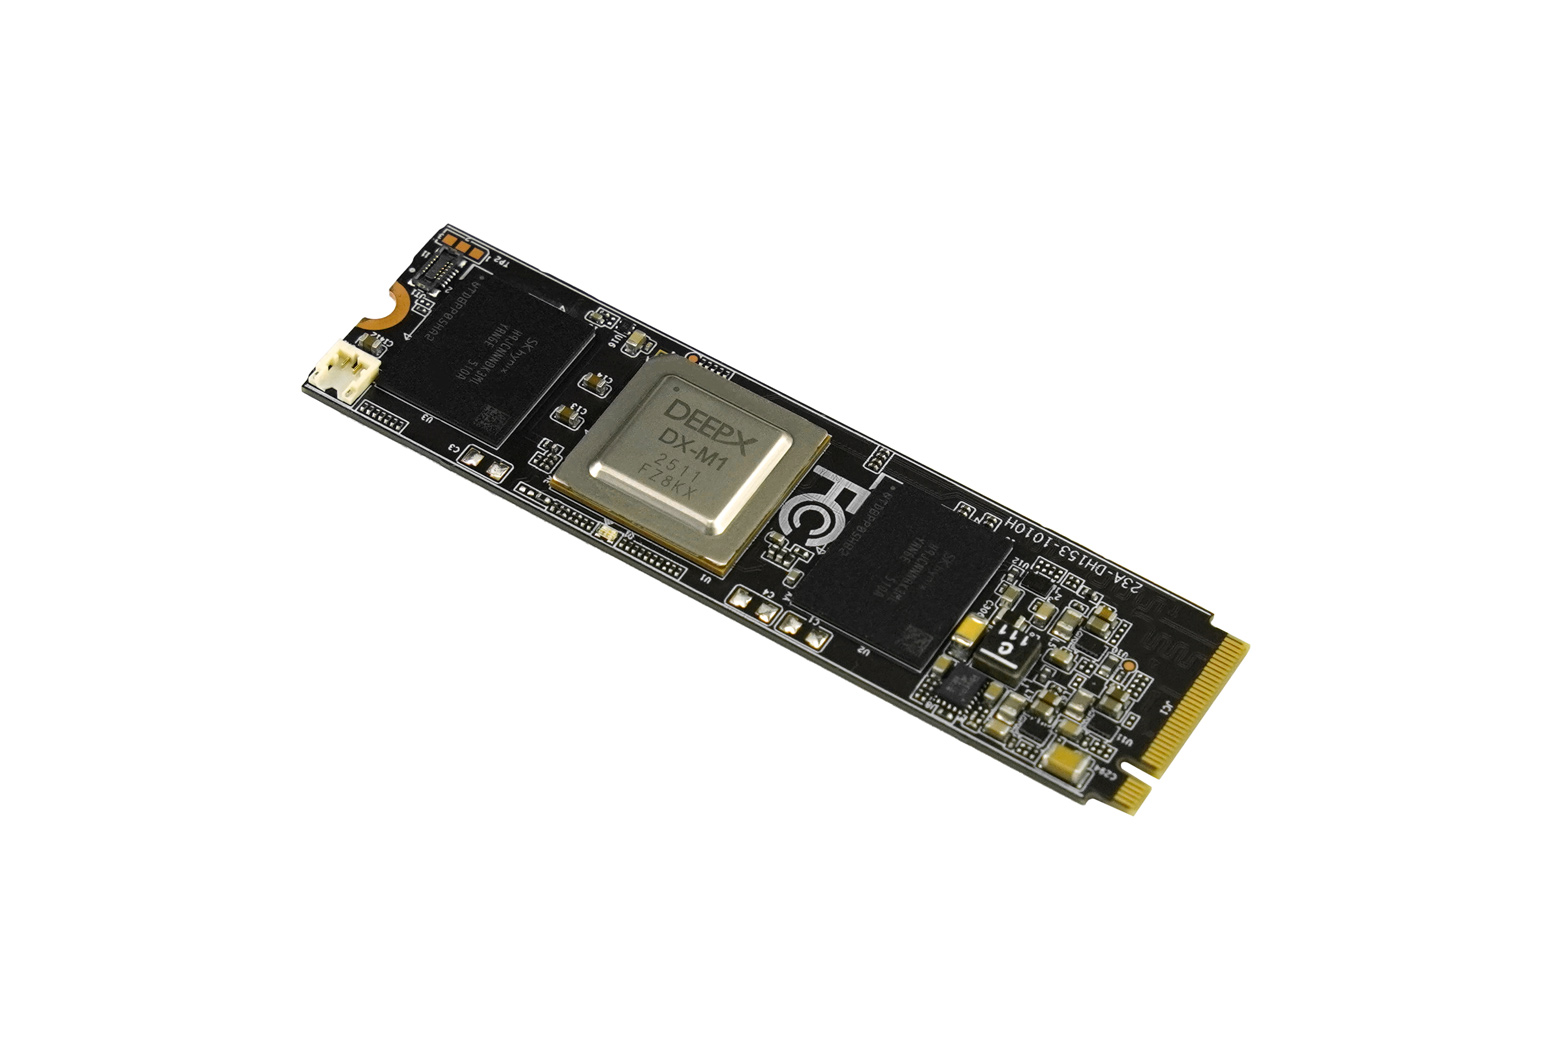
Giới hạn đáng lưu ý của bản DFRobot là dung lượng bộ nhớ, chứ không phải cứ mang tên NPU biên thì chỉ được chạy nhận diện ảnh. Mô-đun có 4 GB LPDDR5 riêng, nên người dùng không thể mặc định RAM dư trên máy chủ sẽ trở thành bộ nhớ làm việc của NPU.
Các mô hình ngôn ngữ lớn với hàng chục tỷ tham số không phải đích phù hợp cho cấu hình này. Ngoài trọng số, quá trình suy luận còn cần bộ nhớ phục vụ tính toán; vì thế, chỉ so dung lượng tệp mô hình với RAM vẫn chưa đủ để quyết định có chạy được hay không.
Ở chiều ngược lại, trang sản phẩm DEEPX hiện mô tả khả năng chạy mô hình ngôn ngữ nhỏ và mô hình thị giác-ngôn ngữ tới khoảng 4 tỷ tham số trên nền tảng DX-M1. Hãng cho biết đã đo 17 mô hình trên hệ tham chiếu x86 và Raspberry Pi 5, với một số mô hình thuộc nhóm 4 tỷ tham số đạt trên 10 token/giây. Đây là công bố cho các mô hình được lựa chọn và tối ưu trên nền tảng của hãng, không phải kết quả bảo đảm cho mọi LLM 4 tỷ tham số trên mô-đun DFRobot 4 GB.
Cũng cần phân biệt giới hạn chip với cấu hình card cụ thể: DEEPX liệt kê bộ điều khiển nhớ hỗ trợ dung lượng tới 8 GB, còn DFRobot bán bản có 4 GB. Không nên lấy thông số tối đa của chip để giới thiệu bản đang bán như thể đã có nhiều RAM hơn.
Với người làm ứng dụng, lựa chọn hợp lý là bắt đầu từ mô hình đã có đường triển khai rõ trong DXNN, rồi kiểm tra cả dung lượng bộ nhớ lẫn độ trễ. DX-M1 phù hợp hơn với một tác vụ suy luận đã xác định so với mục tiêu mua về để thử tùy ý mọi mô hình chatbot.
Khe M.2 và phần mềm mới quyết định chi phí triển khai
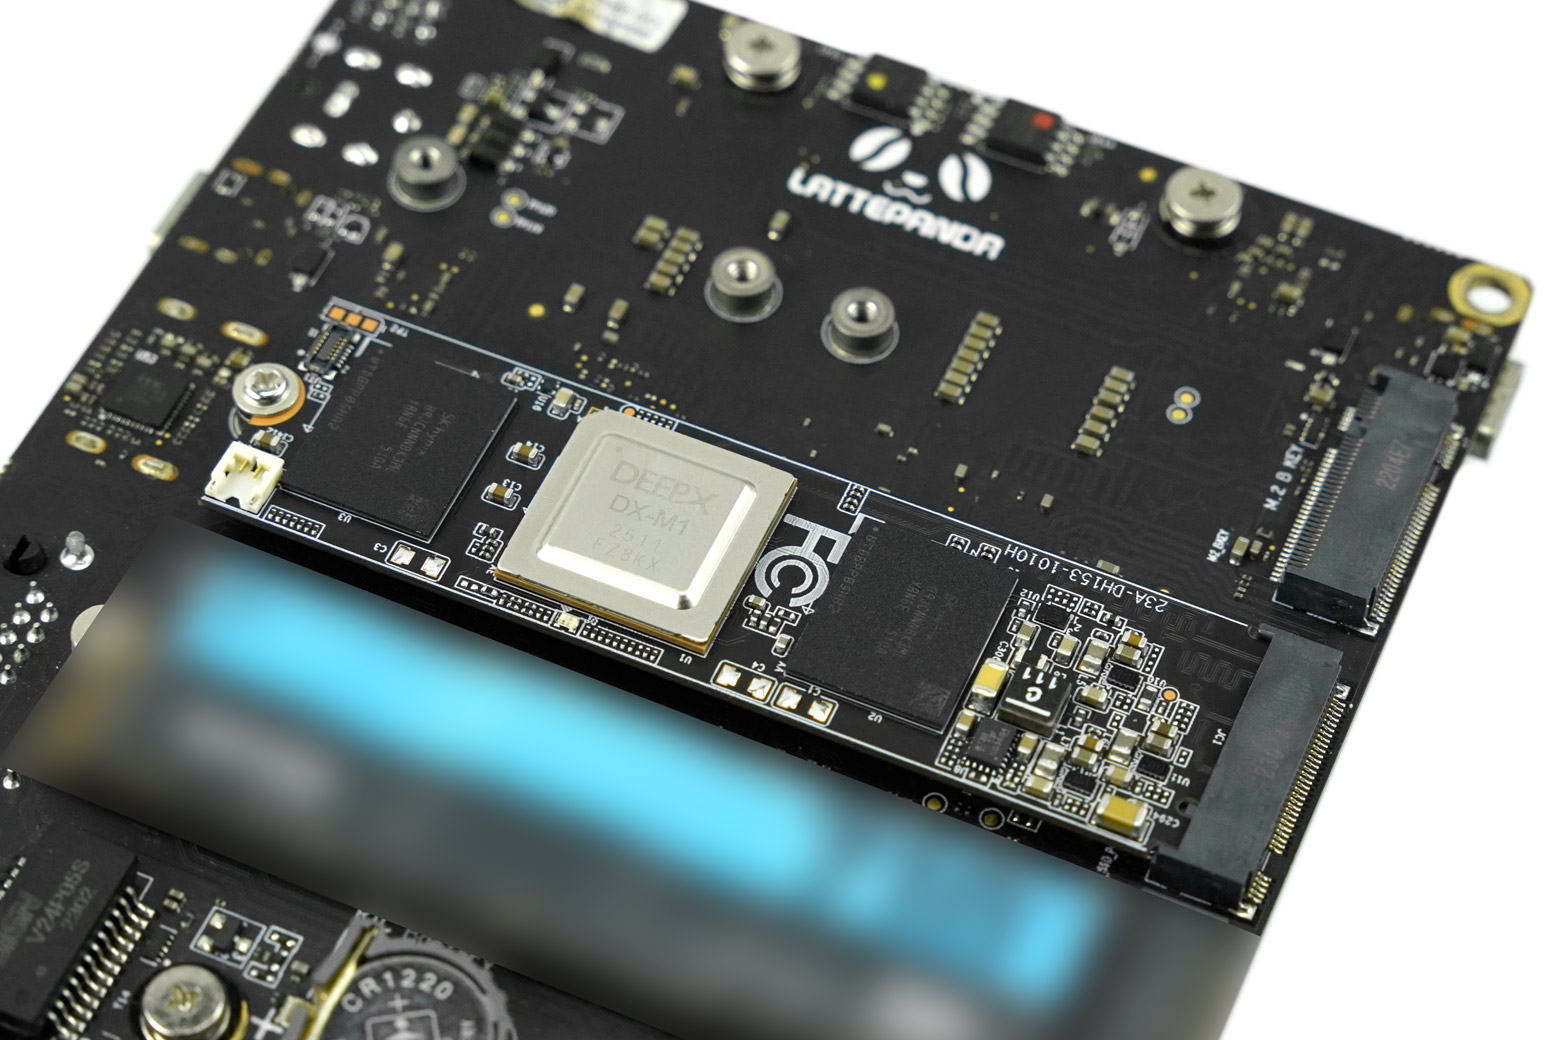
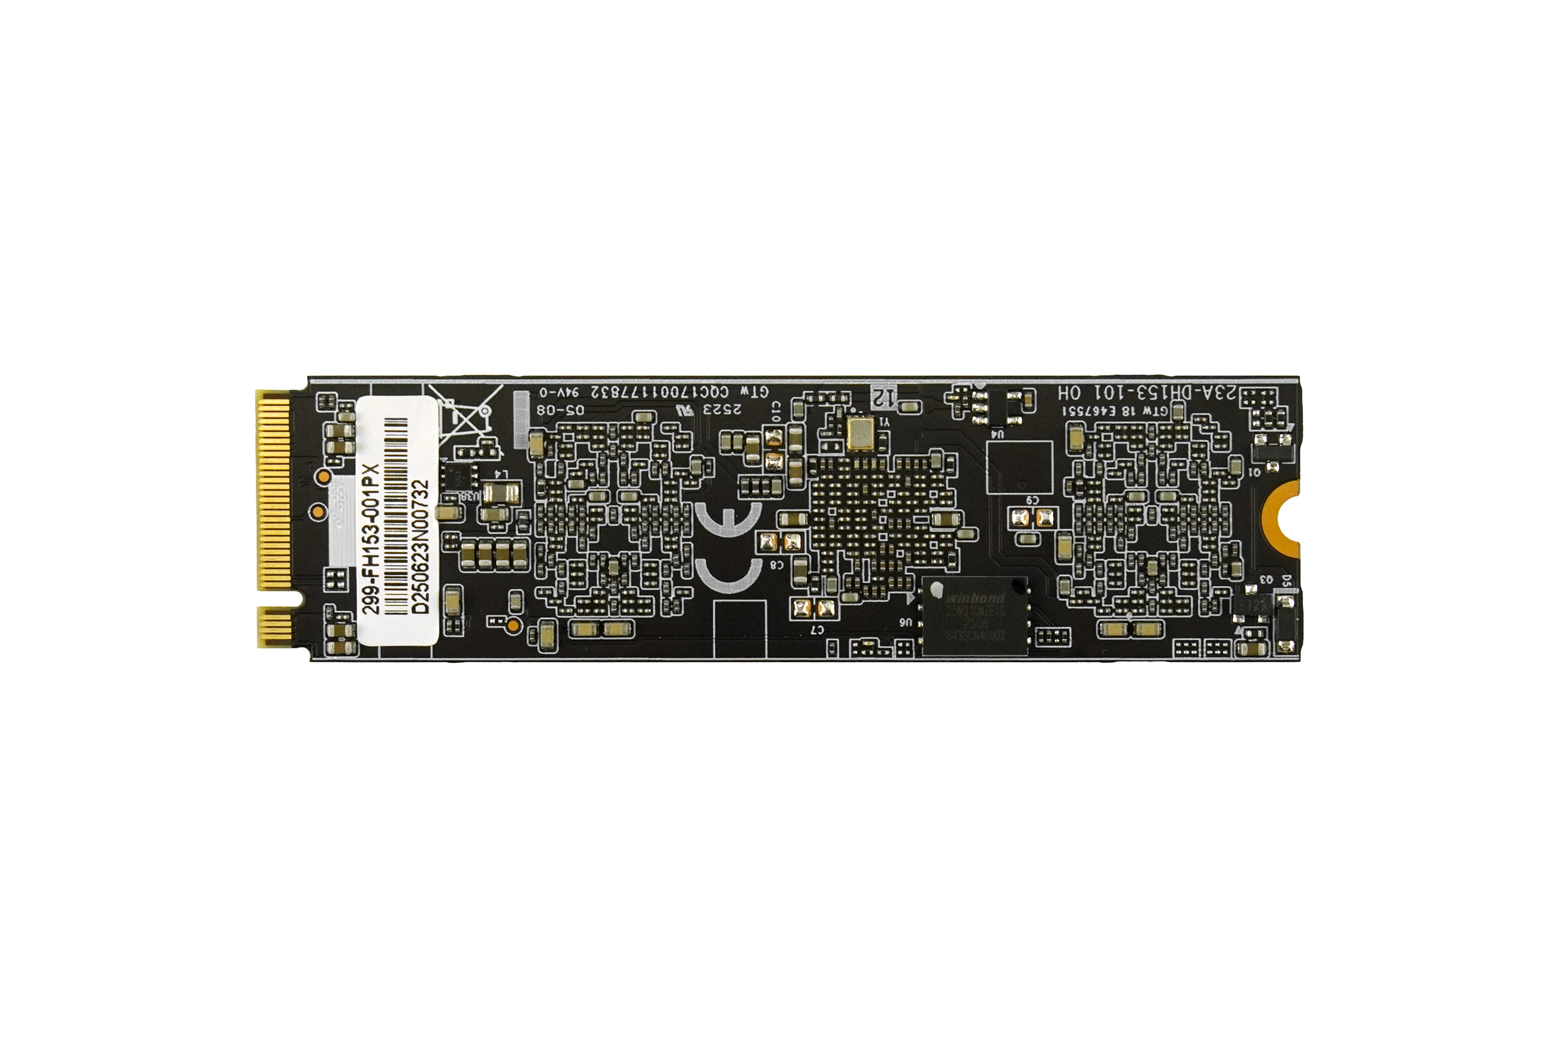
Chi phí thực tế của DX-M1 bao gồm cả khe mở rộng bị chiếm và công sức tích hợp phần mềm, chứ không dừng ở giá card. Với máy chỉ có một khe M.2 phù hợp, gắn NPU đồng nghĩa phải bố trí lại nơi lưu hệ điều hành hoặc dữ liệu; bộ nhớ flash phục vụ firmware trên mô-đun không biến nó thành ổ NVMe dùng thay SSD.
DFRobot nêu khả năng sử dụng với PC x86, LattePanda và Raspberry Pi 5 thông qua HAT phù hợp. Tuy vậy, tên M.2 chỉ nói lên một phần khả năng lắp đặt: người mua còn phải kiểm tra chuẩn M-Key, chiều dài 2280 và giao tiếp PCIe của khe trên bo mạch. Hỗ trợ chế độ x1 giúp mở thêm lựa chọn kết nối, nhưng không đồng nghĩa mọi cấu hình đều có băng thông như x4.
Bộ công cụ DXNN cung cấp quy trình biên dịch, tối ưu và chạy mô hình, còn DFRobot liệt kê hỗ trợ các framework như PyTorch, TensorFlow và ONNX. Điều này không có nghĩa ứng dụng PyTorch đang chạy bằng CPU hoặc GPU sẽ tự chuyển sang NPU sau khi cắm card. Phần việc cần kiểm tra là mô hình cụ thể có đi qua công cụ biên dịch được hay không, cùng khả năng kết nối kết quả suy luận vào ứng dụng đang dùng.
Với nhóm làm camera hoặc máy kiểm tra hình ảnh tại Việt Nam, tận dụng được máy chủ sẵn có sẽ khiến giải pháp M.2 đáng cân nhắc hơn. Ngược lại, nếu phải mua thêm bo mạch chuyển đổi, thay nơi lưu trữ và viết lại nhiều phần mềm, giá 139 USD chưa phản ánh đầy đủ ngân sách dự án. Mức giá này là niêm yết quốc tế của DFRobot, không phải giá bán tại Việt Nam và chưa phản ánh chi phí đưa hàng về nước.
DX-M1 đáng đưa vào danh sách thử nghiệm khi đã chốt mô hình, còn khe tương thích và cần một khối suy luận nhỏ gọn. Trước khi đặt nhiều mô-đun, nên xác nhận một cấu hình mẫu chạy được toàn bộ ứng dụng; đó là bằng chứng có giá trị hơn việc chọn card chỉ vì con số 25 TOPS.